本文创作参考2025年的CS336课程的第一节课程。
CS336 分词器
分词器是连接人类自然语言与机器计算的关键,负责将非结构化的文本高效地编码为模型可理解的数字序列(Tokens)。其地位至关重要,它决定了模型的输入形式。我们可以将大语言模型(LLM)视为一位阅读者,分词器则执行了文本的“认知拆解”即将连续的文本流切分为具备最小语义或功能意义的基本单元,类似于人类阅读时对词汇或音节的本能识别。本章节将剖析分词器实现文本“数字化”的核心原理,并探讨BPE等主流分词算法的实际应用。 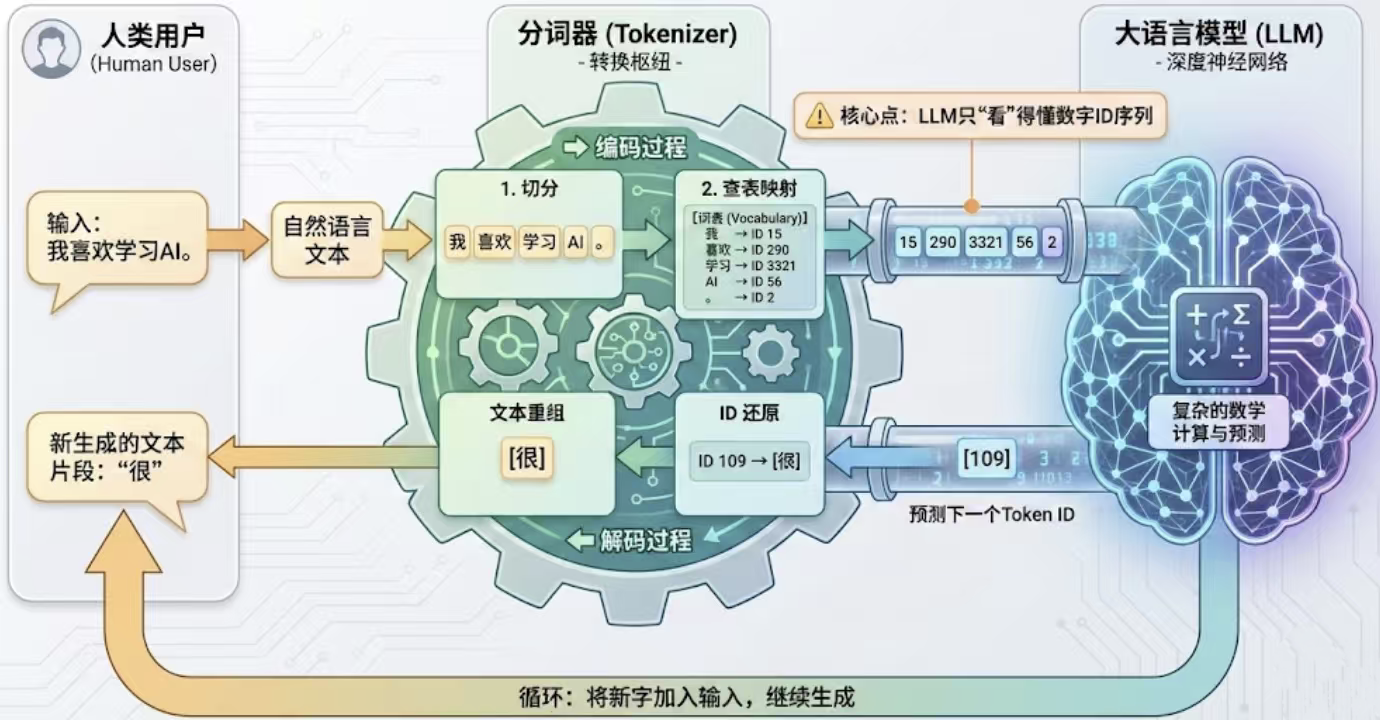
2.1 训练分词器
在我们把海量数据喂给大模型之前,必须先经过一道关键工序——分词。分词器常被视为LLM的一部分,但它其实拥有独立的训练生命周期。我们需要利用正则表达式对原始文本进行预处理,并统计构建出一套高效的词元——数字离散序列转化词表(vocab),这个映射过程决定了模型眼中的世界是由字、词还是更碎的片段组成的,直接影响后续模型对语义的理解效率。也正因如此,分词器虽独立训练却与LLM保持着“强耦合”的关系。
训练一个用于现代大型语言模型的分词器可以拆成四步:准备语料 → 初始化基础单元(可省略) → 统计并迭代合并 → 输出产物并用于编码、解码。
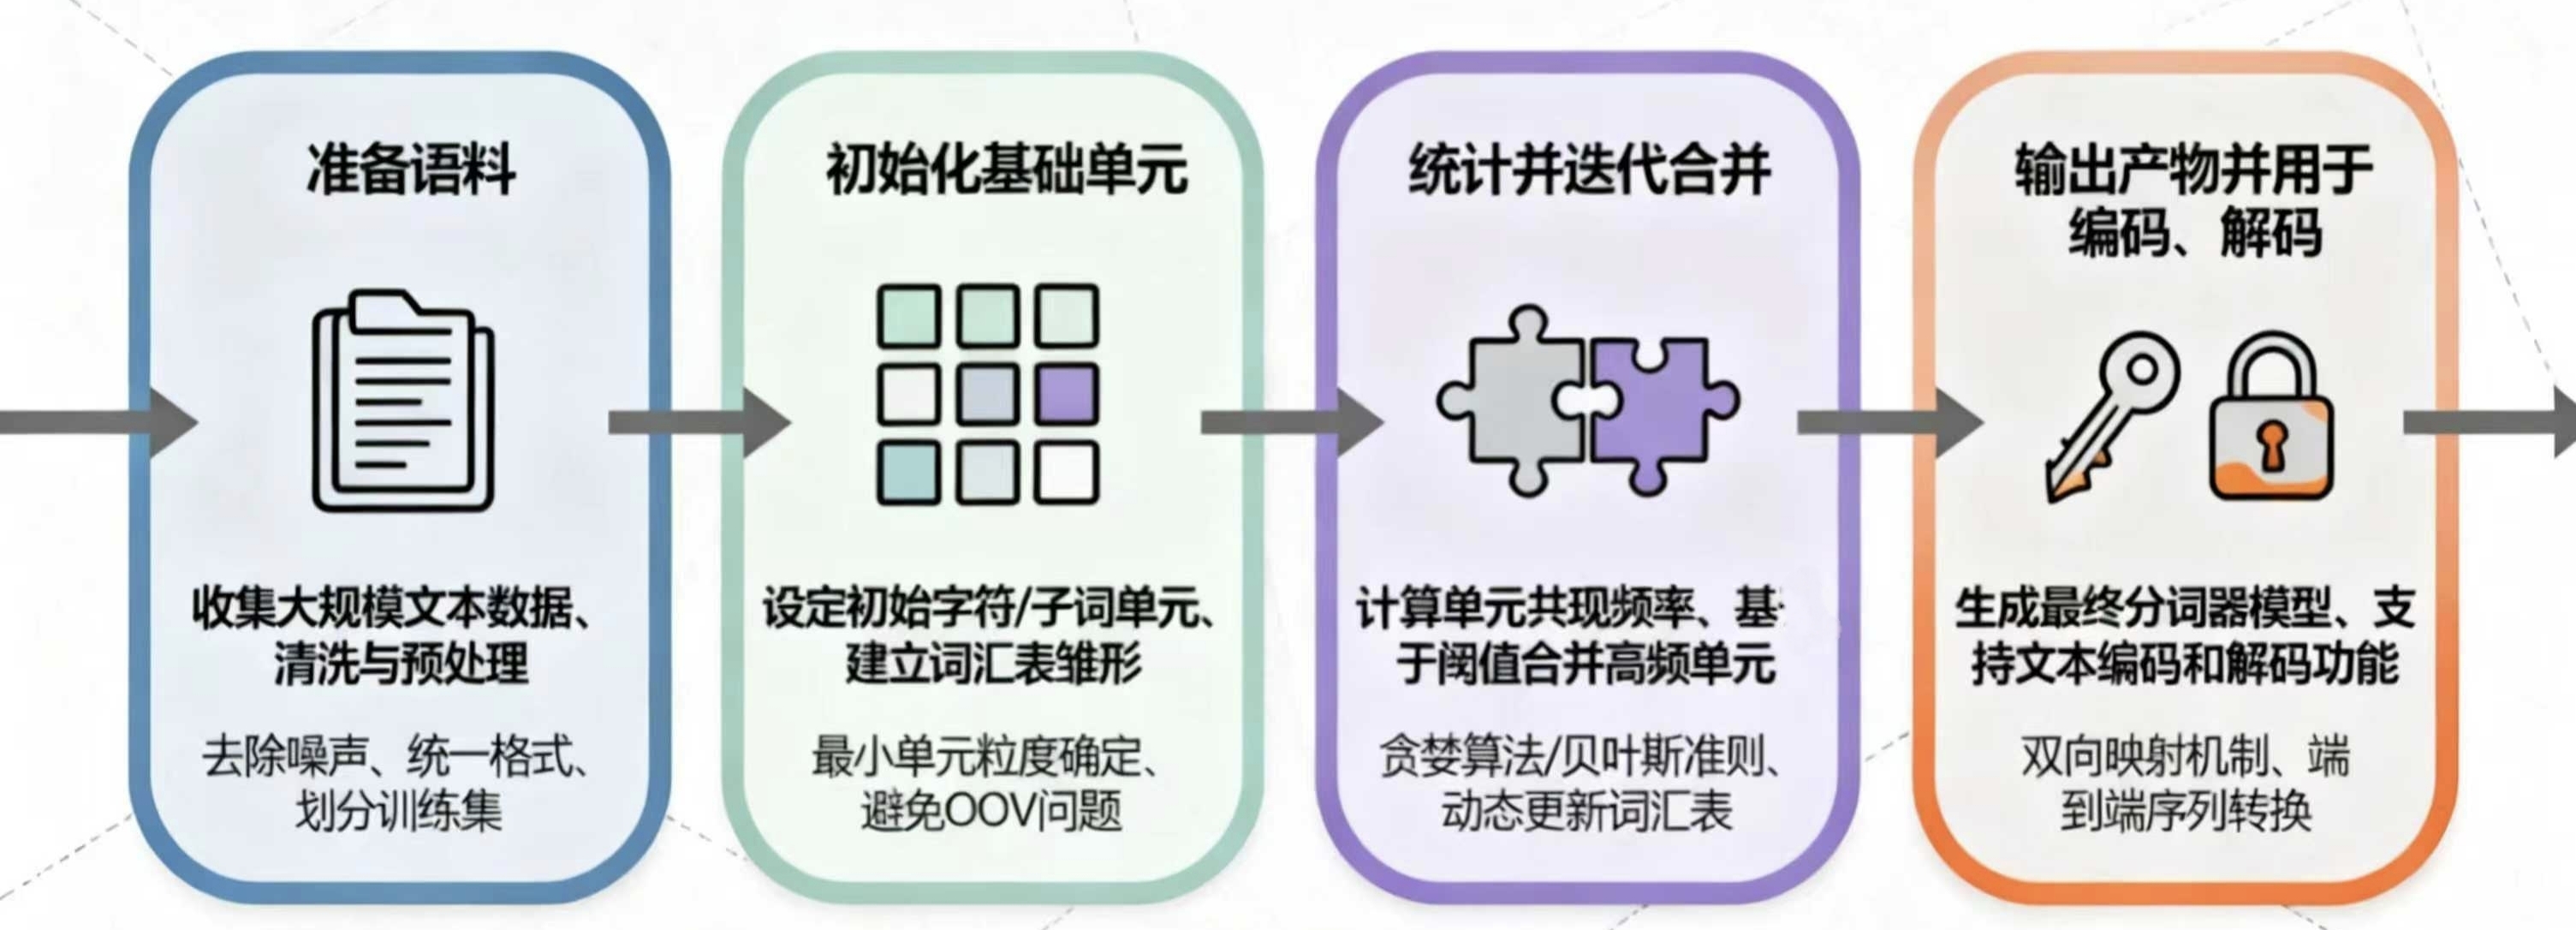
2.1.1 准备语料
在准备语料阶段,应尽量收集覆盖目标应用场景的多样化文本,以便训练出的词表对下游任务具有良好泛化能力。
- 准备不同类型的文本信息比如小说、散文、诗歌等不同描述风格的信息。
- 多种语言的文本信息比如中文、英文、韩语、法语等。
对原始文本进行清洗和标准化是必须的步骤,包含去除或屏蔽无关元数据、修正或删除乱码与非法字符、统一字符编码为UTF-8,并对重复或近重复样本进行去重以减少训练偏移。
对带有敏感信息或隐私的语料要提前进行脱敏处理与合规检查,明确哪些信息不可用于训练并记录数据来源与许可。 处理示例基于python实现:
import re
def desensitize(text):
# 1.常见中文姓名(简单规则:2~3字,全中文)
text = re.sub(r'([\\u4e00-\\u9fa5]{2,3})(的)', r'[NAME]\\2', text)
# 2.手机号脱敏(11位数字)
text = re.sub(r'1[3-9]\\d{9}', '[PHONE]', text)
# 3.地址脱敏(如 “居住于重庆xx…地方”)
# 捕获(居住于、现居住于、现居于)字段后面的“重庆”“北京”“上海”“广州” 等 +任意字符
text = re.sub(r'(居住于|现居住于|现居于)([\\u4e00-\\u9fa5A-Za-z0-9]+)', r'\\1[PLACE]', text)
return text
# 测试
text="小明的联系电话是13312311111,现在居住于重庆两江新区某小区。"
print(f"处理前:{text}")
print(f"脱敏后:{desensitize(text)}")
处理前
小明的联系电话是13312311111,现在居住于重庆两江新区某小区。
脱敏后
[NAME]的联系电话是[PHONE],现居住于[PLACE]。
如果句子中出现姓名、电话号码、住址等特定信息进行脱敏处理。值得注意的是这样数据脱敏不仅是保护隐私与合规的需要,同时也能让tokenizer的统计过程更干净、更稳定。大量独特且高基数的信息如姓名、电话号码、身份证号等如果不处理,会在语料中以几乎不重复的形式出现,使分词器在训练时被这些“只出现一次的随机字符串”干扰,从而产生大量低价值的token片段,通过脱敏替换这类信息后模型能够更专注于学习真正高频、有规律的语言结构,使词表更加精简分词效果更一致,泛化能力也更强。
如果下游任务本身需要识别真实实体(如信息抽取等),过度脱敏会削弱训练信号。因此需要在保护隐私与保留关键语义信息之间进行合理的策略选择与权衡。
token是LLM的基本输入单位,由分词器根据统计规则把文本拆成的子词、字符或字节,再映射成数字ID。
在多语言或混合语料场景中,应当统计每种语言的占比并考虑是否对低资源语言做过采样或专门保留,以避免词表被高频语言主导导致低频语言表现差即语料类型、语言不平衡会导致token碎片化、占用更多token并降低资源语言性能。
例如准备一种可以支持四种语言的分词器,这里假设提前收集到的原始未经过第7步处理的各语言原始语料占比如下:
| 中文 | 200 GB |
| 英文 | 150 GB |
| 法语 | 10 GB |
| 韩文 | 5 GB |
这是一个典型的多语言语料不平衡场景。若将上述语料不经处理直接混合训练分词器,其统计过程会被中文和英文主导,导致法语与韩文的常见字串在合并阶段难以进入高频统计,从而无法占据足够的词表空间,最终在vocab中会出现大量被切得过碎的token,形成严重碎片化,下游LLM在法语与韩文任务上会因此表现显著劣化。
因此在准备语料的第4步应先按语言统计语料占比,并根据目标能力设定合理的采样策略。例如将语料比例调整为中文:英文:法语:韩文=4:4:1:1或者采用完全均衡策略。通过对高资源语言下采样或对低资源语言过采样、增强,可以获得更符合目标分布的训练语料,再使用验证集评估各语言的token覆盖率、平均其碎片化程度,以确保最终词表在多语言任务中具备稳定且均衡的表示能力。
2.1.2 初始化基础单元
预分词的主要任务是将原始文本切分成可统计、可合并的基础单元,例如字符、字节或Unicode片段。常见策略包括基于空格和标点的切分、按Unicode类别划分,或直接采用字节级切分。需要注意的是并不是所有的分词器都需要用户显式进行预分词。例如基于SentencePiece的分词器将标准化和预分词逻辑内置,因此无需在外部额外执行预分词步骤。
- 基于空格和标点的切分策略:一个完整的句子中遇到空格或者标点(.,!?[]{}…)可以分为独立的tokens,该方法适用于大多数预分词处理过程。
# 基于空格和标点切分的实现示例
import re
def part(text):
# 将标点符号单独拆开,并按照空格进行分割
text = re.sub(r'([.,!?;:()"\\'\\[\\]{}])', r' \\1 ', text)
tokens = text.split()
return tokens
# 测试
s = "I like DataWhale."
print(part(s))
输入
I like DataWhale.
输出token划分
[‘I’, ‘like’, ‘DataWhale’, ‘.’]
- Unicode类别划分策略:根据字符类型比如字母、数字、标点、中文、特殊字符等自动切分token,不同Unicode类别会属于不同token块,这种方法天然适用于多种语言混合的文本,提供了可靠的基线切分。
# Unicode类别划分token
import unicodedata
def unicode_category_type(ch):
"""根据Unicode类别将字符划为:中文、字母、数字、其他"""
if '\\u4e00' <= ch <= '\\u9fff':
return "CJK"
if ch.isdigit():
return "DIGIT"
if ch.isalpha():
return "ALPHA"
return "OTHER"
def tokenize_unicode_category(text):
if not text:
return []
tokens = []
current = text[0]
current_type = unicode_category_type(current)
for ch in text[1:]:
ch_type = unicode_category_type(ch)
if ch_type == current_type and ch_type != "OTHER":
# 同类字符,继续合并
current += ch
else:
# Unicode不同类 → 切分
tokens.append(current)
current = ch
current_type = ch_type
tokens.append(current)
# 最后再把"OTHER"类型(标点等)拆开
final_tokens = []
for t in tokens:
if unicode_category_type(t[0]) == "OTHER":
final_tokens.extend(list(t))
else:
final_tokens.append(t)
return final_tokens
# 测试
s = "Hello,DataWhale成立于2018年12月6日!至今已有7年的历史了~"
print(tokenize_unicode_category(s))
输入
Hello,DataWhale成立于2018年12月6日!至今已有7年的历史了~
输出
[‘Hello’, ‘,’, ‘DataWhale’, ‘成立于’, ‘2018’, ‘年’, ‘12’, ‘月’, ‘6’, ‘日’, ‘!’, ‘至今已有’, ‘7’, ‘年的历史了’, ‘~’]
- 字节级切分策略:先将每个字符拆成UTF-8字节序列,不依赖语言种类、字符,按照单个字节序列得到一个独立的token。
def tokenize_byte_level(text):
tokens = []
for ch in text:
# 字符对应的UTF-8字节序列
utf8_bytes = ch.encode("utf-8")
hex_bytes = [f"{b:02X}" for b in utf8_bytes]
# 打印转换过程
print(f"{ch} 转化为UTF-8字节序列:{hex_bytes}")
# 加入token列表
tokens.extend(hex_bytes)
return tokens
# 测试
s = "All for learners!"
print(tokenize_byte_level(s))
输入
All for learners!
输出token划分
[‘41’, ‘6C’, ‘6C’, ‘20’, ‘66’, ‘6F’, ‘72’, ‘20’, ‘6C’, ‘65’, ‘61’, ‘72’, ‘6E’, ‘65’, ‘72’, ‘73’, ‘EF’, ‘BC’, ‘81’]
Unicode与UTF-8的联系:
Unicode就像给全世界所有字符发的“身份证号”,不管是英文A、汉字“中”、还是emoji 😄等不同类型的字符都在Unicode里有一个唯一编号比如A是U+0041,“中”是U+4E2D。但“身份证号”本身只是一个抽象编号,电脑不能直接存储。
UTF-8就像把这个字符对应的“身份证号”写进电脑的具体方式。它规定这个字符的编号应该用几个字节、按什么规则写下来。英文常用字符在UTF-8中只需要1个字节,而中文通常需要3个字节。不管是Unicode还是UTF-8都可以表示不同类别的字符,两者配合起来让自然语言可以被计算机准确存储、传输和解析,是人机交互之间的“桥梁”。
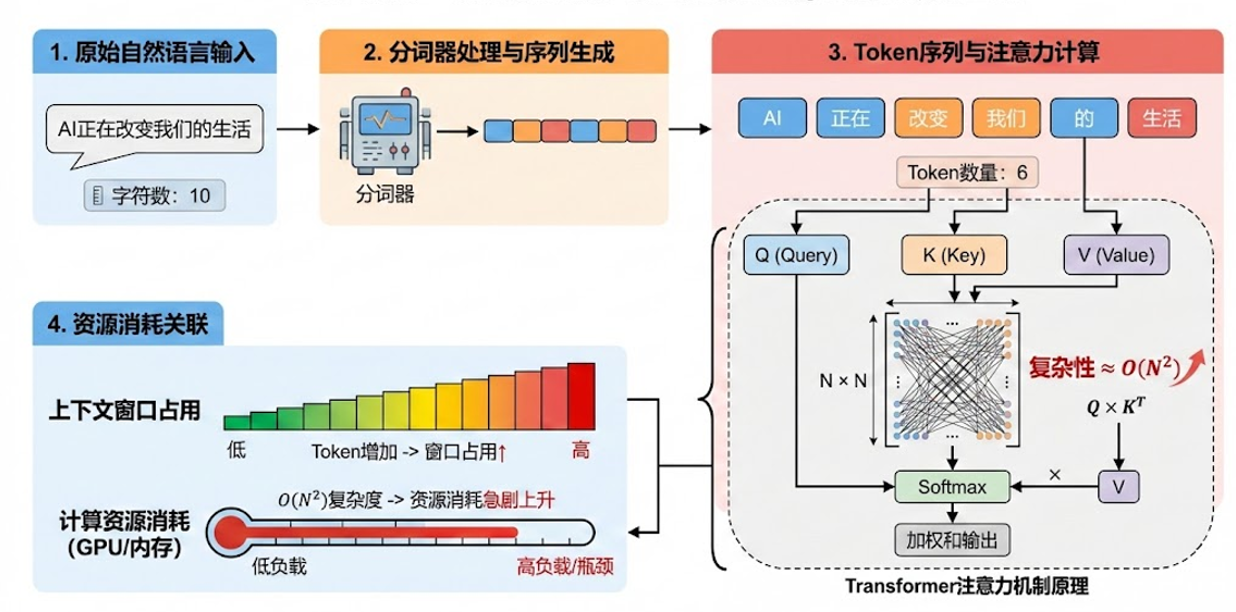
在LLM的token划分中,常见策略包括基于规则的预分词按空格以及标点切分、按Unicode类别的分段如连续汉字、连续拉丁字母或数字…以及更底层的UTF-8字节级切分。前两类方法在处理缺乏显式分隔符或长段同类字符例如连续的中文长句、拼接的代码标识符或压缩后的字符串时存在局限,预处理阶段难以有效断句,分词器可能被迫退化为字符级切分,从而把文本映射成更长的token ID序列,增加Transformer的计算和内存负担,其中注意力的复杂度近似为
O
(
n
2
)
O(n^2)
O(n2) 。
相比之下,UTF-8字节级策略具有最强的通用性,它把任意文本统一拆为字节序列,从而从根本上减少未登录词(OOV)问题并覆盖任意字符集。但因为它以最细粒度开始,训练时通常需要更多轮的共现统计与合并来把零散字节压缩为紧凑且具语义的token,才能在Transformer计算效率与语义表征之间取得平衡。
未登录词是当LLM模型在处理新的、实际应用的文本时,如果遇到一个词汇表中没有的Token,那么这个Token就被视为一个OOV。
对大多数以空格为词边界的语言,可先用正则表达式按单词边界和标点进行初步切割,而对中文、日文等不以空格为词界的语言则通常采用逐字符或基于字的初始单元来保证覆盖性。
字节级预分词的好处:
- token利用率更高,提高BPE合并token的自由度以及尽可能合并共现频率高的单个字符,提高文本信息压缩率。
- 可兼容处理多种语言。
- 学到更多高频片段,减少未登录词的出现情况,模型推理更快(token数少)。
文本压缩率:指一段文字被转换成token(数字化)后,用多少token来表示内容的紧凑程度,同样内容使用的token越少,压缩率就越高。
预分词生成的基础单元序列将作为后续统计合并的输入,务必保存该序列与对应位置信息以便在训练过程反复高效更新。
实现示例:
def btp_hex_list(text):
"""
UTF-8字节级预分词,返回:
1. tokens: 每个字符的字节序列+位置信息
2. t: 所有字节的十六进制字符串列表
"""
tokens = []
t = []
for idx, char in enumerate(text):
utf8_bytes = char.encode('utf-8')
hex_bytes = ' '.join(f"{b:02X}" for b in utf8_bytes)
tokens.append({
'char': char,
'bytes': hex_bytes, # 单个字符对应的UTF-8字节序列
'start': idx, # 文本信息起始位置
'end': idx + 1 # 文本信息结束位置
})
# 将每个字节拆成单个十六进制字符串
t.extend([f"{b:02X}" for b in utf8_bytes])
return tokens, t
# 测试
text = "Hi,你好🐋"
tokens, t = btp_hex_list(text)
for i in tokens:
print(i)
print(t)
2.1.3 统计并迭代更新
遍历语料以收集用于后续决策的统计信息,具体方法随算法不同而异:
- BPE:统计当前符号字符、子词序列中相邻对的出现频次,每次贪心合并出现频次最高的相邻对,迭代构建词表——其决策仅基于频率统计。
- WordPiece:评估合并或保留某些子词对对语料似然即语言模型性能的贡献,选择能显著提升语料拟合度的合并操作。
- Unigram:从一个过大的种子词表出发,初始化每个token的概率。
| BPE | 快速、简单,高频子词压缩好;多语言、大语料适用 | 字节级BPE或代码点级BPE | GPT系列、RoBERTa |
| WordPiece | 平衡OOV与词表大小;预训练语言模型常用 | 代码点、字符级实现Google BERT原始实现 | BERT、DistilBERT、RoBERTa |
| Unigram | 灵活适应语料分布;多语言、低频词友好 | SentencePiece Unigram模式支持byte-fallback | T5、mT5、其他使用 SentencePiece 的模型 |
| SentencePiece | 跨语言、通用tokenizer;可移植、多语种适用 | 代码点级BPE、Unigrambyte-fallback | T5、mT5、各种开源模型和自定义LLM |
总体来说,以上四种子词分词算法各有特点,没有哪一种是绝对最好的。选择算法时应根据具体的文本内容(语料分布)、任务类型(理解或生成)、词表规模以及是否需要处理多语言来决定,这样才能让训练出来的LLM模型发挥最佳性能。
迭代 BPE、WordPiece、Unigram、SentencePiece这四种迭代算法简要分析:
- BPE算法:可以借助第一步子词候选统计数据作为初始化数据,进行单个token合并形成新的token,然后在多次迭代过程中动态统计共现次数,得到新的token。
- WordPiece算法:会在迭代过程中动态统计当前词汇表中所有相邻子词对的出现情况。其关键并非简单合并频率最高的对子,而是优先选择能最大提升语料整体似然的子词对,从而形成更有表征意义的token,一个常用的近似评分为:
score
(
A
,
B
)
=
P
(
A
,
B
)
P
(
A
)
×
P
(
B
)
\\text{score}(A,B)=\\frac{P(A,B)}{P(A) \\times P(B)}
score(A,B)=P(A)×P(B)P(A,B)
该比值衡量A与B的“关联性”是否强于独立出现时的期望。如果score>1,则说明A与B的结合比随机独立出现更有义,更可能被WordPiece合并。【Google没有公开WordPiece算法详情,这里参考huggingface相关原理介绍】
-
Unigram算法:它基于一个子词概率语言模型,将一个句子的概率定义为其所有可能分词方式概率的总和。核心思想是通过迭代优化子词概率,使得整个语料的似然最大化。算法采用期望最大化(EM)方法,主要包含两步:
①E步(期望步):在当前词表和子词概率下,为语料中的每个句子计算最可能的分词方式或前n个高概率分词方案,并据此估计每个子词在语料中的期望使用次数。
②M步(最大化步):根据E步的统计结果,更新每个子词的概率,使整体语料的似然最大化。
③在每次迭代中,模型会剪枝(淘汰)概率较低的token如丢弃底部10%~20%,从而逐步收敛到一个较小且优化后的词表,直到达到预设的目标词表大小。这种方法相比BPE或WordPiece更依赖概率建模,能够灵活处理不同长度的子词,并自然保留最能解释语料的高频段。
最大化语料似然指的是在训练分词器时,学习一套能让训练语料整体概率最大的token划分方式和词表,使语料中的字符序列可以被更高概率、更常见的token组合表示。通俗地说就是把文本切成最顺畅、最符合语言统计规律的片段,让同一句话在不同地方都能被稳定、紧凑地切分成一致的token序列。需要注意的是:分词器优化的是输入的表示方式,它本身并不会让模型“理解”自然语言——真正“理解”语言的能力是在后续Transformer参与的训练中获得的。但更合理的token划分会让输入分布更清晰一致,从而间接提升模型训练效率和最终性能。
- SentencePiece算法:它是一个独立的分词工具和实现库,能够直接从原始文本训练子词模型,因此无需用户在外部显式执行预分词步骤。它在内部会将空格、词边界等信息编码为特殊字符(训练输出中常见的▁用于表示词首空格),从而可以将空格也作为建表对象之一。接着会在这些初始token上应用BPE或Unigram算法,生成最终的token词表及映射。
这个迭代过程中需要保持特殊控制token(如<PAD>、<UNK>、<CLS>、<MASK>等),在分词器迭代更新过程中不参与修改,这样可以确保它们的词——数字映射保持固定,编码后的离散数字序列能够准确还原为原始文本。同时,这些token不会在统计合并或概率优化中被拆分或覆盖,从而有效减少碎片化token的出现。无论使用BPE、WordPiece、SentencePiece还是Unigram等算法,这一策略都适用有助于保护关键token的完整性,保证模型训练和推理的一致性。
通用终止条件 不同算法可能采用不同策略,但核心目标都是得到一个可控大小且高效的词表:
-
词表大小限制:当词表达到预设大小如32k、50k、100k、256k…时停止。
-
迭代步数限制:达到最大合并或训练步数(合并次数、EM迭代次数)时停止。
-
低贡献候选终止:
- 对BPE、WordPiece:最高合并频率低于阈值时停止。
- 对Unigram、SPM:子词概率低于阈值,删除后剩余词表稳定即可停止。
-
训练、验证集指标收敛:用于监控与评估等指标,直到达到预设目标或收敛。
大规模语料优化
- 分布式统计或分片训练。
- 精确、近似计数。
- 确定性排序+固定随机种子保证训练可复现。
监控与评估指标
- 平均token长度即每词或每字符、未登录词率(OOV)。
- 高频token示例合理性。
- 压缩率(总token数 / 总字符数或总字节数)。
总结:分词器训练的核心是迭代更新候选子词 → 控制词表大小或收敛指标 → 监控质量指标,不同算法仅在“候选生成方式”和“迭代更新策略”上有差异。
2.1.4 输出产物并用于编码与解码
导出核心产物 训练完成后需要导出至少两个关键文件:
- vocab文件:记录所有token及其对应的id,是编码器和解码器的核心索引。
- merges文件:按顺序记录所有子词合并规则或概率模型。二者共同决定tokenizer的编码与解码逻辑,并确保编码的可逆。
下游使用前的验证与评估
-
将tokenizer应用于一部分验证集后,建议统计以下关键指标:平均token数与最大长度分布,直接影响显存占用、训练速度和推理效率;碎片化情况,检查关键实体、专业术语是否被拆得过碎,避免影响模型理解;跨语言token平衡度,多语言任务中需确保不同语言的常见模式都有足够的token支持。
-
如果后续需要扩表如加入新领域术语、专业词或品牌名等,建议优先采用这些方式而非完全重训tokenizer:增量训练、加入新的merges项、清理极低频token。
-
扩表后应进行一次回归测试,确保:与旧模型保持兼容且根据数字化编码可以还原回到最开始的输入文本、不发生token分配冲突或token耗尽问题。
版本管理与可复现性保证 词表与merges文件应纳入严格的版本控制,包括:语义化版本号(如1.2.0 )、每次修改的变更日志、在训练脚本和推理pipeline中显式固定tokenizer版本,防止模型训练阶段与推理部署阶段使用不同tokenizer,导致结果不可复现或性能下降。
2.2 常用的分词器
在NLP的发展历程中,分词策略经历了几次重要的演变。我们主要关注四种最典型的范式:字符、字节、词级、BPE分词器,以及结合课程lecture1各个分词器伪代码转化为python代码实践。
2.2.1 字符分词器
原理介绍
这是最直观、最简单的分词方式,它将文本拆解为最小的字符单位即单个字符形如英语中的字母(a, b, c)或者中文里的单字(你,好)。
- 优点:
- 词表极小: 英语只需包含26个字母+符号;中文只需包含常用汉字(约几千个)。
- 无OOV问题: 任何生僻词都是由基础字符组成的,不会出现“未知词”。
- 缺点:
- 序列过长: 一句话变成字符后,长度会增加数倍,大大消耗LLM宝贵的上下文窗口,从而加大LLM的transformer计算显存消耗。
- 语义稀疏: 单个字符(如t)通常不具备独立的语义,模型需要更深的网络层数来组合出意义。
实现示例:
# 字符Tokenizer
class CharacterTokenizer:
def __init__(self):
pass # 不需要额外参数,直接用ord、chr
def encode(self, text):
"""
将字符串编码为字符索引列表(Unicode code points)
"""
return [ord(ch) for ch in text]
def decode(self, indices):
"""
将索引列表解码为字符串
"""
return ''.join([chr(i) for i in indices])
# 测试代码
if __name__ == "__main__":
tokenizer = CharacterTokenizer()
string = "hi,很好的,terrific!🐋" # 测试字符串
# 编码
indices = tokenizer.encode(string)
print("编码ID:", indices)
# 解码
reconstructed_string = tokenizer.decode(indices)
print("解码:", reconstructed_string)
# 验证是否可逆
assert string == reconstructed_string, "字符编码、解码不一致!"
# 计算词汇量(最大Unicode code point+1)
vocabulary_size = max(indices) + 1
print("词汇量(上限)", vocabulary_size)
# 简单压缩率计算
def get_compression_ratio(text, indices):
# 压缩率 = 原字符串字节数/编码索引字节数
import sys
original_bytes = len(text.encode('utf-8'))
encoded_bytes = len(indices) * 4 # 假设每个Unicode code point用4字节存储
return original_bytes / encoded_bytes
compression_ratio = get_compression_ratio(string, indices)
print("压缩比率:", compression_ratio)
输入
hi,很好的,terrific!🐋
输出
编码ID: [104, 105, 65292, 24456, 22909, 30340, 65292, 116, 101, 114, 114, 105, 102, 105, 99, 65281, 128011]
压缩比率: 0.47058823529411764
2.2.2 字节分词器
原理介绍
计算机底层存储文本本质上都是字节,在UTF-8编码中,英文通常占1个字节,汉字通常占3个字节。字节分词器直接对二进制字节进行操作。
- 核心逻辑: 不再维护“字符”的词表,而是维护一个大小为256的基础词表(0x00到0xFF)。
- 应用: 现代LLM如GPT-4, Llama通常不单独使用纯字节分词,而是将字节作为BPE的基础单位即BBPE,这样可以彻底解决跨语言和特殊符号如emoji 🌍等的编码问题。
# Byte-level Tokenizer实现
class ByteTokenizer:
def __init__(self):
# vocab就是0~255的256个值
self.vocab_size = 256
def encode(self, text: str):
# 将字符串编码为UTF-8字节序列 转为int列表
return list(text.encode("utf-8"))
def decode(self, indices):
# 将int列表→bytes→UTF-8 字符串
return bytes(indices).decode("utf-8")
# 计算压缩率
def get_compression_ratio(text: str, indices):
input_byte_len = len(text.encode("utf-8")) # 原始字节序列长度
token_len = len(indices) # token数量
return input_byte_len / token_len if token_len > 0 else 1
# 测试
if __name__ == "__main__":
print("以下测试单字节与多字节 UTF-8 字符:")
assert bytes("a", encoding="utf-8") == b"a"
assert bytes("🌍", encoding="utf-8") == b"\\xf0\\x9f\\x8c\\x8d"
print("测试通过:UTF-8单字节与多字节验证完毕\\n")
tokenizer = ByteTokenizer()
string = "Hello, 🌍! 你好!"
print("原始字符串:", string)
indices = tokenizer.encode(string)
print("编码后的byte token序列:", indices)
reconstructed_string = tokenizer.decode(indices)
print("解码结果:", reconstructed_string)
assert string == reconstructed_string
print("\\nRound-trip测试通过")
vocabulary_size = tokenizer.vocab_size
print("\\n词表大小:", vocabulary_size)
compression_ratio = get_compression_ratio(string, indices)
print("压缩率compression_ratio:", compression_ratio)
assert compression_ratio == 1
print("压缩率测试通过(byte tokenizer无压缩)。")
输入
Hello, 🌍! 你好!
输出
原始字符串: Hello, 🌍! 你好!
编码后的byte token序列: [72, 101, 108, 108, 111, 44, 32, 240, 159, 140, 141, 33, 32, 228, 189, 160, 229, 165, 189, 33]
解码结果: Hello, 🌍! 你好!
值得注意的是字节级分词器的压缩比恒等于1,原因在于:
- 输入文本中单个字符首先被编码为UTF-8字节序列;
- 字节级分词器将每一个UTF-8字节(0-255)直接作为一个token;
- 因此token数量=UTF-8字节数。
所以
c
o
m
p
r
e
s
s
i
o
n
r
a
t
i
o
=
UTF-8 字节长度
token 数量
=
N
N
=
1
compression_{ratio} = \\frac{\\text{UTF-8 字节长度}}{\\text{token 数量}} = \\frac{N}{N} = 1
compressionratio=token 数量UTF-8 字节长度=NN=1
也就是说,字节级分词器完全不具备压缩能力即每个字节对应一个token,不会产生更长或更短的词片段。
2.2.3 词级分词器
原理介绍
在深度学习早期(如RNN时代)这是最主流的方法。它基于空格(英文)或分词算法(中文)将文本切分为具备独立语义的“词”。
- 优点: Token保留了完整的语义信息比如"apple" 直接对应一个Token ID…。
- 缺点:
- 词表爆炸: 英语中 look, looks, looked, looking 会被视为4个完全不同的ID,导致词表巨大几十万甚至上百万。
- OOV 问题严重: 遇到没见过的词如人名、新造词等,只能标记为<UNK> ,导致信息丢失从而影响LLM的表现能力。
实现示例:
import regex
# deepseek tokenizer中使用的经典正则表达式(简化版)
TOKENIZER_REGEX = r"\\p{L}+|\\p{N}+|[^\\p{L}\\p{N}\\s]+|\\s+"
# 压缩率计算
def get_compression_ratio(text: str, segments):
byte_len = len(text.encode("utf-8"))
token_count = len(segments)
return byte_len / token_count if token_count > 0 else 1
# Word-level Tokenizer实现
class WordTokenizer:
def __init__(self, pattern=r"\\w+|."):
"""
pattern: 正则表达式(默认基础版:把连续字母数字合成一个词)
"""
self.pattern = pattern
self.word2id = {}
self.id2word = {}
def build_vocab(self, texts):
"""
根据训练文本列表建立词表
"""
vocab = set()
for text in texts:
segments = regex.findall(self.pattern, text)
vocab.update(segments)
vocab = sorted(vocab)
self.word2id = {w: i for i, w in enumerate(vocab)}
self.id2word = {i: w for w, i in self.word2id.items()}
def encode(self, text):
"""
文本 → 字符串片段 → token id列表
未登录词 UNK = -1
"""
segments = regex.findall(self.pattern, text)
return [self.word2id.get(seg, –1) for seg in segments], segments
def decode(self, ids):
"""
token ID → 原始片段 → 拼成字符串
"""
return "".join(self.id2word.get(i, "<UNK>") for i in ids)
# 测试
if __name__ == "__main__":
string = "It's so supercalifragilisticexpialidocious!👋👋"
print("原始字符串:", string)
# 使用基础正则分词(基于空格和标点切分)
basic_segments = regex.findall(r"\\w+|.", string)
print("基础正则分词结果:")
print(basic_segments)
# 使用deepseek风格正则
segments = regex.findall(TOKENIZER_REGEX, string)
print(f"deepseek风格分词结果:{segments}")
# 构建词表
tokenizer = WordTokenizer(pattern=TOKENIZER_REGEX)
tokenizer.build_vocab([string])
print("词表大小:", len(tokenizer.word2id))
# 编码
ids, segs = tokenizer.encode(string)
print(f"编码token IDs:{ids}")
# 字节序列
byte_tokens = [b for b in string.encode("utf-8")]
print(f"UTF-8字节序列:{byte_tokens}")
print(f"编码segments:{segs}")
# 解码
decoded = tokenizer.decode(ids)
print("解码结果:", decoded)
# 压缩率
ratio = get_compression_ratio(string, segs)
print("压缩率:", ratio)
输入
It’s so supercalifragilisticexpialidocious!👋👋
输出
基础正则分词结果:
[‘It’, “'”, ‘s’, ’ ', ‘so’, ’ ', ‘supercalifragilisticexpialidocious’, ‘!’, ‘👋’, ‘👋’]
deepseek风格分词结果:[‘It’, “'”, ‘s’, ’ ', ‘so’, ’ ', ‘supercalifragilisticexpialidocious’, ‘!👋👋’]
词表大小: 7
编码token IDs:[3, 2, 4, 0, 5, 0, 6, 1]
压缩率: 6.375
2.2.4 BPE分词器
原理介绍
这是目前LLM(GPT, BERT, Llama等)最主流的分词算法,BPE是一种试图在字符级(粒度太细)和词级(粒度太粗)之间找到平衡。
-
核心思想: 统计语料中相邻字符对出现的频率,迭代地将最频繁出现的字符对合并成一个新的Token。
-
过程:
- 初始化:将单词拆成字符序列。
- 统计:计算所有相邻字符对的频率(如’e’ 和’s’经常一起出现)。
- 合并:将频率最高的对(‘e’, ‘s’)合并为新 Token (‘es’)。
- 循环:重复上述步骤,直到达到预设的词表大小。
实现实例:简易版BPE训练过程
import regex
from collections import Counter
# DeepSeek风格正则
DEEPSEEK_REGEX = r"\\p{L}+|\\p{N}+|[^\\p{L}\\p{N}\\s]+|\\s+"
# 使用grapheme cluster保持emoji不被拆分
def split_graphemes(token):
return tuple(regex.findall(r'\\X', token))
# BPE训练函数
def train_bpe(texts, num_merges=50):
"""
texts: 文本列表(用于训练BPE)
num_merges: BPE 迭代合并的次数
"""
# 1.构建初始vocab(字符级+</w>结束符)
vocab = Counter()
for text in texts:
tokens = regex.findall(DEEPSEEK_REGEX, text)
for token in tokens:
chars = split_graphemes(token) + ('</w>',)
vocab[chars] += 1
merges = []
for _ in range(num_merges):
# 统计相邻pair出现次数
pairs = Counter()
for word, freq in vocab.items():
for i in range(len(word)–1):
pairs[(word[i], word[i+1])] += freq
if not pairs:
break
# 找到最常见pair
best_pair = max(pairs, key=pairs.get)
merges.append(best_pair)
# 合并所有vocab中的该pair
new_vocab = {}
for word, freq in vocab.items():
w = []
i = 0
while i < len(word):
if i < len(word)–1 and (word[i], word[i+1]) == best_pair:
w.append(word[i]+word[i+1])
i += 2
else:
w.append(word[i])
i += 1
new_vocab[tuple(w)] = freq
vocab = new_vocab
return merges, vocab
# BPE Tokenizer类
class BPETokenizer:
def __init__(self, merges):
self.merges = merges
def encode_word(self, token):
# 初始分成字符+</w>
word = list(split_graphemes(token)) + ['</w>']
# 按merge顺序依次合并
for pair in self.merges:
i = 0
new_word = []
while i < len(word):
if i < len(word)–1 and (word[i], word[i+1]) == pair:
new_word.append(word[i]+word[i+1])
i += 2
else:
new_word.append(word[i])
i += 1
word = new_word
return word
def encode(self, text):
tokens = regex.findall(DEEPSEEK_REGEX, text)
bpe_tokens = []
for t in tokens:
bpe_tokens.extend(self.encode_word(t))
return bpe_tokens
def decode(self, tokens):
# 拼接tokens并去掉结尾</w>
text = ''.join(tokens).replace('</w>', '')
return text
# 测试
if __name__ == "__main__":
train_texts = ["这只猫🐈很可爱", "the quick brown fox jumps over the lazy 🐕🦺"]
merges, vocab = train_bpe(train_texts, num_merges=20)
print("BPE合并:", merges)
tokenizer = BPETokenizer(merges)
test_text = "敏捷的棕色狐狸🦊"
encoded = tokenizer.encode(test_text)
print("编码:", encoded)
decoded = tokenizer.decode(encoded)
print("解码:", decoded)
输入
test_text = “敏捷的棕色狐狸🦊”
输出
BPE合并: [(’ ', ‘’), (‘t’, ‘h’), (‘th’, ‘e’), (‘the’, ‘’), (‘这’, ‘只’), (‘这只’, ‘猫’), (‘这只猫’, ‘’), (‘🐈’, ‘’), (‘很’, ‘可’), (‘很可’, ‘爱’), (‘很可爱’, ‘’), (‘q’, ‘u’), (‘qu’, ‘i’), (‘qui’, ‘c’), (‘quic’, ‘k’), (‘quick’, ‘’), (‘b’, ‘r’), (‘br’, ‘o’), (‘bro’, ‘w’), (‘brow’, ‘n’)]
编码: [‘敏’, ‘捷’, ‘的’, ‘棕’, ‘色’, ‘狐’, ‘狸’, ‘’, ‘🦊’, ‘’]
在BPE编码阶段,如果没有</w>算法可能把the错误地拆成’th’、'e’或在后续合并时与其他token错误合并。加上</w>后,the会被表示为[‘t’, ‘h’, ‘e’, ‘’],BPE就知道这是一个完整单词的结尾不会跨单词错误合并,那么解码阶段去掉</w>就能把token拼回the,保证原文恢复正确。
因此,</w>的核心作用是保证单词完整性,并让编码可逆即可以从相应的数字序列转化为原文。
四种分词器对比表
| 字符级 | 细 | 小 (100-5k) | 无 | 非常长 | Char-RNN |
| 词级 | 粗 | 极大 (>100k) | 严重 | 短 | Word2Vec, GloVe |
| BPE | 中 (自适应) | 适中 (30k-100k) | 极少 | 适中 | GPT-4, Llama 3 |
除了分词器的选择与训练语料直接影响LLM的输入稀疏度与表示效率。用大规模、高质量且多样的语料训练分词器通常会减少token碎片化即生成更常见、更稳定的子词单元,使得同一段文字被编码为更少的token,同时在固定的上下文窗口长度下单位token承载更多实际信息,这意味着模型能够在有限窗口内“看到”更多内容——从而在一定程度上缓解因上下文长度受限引起的信息丢失。
注意上述情况这依赖于语料的覆盖与质量;若语料偏颇或过度合并罕见词,反而可能损害少数语言或专业术语的表示能力。
3 分析DeepSeek的分词器
DeepSeek模型尤其是Coder系列,对代码和中英文都进行了高度优化,我们将加载DeepSeek Coder模型的官方分词器。
3.1 加载DeepSeek Tokenizer
请确保transformers库已安装
# 安装transformers库
pip install transformers torch
我们将加载deepseek-ai/deepseek-coder-6.7b-instruct的分词器。
from transformers import AutoTokenizer
# 使用DeepSeek Coder系列模型的分词器
MODEL_NAME = "deepseek-ai/deepseek-coder-6.7b-instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
print(f"成功加载模型: {MODEL_NAME} 的分词器。")
print(f"分词器词表大小V: {len(tokenizer.get_vocab())}")
3.2 DeepSeek分词器的处理逻辑
DeepSeek的分词器基于BPE在处理中、英文和代码时具有其独特的策略。
举例分析: 中文文本处理 观察DeepSeek如何处理中文短语,通常它也会使用子词或单个汉字Token来提高效率。
chinese_text = "注意力机制是AI的核心技术。 🚀 🚀"
# 编码
encoded_ids = tokenizer.encode(chinese_text, add_special_tokens=False)
# 解码回Token字符串 (用于观察子词)
tokens = tokenizer.convert_ids_to_tokens(encoded_ids)
print(f"\\n原文: {chinese_text}")
print(f"编码: {tokens}")
print(f"IDs:{encoded_ids}")
最后得到的token可能在显示上与原文有所差异这并不是编码本身出错,而是因为LLM所用的词表在训练过程中对某些字符或子词的覆盖不足(例如BPE训练不够充分),导致模型无法生成对应的token,从而在可读形式上看起来像“乱码”。可以通过增加训练语料量或进行充分的BPE训练,可以学习到更完整的token映射表,从而解决这个问题,使中文、英文、emoji等字符都能被正确编码和解码。接下来是相应的解决办法即训练BPE:
"""
DeepSeek-V3 Tokenizer简易实现示例
(核心包含:字节级BPE+DeepSeek风格正则预分词)
"""
import regex as re
from collections import Counter
from typing import List, Tuple, Dict, Iterable
import json
import base64
# 配置:DeepSeek 正则模式(预分词)
# \\p{L}+ 连续字母(中文、英文、所有 Unicode 字母)
# \\p{N}+ 连续数字
# [^\\p{L}\\p{N}\\s]+ 非字母数字空白的字符(如标点、emoji)
# \\s+ 连续空白符
DEEPSEEK_REGEX = r"\\p{L}+|\\p{N}+|[^\\p{L}\\p{N}\\s]+|\\s+"
# 基础函数:预分词与字节处理
def pretokenize(text:str):
"""按DeepSeek风格的正则进行预分词"""
return re.findall(DEEPSEEK_REGEX, text)
def bytes2tokens(b:bytes):
"""
将UTF-8字节序列转为latin1可表示的token列表。
每个字节0–255都能被latin1接映射到字符。
"""
return [bytes([x]).decode('latin1') for x in b]
def tokens2bytes(tokens):
"""将latin1 token列表重新转回原始bytes"""
return b''.join([t.encode('latin1') for t in tokens])
# BPE训练相关
def build_corpus(texts):
"""
构建byte-level语料。
步骤:预分词 → UTF-8编码 → 分解为单字节 → 作为初始token序列。
"""
corpus = []
for text in texts:
for chunk in pretokenize(text):
corpus.append(bytes2tokens(chunk.encode('utf-8')))
return corpus
def pair_freq(corpus: List[List[str]]):
"""统计所有token序列中相邻token pair的出现频率"""
pairs = Counter()
for word in corpus:
for i in range(len(word)–1):
pairs[(word[i], word[i+1])] += 1
return pairs
def merge_pair(word: List[str], pair: Tuple[str,str]):
"""将指定的token pair合并成一个token"""
a, b = pair
merged = []
i = 0
while i < len(word):
if i < len(word)–1 and word[i]==a and word[i+1]==b:
merged.append(a+b) # 合并为一个新token
i += 2
else:
merged.append(word[i])
i += 1
return merged
def train_bpe(texts: Iterable[str], vocab_size: int=5000, num_merges: int=None) –> Tuple[List[Tuple[str,str]], List[str]]:
"""
训练字节级BPE
"""
corpus = build_corpus(texts)
base_tokens = [bytes([i]).decode('latin1') for i in range(256)]
merges: List[Tuple[str,str]] = []
merged_set = set()
cur_vocab_size = 256
# 若未指定合并次数,则由target vocab来决定
merge_steps = num_merges or (vocab_size – 256)
for _ in range(merge_steps):
pfreq = pair_freq(corpus)
if not pfreq:
break
# 找到出现频率最高的pair
best_pair, _ = pfreq.most_common(1)[0]
if cur_vocab_size + 1 > vocab_size:
break
merges.append(best_pair)
# 对整个语料进行合并替换
corpus = [merge_pair(word, best_pair) for word in corpus]
# 将新token记入词表
merged_set.add(best_pair[0]+best_pair[1])
cur_vocab_size += 1
# 追加特殊token
special_tokens = ["<pad>", "<bos>", "<eos>", "<unk>"]
# vocab = 特殊token+ 256 byte token +BPE合并的新token
vocab_tokens = special_tokens + base_tokens + sorted(merged_set)
return merges, vocab_tokens
# Tokenizer类
class DeepSeekV3Tokenizer:
def __init__(self, merges: List[Tuple[str,str]], vocab_tokens: List[str]):
self.merges = merges
self.vocab_tokens = vocab_tokens
# token ↔ id映射
self.token2id = {tok:i for i, tok in enumerate(vocab_tokens)}
self.id2token = {i:tok for tok,i in self.token2id.items()}
# merges pair → 排序index
self.ranks = {pair:i for i,pair in enumerate(merges)}
# 特殊token
self.pad_token = "<pad>"
self.bos_token = "<bos>"
self.eos_token = "<eos>"
self.unk_token = "<unk>"
def encode_chunk(self, chunk: str) –> List[str]:
"""
对一个预分词做BPE编码:
– 转字节token
– 逐步应用merges
– 处理OOV:未知token拆回字节或标记为<unk>
"""
tokens = bytes2tokens(chunk.encode('utf-8'))
# 应用PE并规则
for pair in self.merges:
new_tokens = []
i = 0
a,b = pair
while i < len(tokens):
if i<len(tokens)–1 and tokens[i]==a and tokens[i+1]==b:
new_tokens.append(a+b)
i+=2
else:
new_tokens.append(tokens[i])
i+=1
tokens = new_tokens
# OOV token拆回字节
out = []
for t in tokens:
if t in self.token2id:
out.append(t)
else:
# 拆分成字节token,如果字节token也不在词表 → <unk>
out.extend([ch if ch in self.token2id else self.unk_token for ch in t])
return out
def encode(self, text: str, add_bos=False, add_eos=False, print_chunks=False):
"""
编码完整文本:
– 先预分词
– 再逐chunk编码
– 可选打印中间过程
"""
ids = []
if add_bos:
ids.append(self.token2id[self.bos_token])
if print_chunks: print(f"[Special] <bos> -> {self.token2id[self.bos_token]}")
for chunk in pretokenize(text):
toks = self.encode_chunk(chunk)
chunk_ids = [self.token2id.get(t, self.token2id[self.unk_token]) for t in toks]
if print_chunks:
readable = []
for t in toks:
try:
# 尝试恢复utf-8
r = tokens2bytes([t]).decode('utf-8', errors='ignore')
readable.append(r if r else t.encode('latin1').hex())
except:
readable.append(t.encode('latin1').hex())
print(f"[Chunk] \\"{chunk}\\" -> {readable} -> IDs: {chunk_ids}")
ids.extend(chunk_ids)
if add_eos:
ids.append(self.token2id[self.eos_token])
if print_chunks: print(f"[Special] <eos> -> {self.token2id[self.eos_token]}")
return ids
def decode(self, ids: Iterable[int]):
"""
将ID序列还原为utf-8文本:
"""
byte_seq = bytearray()
for i in ids:
tok = self.id2token.get(i, self.unk_token)
if tok in {self.pad_token, self.bos_token, self.eos_token}:
continue
byte_seq.extend(tokens2bytes(list(tok)))
return byte_seq.decode('utf-8', errors='replace')
def save(self, vocab_path: str, merges_path: str):
# 保存vocab(token2id)
with open(vocab_path, 'w', encoding='utf-8') as f:
json.dump(self.token2id, f, ensure_ascii=False, indent=2)
# 保存merges:每个token用base64
merges_b64 = []
for a, b in self.merges:
a_bytes = a.encode('latin1')
b_bytes = b.encode('latin1')
merges_b64.append((
base64.b64encode(a_bytes).decode('ascii'),
base64.b64encode(b_bytes).decode('ascii')
))
with open(merges_path, 'w', encoding='utf-8') as f:
json.dump(merges_b64, f, ensure_ascii=False, indent=2)
@classmethod
def load(cls, vocab_path: str, merges_path: str):
# 加载vocab
with open(vocab_path, 'r', encoding='utf-8') as f:
token2id = json.load(f)
vocab_tokens = [None] * (max(token2id.values()) + 1)
for tok, idx in token2id.items():
vocab_tokens[idx] = tok
# 加载merges(base64 → bytes → latin1)
with open(merges_path, 'r', encoding='utf-8') as f:
merges_b64 = json.load(f)
merges = []
for a_b64, b_b64 in merges_b64:
a = base64.b64decode(a_b64).decode('latin1')
b = base64.b64decode(b_b64).decode('latin1')
merges.append((a, b))
return cls(merges, vocab_tokens)
# 提供训练函数
def train_tokenizer(texts, vocab_size=5000, num_merges=None):
merges, vocab_tokens = train_bpe(texts, vocab_size=vocab_size, num_merges=num_merges)
return DeepSeekV3Tokenizer(merges, vocab_tokens)
# 示例
if __name__ == "__main__":
texts = [
"Transformer是AI的核心技术。",
"DeepSeek分词器支持中文、英文、emoji等多语言。",
"Hello, 世界! 🌍🚀",
]
print("训练 Tokenizer (vocab_size=1024)")
tokenizer = train_tokenizer(texts, vocab_size=1024)
print(f"完成训练,词表大小: {len(tokenizer.vocab_tokens)}")
print("-"*50)
txt = "注意力机制是AI的核心技术。 🚀 🚀"
print(f"编码文本: {txt}")
ids = tokenizer.encode(txt, add_bos=True, add_eos=True, print_chunks=True)
print("-"*50)
print("Token ID:", ids)
decoded = tokenizer.decode(ids)
print("解码结果:", decoded)
print("是否可逆:", decoded == txt)
输入测试样例
注意力机制是AI的核心技术。 🚀 🚀
输出
tokens映射id,以及每个划分token对应的编码,并且对于不同位置的空格和emoji🚀对应的编码以及映射ID是相同的。
从以上代码的运行结果可以看到,分词器中的token ↔ id映射只描述“这个token的内容”,并不包含它在句子中的任何位置信息。BPE或其他基于统计和概率的分词算法,其本质都是依据语料中的共现频率或概率分布,决定如何将常见的字符、字节或子串合并成更长、更高频的token。这类算法本身并不理解句子的语义,它更像一个纯统计模块,通过频率或概率原则对字符序列进行切分与合并,为上层模型如LLM提供稳定而紧凑的离散输入单元。真正的语义理解由下游的Transformer板块在上下文中通过学习获得,并依赖位置编码来建模顺序信息,而不是由分词器完成。
为什么DeepSeek要用latin1编解码?
在DeepSeek的分词流程中最终处理得到的是数字化的token,但在BPE分词器训练阶段需要按“字符”操作。如果直接用 UTF-8编解码,汉字或emoji等多字节字符在拆分为单字节时会出现不完整序列,Python会报错或替换,导致信息丢失。而latin-1是单字节编码,它把每个字节(0–255)机械映射为一个Unicode字符,保证任意字节序列都能完整、可逆地保存,从而让BPE或其他子词算法能把字节当作字符合并而不丢数据。简单来说使用latin-1是为了在分词器中安全地把原始字节当作字符处理,确保编码器阶段信息完整。
3.3 快速体验DeepSeek分词器

这里输入文本信息为你好 ,hello, world ! 🌏 !。
通过这里的可视化展示DeepSeek的分词器输出,右边的最后一栏表示的是对应token ID映射,可以看到对于单独划分为一组token的空格,就算位置不同其ID值均为223。
4思考
1)有研究表明,视觉特征能够增强LLM的理解能力,但并非适用于所有语言任务。那么是否可以在视觉表征与离散 token 之间寻求一种动态“平衡点”:同时为模型提供两类表征方式,并借鉴MoE的思想设计轻量级动态路由,使模型能够在不同任务或文本片段中自动选择或融合最合适的词——数字映射表形式,从而显著提升跨场景的适配能力?
文本token的离散性限制了表达能力,视觉token可提供高密度的连续压缩表征但并不适用于所有语言场景;因此探索一种MoE风格的多表征机制,使模型能按任务动态选择文本、视觉或混合表征,以获得更丰富且具场景适配性的表示或许也值得思考。
2)能否设计一种“自适应分词器”,在训练阶段先与LLM分开训练,并通过一种特殊机制将训练好的分词器与模型结合,使其在下游任务中仍能动态学习和优化token划分策略?
比如考虑一种反馈驱动的词表动态增强方法,核心是跨模型语义表示的蒸馏与迁移。它不使用传统的输出概率蒸馏,而是由教师模型根据用户反馈,提取新概念的精准语义向量。通过映射适配器将该向量投影到学生模型的Embedding空间,实现对学生词表矩阵的即时“补丁”,从而让学生模型能够零样本地识别并处理新Token。
3)借助微分子词模块、元学习或强化学习等方法,让分词器能够从少量对话或任务样本中自动发现最合适的token划分方式,从而降低下游任务对数据的依赖同时提升模型的鲁棒性和泛化能力?
这种方式有点像半监督学习,分词器自己在“学习怎么学习”,这样即使只看到少量对话样本,它也能找到更合适的token划分方式,让模型理解语言更高效,也更不容易被新词或少量数据难住。
参考资料
- hugging face介绍四种分词器算法
- BEP算法
- CS336的Lecture1课程资料