/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}

🏆 本文收录于 《YOLOv10实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv10 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv10 的网络结构、训练策略、标签分配、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Consistent Dual Assignments(一致性双重标签分配)、NMS-Free End-to-End Detection(无 NMS 端到端检测)、Holistic Efficiency-Accuracy Driven Model Design(整体效率-精度驱动模型设计) 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv10 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️
🎉 本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉 《YOLOv8实战》 👉 《YOLOv9实战》 👉 《YOLOv10实战》 👉 《YOLOv11实战》 👉 《YOLOv12实战》 👉 以及最新上线的 《YOLOv26实战》
想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀 想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
🎯 本文定位:计算机视觉 × YOLOv10 生成式 AI 与自动标注篇 📅 预计阅读时间:约 45~60 分钟 🏷️ 难度等级:⭐⭐⭐⭐☆(高级) 🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv10 · ByteTrack · OpenCV · NumPy
全文目录:
-
- 📌 上期回顾
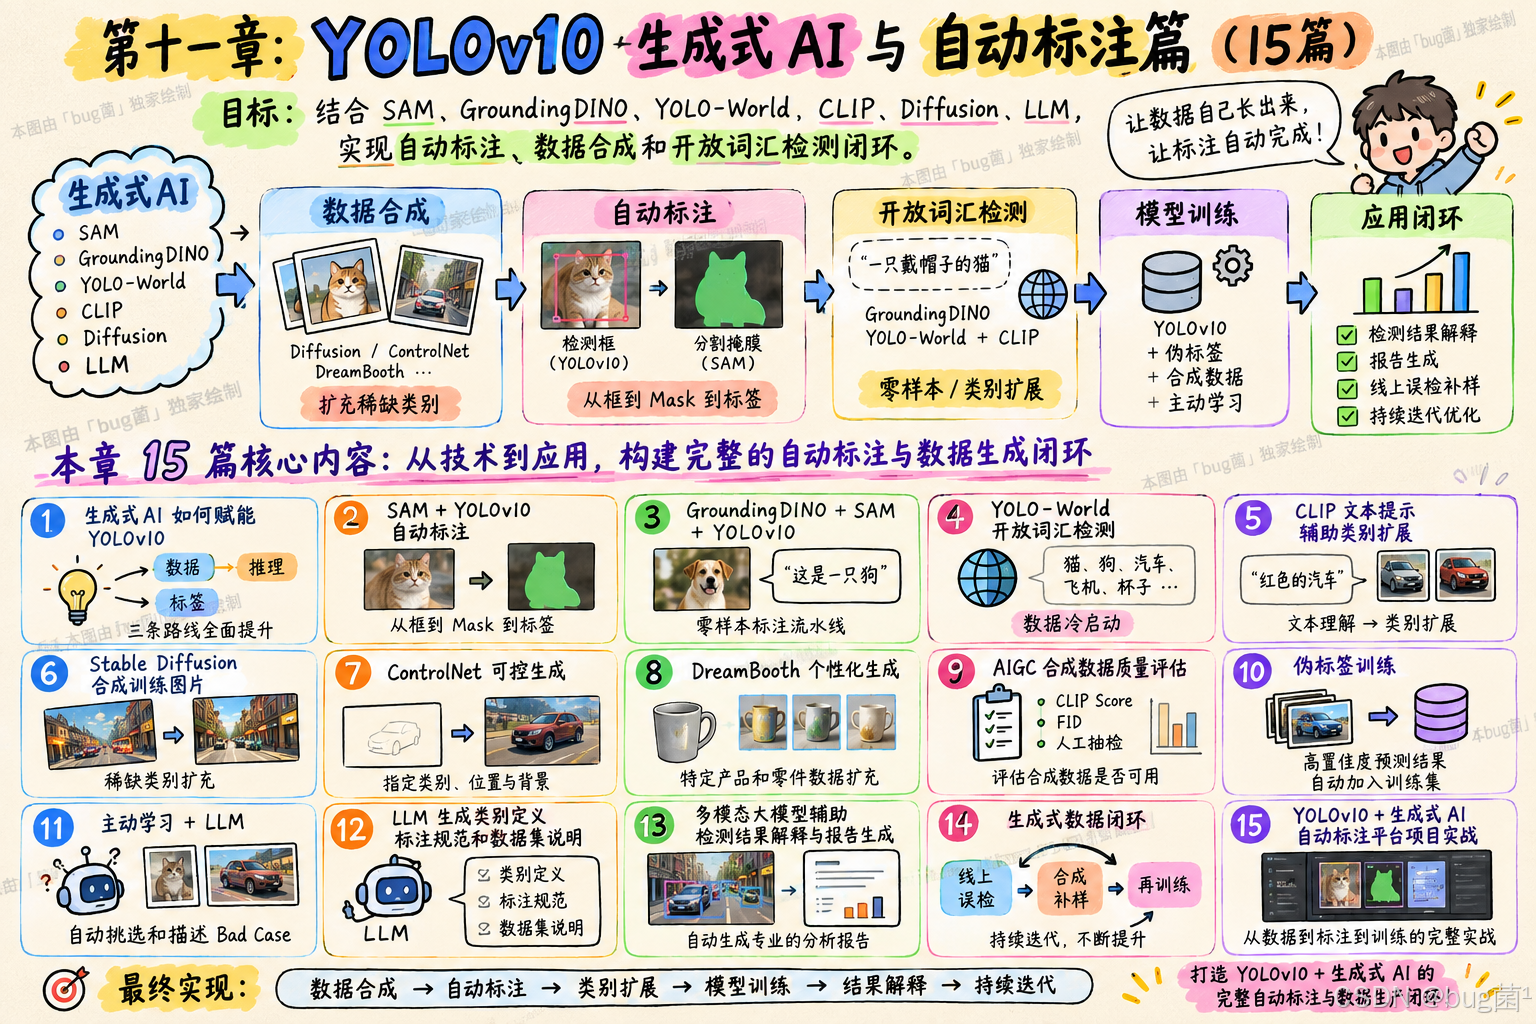
- 🎯 本节主题:LLM 生成类别定义、标注规范和数据集说明
-
- 一、为什么标注规范是 AI 工程中最被低估的环节
- 二、LLM 在标注规范生成中能做什么
- 三、整体架构设计
- 四、核心模块一:类别定义生成器
-
- 4.1 提示词工程设计
- 4.2 代码解析
- 五、核心模块二:标注规范文档生成器
-
- 5.1 标注规范的完整结构
- 5.2 标注规范生成器实现
- 5.3 代码解析:设计决策说明
- 六、核心模块三:数据集说明文档(Dataset Card)生成器
-
- 6.1 为什么需要 Dataset Card
- 6.2 Dataset Card 生成器实现
- 数据集配置文件(data.yaml)
- 训练 YOLOv10 模型
- 模型推理
- 七、核心模块四:YOLO data.yaml 自动生成器
- 八、完整集成示例:端到端运行演示
-
- 代码运行效果说明
- 九、标注规范的版本管理与迭代机制
-
- 9.1 迭代触发条件
- 9.2 规范补丁生成器
- 十、标注一致性自动化检测
- 十一、LLM 生成内容的质量控制
-
- 11.1 自动校验清单
- 十二、工程化部署:与标注平台集成
-
- 12.1 Label Studio 集成
- 十三、本节总结与思考
- 🔮 下期预告
- 📌 附录
- 🧧🧧 文末福利,等你来拿!🧧🧧
- 👨💻 About Me · 关于作者
写在前面:这一节其实是我在做项目时踩了无数坑之后,才真正意识到有多重要的一个环节。标注规范的缺失,往往不是模型的问题,而是\”人的问题\”——每个标注员对同一类别的理解可能差了十万八千里。LLM 的介入,让这件事有了更优雅的解法。
📌 上期回顾
在上期《YOLOv10【第十一章:生成式 AI 与自动标注篇·第11节】主动学习 + LLM:自动挑选和描述 Bad Case》内容中,我们聚焦在一个很有意思的主题上——如何让系统自己找出自己的问题。
传统的模型迭代流程大概是这样的:训练 → 部署 → 出错 → 人工排查 → 修复 → 重训。这个链路里最耗时耗力的环节,恰恰是\”人工排查\”。一个工业部署场景下,每天的推理日志可能有数十万条,靠人眼去找那几十个 Bad Case,简直是大海捞针。
上节我们构建了一套 主动学习 + LLM 联合挑选与描述 Bad Case 的完整流水线,核心思路是:
第一步:主动学习策略筛选候选样本。 我们用了基于不确定性采样(Uncertainty Sampling)的策略,把模型预测置信度低、预测结果波动大的样本优先挑出来。具体指标包括:预测类别的 softmax 熵、检测框 IoU 分布的方差、以及 NMS 前后框数量变化比率。这三个指标组合起来,可以相当准确地定位到\”模型不确定自己在看什么\”的