原文:别再让工具定义撑爆上下文了!MCP 代码执行模式深度解析
智能体与工具的交互,有两种截然不同的方式:
- 直接调用:每个工具定义和返回结果都会占用模型的上下文窗口
- 代码执行:让模型写代码去调用工具,扩展性更好,Token 消耗更低
听起来差别不大?实测数据告诉你:同样的任务,Token 消耗从 15 万降到 2000,节省 98.7%。
这篇文章来自 Anthropic 官方工程博客,详细拆解了 MCP(Model Context Protocol)在规模化场景下的性能瓶颈,以及如何用代码执行模式彻底解决这个问题。
MCP:智能体连接万物的通用协议
MCP 是连接智能体与外部系统的开放标准。传统方式下,智能体每接入一个工具都需要定制化集成,这种"一对一"的模式根本无法规模化。MCP 提供了一种通用协议——开发者只需在智能体中实现一次 MCP,就能接入整个工具生态。
自 2024 年 11 月发布以来,MCP 的发展势头迅猛:社区已构建了数千个 MCP Server,主流编程语言都有了 SDK 支持,MCP 已成为智能体连接工具与数据的事实标准。
问题来了:当开发者动辄连接几十个 MCP 服务、上百甚至上千个工具时,性能瓶颈开始显现。
两个吃掉 Token 的"隐形杀手"
MCP 规模化使用后,有两个因素会显著增加成本和延迟:
第一,工具定义塞满上下文窗口。
大多数 MCP 客户端会预加载所有工具定义到上下文中。每个工具的定义长这样:
gdrive.getDocument
描述:从 Google Drive 检索文档
参数:
documentId(必需,字符串):要检索的文档 ID
fields(可选,字符串):返回的特定字段
返回值:包含标题、正文内容、元数据、权限等的文档对象
一个工具几十上百 Token,连接几千个工具意味着模型在读到用户请求之前,就要先消化十几万 Token 的工具定义。
第二,中间结果反复流经模型。
假设你让智能体执行这个任务:
从 Google Drive 下载我的会议记录,并附加到 Salesforce 的潜在客户信息中。
模型的调用过程是这样的:
工具调用:gdrive.getDocument(documentId: "abc123")
→ 返回"讨论第四季度目标…\\n[完整会议记录]"
(加载到模型上下文)
工具调用:salesforce.updateRecord(
objectType: "SalesMeeting",
recordId: "00Q5f000001abcXYZ",
data: { "备注": "讨论第四季度目标…\\n[完整会议记录]" }
)
(模型需要把会议记录再写一遍到上下文中)
完整的会议记录流经模型两次。一个 2 小时的会议,可能产生 5 万个额外 Token。更大的文档甚至会超出上下文限制,直接导致工作流中断。
而且,当模型在工具调用之间复制大段数据时,出错的概率也会上升。 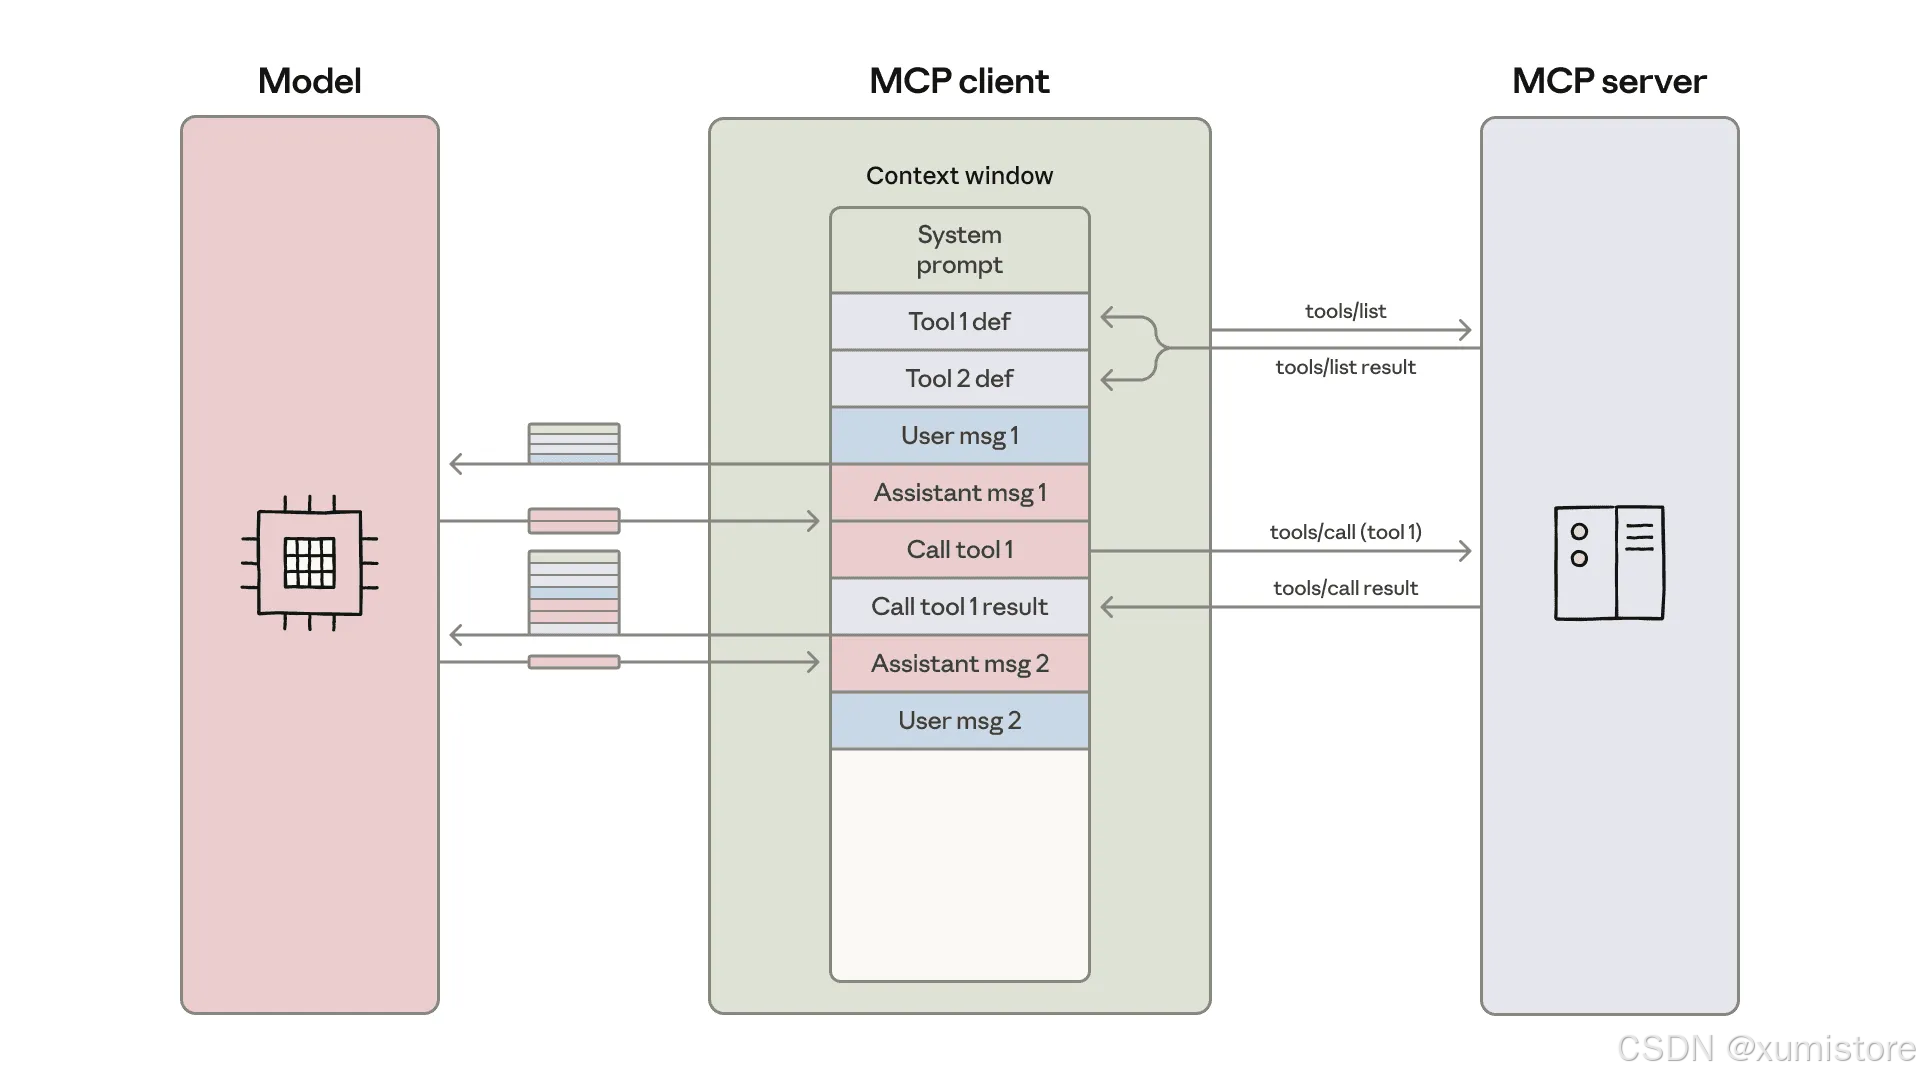
破局之道:让智能体写代码调用工具
代码执行环境在智能体中越来越普及,这为解决上述问题提供了一条优雅的路径:把 MCP 服务暴露为代码 API,而不是直接的工具调用。
这样做有两个核心优势:
具体怎么实现?一种方法是从 MCP 服务生成工具的文件树结构:
servers
├── google-drive
│ ├── getDocument.ts
│ ├── … (其他工具)
│ └── index.ts
├── salesforce
│ ├── updateRecord.ts
│ ├── … (其他工具)
│ └── index.ts
└── … (其他服务)
每个工具对应一个文件,包含类型定义和调用封装:
// ./servers/google-drive/getDocument.ts
import { callMCPTool } from "../../../client.js";
interface GetDocumentInput {
documentId: string;
}
interface GetDocumentResponse {
content: string;
}
/* 从 Google Drive 读取文档 */
export async function getDocument(input: GetDocumentInput): Promise<GetDocumentResponse> {
return callMCPTool<GetDocumentResponse>('google_drive__get_document', input);
}
前面那个"下载会议记录并附加到 Salesforce"的任务,现在变成这样的代码:
import * as gdrive from './servers/google-drive';
import * as salesforce from './servers/salesforce';
const transcript = (await gdrive.getDocument({ documentId: 'abc123' })).content;
await salesforce.updateRecord({
objectType: 'SalesMeeting',
recordId: '00Q5f000001abcXYZ',
data: { Notes: transcript }
});
智能体通过探索文件系统来发现工具:先列出 ./servers/ 目录找到可用服务,再按需读取具体工具文件了解接口定义。这种方式让 Token 消耗从 15 万骤降到 2000——节省 98.7%。
Cloudflare 也发布了类似的研究成果,将这种模式称为"Code Mode"。核心洞察是一致的:大模型天生擅长写代码,开发者应该利用这个优势构建更高效的智能体。
代码执行模式的四大优势
1. 渐进式披露:按需加载工具定义
模型擅长浏览文件系统。当工具以代码形式呈现在文件系统中时,模型可以按需读取,而不是一次性加载所有定义。
另一种做法是在服务端增加 search_tools 工具,支持分层级查询:
- 第一层:只返回工具名称
- 第二层:返回名称 + 描述
- 第三层:返回完整定义
智能体可以根据任务需要选择合适的层级,既省上下文,又能高效找到工具。
2. 数据预处理:过滤后再返回
处理大数据集时,智能体可以在代码中先筛选、转换,再把结果返回给模型。
看一个获取 10,000 行电子表格的场景:
// 没有代码执行:10,000 行全部塞进上下文
TOOL CALL: gdrive.getSheet(sheetId: 'abc123')
→ 返回 10,000 行,模型手动过滤
// 有代码执行:在执行环境中过滤
const allRows = await gdrive.getSheet({ sheetId: 'abc123' });
const pendingOrders = allRows.filter(row =>
row["Status"] === 'pending'
);
console.log(`Found ${pendingOrders.length} pending orders`);
console.log(pendingOrders.slice(0, 5)); // 只返回 5 行供审查
模型看到的是 5 行,不是 10,000 行。聚合计算、多源数据关联、字段提取——这些操作都可以在代码中完成,不会撑爆上下文窗口。
3. 强大的控制流:循环、条件、错误处理
代码执行让智能体可以使用循环、条件判断和错误处理,而不只是单条工具调用链。
比如你需要轮询 Slack 等待部署完成通知:
let found = false;
while (!found) {
const messages = await slack.getChannelHistory({ channel: 'C123456' });
found = messages.some(m => m.text.includes('deployment complete'));
if (!found) await new Promise(r => setTimeout(r, 5000));
}
console.log('Deployment notification received');
这比让模型反复调用工具、等待、再调用高效得多。
还有一个隐藏收益:条件分支在代码执行环境中直接完成,不需要等模型评估 if 语句,首 Token 延迟也降低了。
4. 隐私保护:敏感数据不过模型
代码执行模式下,中间结果默认保留在执行环境中。智能体只能看到你明确打印或返回的数据——那些你不想让模型知道的中间数据,根本不会进入上下文。
对于更敏感的场景,可以让 MCP 客户端自动对敏感数据脱敏。比如你要把客户联系信息从电子表格导入 Salesforce:
const sheet = await gdrive.getSheet({ sheetId: 'abc123' });
for (const row of sheet.rows) {
await salesforce.updateRecord({
objectType: 'Lead',
recordId: row.salesforceId,
data: {
Email: row.email,
Phone: row.phone,
Name: row.name
}
});
}
MCP 客户端在数据抵达模型前拦截并脱敏:
// 智能体看到的是这样的数据:
[
{ salesforceId: '00Q…', email: '[EMAIL_1]', phone: '[PHONE_1]', name: '[NAME_1]' },
{ salesforceId: '00Q…', email: '[EMAIL_2]', phone: '[PHONE_2]', name: '[NAME_2]' },
…
]
当数据流向下一个 MCP 工具时,客户端会自动还原真实值。真实的邮箱、电话、姓名从 Google Sheets 直接流向 Salesforce,始终不经过模型。
技能持久化:让智能体越用越强
代码执行模式还带来一个强大的能力:状态持久化。
智能体可以把中间结果写入文件,实现断点续传:
const leads = await salesforce.query({
query: 'SELECT Id, Email FROM Lead LIMIT 1000'
});
const csvData = leads.map(l => `${l.Id},${l.Email}`).join('\\n');
await fs.writeFile('./workspace/leads.csv', csvData);
// 后续执行从上次中断处继续
const saved = await fs.readFile('./workspace/leads.csv', 'utf-8');
更有价值的是,智能体可以把自己写的代码保存为可复用函数:
// 在 ./skills/save-sheet-as-csv.ts
import * as gdrive from './servers/google-drive';
export async function saveSheetAsCsv(sheetId: string) {
const data = await gdrive.getSheet({ sheetId });
const csv = data.map(row => row.join(',')).join('\\n');
await fs.writeFile(`./workspace/sheet-${sheetId}.csv`, csv);
return `./workspace/sheet-${sheetId}.csv`;
}
// 之后任何执行中都可以复用:
import { saveSheetAsCsv } from './skills/save-sheet-as-csv';
const csvPath = await saveSheetAsCsv('abc123');
这就是 Skills(技能) 的概念——存放可复用指令、脚本和资源的文件夹,提升模型在专业任务上的表现。给这些函数加上 SKILL.md 说明文件,就创建了结构化技能供模型调用。
长此以往,你的智能体会逐步构建起一个高阶能力工具箱,不断进化它的"脚手架"。
权衡:代码执行不是银弹
必须承认,代码执行模式有自己的复杂性。
运行智能体生成的代码,需要一个安全的执行环境,配备适当的沙箱机制、资源限制和监控措施。这些基础设施会增加运营开销和安全考量——而直接工具调用不需要操心这些。
代码执行的核心价值是:降低 Token 成本、减少延迟、提升工具组合能力。这些收益需要与实施成本权衡。
总结
MCP 为智能体提供了连接万物的基础协议。但当连接的服务和工具越来越多,工具定义和中间结果会消耗大量 Token,拖慢智能体效率。
虽然"上下文管理"“工具组合”"状态持久化"这些问题听起来很新,但在软件工程领域早有成熟方案。代码执行模式把这些经典模式应用到智能体开发中,让模型用熟悉的编程方式更高效地与 MCP 服务交互。
从 15 万 Token 到 2000 Token,这不只是数字游戏——这是智能体从"玩具"走向"生产"的必经之路。