本章是全书从理论转向实践的关键枢纽,系统性地梳理了Linux系统性能观测的“工具箱”全景图。作者Brendan Gregg强调,避免“街灯讹方法”(即只使用自己熟悉的工具,如top,而忽视其他更合适的工具)是进行有效性能分析的前提。本章不仅列举了工具,更构建了一个基于观测对象与方法的分类框架,并深入揭示了数据来源(如/proc、/sys),为后续针对CPU、内存、文件系统等具体组件的深入分析奠定了方法论基础。
一、观测工具的分类框架
作者根据观测对象(系统级 vs. 进程级)和观测方法(计数器 vs. 事件)两个维度,将性能工具划分为四个象限,这有助于我们根据问题场景选择正确的工。
1. 固定计数器(Fixed Counters)
这类工具读取由内核维护的各种统计计数器(如CPU周期、磁盘I/O次数、网络包数量),提供系统或进程在某个时间点的资源使用快照。
- 系统级别:vmstat(虚拟内存统计)、mpstat(每CPU统计)、iostat(磁盘I/O统计)、nstat(网络栈统计)、sar(系统活动报告器)。这些是性能排查的“第一响应”工具,用于快速了解系统整体负载和瓶颈方向。例如,top命令不仅显示进程列表,其顶部的汇总行还隐含了关键信息:最近1、5、15分钟的负载平均值,以及CPU时间在用户态、内核态、I/O等待(iowait)等状态间的分布,能初步判断瓶颈所在。
- 进程级别:ps(进程状态)、top(动态进程视图)、pmap(进程内存映射)。它们用于识别消耗资源最多的具体进程及其ID、命令行等信息。
2. 剖析(Profiling)
剖析旨在揭示在某一时刻或短时间段内,某项资源(如CPU)的使用构成。它回答“CPU时间具体花在了哪些函数或代码路径上?”的问题。
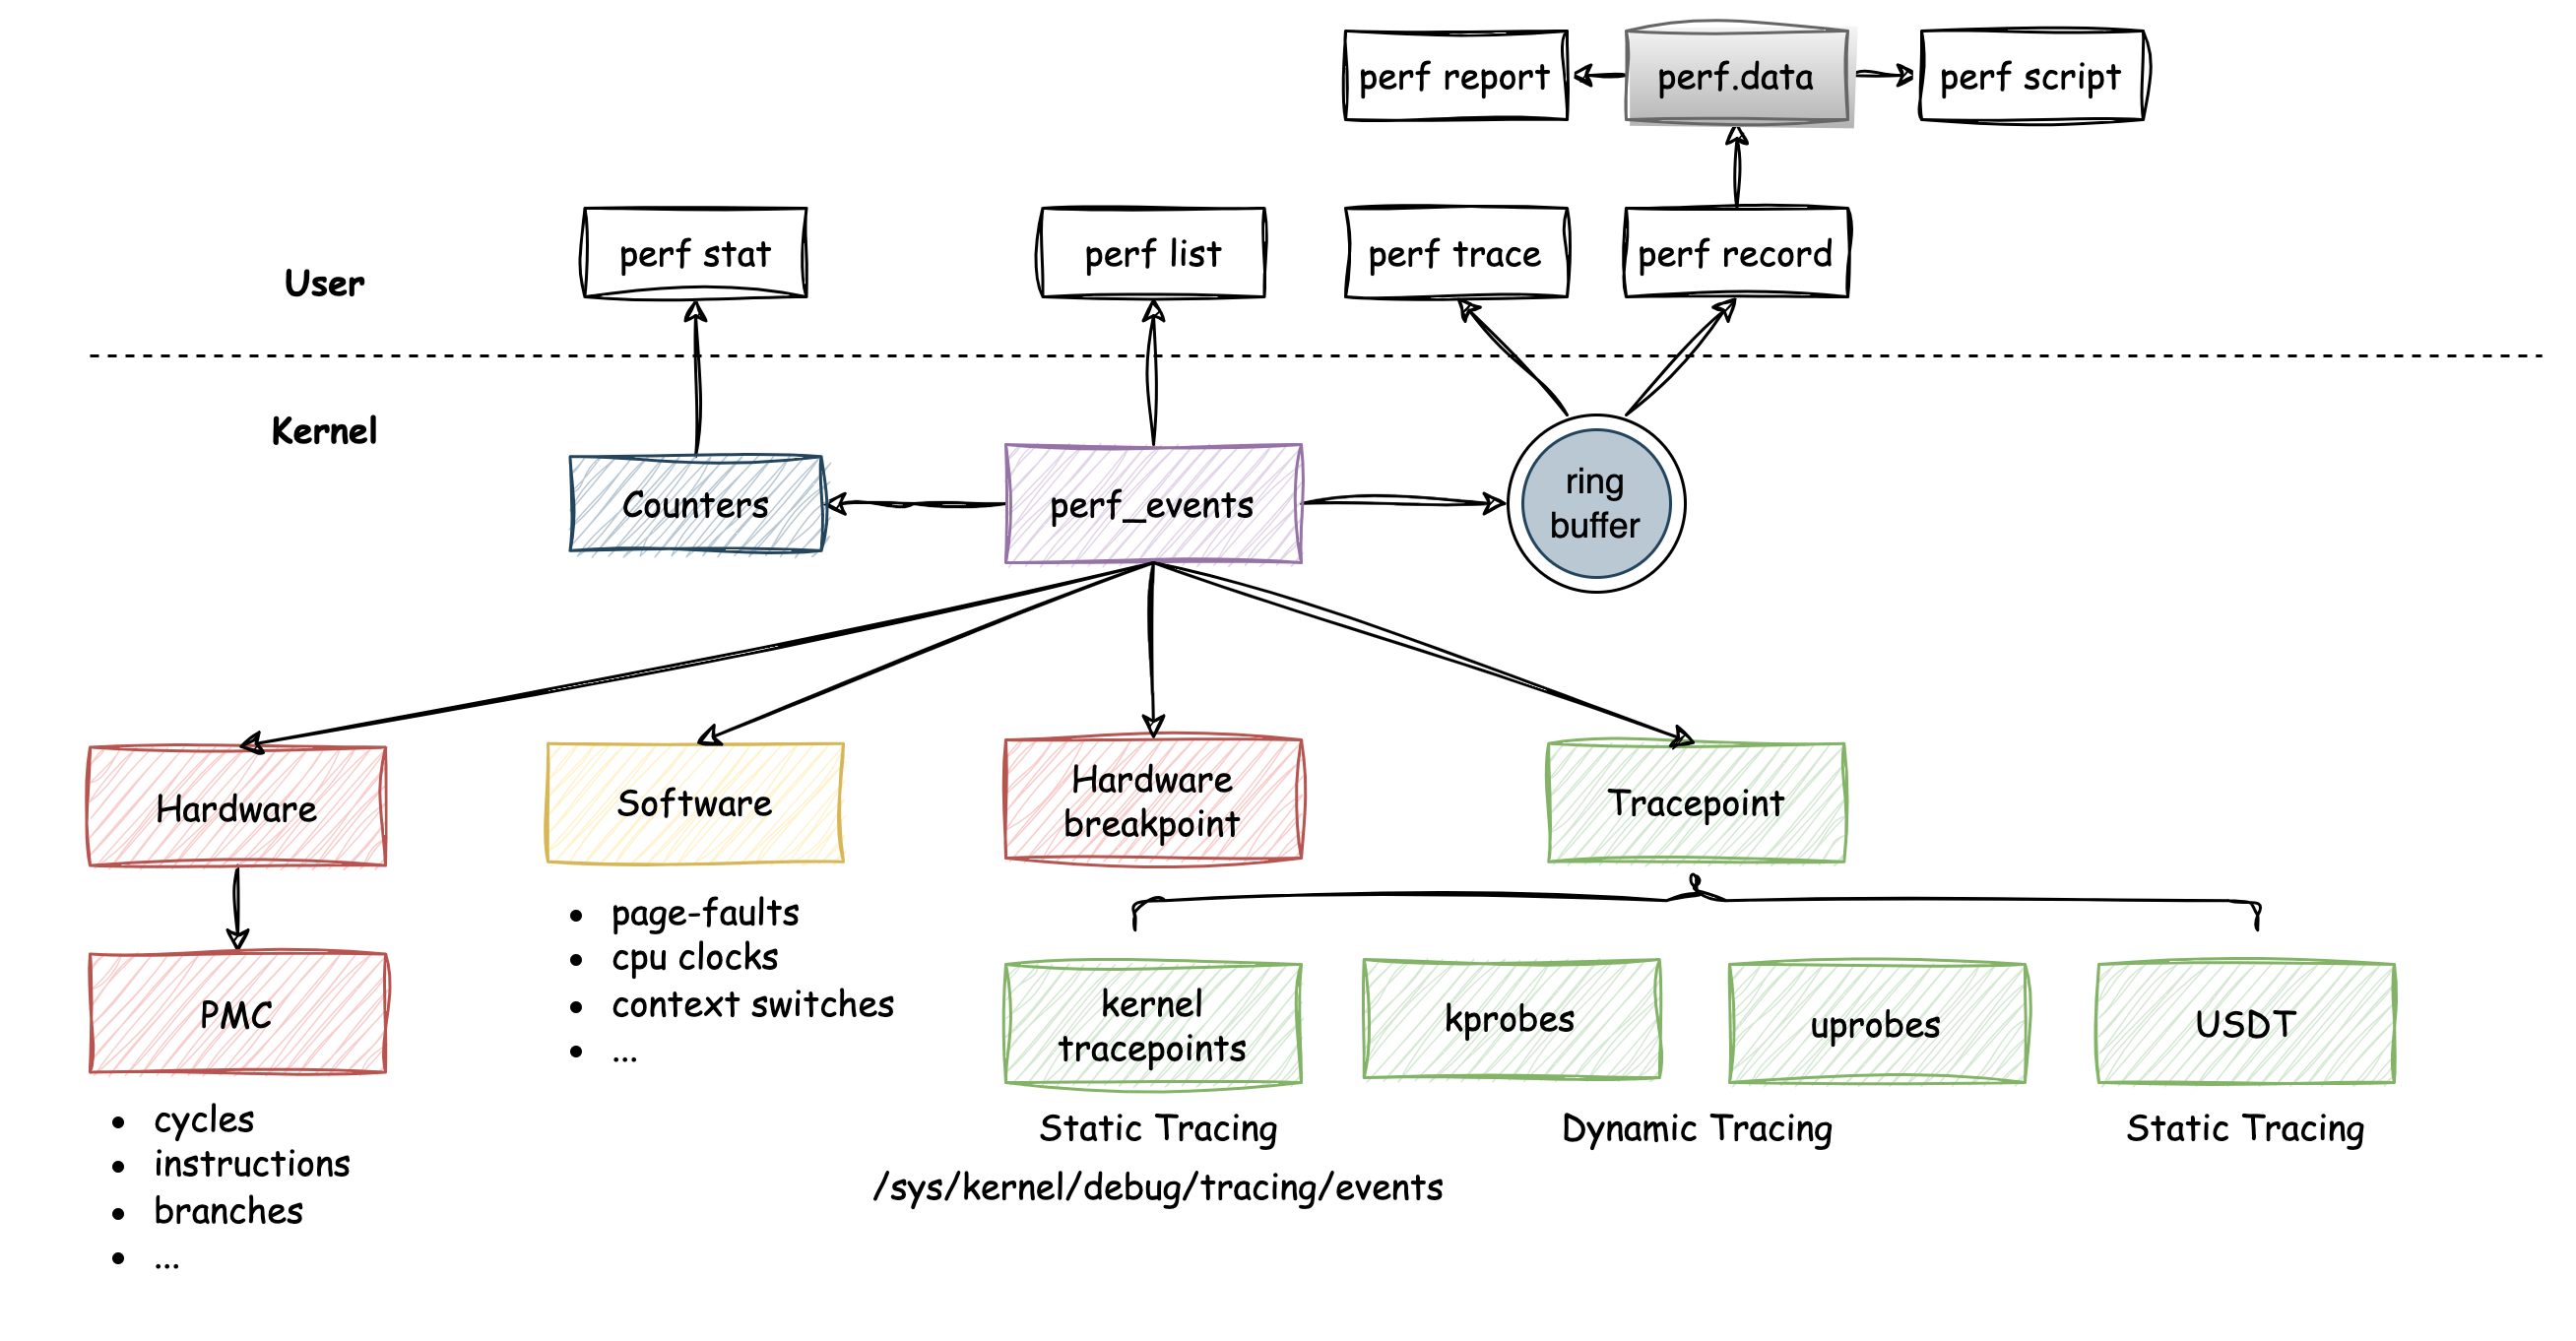
- 常用工具:perf是Linux标准的性能剖析工具。此外,还有针对特定场景的工具,如BCC中的profile(基于BPF的CPU剖析器)、Intel VTune Amplifier XE(带图形界面的剖析器),以及针对特定语言的剖析器,如Java Flight Recorder (JFR)。
3. 跟踪(Tracing)
跟踪记录一段时间内发生的具体事件,提供详细的、带有时间戳的流水账,用于深入分析特定操作的完整链条。
- 系统级别:
- tcpdump:经典的网络数据包捕获工具。
- biosnoop、execsnoop:分别用于跟踪块I/O事件和新进程创建事件,基于BCC或bpftrace。
- Ftrace:Linux内核内置的跟踪框架。
- BCC & bpftrace:本书作者大力推荐的基于eBPF的现代跟踪工具集,功能强大且灵活。
- perf trace:perf工具的子命令,用于全系统范围的系统调用跟踪。
- 进程级别:
- strace:跟踪进程发起的系统调用,是排查进程行为(如文件、网络访问)的利器。
- gdb:源码级调试器。
4. 监测(Monitoring)
监测指定期、持续地采集和记录性能数据,以便进行历史查询、趋势分析和告警。
- 常用工具:
- sar:功能强大的系统活动数据收集器,可以收集CPU、内存、磁盘、网络等数十种指标,并能将数据存档以备查询。其历史日志通常位于/var/log/sa或/var/log/sar目录下。
- SNMP:广泛应用于监控网络设备、服务器硬件的标准协议。
- 代理(Agents):为获取特定应用(如数据库、Web服务器)的深度指标,常需安装专用代理(如Prometheus exporters)来收集并上报数据。
二、观测数据的来源
理解工具的数据来源,能让我们在标准工具受限时,直接获取原始信息,甚至开发自定义工具。
1. /proc 文件系统
/proc是一个由内核动态生成的虚拟文件系统,是众多性能工具的数据基石。
- 系统信息:/proc/meminfo、/proc/cpuinfo、/proc/slabinfo等文件提供了系统级的性能数据。vmstat、top、free等命令正是读取这些文件。直接查看这些文件有时能获得比工具输出更详细的信息,例如/proc/meminfo会详细列出Slab缓存的使用情况,而free命令通常不显示此细节。
- 进程信息:每个运行中的进程在/proc下都有一个以其PID命名的目录,包含该进程的详细信息。其中/proc/<PID>/fd/目录尤为实用,它包含了该进程打开的所有文件描述符的符号链接。当误删了被进程打开的文件(如日志文件)导致磁盘空间未释放时,可以通过清空对应的fd链接来释放空间,而无需重启进程。
2. /sys 文件系统
/sys(sysfs)是另一个重要的虚拟文件系统,它提供了一个用于查看和配置内核参数、硬件设备的统一接口。例如,在/sys/devices/system/cpu/目录下,可以查看每个CPU的在线状态、缓存信息,甚至通过向online文件写入0或1来动态下线或上线CPU。
3. 跟踪点(Tracepoints)、探针(Probes)与延时核算
- Tracepoints:是内核代码中预置的静态检测点,例如在系统调用、块I/O请求发起和完成处都有。它们可以通过perf等工具进行跟踪,开销相对较低。使用perf list tracepoint可以查看可用的跟踪点。
- kprobes & uprobes:分别是内核空间和用户空间的动态探针。与tracepoint相比,它们可以跟踪几乎任何内核或用户态函数,灵活性极高,是bpftrace等强大工具的基础。
- 延时核算:当内核配置CONFIG_TASK_DELAY_ACCT启用后,可以跟踪每个任务的多种延时,包括:调度器延时(等待CPU)、块I/O延时(等待块I/O完成)、交换延时(等待换页)、内存回收延时。这对于分析应用延迟的根源至关重要。
三、核心工具 sar 与性能分析方法论启示
1. sar 工具详解
sar(System Activity Reporter)是本章重点介绍的多面手工具,它横跨了计数器、剖析(通过高频率采样)和监测三大功能。
- 历史数据查询:如果系统已启用sar数据收集(通常由sysstat包中的sadc守护进程完成),则可以使用sar -u(CPU)、sar -n TCP(网络TCP指标)等命令查询历史数据。
- 实时监控:也可以指定采样间隔和次数进行实时监控,例如sar -n TCP 1 5表示每秒采样一次TCP统计,共采样5次。
2. 本章对性能分析工作的核心启示
总之,第四章为我们绘制了一张详尽的Linux性能观测“地图”。它告诉我们有哪些“工具”(What),这些工具属于什么“类型”(Why),以及它们的数据从何而来(How)。掌握本章内容,是摆脱对单一工具的盲目依赖、进行科学、系统化性能分析的关键一步。