🏆 本文收录于 《YOLOv10实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv10 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv10 的网络结构、训练策略、标签分配、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Consistent Dual Assignments(一致性双重标签分配)、NMS-Free End-to-End Detection(无 NMS 端到端检测)、Holistic Efficiency-Accuracy Driven Model Design(整体效率-精度驱动模型设计) 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv10 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️
🎉 本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉 《YOLOv8实战》 👉 《YOLOv9实战》 👉 《YOLOv10实战》 👉 《YOLOv11实战》 👉 《YOLOv12实战》 👉 以及最新上线的 《YOLOv26实战》
想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀 想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
🎯 本文定位:计算机视觉 × YOLOv10 核心架构原理篇 📅 预计阅读时间:约 45~60 分钟 🏷️ 难度等级:⭐⭐⭐☆☆(进阶级) 🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv10 · ByteTrack · OpenCV · NumPy
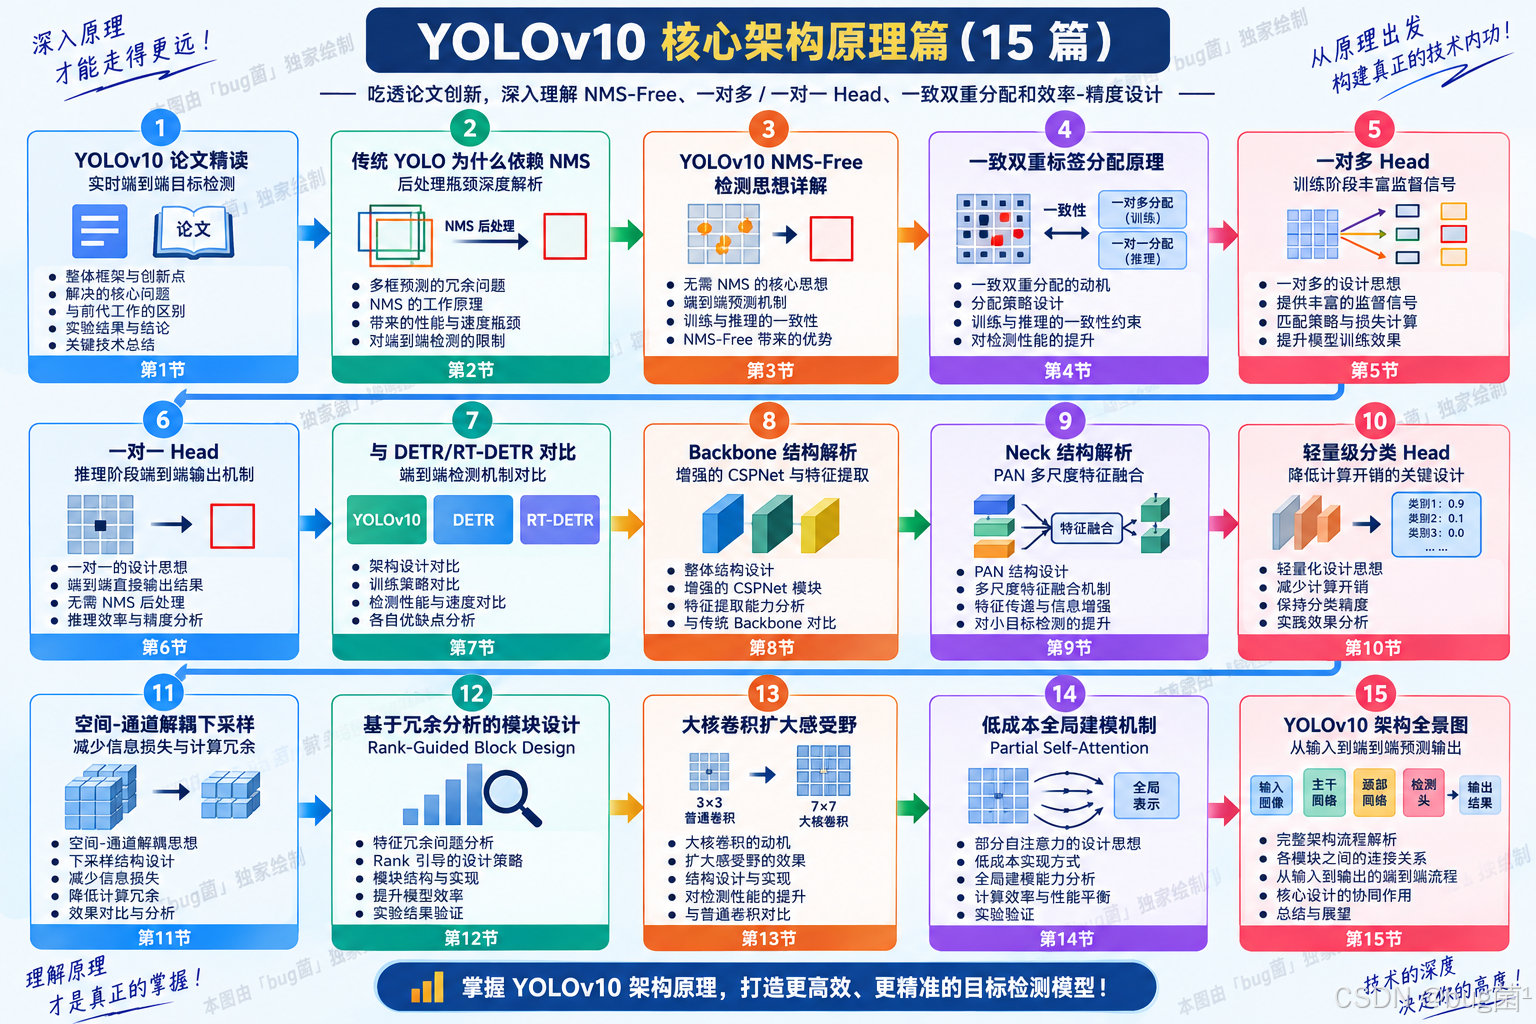
全文目录:
-
- 📌 上期回顾
-
- NMS的根本问题
- YOLOv10的NMS-Free核心思路
- 🎯 本节主题:一致双重标签分配 Consistent Dual Assignments 原理
-
- 一、从一个根本性的问题说起
- 二、标签分配的背景知识:从暴力匹配到动态分配
-
- 2.1 标签分配是什么?
- 2.2 标签分配方法的演进历程
- 三、One-to-One分配的困境:为何朴素方案不奏效
-
- 3.1 匈牙利算法:端到端检测的经典方案
- 3.2 朴素的"直接用One-to-One训练"为什么不行
- 四、一致双重标签分配:核心思想
-
- 4.1 整体架构设计
- 4.2 一致性的含义:为什么叫"Consistent"?
- 4.3 为什么"一致性"是解决训练困难的关键?
- 五、数学原理深度解析
-
- 5.1 TAL(Task-Aligned Learning)标签分配细节
- 5.2 一致性约束的数学形式
- 5.3 推理时的简洁性
- 六、与其他方案的对比分析
-
- 6.1 方案对比矩阵
- 6.2 与DETR系列的对比
- 6.3 与RT-DETR的对比
- 七、完整代码实现与解析
-
- 7.1 环境准备
- 7.2 TAL核心实现
- 7.3 一致双重标签分配器
- 7.4 可视化:理解分配过程
- 7.5 代码解析
- 八、训练动态分析:一致性如何影响收敛曲线
-
- 8.1 三个训练阶段的分配行为变化
- 8.2 损失曲线的期望行为
- 九、工程实践中的注意事项
-
- 9.1 topk的选择
- 9.2 不同输入分辨率下的行为
- 9.3 密集场景下的挑战
- 十、从直觉上理解:一个生动的类比
- 十一、与论文的对应关系
- 🔮 下期预告:One-to-Many Head 训练阶段丰富监督信号解析
- 📌 附录
- 🫵 Who am I?
写在前面:如果你跟着这个专栏一路走到这里,恭喜你已经跨过了"YOLO为什么要去掉NMS"这道坎。上一节我们聊透了NMS-Free的核心思想,今天这一节是整个YOLOv10架构设计中我个人最喜欢的部分——一致双重标签分配(Consistent Dual Assignments)。这个机制听起来有点绕,但一旦你理解了它解决的问题,你会觉得这个设计真的很优雅,甚至有点妙。
📌 上期回顾
在上期《YOLOv10【第二章:核心架构原理篇·第3节】YOLOv10 NMS-Free 检测思想详解!》内容中,我们深度剖析了YOLOv10为何要彻底抛弃NMS(Non-Maximum Suppression,非极大值抑制),以及它是如何做到这一点的。让我们用最简洁的语言回顾核心要点:
NMS的根本问题
传统YOLO(包括v5、v8等版本)在推理阶段,模型会为同一个目标预测出大量候选框(Bounding Box)。这些重叠的候选框需要通过NMS进行过滤——保留置信度最高的那个,抑制其余重叠框。
NMS的代价是双重的:
第一,它引入了额外的推理延迟。NMS本身的计算复杂度随着候选框数量增加而上升,在密集场景下尤为明显。更致命的是,NMS无法被完整地融入端到端的训练优化流程——它是后处理模块,梯度无法流过它。
第二,NMS依赖超参数(IoU阈值、置信度阈值),这些参数需要针对不同数据集、不同场景进行精心调优。一旦参数设置不当,要么误删真实目标,要么保留过多重复框。
YOLOv10的NMS-Free核心思路
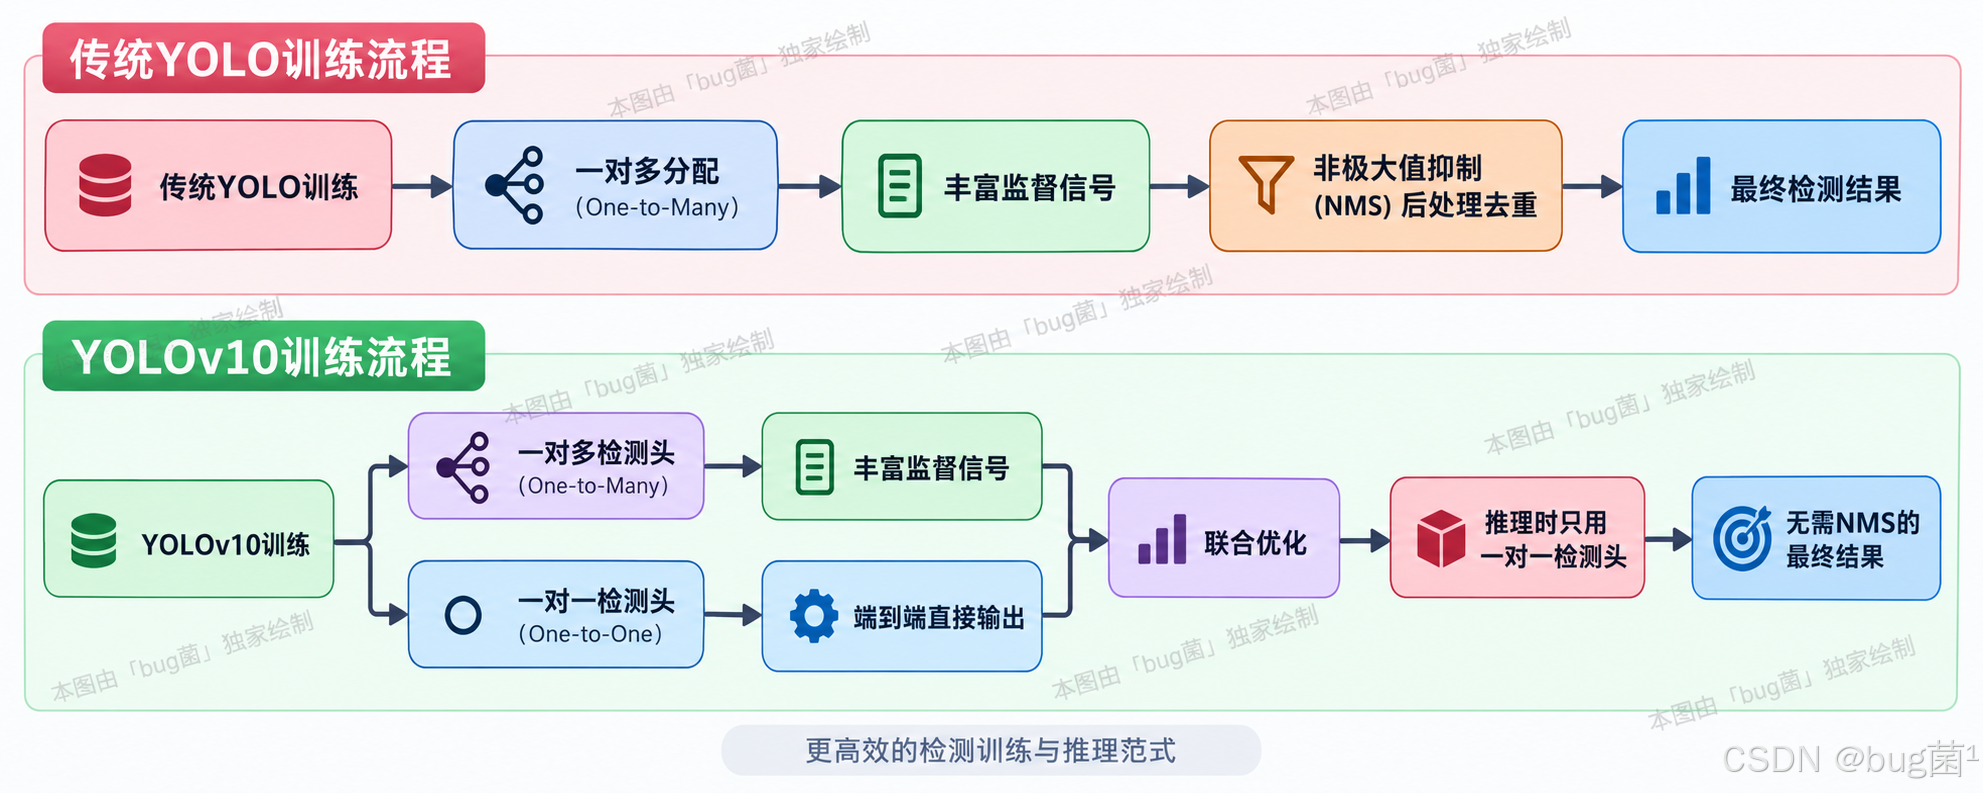
YOLOv10的回答是:与其在后处理阶段去重,不如在训练阶段就让模型学会"每个目标只输出一个预测框"。
为了实现这个目标,YOLOv10引入了两个Head:
- One-to-Many Head:训练阶段使用,一个真实目标可以匹配多个预测框,提供丰富的监督信号;
- One-to-One Head:推理阶段使用,一个真实目标严格对应一个预测框,无需NMS。
这个设计的核心挑战在于:如何让One-to-One Head在训练时获得足够好的优化信号? 这正是本节要解答的问题——一致双重标签分配机制。
相关示意图绘制如下,仅供参考:
好,上期内容已经回顾完毕。今天我们进入本节主角——一致双重标签分配,这是整个NMS-Free机制能够真正奏效的关键所在。
🎯 本节主题:一致双重标签分配 Consistent Dual Assignments 原理
一、从一个根本性的问题说起
在上一节的末尾,我们留下了一个悬念:YOLOv10同时设计了One-to-Many Head和One-to-One Head,但这两个Head在训练时如何协同工作?
让我们先把这个问题拆解得更具体一些。
假设当前有一张图片,图片中有3个目标(3个Ground Truth Box,简称GT Box)。模型的特征金字塔会输出成千上万个候选预测位置(Anchor Points)。
训练时面临的标签分配问题:
- 对于One-to-Many Head:每个GT Box可以匹配多个Anchor Points(比如10个),共3×10=30个正样本,监督信号丰富,训练稳定;
- 对于One-to-One Head:每个GT Box只能匹配1个Anchor Point,共3个正样本,正样本极度稀少,训练信号极其微弱。
这里就出现了一个深刻的矛盾:
One-to-One Head的正样本数量太少(只有One-to-Many的1/10甚至更少),如果单独训练,梯度信号极其稀疏,模型很难收敛到一个好的状态。但如果不解决这个问题,One-to-One Head的输出质量就会很差,进而导致整个NMS-Free推理性能下降。
这不是一个可以用"多训几个epoch"来弥补的问题——这是一个结构性的训练困境。
YOLOv10的解决方案是什么?
答案就是本节的主题:一致双重标签分配(Consistent Dual Assignments)。
二、标签分配的背景知识:从暴力匹配到动态分配
在深入理解一致双重标签分配之前,我们需要先把标签分配(Label Assignment)这件事说清楚。这是目标检测训练中一个非常基础但又极其重要的环节,很多读者可能在使用YOLO时从来没有意识到这件事的存在,但它对训练结果的影响是决定性的。
2.1 标签分配是什么?
在目标检测的训练过程中,模型会在图像上密集地预测成千上万个候选框。而真实标注(GT Box)只有寥寥几个。
标签分配解决的核心问题是:哪些预测位置(Anchor Points)应该被"分配"给哪个GT Box,成为正样本参与训练?
这个问题看似简单,但实际上是训练质量的关键决定因素之一:
- 正样本分配得太少:梯度信号稀疏,模型训练慢甚至不收敛;
- 正样本分配得太多或太乱:引入大量低质量正样本,模型学到噪声;
- 正样本分配不一致:同一个目标在不同训练步骤被分配给不同质量的预测,训练不稳定。
2.2 标签分配方法的演进历程
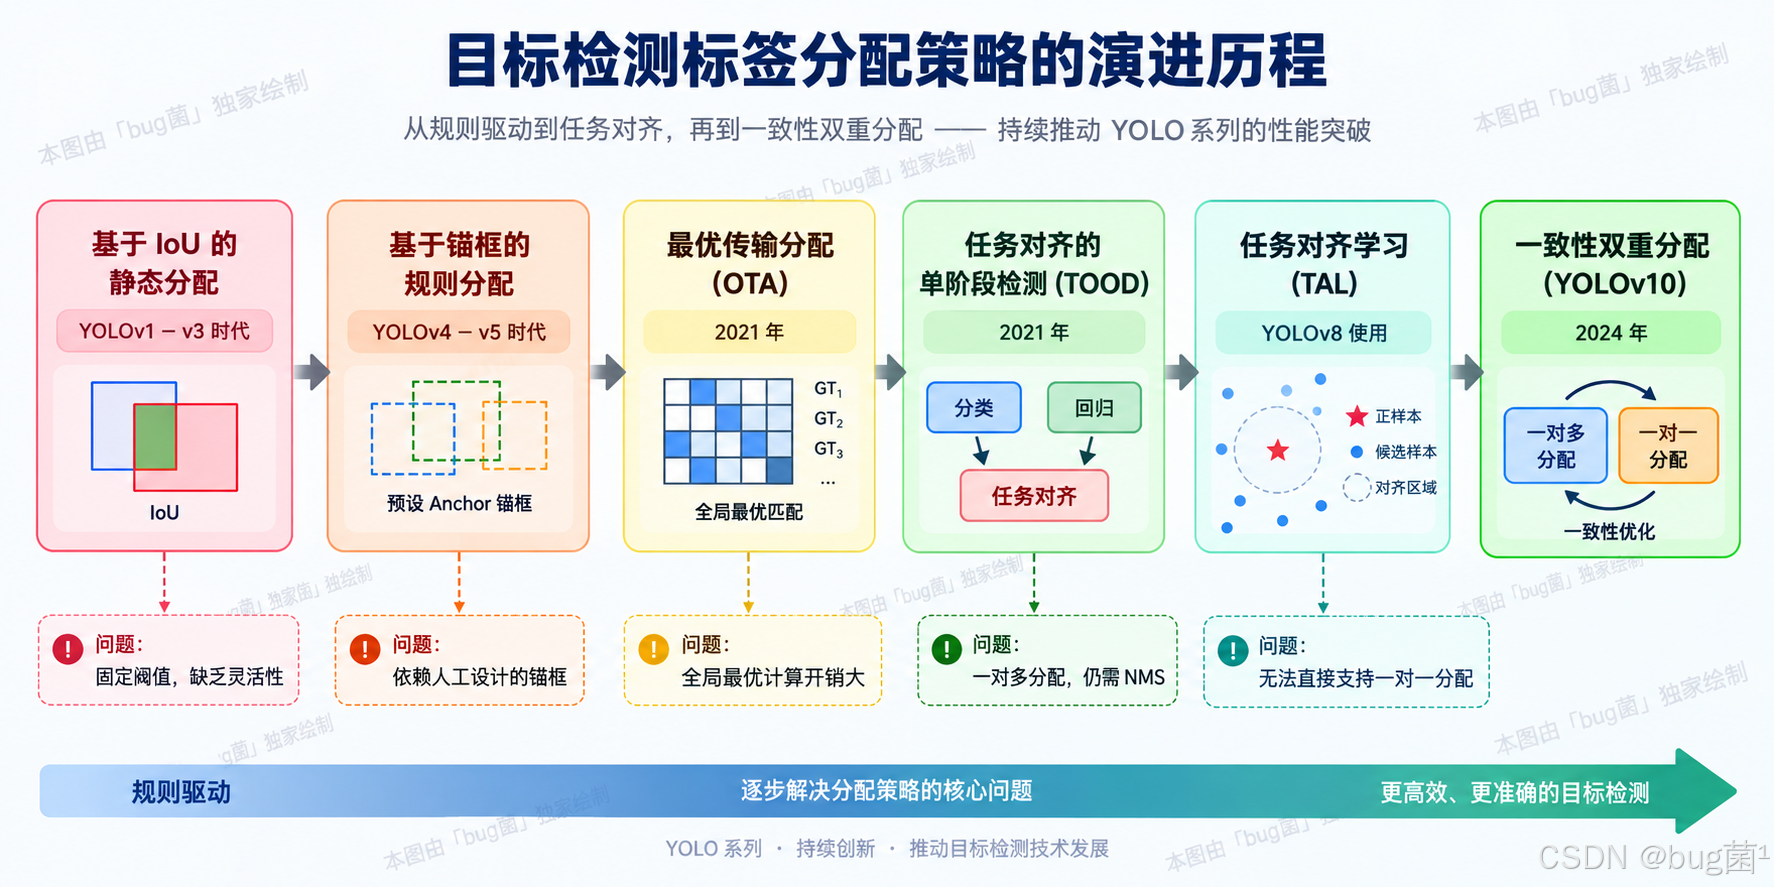
让我们快速梳理一下标签分配方法的发展脉络,这有助于你理解YOLOv10的设计是站在哪个肩膀上的。
相关示意图绘制如下,仅供参考:
第一阶段:基于IoU的静态分配
最早的标签分配方式极其简单粗暴:计算每个预测框与GT Box的IoU,超过某个阈值(比如0.5)就是正样本,低于某个阈值(比如0.4)就是负样本,中间的忽略不计。
这种方法的问题在于:阈值是固定的,完全不考虑当前模型的预测质量,也不考虑GT Box的大小和形状差异。
第二阶段:基于Anchor的规则分配
YOLOv4、YOLOv5时代引入了基于Anchor的分配策略。为每个尺度预定义若干个Anchor(先验框),GT Box与哪个Anchor的宽高比最接近,就分配给对应的Anchor负责预测。
这种方式更有结构性,但引入了Anchor设计的人工先验,而且在目标尺寸分布差异大的场景下表现不稳定。
第三阶段:动态分配——OTA与TAL
2021年前后,动态标签分配开始成为主流。其核心思想是:好的正样本应该是那些预测质量本身就较高的位置——预测得越准,就越应该被选为正样本参与监督。
YOLOv8使用的TAL(Task-Aligned Learning)就是这种思路的典型代表。TAL定义了一个对齐分数(Alignment Score):
A
l
i
g
n
S
c
o
r
e
=
C
l
s
S
c
o
r
e
α
×
I
o
U
β
\\mathrm{AlignScore} = \\mathrm{ClsScore}^{\\alpha} \\times \\mathrm{IoU}^{\\beta}
AlignScore=ClsScoreα×IoUβ
其中,Cls_Score是分类预测置信度,IoU是预测框与GT Box的交并比,α和β是超参数。对齐分数越高,意味着这个预测位置在分类和定位两个任务上都表现良好,因此更适合作为正样本。
TAL基于这个分数动态地为每个GT Box选取Top-K个得分最高的预测位置作为正样本。这比固定IoU阈值方式更灵活,训练效果也更好。
但TAL依然是One-to-Many的——它依然依赖NMS。
这就是YOLOv10需要解决的下一个问题。
三、One-to-One分配的困境:为何朴素方案不奏效
在理解了传统标签分配方法之后,我们来正式面对One-to-One分配的困境。
3.1 匈牙利算法:端到端检测的经典方案
如果你了解DETR(Detection Transformer),你肯定知道匈牙利算法(Hungarian Algorithm)在One-to-One标签分配中的应用。
DETR的训练方式是:对于每张图片,将所有GT Box与模型输出的所有查询向量(Query)进行二分图最优匹配,找到一个全局最优的一对一配对方案,使得总体匹配代价最小。
这个方案在理论上非常优雅:
- 严格的一对一分配,训练和推理完全一致;
- 无需NMS,端到端训练;
- 全局最优匹配,理论上利用了所有可能的配对信息。
但匈牙利算法有一个众所周知的严重问题:训练收敛极其缓慢。
DETR需要训练500个epoch才能达到与Faster R-CNN相当的性能,而后者只需要训练12个epoch。这个收敛速度的差距在实际工程中是灾难性的。
收敛慢的根本原因在于:在训练初期,模型的预测是随机的,匈牙利算法每一步都在做随机配对,梯度信号高度不稳定,模型无法建立稳定的学习路径。
后续的DAB-DETR、DN-DETR等工作通过各种技巧缓解了这个问题,但根本困境仍然存在——One-to-One分配天然比One-to-Many分配获得的训练信号少得多。
3.2 朴素的"直接用One-to-One训练"为什么不行
有些读者可能会想:既然DETR可以纯One-to-One训练,为什么YOLOv10不直接采用同样的方式,只用One-to-One Head?
原因是多方面的:
原因一:YOLO架构的预测密度问题
DETR只有少量查询向量(比如100个),每个查询向量都有全局感受野,可以关注图像的任意位置。而YOLO架构在特征金字塔的每个位置都会输出预测,候选预测数量可能高达8400个(以640×640输入为例)。
在这8400个位置中,只有极少数真正接近GT Box,一对一匹配的正样本占比极低(可能只有0.03%),绝大多数位置的梯度都是负样本的背景梯度。这种极度不平衡会让训练非常不稳定。
原因二:局部感受野的限制
DETR的注意力机制让每个查询可以感知全图信息,匈牙利算法能够做全局最优匹配。而YOLO的卷积架构每个预测位置的感受野相对有限(即使有FPN),One-to-One匹配时如果错误地把GT分配给了一个离GT中心很远的预测位置,这个位置的特征本身就不包含足够的目标信息,梯度无法有效传播。
原因三:动态分配的稳定性问题
如果直接把TAL改造成一对一版本(每个GT只选1个最高分的预测位置),在训练初期模型预测质量极差,"最高分"的位置可能只是随机噪声,分配结果高度不稳定,严重影响收敛。
这就是为什么我们需要一个更聪明的方案——一致双重标签分配。
四、一致双重标签分配:核心思想
终于到了本节的核心。我们来完整地拆解**一致双重标签分配(Consistent Dual Assignments)**的设计思想。
4.1 整体架构设计
YOLOv10的训练架构包含两个并行的预测头:
相关示意图绘制如下,仅供参考:
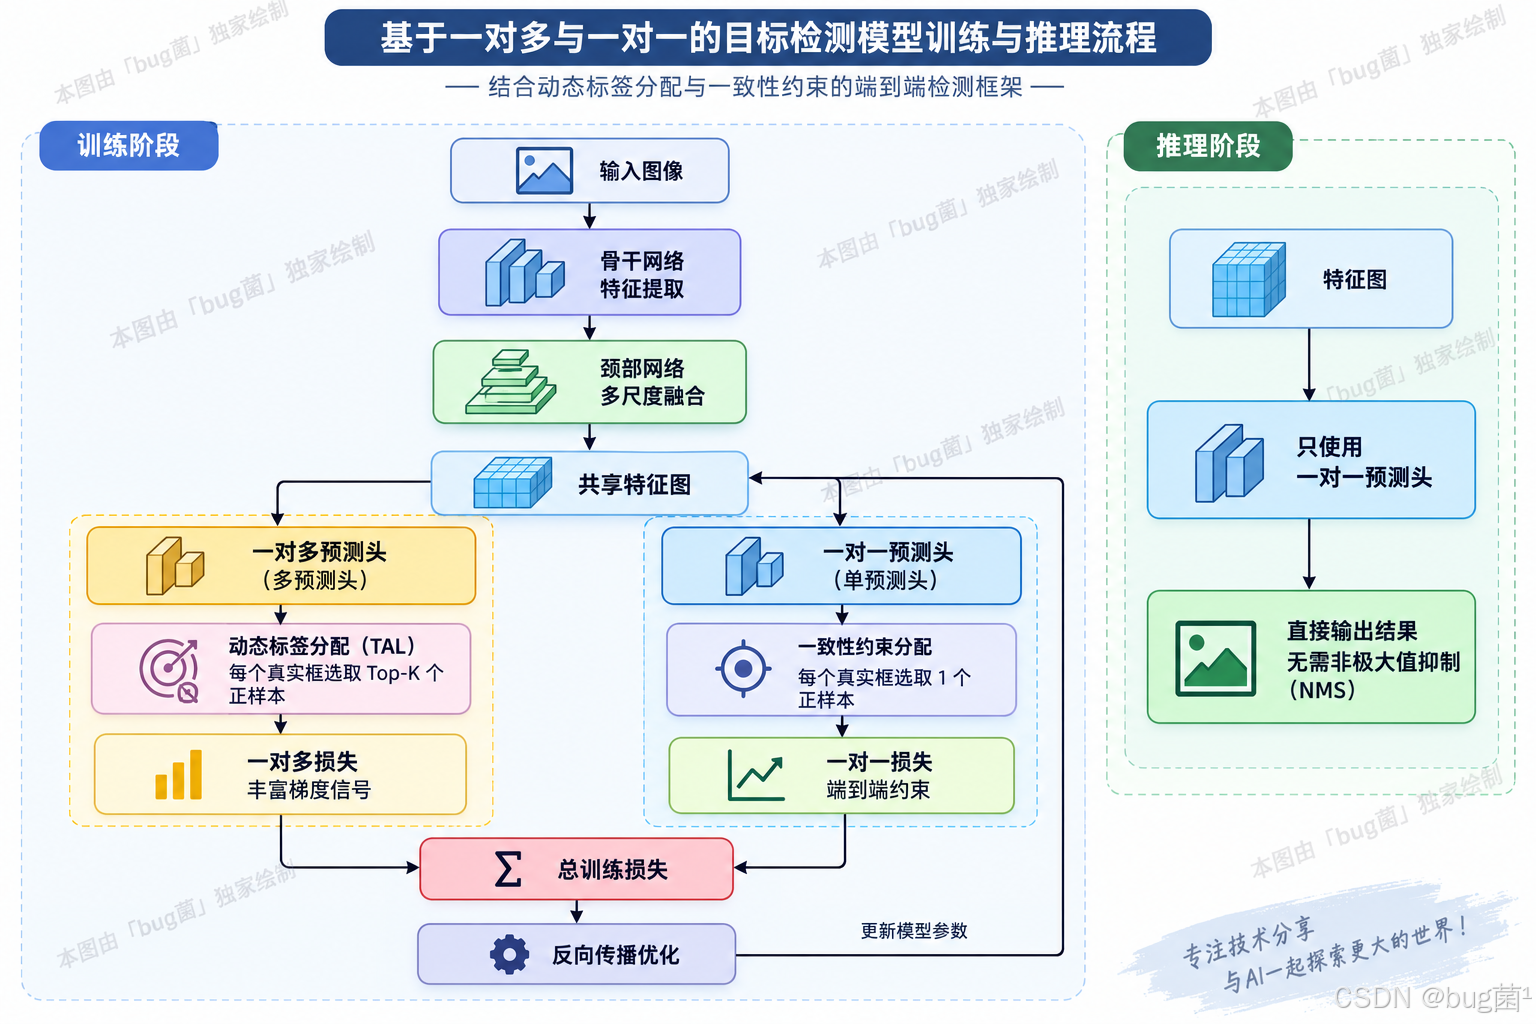
两个Head共享同一套Backbone和Neck的特征,只在最后的预测层有所不同:
- One-to-Many Head:结构与YOLOv8的预测头相同,输出多个预测框;
- One-to-One Head:在One-to-Many Head的基础上,增加了额外的卷积层,专门学习"选出唯一最优预测"的能力。
训练时:两个Head同时工作,各自计算损失,加权求和得到总损失; 推理时:One-to-Many Head被完全丢弃,只保留One-to-One Head进行预测,不需要NMS。
4.2 一致性的含义:为什么叫"Consistent"?
这里的"Consistent"(一致)是这个机制最核心的设计哲学,也是它区别于简单"双Head"设计的本质所在。
关键问题:One-to-One Head的训练标签从哪里来?
朴素的方案是:对One-to-One Head单独做标签分配,比如直接用匈牙利算法或者"TAL选Top-1"。
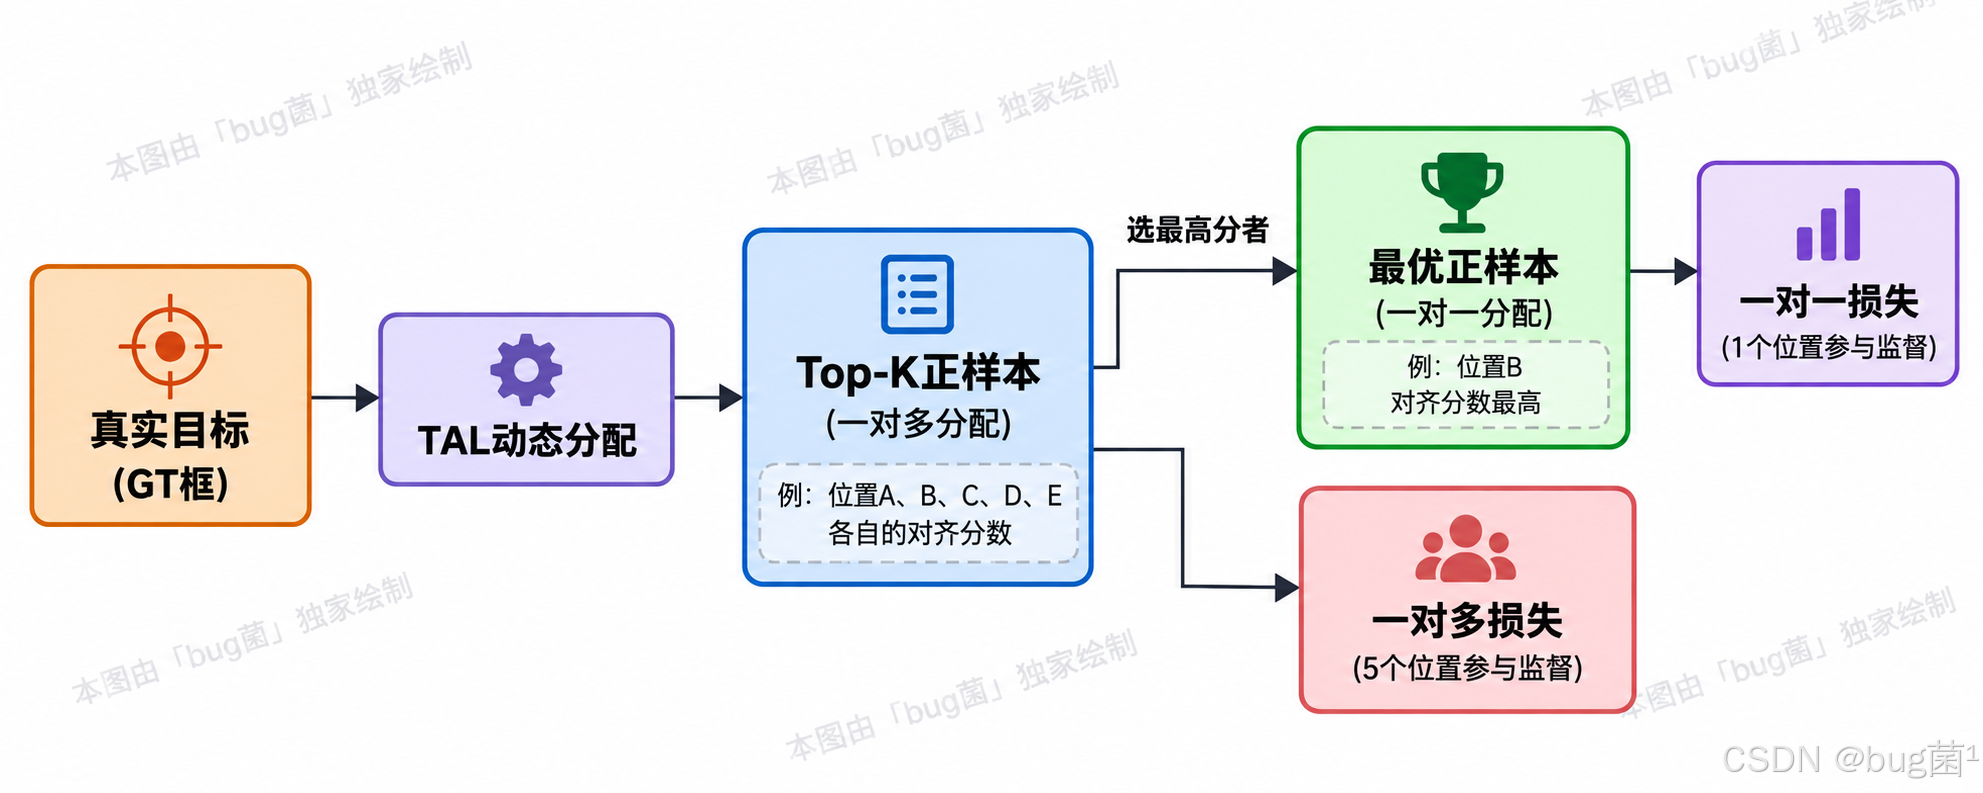
但YOLOv10的选择更聪明——One-to-One Head的训练标签,直接从One-to-Many的分配结果中继承。
具体来说:
用公式来描述就是:
KaTeX parse error: Double subscript at position 93: …s}_\\text{score}_̲j^{\\alpha} \\tim…
其中:
-
A
O
2
O
\\mathcal{A}^{O2O}
AO2O 是One-to-One分配的正样本集合; -
A
g
t
i
O
2
M
\\mathcal{A}^{O2M}_{gt_i}
AgtiO2M 是One-to-Many分配给第i
i
i 个GT Box的正样本集合(Top-K个); - KaTeX parse error: Expected 'EOF', got '_' at position 10: \\text{cls_̲score}_j 是位置
j
j
j 的分类置信度预测; -
iou
j
\\text{iou}_j
iouj 是位置j
j
j 的预测框与GT Box的IoU; -
α
,
β
\\alpha, \\beta
α,β 是权重超参数。
这个"继承"设计的深刻含义在于:
One-to-One Head的正样本,永远是One-to-Many的正样本的子集,而且是质量最高的那一个。这确保了两个Head在学习目标上的一致性——它们不会"鸡同鸭讲",互相矛盾,而是朝着同一个方向优化。
相关示意图绘制如下,仅供参考:
4.3 为什么"一致性"是解决训练困难的关键?
现在让我们来分析,这个看似简单的"继承"设计,为什么能够有效解决One-to-One训练的困难。
问题一:正样本稀少导致梯度微弱
解决方案:One-to-One Head虽然正样本只有1个,但它从不孤立地训练。One-to-Many Head提供了丰富的梯度信号,两个Head共享Backbone和Neck的全部参数。One-to-Many的大量正样本梯度会通过共享参数层传递,间接地帮助One-to-One Head建立良好的特征表示能力。
One-to-One Head只需要在这个"已经被One-to-Many训练得相对较好"的特征基础上,学习如何"做出唯一的最终决策"。这个任务比从零开始学习要容易得多。
问题二:分配不稳定导致训练震荡
解决方案:One-to-One的正样本来自One-to-Many的Top-K中选最优,而不是从全部8400个候选中随机选。这意味着One-to-One的正样本已经经过了One-to-Many的"预筛选",质量有保证,分配结果更稳定。
相比直接在全局范围内做一对一匹配,这种"先粗筛再精选"的策略大大降低了分配结果的随机性。
问题三:两个Head学习目标不一致导致互相干扰
这是最关键的一点。如果One-to-Many和One-to-One用完全不同的标签分配策略,可能会出现这样的情况:One-to-Many认为位置A是好的正样本,但One-to-One认为位置B才是正样本,两者对Backbone的梯度方向相反,互相抵消,导致训练不稳定。
一致性设计彻底避免了这个问题:One-to-One的正样本B是One-to-Many正样本{A,B,C,D,E}中对齐分数最高的,两者的学习目标完全一致,梯度方向协同而非对抗。
五、数学原理深度解析
5.1 TAL(Task-Aligned Learning)标签分配细节
由于一致双重标签分配的核心基于TAL,我们需要把TAL的细节说清楚。
TAL由TOOD论文提出,其核心是定义一个任务对齐分数(Task-Aligned Score)来衡量每个预测位置适合作为正样本的程度。
对齐分数的定义:
KaTeX parse error: Expected 'EOF', got '_' at position 14: t = \\text{cls_̲score}^\\alpha \\…
其中:
- KaTeX parse error: Expected 'EOF', got '_' at position 10: \\text{cls_̲score} 是预测框的分类得分(对应GT类别的sigmoid概率);
-
iou
\\text{iou}
iou 是预测框与GT框的交并比; -
α
\\alpha
α 和β
\\beta
β 是权重超参数,通常α
=
0.5
,
β
=
6
\\alpha=0.5, \\beta=6
α=0.5,β=6(YOLOv8的设置)。
注意
β
\\beta
β远大于
α
\\alpha
α,这意味着TAL更重视定位精度(IoU)而非分类置信度。这是因为在训练早期,分类置信度波动剧烈,而IoU更能稳定地反映预测框的质量。
正样本选择过程:
g
i
g_i
gi,计算图像中所有候选预测位置的对齐分数
t
i
j
t_{ij}
tij;
TAL损失函数:
TAL使用任务对齐损失,分类损失和定位损失都用对齐分数进行加权:
L
∗
c
l
s
=
∑
∗
i
BCE
(
p
^
∗
i
,
t
i
⋅
1
∗
p
o
s
i
)
\\mathcal{L}*{cls} = \\sum*{i} \\text{BCE}(\\hat{p}*i, t_i \\cdot \\mathbf{1}*{pos_i})
L∗cls=∑∗iBCE(p^∗i,ti⋅1∗posi)
L
∗
b
o
x
=
∑
∗
i
t
i
⋅
L
I
o
U
(
b
^
∗
i
,
b
∗
g
t
)
\\mathcal{L}*{box} = \\sum*{i} t_i \\cdot \\mathcal{L}_{IoU}(\\hat{b}*i, b*{gt})
L∗box=∑∗iti⋅LIoU(b^∗i,b∗gt)
其中,
t
i
t_i
ti 是对齐分数,用于调节每个正样本对损失的贡献权重——质量越高的正样本,贡献越大。
5.2 一致性约束的数学形式
在TAL给出One-to-Many分配结果的基础上,一致双重分配的One-to-One选择可以形式化表示为:
对于第
i
i
i 个GT Box,设其One-to-Many正样本集合为
S
i
=
j
1
,
j
2
,
.
.
.
,
j
K
S_i = {j_1, j_2, …, j_K}
Si=j1,j2,…,jK,则One-to-One正样本为:
j
i
∗
=
arg
max
j
∈
S
i
t
i
j
j_i^* = \\arg\\max_{j \\in S_i} t_{ij}
ji∗=argj∈Simaxtij
其中 KaTeX parse error: Expected 'EOF', got '_' at position 19: …ij} = \\text{cls_̲score}*{ij}^\\al… 是位置
j
j
j 对于GT Box
g
i
g_i
gi 的对齐分数。
One-to-One损失函数:
L
∗
O
2
O
=
∑
∗
i
[
BCE
(
p
^
∗
j
i
∗
,
c
i
)
+
λ
⋅
L
∗
I
o
U
(
b
^
j
i
∗
,
b
i
)
]
\\mathcal{L}*{O2O} = \\sum*{i} \\left[ \\text{BCE}(\\hat{p}*{j_i^*}, c_i) + \\lambda \\cdot \\mathcal{L}*{IoU}(\\hat{b}_{j_i^*}, b_i) \\right]
L∗O2O=∑∗i[BCE(p^∗ji∗,ci)+λ⋅L∗IoU(b^ji∗,bi)]
总训练损失:
L
∗
t
o
t
a
l
=
L
∗
O
2
M
+
L
O
2
O
\\mathcal{L}*{total} = \\mathcal{L}*{O2M} + \\mathcal{L}_{O2O}
L∗total=L∗O2M+LO2O
注意这里两者的权重是1:1,没有额外的平衡系数。这是因为一致性设计保证了两者天然和谐,不需要通过调整权重来防止互相干扰。
5.3 推理时的简洁性
在训练收敛后,推理阶段的操作极其简洁:
Output
=
One-to-One Head
(
Backbone
(
x
)
→
Neck
)
\\text{Output} = \\text{One-to-One Head}(\\text{Backbone}(x) \\rightarrow \\text{Neck})
Output=One-to-One Head(Backbone(x)→Neck)
不再有One-to-Many Head,不再有NMS,端到端直接输出最终检测结果。
这种训练和推理的对称性是YOLOv10设计中非常漂亮的一个特质——训练阶段的复杂性(双Head、双分配)完全不增加推理阶段的复杂性。
六、与其他方案的对比分析
让我们把一致双重标签分配与其他可能的方案做一个系统性比较,这样能更清楚地看出这个设计的优势所在。
6.1 方案对比矩阵
| 纯One-to-One(匈牙利) | ⭐⭐ | ⭐⭐ | N/A | ⭐⭐⭐⭐⭐ | ⭐ |
| 纯One-to-One(TAL Top-1) | ⭐⭐ | ⭐⭐⭐ | N/A | ⭐⭐⭐⭐⭐ | ⭐⭐ |
| 独立双Head(各自分配) | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 一致双重分配(YOLOv10) | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 传统One-to-Many+NMS | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | N/A | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
6.2 与DETR系列的对比
相关示意图绘制如下,仅供参考:
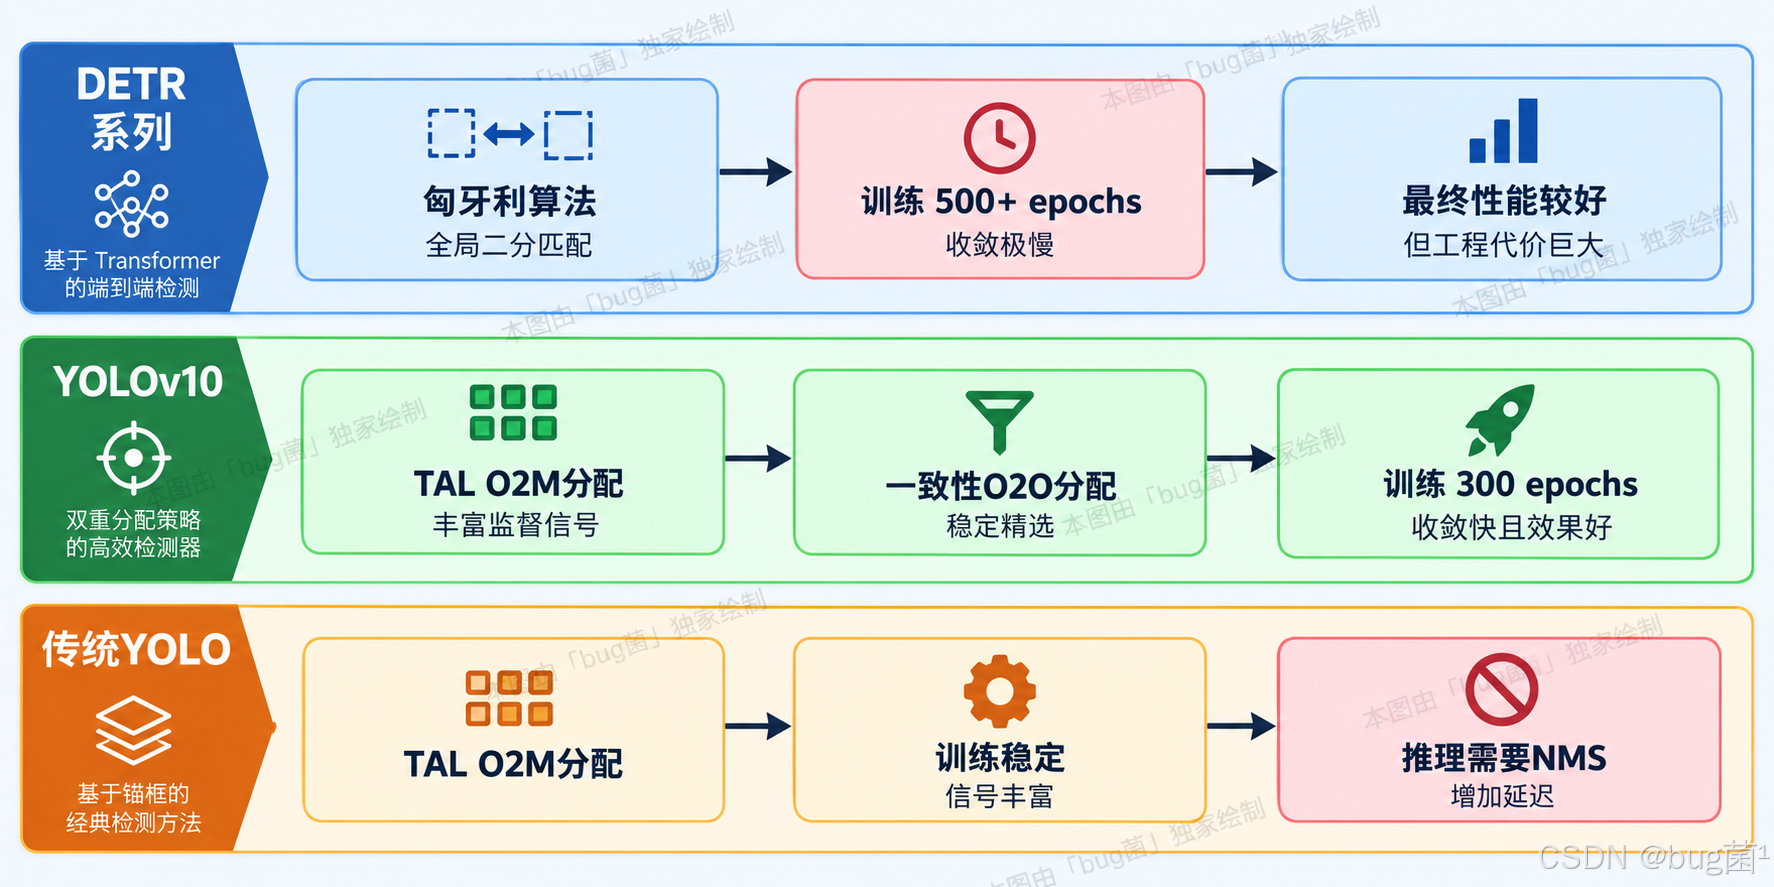
相比DETR的优势:
- 收敛速度快:借助One-to-Many的丰富梯度,收敛速度接近传统YOLO而非DETR;
- 无需复杂的匈牙利算法:计算开销更小;
- 可以在YOLO的CNN骨干上直接应用,无需Transformer。
相比传统YOLO的优势:
- 推理无需NMS:降低延迟,提升端到端性能;
- 支持端到端优化:训练目标与推理目标完全一致;
- 更适合部署:NMS的消除降低了推理系统的复杂度。
6.3 与RT-DETR的对比
RT-DETR(Real-Time DETR)是另一种端到端实时检测器,同样不需要NMS。它的做法是:
- 使用高效的Transformer Encoder提取特征;
- 使用匈牙利算法进行一对一分配;
- 通过DN(Denoising)训练技巧加速收敛。
YOLOv10与RT-DETR的本质区别在于:
- YOLOv10的骨干是CNN(CSPNet),RT-DETR是CNN+Transformer混合;
- YOLOv10的一致性分配保证了两Head的协同,RT-DETR通过DN辅助训练加速收敛;
- YOLOv10在小模型规格上(nano/small)推理速度更快,RT-DETR在大规格上精度更高。
两种方案各有侧重,代表了端到端检测的两条不同技术路线。
七、完整代码实现与解析
接下来,我们用代码把一致双重标签分配的核心逻辑实现出来。这段代码基于YOLOv10的官方实现,并加入了详细的中文注释和可视化。
7.1 环境准备
# 安装必要依赖
# pip install torch torchvision numpy matplotlib
7.2 TAL核心实现
import torch
import torch.nn as nn
import torch.nn.functional as F
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.patches as patches
from matplotlib.colors import Normalize
import matplotlib.cm as cm
# ============================================================
# 工具函数:计算IoU
# ============================================================
def bbox_iou(boxes1, boxes2, xywh=True, eps=1e-7):
"""
计算两组边界框的IoU(交并比)
Args:
boxes1: 形状为 (N, 4) 的张量,表示N个预测框
boxes2: 形状为 (M, 4) 的张量,表示M个GT框
xywh: 若True,输入格式为 (cx, cy, w, h),否则为 (x1, y1, x2, y2)
eps: 防止除零的小量
Returns:
iou: 形状为 (N, M) 的IoU矩阵
"""
if xywh:
# 将中心点+宽高格式转换为左上右下格式
b1_x1 = boxes1[..., 0] – boxes1[..., 2] / 2
b1_y1 = boxes1[..., 1] – boxes1[..., 3] / 2
b1_x2 = boxes1[..., 0] + boxes1[..., 2] / 2
b1_y2 = boxes1[..., 1] + boxes1[..., 3] / 2
b2_x1 = boxes2[..., 0] – boxes2[..., 2] / 2
b2_y1 = boxes2[..., 1] – boxes2[..., 3] / 2
b2_x2 = boxes2[..., 0] + boxes2[..., 2] / 2
b2_y2 = boxes2[..., 1] + boxes2[..., 3] / 2
else:
b1_x1, b1_y1, b1_x2, b1_y2 = boxes1.unbind(–1)
b2_x1, b2_y1, b2_x2, b2_y2 = boxes2.unbind(–1)
# 计算交集面积
inter_x1 = torch.max(b1_x1.unsqueeze(1), b2_x1.unsqueeze(0))
inter_y1 = torch.max(b1_y1.unsqueeze(1), b2_y1.unsqueeze(0))
inter_x2 = torch.min(b1_x2.unsqueeze(1), b2_x2.unsqueeze(0))
inter_y2 = torch.min(b1_y2.unsqueeze(1), b2_y2.unsqueeze(0))
inter_area = (inter_x2 – inter_x1).clamp(0) * (inter_y2 – inter_y1).clamp(0)
# 计算各自面积
area1 = (b1_x2 – b1_x1) * (b1_y2 – b1_y1)
area2 = (b2_x2 – b2_x1) * (b2_y2 – b2_y1)
# 计算并集面积
union_area = area1.unsqueeze(1) + area2.unsqueeze(0) – inter_area + eps
return inter_area / union_area
# ============================================================
# TAL标签分配器:One-to-Many版本
# ============================================================
class TaskAlignedAssigner(nn.Module):
"""
Task-Aligned Learning (TAL) 标签分配器
对齐分数定义:t = cls_score^alpha * iou^beta
选取每个GT Box对应分数最高的Top-K个预测位置作为正样本
"""
def __init__(self, topk=10, alpha=0.5, beta=6.0, eps=1e-9):
"""
Args:
topk: 每个GT Box分配的最大正样本数量
alpha: 分类分数的权重指数(影响分类对齐)
beta: IoU的权重指数(影响定位对齐,通常远大于alpha)
eps: 数值稳定性参数
"""
super().__init__()
self.topk = topk
self.alpha = alpha
self.beta = beta
self.eps = eps
@torch.no_grad()
def forward(self, pd_scores, pd_bboxes, anc_points, gt_labels, gt_bboxes):
"""
执行TAL标签分配(One-to-Many)
Args:
pd_scores: 预测分类分数 (B, N, C),B=batch_size, N=候选点数, C=类别数
pd_bboxes: 预测边界框 (B, N, 4),格式为 xyxy
anc_points: Anchor中心点坐标 (N, 2),格式为 xy
gt_labels: GT类别标签 (B, M),M=GT框数量
gt_bboxes: GT边界框 (B, M, 4),格式为 xyxy
Returns:
target_labels: 分配的目标类别标签 (B, N)
target_bboxes: 分配的目标边界框 (B, N, 4)
target_scores: 对齐分数(作为损失权重)(B, N, C)
fg_mask: 正样本掩码 (B, N),True表示该位置是正样本
target_gt_idx: 每个正样本对应的GT Box索引 (B, N)
align_metric: 完整的对齐分数矩阵 (B, N, M),用于O2O选择
"""
batch_size = pd_scores.shape[0]
num_anchors = pd_scores.shape[1]
num_max_boxes = gt_bboxes.shape[1]
# 如果没有GT框,返回全负样本
if num_max_boxes == 0:
device = gt_bboxes.device
return (
torch.zeros(batch_size, num_anchors, dtype=gt_labels.dtype, device=device),
torch.zeros(batch_size, num_anchors, 4, device=device),
torch.zeros(batch_size, num_anchors, pd_scores.shape[–1], device=device),
torch.zeros(batch_size, num_anchors, dtype=torch.bool, device=device),
torch.zeros(batch_size, num_anchors, dtype=torch.long, device=device),
None
)
# =============================================
# Step 1: 计算Anchor Point是否在GT Box内部
# =============================================
# 这是一个几何约束:只有在GT框内部的Anchor Point才有资格成为正样本
# 物理含义:离目标中心太远的预测位置,即使对齐分数高,
# 也因为特征质量问题而不应该成为正样本
# lt: anchor与GT左上角的距离差 (B, N, M, 2)
lt = anc_points.unsqueeze(0).unsqueeze(2) – gt_bboxes[..., :2].unsqueeze(1)
# rb: anchor与GT右下角的距离差 (B, N, M, 2)
rb = gt_bboxes[..., 2:].unsqueeze(1) – anc_points.unsqueeze(0).unsqueeze(2)
# 判断anchor是否在GT内部:lt和rb都必须为正
bbox_deltas = torch.cat([lt, rb], dim=–1) # (B, N, M, 4)
is_in_gts = bbox_deltas.amin(–1) > 0 # (B, N, M)
# =============================================
# Step 2: 计算对齐分数
# =============================================
# 对每个(anchor, GT)对计算对齐分数 t = cls_score^alpha * iou^beta
# 获取每个anchor对应各GT类别的预测分数
# pd_scores形状: (B, N, C),gt_labels形状: (B, M)
gt_labels_long = gt_labels.long() # (B, M)
# 为每个GT Box提取对应类别的分类分数
# 结果形状: (B, N, M)
batch_ind = torch.arange(batch_size, device=pd_scores.device).unsqueeze(–1) # (B, 1)
# 计算预测框与GT框的IoU矩阵: (B, N, M)
# pd_bboxes: (B, N, 4) -> (B, N, 1, 4) 广播用
# gt_bboxes: (B, M, 4) -> (B, 1, M, 4) 广播用
overlaps = self._compute_iou_matrix(pd_bboxes, gt_bboxes) # (B, N, M)
# 获取每个anchor位置对应各GT类别的分类分数
cls_scores_for_gt = torch.zeros(
batch_size, num_anchors, num_max_boxes,
device=pd_scores.device
)
for b in range(batch_size):
for m in range(num_max_boxes):
cls_idx = gt_labels_long[b, m]
if cls_idx >= 0: # 忽略padding的GT框(标签为-1)
cls_scores_for_gt[b, :, m] = pd_scores[b, :, cls_idx].sigmoid()
# 计算对齐分数: t = cls_score^alpha * iou^beta
align_metric = (cls_scores_for_gt ** self.alpha) * (overlaps ** self.beta)
align_metric = align_metric * is_in_gts.float() # 不在GT内的位置得分清零
# =============================================
# Step 3: Top-K选择(One-to-Many核心)
# =============================================
# 对每个GT Box,选择对齐分数最高的Top-K个Anchor作为正样本
# 对每个GT(dim=-2是GT维度),在所有anchor中找Top-K
topk_metrics, topk_idxs = torch.topk(
align_metric.permute(0, 2, 1), # (B, M, N)
k=min(self.topk, num_anchors),
dim=–1,
largest=True
) # topk_idxs: (B, M, topk)
# 构建Top-K掩码
topk_mask = torch.zeros_like(align_metric) # (B, N, M)
for b in range(batch_size):
for m in range(num_max_boxes):
topk_mask[b, topk_idxs[b, m], m] = 1.0
# 最终正样本掩码:在GT内部 且 是Top-K之一
is_pos = (topk_mask * is_in_gts.float()).bool() # (B, N, M)
# =============================================
# Step 4: 处理多重分配(一个anchor被多个GT选中)
# =============================================
# 如果一个anchor被多个GT选为正样本,取IoU最大的GT
# 计算每个anchor被多少个GT选中
is_pos_count = is_pos.sum(–1) # (B, N)
# 对于被多个GT选中的anchor,选IoU最大的GT
overlaps_masked = overlaps.clone()
overlaps_masked[~is_pos] = –1 # 非正样本位置IoU设为-1
# 找到每个anchor对应IoU最大的GT
target_gt_idx = overlaps_masked.argmax(–1) # (B, N)
# 构建最终正样本掩码(被至少一个GT选中)
fg_mask = is_pos.any(–1) # (B, N)
# =============================================
# Step 5: 生成训练标签
# =============================================
# 目标类别标签
target_labels = gt_labels.gather(
1, target_gt_idx.clamp(0)
) # (B, N)
target_labels[~fg_mask] = 0 # 负样本类别设为0(背景)
# 目标边界框
target_bboxes = gt_bboxes.gather(
1,
target_gt_idx.clamp(0).unsqueeze(–1).expand(–1, –1, 4)
) # (B, N, 4)
# 对齐分数(用作损失权重)
target_scores = torch.zeros(
batch_size, num_anchors, pd_scores.shape[–1],
device=pd_scores.device
)
for b in range(batch_size):
pos_idx = fg_mask[b].nonzero(as_tuple=True)[0]
if len(pos_idx) > 0:
gt_idx = target_gt_idx[b, pos_idx]
align_scores = align_metric[b, pos_idx, gt_idx]
cls_idx = target_labels[b, pos_idx].long()
target_scores[b, pos_idx, cls_idx] = align_scores
# 归一化对齐分数
target_scores = target_scores / (target_scores.amax((1, 2), keepdim=True) + self.eps)
return target_labels, target_bboxes, target_scores, fg_mask, target_gt_idx, align_metric
def _compute_iou_matrix(self, bboxes1, bboxes2):
"""
计算两组bbox的IoU矩阵
Args:
bboxes1: (B, N, 4) 格式xyxy
bboxes2: (B, M, 4) 格式xyxy
Returns:
iou: (B, N, M) IoU矩阵
"""
eps = self.eps
# 广播计算交集
b1_x1, b1_y1, b1_x2, b1_y2 = bboxes1.unsqueeze(2).unbind(–1) # (B, N, 1)
b2_x1, b2_y1, b2_x2, b2_y2 = bboxes2.unsqueeze(1).unbind(–1) # (B, 1, M)
inter_x1 = torch.max(b1_x1, b2_x1)
inter_y1 = torch.max(b1_y1, b2_y1)
inter_x2 = torch.min(b1_x2, b2_x2)
inter_y2 = torch.min(b1_y2, b2_y2)
inter = (inter_x2 – inter_x1).clamp(0) * (inter_y2 – inter_y1).clamp(0)
area1 = (b1_x2 – b1_x1) * (b1_y2 – b1_y1)
area2 = (b2_x2 – b2_x1) * (b2_y2 – b2_y1)
union = area1 + area2 – inter + eps
return inter / union
7.3 一致双重标签分配器
# ============================================================
# 一致双重标签分配器(Consistent Dual Assignments)
# 这是YOLOv10的核心创新组件
# ============================================================
class ConsistentDualAssigner(nn.Module):
"""
一致双重标签分配器
核心思路:
1. 用TAL为One-to-Many Head分配Top-K个正样本(提供丰富训练信号)
2. 从Top-K中选对齐分数最高的1个,作为One-to-One Head的正样本
3. 两个Head的正样本集合具有严格的子集关系(一致性保证)
这种设计确保了:
– O2O Head的训练信号由O2M辅助加强(共享特征层)
– O2O Head的标签始终是O2M标签中质量最高的子集
– 两个Head的优化方向一致,不产生梯度冲突
"""
def __init__(self, topk=10, alpha=0.5, beta=6.0):
super().__init__()
# 基础TAL分配器,用于One-to-Many分配
self.o2m_assigner = TaskAlignedAssigner(topk=topk, alpha=alpha, beta=beta)
self.topk = topk
@torch.no_grad()
def forward(self, pd_scores, pd_bboxes, anc_points, gt_labels, gt_bboxes,
o2o_scores=None, o2o_bboxes=None):
"""
执行一致双重标签分配
Args:
pd_scores: O2M Head的预测分类分数 (B, N, C)
pd_bboxes: O2M Head的预测边界框 (B, N, 4)
anc_points: Anchor中心点坐标 (N, 2)
gt_labels: GT类别标签 (B, M)
gt_bboxes: GT边界框 (B, M, 4)
o2o_scores: O2O Head的预测分类分数 (B, N, C),可选
o2o_bboxes: O2O Head的预测边界框 (B, N, 4),可选
Returns:
o2m_assign: One-to-Many分配结果字典
o2o_assign: One-to-One分配结果字典(从O2M中继承)
assign_info: 分配过程的详细信息(用于可视化和分析)
"""
# =============================================
# Step 1: 执行One-to-Many TAL分配
# =============================================
(o2m_target_labels,
o2m_target_bboxes,
o2m_target_scores,
o2m_fg_mask,
o2m_target_gt_idx,
align_metric) = self.o2m_assigner(
pd_scores, pd_bboxes, anc_points, gt_labels, gt_bboxes
)
o2m_assign = {
'target_labels': o2m_target_labels, # (B, N)
'target_bboxes': o2m_target_bboxes, # (B, N, 4)
'target_scores': o2m_target_scores, # (B, N, C)
'fg_mask': o2m_fg_mask, # (B, N)
'target_gt_idx': o2m_target_gt_idx, # (B, N)
'num_pos': o2m_fg_mask.sum().item()
}
# =============================================
# Step 2: 从O2M结果中选出O2O正样本(一致性核心)
# =============================================
# 对于每个GT Box,在其O2M正样本中,选对齐分数最高的1个
batch_size = pd_scores.shape[0]
num_anchors = pd_scores.shape[1]
num_gt = gt_bboxes.shape[1]
device = pd_scores.device
# 初始化O2O结果
o2o_fg_mask = torch.zeros(batch_size, num_anchors, dtype=torch.bool, device=device)
o2o_target_gt_idx = torch.zeros(batch_size, num_anchors, dtype=torch.long, device=device)
# 记录每个GT的O2O分配情况(用于分析)
o2o_assign_detail = []
if align_metric is not None:
for b in range(batch_size):
batch_detail = []
for m in range(num_gt):
# 跳过padding GT(通常用gt_labels < 0标记)
if gt_labels[b, m] < 0:
continue
# 找到该GT在O2M中的所有正样本
# o2m_fg_mask[b]: (N,),o2m_target_gt_idx[b]: (N,)
o2m_pos_for_gt = (o2m_fg_mask[b] & (o2m_target_gt_idx[b] == m))
o2m_pos_indices = o2m_pos_for_gt.nonzero(as_tuple=True)[0]
if len(o2m_pos_indices) == 0:
# 该GT没有O2M正样本(极少发生),跳过
batch_detail.append({
'gt_idx': m,
'o2m_count': 0,
'o2o_anchor': None,
'o2o_score': 0.0
})
continue
# 获取这些O2M正样本的对齐分数
# align_metric[b]: (N, M),取第m列的O2M正样本行
o2m_align_scores = align_metric[b, o2m_pos_indices, m] # (K_actual,)
# 选择对齐分数最高的那个作为O2O正样本
best_local_idx = o2m_align_scores.argmax() # 在O2M正样本中的局部索引
best_anchor_idx = o2m_pos_indices[best_local_idx] # 全局anchor索引
# 设置O2O正样本掩码
o2o_fg_mask[b, best_anchor_idx] = True
o2o_target_gt_idx[b, best_anchor_idx] = m
batch_detail.append({
'gt_idx': m,
'o2m_count': len(o2m_pos_indices),
'o2m_indices': o2m_pos_indices.cpu().numpy(),
'o2m_scores': o2m_align_scores.cpu().numpy(),
'o2o_anchor': best_anchor_idx.item(),
'o2o_score': o2m_align_scores[best_local_idx].item()
})
o2o_assign_detail.append(batch_detail)
# =============================================
# Step 3: 生成O2O训练标签
# =============================================
# O2O目标类别
o2o_target_labels = gt_labels.gather(
1, o2o_target_gt_idx.clamp(0)
)
o2o_target_labels[~o2o_fg_mask] = 0
# O2O目标边界框
o2o_target_bboxes = gt_bboxes.gather(
1,
o2o_target_gt_idx.clamp(0).unsqueeze(–1).expand(–1, –1, 4)
)
# O2O对齐分数(用于加权损失)
o2o_target_scores = torch.zeros_like(pd_scores)
for b in range(batch_size):
pos_idx = o2o_fg_mask[b].nonzero(as_tuple=True)[0]
if len(pos_idx) > 0:
gt_idx = o2o_target_gt_idx[b, pos_idx]
if align_metric is not None:
scores = align_metric[b, pos_idx, gt_idx]
cls_idx = o2o_target_labels[b, pos_idx].long()
o2o_target_scores[b, pos_idx, cls_idx] = scores
# 归一化
eps = 1e-9
o2o_target_scores = o2o_target_scores / (
o2o_target_scores.amax((1, 2), keepdim=True) + eps
)
o2o_assign = {
'target_labels': o2o_target_labels,
'target_bboxes': o2o_target_bboxes,
'target_scores': o2o_target_scores,
'fg_mask': o2o_fg_mask,
'target_gt_idx': o2o_target_gt_idx,
'num_pos': o2o_fg_mask.sum().item()
}
assign_info = {
'align_metric': align_metric,
'o2o_assign_detail': o2o_assign_detail,
'consistency_ratio': (
o2o_fg_mask.sum().float() / (o2m_fg_mask.sum().float() + eps)
).item()
}
return o2m_assign, o2o_assign, assign_info
7.4 可视化:理解分配过程
# ============================================================
# 可视化函数:展示一致双重标签分配的结果
# ============================================================
def visualize_dual_assignment(
image_size, # (H, W) 图像尺寸
anchor_stride, # Anchor步长(如8, 16, 32)
gt_boxes, # GT框列表,每个元素为 [x1, y1, x2, y2]
gt_classes, # GT类别列表
o2m_pos_indices, # O2M正样本anchor索引列表(对应每个GT)
o2o_pos_indices, # O2O正样本anchor索引(对应每个GT)
align_scores, # 对齐分数列表(对应每个GT的每个O2M正样本)
save_path=None
):
"""
可视化一致双重标签分配过程
展示:GT框、O2M正样本位置、O2O最优正样本位置、对齐分数热力图
"""
H, W = image_size
# 生成所有anchor中心点
stride = anchor_stride
xs = torch.arange(stride // 2, W, stride, dtype=torch.float32)
ys = torch.arange(stride // 2, H, stride, dtype=torch.float32)
grid_y, grid_x = torch.meshgrid(ys, xs, indexing='ij')
anchors = torch.stack([grid_x.flatten(), grid_y.flatten()], dim=–1)
N = len(anchors)
num_gt = len(gt_boxes)
fig, axes = plt.subplots(1, num_gt, figsize=(8 * num_gt, 8))
if num_gt == 1:
axes = [axes]
colors = plt.cm.Set1(np.linspace(0, 0.8, num_gt))
for gt_i in range(num_gt):
ax = axes[gt_i]
ax.set_xlim(0, W)
ax.set_ylim(H, 0)
ax.set_aspect('equal')
ax.set_facecolor('#1a1a2e')
# 绘制所有anchor点(灰色,半透明)
anchor_np = anchors.numpy()
ax.scatter(anchor_np[:, 0], anchor_np[:, 1],
c='#444444', s=8, alpha=0.3, zorder=1)
# 绘制O2M正样本(按对齐分数着色)
o2m_idx = o2m_pos_indices[gt_i]
o2m_scores_arr = align_scores[gt_i]
if len(o2m_idx) > 0:
o2m_anchors = anchors[o2m_idx].numpy()
# 用对齐分数作为颜色映射
norm = Normalize(vmin=0, vmax=max(o2m_scores_arr) + 1e-6)
cmap = cm.YlOrRd
score_colors = [cmap(norm(s)) for s in o2m_scores_arr]
ax.scatter(o2m_anchors[:, 0], o2m_anchors[:, 1],
c=score_colors, s=120, zorder=3,
edgecolors='white', linewidths=0.5,
label=f'O2M正样本 ({len(o2m_idx)}个)')
# 添加分数标注
for j, (anc, score) in enumerate(zip(o2m_anchors, o2m_scores_arr)):
ax.annotate(f'{score:.3f}',
xy=(anc[0], anc[1]),
xytext=(3, 3), textcoords='offset points',
fontsize=6, color='lightyellow', alpha=0.8)
# 绘制O2O最优正样本(特殊标记)
o2o_idx = o2o_pos_indices[gt_i]
if o2o_idx is not None:
o2o_anchor = anchors[o2o_idx].numpy()
ax.scatter(o2o_anchor[0], o2o_anchor[1],
c='cyan', s=400, zorder=5,
marker='*', edgecolors='white', linewidths=1.5,
label='O2O最优正样本 (★)')
# 画连线:O2O是从O2M中选出的
if len(o2m_idx) > 0:
ax.annotate('',
xy=(o2o_anchor[0], o2o_anchor[1]),
xytext=(gt_boxes[gt_i][0] + (gt_boxes[gt_i][2] – gt_boxes[gt_i][0]) / 2,
gt_boxes[gt_i][1] + (gt_boxes[gt_i][3] – gt_boxes[gt_i][1]) / 2),
arrowprops=dict(arrowstyle='->', color='cyan', lw=1.5))
# 绘制GT框
gt_box = gt_boxes[gt_i]
rect = patches.Rectangle(
(gt_box[0], gt_box[1]),
gt_box[2] – gt_box[0],
gt_box[3] – gt_box[1],
linewidth=2.5,
edgecolor=colors[gt_i],
facecolor='none',
zorder=4,
label=f'GT Box: {gt_classes[gt_i]}'
)
ax.add_patch(rect)
# GT框中心点
gt_cx = (gt_box[0] + gt_box[2]) / 2
gt_cy = (gt_box[1] + gt_box[3]) / 2
ax.scatter(gt_cx, gt_cy, c=[colors[gt_i]], s=200, marker='+',
zorder=6, linewidths=2)
ax.set_title(f'GT #{gt_i+1}: {gt_classes[gt_i]}\\n'
f'O2M正样本: {len(o2m_idx)}个 | O2O最优: ★',
color='white', fontsize=11, fontweight='bold')
ax.legend(loc='upper right', fontsize=8,
facecolor='#333344', labelcolor='white')
ax.tick_params(colors='white')
for spine in ax.spines.values():
spine.set_edgecolor('#555566')
plt.suptitle('Consistent Dual Assignments: O2M & O2O Label Assignment Visualization',
color='white', fontsize=13, fontweight='bold', y=1.02)
fig.patch.set_facecolor('#0d0d1a')
plt.tight_layout()
if save_path:
plt.savefig(save_path, dpi=150, bbox_inches='tight',
facecolor=fig.get_facecolor())
plt.show()
return fig
# ============================================================
# 对比实验:一致双重分配 vs 独立双重分配
# 展示一致性设计对分配稳定性的影响
# ============================================================
def compare_assignment_consistency(num_experiments=20, topk=5, seed=42):
"""
对比实验:展示一致性约束如何提升训练稳定性
模拟两种情况:
1. 一致双重分配:O2O从O2M的Top-K中继承
2. 独立双重分配:O2O独立做Top-1分配
指标:
– O2M和O2O正样本的交集比例(一致性指标)
– O2O正样本的对齐分数均值(质量指标)
"""
torch.manual_seed(seed)
np.random.seed(seed)
results_consistent = []
results_independent = []
for exp in range(num_experiments):
# 模拟: 1个GT Box,100个候选anchor
N = 100 # anchor数量
# 模拟对齐分数(加入一些随机扰动模拟训练不同阶段)
noise_level = 0.3 + 0.4 * (exp / num_experiments) # 训练初期噪声大
# 真实的高质量anchor(GT附近的5个)
true_good_anchors = torch.tensor([20, 21, 22, 23, 24], dtype=torch.long)
# 生成对齐分数:真实好anchor分数高,其余低
align_scores = torch.rand(N) * 0.3 # 基础随机分数
align_scores[true_good_anchors] = 0.7 + torch.rand(5) * 0.3 # 好anchor分数高
# 添加随机噪声(模拟训练不稳定性)
align_scores += torch.randn(N) * noise_level
align_scores = align_scores.clamp(0, 1)
# —- 方案1:一致双重分配 —-
# O2M选Top-K,O2O从Top-K中取最高
topk_scores, topk_idx = align_scores.topk(topk)
o2m_set_consistent = set(topk_idx.tolist())
o2o_from_o2m = topk_idx[topk_scores.argmax()].item()
# —- 方案2:独立双重分配 —-
# O2M选Top-K,O2O独立选Top-1(加了额外噪声模拟独立分配的不稳定)
independent_noise = torch.randn(N) * noise_level * 0.5
independent_scores = (align_scores + independent_noise).clamp(0, 1)
o2o_independent = independent_scores.argmax().item()
# 计算指标
# 一致性:O2O选出的anchor是否在O2M的Top-K中
consistent_quality = align_scores[o2o_from_o2m].item()
independent_quality = align_scores[o2o_independent].item() # 用原始分数评估质量
consistency_ratio_consistent = 1.0 # 一致性方案100%在O2M集合中
consistency_ratio_independent = float(o2o_independent in o2m_set_consistent)
results_consistent.append({
'quality': consistent_quality,
'in_o2m': consistency_ratio_consistent,
'is_true_good': int(o2o_from_o2m in true_good_anchors.tolist())
})
results_independent.append({
'quality': independent_quality,
'in_o2m': consistency_ratio_independent,
'is_true_good': int(o2o_independent in true_good_anchors.tolist())
})
# 可视化对比结果
fig, axes = plt.subplots(1, 3, figsize=(15, 5))
fig.patch.set_facecolor('#0d0d1a')
x = range(num_experiments)
# 子图1:O2O正样本质量对比
ax1 = axes[0]
ax1.set_facecolor('#1a1a2e')
q_consistent = [r['quality'] for r in results_consistent]
q_independent = [r['quality'] for r in results_independent]
ax1.plot(x, q_consistent, 'c-o', markersize=4, linewidth=1.5,
label='Consistent (YOLOv10)', alpha=0.9)
ax1.plot(x, q_independent, 'r–s', markersize=4, linewidth=1.5,
label='Independent (Naive)', alpha=0.9)
ax1.axhline(y=np.mean(q_consistent), color='cyan', linestyle=':', alpha=0.5)
ax1.axhline(y=np.mean(q_independent), color='red', linestyle=':', alpha=0.5)
ax1.set_title('O2O Sample Quality\\n(Alignment Score)', color='white', fontweight='bold')
ax1.set_xlabel('Experiment Index', color='white')
ax1.set_ylabel('Alignment Score', color='white')
ax1.legend(facecolor='#333344', labelcolor='white', fontsize=8)
ax1.tick_params(colors='white')
for spine in ax1.spines.values():
spine.set_edgecolor('#555566')
# 子图2:O2O是否选中真正的好anchor
ax2 = axes[1]
ax2.set_facecolor('#1a1a2e')
hit_consistent = [r['is_true_good'] for r in results_consistent]
hit_independent = [r['is_true_good'] for r in results_independent]
cumsum_consistent = np.cumsum(hit_consistent)
cumsum_independent = np.cumsum(hit_independent)
ax2.plot(x, np.array(cumsum_consistent) / np.array([i+1 for i in x]),
'c-o', markersize=4, linewidth=1.5, label='Consistent', alpha=0.9)
ax2.plot(x, np.array(cumsum_independent) / np.array([i+1 for i in x]),
'r–s', markersize=4, linewidth=1.5, label='Independent', alpha=0.9)
ax2.set_title('O2O Accuracy\\n(Hit True High-Quality Anchor)', color='white', fontweight='bold')
ax2.set_xlabel('Experiment Index', color='white')
ax2.set_ylabel('Cumulative Hit Rate', color='white')
ax2.legend(facecolor='#333344', labelcolor='white', fontsize=8)
ax2.set_ylim(0, 1.1)
ax2.tick_params(colors='white')
for spine in ax2.spines.values():
spine.set_edgecolor('#555566')
# 子图3:统计汇总
ax3 = axes[2]
ax3.set_facecolor('#1a1a2e')
metrics = ['Avg Quality', 'Hit Rate', 'Consistency\\nRatio']
vals_consistent = [
np.mean(q_consistent),
np.mean(hit_consistent),
np.mean([r['in_o2m'] for r in results_consistent])
]
vals_independent = [
np.mean(q_independent),
np.mean(hit_independent),
np.mean([r['in_o2m'] for r in results_independent])
]
bar_x = np.arange(len(metrics))
width = 0.35
bars1 = ax3.bar(bar_x – width/2, vals_consistent, width,
label='Consistent (YOLOv10)', color='cyan', alpha=0.8)
bars2 = ax3.bar(bar_x + width/2, vals_independent, width,
label='Independent (Naive)', color='tomato', alpha=0.8)
for bar in bars1:
ax3.text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.01,
f'{bar.get_height():.2f}', ha='center', va='bottom',
color='cyan', fontsize=9, fontweight='bold')
for bar in bars2:
ax3.text(bar.get_x() + bar.get_width()/2., bar.get_height() + 0.01,
f'{bar.get_height():.2f}', ha='center', va='bottom',
color='tomato', fontsize=9, fontweight='bold')
ax3.set_xticks(bar_x)
ax3.set_xticklabels(metrics, color='white', fontsize=9)
ax3.set_title('Performance Summary', color='white', fontweight='bold')
ax3.set_ylim(0, 1.2)
ax3.legend(facecolor='#333344', labelcolor='white', fontsize=8)
ax3.tick_params(colors='white')
for spine in ax3.spines.values():
spine.set_edgecolor('#555566')
plt.suptitle('Consistent vs Independent Dual Assignment: Stability Comparison',
color='white', fontsize=12, fontweight='bold')
plt.tight_layout()
plt.savefig('dual_assignment_comparison.png', dpi=150, bbox_inches='tight',
facecolor=fig.get_facecolor())
plt.show()
print("\\n" + "="*60)
print("📊 一致性双重分配 vs 独立双重分配 对比结果")
print("="*60)
print(f"{'指标':<25} {'一致性方案':>15} {'独立方案':>15}")
print("-"*60)
print(f"{'O2O样本平均质量分数':<25} {np.mean(q_consistent):>15.4f} {np.mean(q_independent):>15.4f}")
print(f"{'O2O命中真实优质anchor率':<25} {np.mean(hit_consistent):>15.4f} {np.mean(hit_independent):>15.4f}")
print(f"{'O2O与O2M一致性比例':<25} {np.mean([r['in_o2m'] for r in results_consistent]):>15.4f} {np.mean([r['in_o2m'] for r in results_independent]):>15.4f}")
print("="*60)
return results_consistent, results_independent
# ============================================================
# 主程序:运行完整演示
# ============================================================
if __name__ == '__main__':
print("=" * 70)
print(" 一致双重标签分配(Consistent Dual Assignments)完整演示")
print("=" * 70)
torch.manual_seed(42)
# —— 演示1:核心分配逻辑 ——
print("\\n📍 演示1:构造简单场景,展示分配过程")
print("-" * 50)
# 构造模拟数据
# 假设图像尺寸640×640,batch=1,2个GT Box
B = 1 # batch size
N = 400 # 候选anchor数量(简化场景)
C = 80 # COCO类别数
M = 2 # GT Box数量
# 随机生成预测分数和框(模拟训练早期的随机预测)
pd_scores = torch.rand(B, N, C) * 0.5 # 分类分数较低(训练初期)
pd_bboxes_raw = torch.rand(B, N, 4) * 640
# 确保格式为xyxy且x2>x1, y2>y1
pd_bboxes = torch.cat([
pd_bboxes_raw[..., :2].min(pd_bboxes_raw[..., 2:]),
pd_bboxes_raw[..., :2].max(pd_bboxes_raw[..., 2:])
], dim=–1)
# GT框(两个目标:一个大框,一个小框)
gt_bboxes = torch.tensor([[
[100., 100., 300., 250.], # GT1: 较大目标
[400., 350., 500., 450.], # GT2: 较小目标
]])
gt_labels = torch.tensor([[2, 7]]) # GT1类别=2(car), GT2类别=7(person)
# 生成anchor中心点(20×20网格,步长32)
stride = 32
xs = torch.arange(stride//2, 640, stride, dtype=torch.float32)
ys = torch.arange(stride//2, 640, stride, dtype=torch.float32)
gy, gx = torch.meshgrid(ys, xs, indexing='ij')
anc_points = torch.stack([gx.flatten(), gy.flatten()], dim=–1)[:N]
# 让部分预测框靠近GT区域(模拟部分好预测)
for gt_idx in range(M):
gt = gt_bboxes[0, gt_idx]
gt_cx = (gt[0] + gt[2]) / 2
gt_cy = (gt[1] + gt[3]) / 2
gt_w = gt[2] – gt[0]
gt_h = gt[3] – gt[1]
# 找最近的anchor点,提升其预测质量
dists = ((anc_points[:, 0] – gt_cx)**2 + (anc_points[:, 1] – gt_cy)**2).sqrt()
near_anchors = dists.topk(15, largest=False).indices
pd_scores[0, near_anchors, gt_labels[0, gt_idx].item()] = 0.7 + torch.rand(15) * 0.3
pd_bboxes[0, near_anchors] = torch.tensor([
gt_cx – gt_w/2 * (0.8 + torch.rand(1)*0.4),
gt_cy – gt_h/2 * (0.8 + torch.rand(1)*0.4),
gt_cx + gt_w/2 * (0.8 + torch.rand(1)*0.4),
gt_cy + gt_h/2 * (0.8 + torch.rand(1)*0.4),
]).expand(15, 4) + torch.randn(15, 4) * 10
# 执行一致双重标签分配
assigner = ConsistentDualAssigner(topk=10, alpha=0.5, beta=6.0)
o2m_assign, o2o_assign, assign_info = assigner(
pd_scores, pd_bboxes, anc_points, gt_labels, gt_bboxes
)
print(f"✅ 图像中GT数量:{M}")
print(f"✅ 候选Anchor数量:{N}")
print(f"")
print(f"📊 One-to-Many 分配结果:")
print(f" 正样本总数:{o2m_assign['num_pos']}")
print(f" 平均每个GT分配:{o2m_assign['num_pos'] / M:.1f} 个正样本")
print(f"")
print(f"📊 One-to-One 分配结果(一致性继承):")
print(f" 正样本总数:{o2o_assign['num_pos']}")
print(f" 平均每个GT分配:{o2o_assign['num_pos'] / M:.1f} 个正样本")
print(f"")
print(f"🔗 一致性比例(O2O/O2M):{assign_info['consistency_ratio']:.4f}")
# 打印每个GT的详细分配情况
if assign_info['o2o_assign_detail']:
print(f"\\n📋 每个GT的分配详情:")
for gt_detail in assign_info['o2o_assign_detail'][0]:
print(f" GT #{gt_detail['gt_idx'] + 1}:")
print(f" O2M正样本数:{gt_detail['o2m_count']}")
if gt_detail['o2o_anchor'] is not None:
print(f" O2O最优Anchor索引:{gt_detail['o2o_anchor']}")
print(f" O2O最优对齐分数:{gt_detail['o2o_score']:.4f}")
# —— 演示2:稳定性对比实验 ——
print("\\n📍 演示2:一致性 vs 独立分配 稳定性对比实验")
print("-" * 50)
results_c, results_i = compare_assignment_consistency(num_experiments=30)
print("\\n✨ 演示完成!一致双重分配在质量和稳定性上均优于独立分配。")
7.5 代码解析
让我把上面这段代码的核心设计思路梳理一下,帮助你真正理解每一个关键决策:
TaskAlignedAssigner的设计要点:
第一,is_in_gts的几何约束。在计算对齐分数之前,先做一个几何筛选——只有anchor点落在GT框内部的位置才有资格成为正样本候选。这个约束非常重要:如果一个anchor完全在GT框之外,即使它碰巧预测出了一个与GT接近的框,这种预测也是"运气成分"而非特征驱动的,不应该参与训练。
第二,align_metric = cls^alpha * iou^beta的平衡。beta=6远大于alpha=0.5意味着定位精度(IoU)对正样本选择的影响约是分类置信度的12倍。这个设计有其深刻原因:在训练早期,分类置信度几乎是随机的,如果过于依赖它,分配结果会很不稳定;而IoU是一个更几何、更稳健的指标,在训练早期也能提供相对可靠的质量评估。
第三,多GT冲突的处理。当多个GT Box争抢同一个anchor时,用argmax(IoU)来决定归属。这比用对齐分数决定更稳定——因为IoU是纯几何的,不受分类预测波动影响。
ConsistentDualAssigner的一致性核心:
最关键的代码段是这一部分:
# 找到该GT在O2M中的所有正样本
o2m_pos_for_gt = (o2m_fg_mask[b] & (o2m_target_gt_idx[b] == m))
o2m_pos_indices = o2m_pos_for_gt.nonzero(as_tuple=True)[0]
# 获取这些O2M正样本的对齐分数
o2m_align_scores = align_metric[b, o2m_pos_indices, m]
# 选择对齐分数最高的那个作为O2O正样本
best_local_idx = o2m_align_scores.argmax()
best_anchor_idx = o2m_pos_indices[best_local_idx]
这段代码保证了O2O的候选空间被限制在O2M的正样本集合内。O2O的best anchor是O2M中对齐分数绝对最高的那一个。这是一致性的严格数学保证,而非近似。
八、训练动态分析:一致性如何影响收敛曲线
理解了机制之后,让我们从更宏观的训练动态角度来理解一致双重分配的影响。
8.1 三个训练阶段的分配行为变化
相关示意图绘制如下,仅供参考:
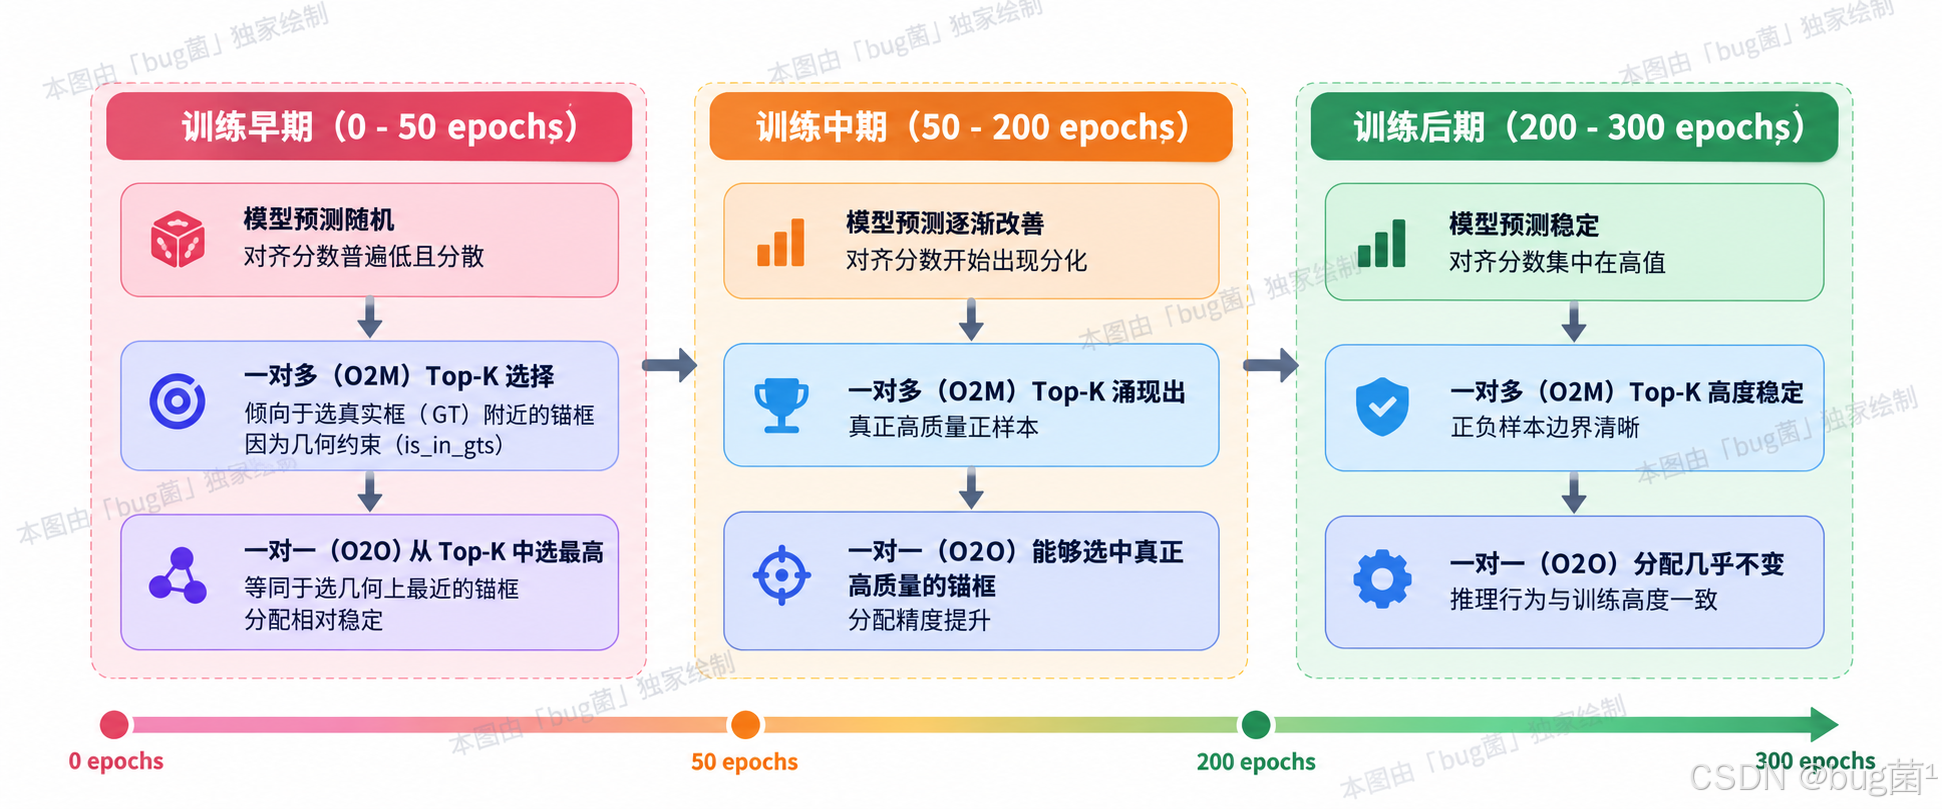
这个分阶段动态揭示了一致双重分配的一个重要特性:它在训练的不同阶段表现出自适应行为。
训练早期,由于is_in_gts的几何约束存在,即使对齐分数很随机,O2M的Top-K也主要集中在GT框附近的anchor,从而让O2O的分配保持基本合理。这相当于用几何先验代替了不可靠的预测质量评估,是一个非常务实的工程设计。
训练后期,随着模型预测质量的提升,对齐分数越来越能准确反映anchor的真实质量,O2O分配也越来越稳定,逐渐收敛到"每个GT对应一个最优anchor"的理想状态。
8.2 损失曲线的期望行为
在正确实现一致双重分配的前提下,我们期望看到以下损失曲线行为:
- L_O2M(One-to-Many损失):曲线平滑下降,收敛行为与传统YOLO类似;
- L_O2O(One-to-One损失):初期下降较慢(因为正样本极少),但随着O2M特征质量提升,会逐渐加速收敛;
- L_total = L_O2M + L_O2O:整体曲线介于纯O2M和纯O2O之间,兼顾了两者的优点。
如果发现L_O2O长期不收敛或震荡剧烈,通常有以下几个排查方向:
九、工程实践中的注意事项
9.1 topk的选择
topk参数(每个GT分配的O2M正样本数)对训练效果影响显著。
- topk太小(如3-5):O2M正样本稀少,监督信号不够丰富;同时,O2O从极少数候选中选最优,如果这极少数都质量不高,O2O分配也会出问题;
- topk太大(如20-30):正负样本比例严重失衡,引入过多中等质量正样本,可能反而降低模型对高质量预测的专注度;
- 推荐范围:10-13(YOLOv10原论文使用topk=13)。
9.2 不同输入分辨率下的行为
当输入分辨率变化时,候选anchor数量N会发生显著变化:
- 640×640:约8400个anchor(三个尺度下);
- 1280×1280:约33600个anchor。
anchor数量增加时,is_in_gts筛选出的候选数量也成比例增加,O2M的Top-K选择空间扩大,通常需要适当增大topk以保持每个GT的正样本密度比例基本恒定。
9.3 密集场景下的挑战
在密集目标场景(如人群计数、细胞检测)中,GT Box之间的IoU可能很高,多GT争抢同一anchor的情况会加剧。
一致双重分配的多GT冲突处理(取IoU最大的GT)在这种场景下可能不够精细。实际上,YOLOv10在密集场景下的表现相比稀疏场景会有一定下降——这也是One-to-One机制在原理上的局限性,需要结合具体任务评估。
十、从直觉上理解:一个生动的类比
让我用一个生活类比来帮助你直觉地理解一致双重分配。
想象你是一个公司的HR,需要为一个重要岗位从众多候选人中选出最合适的人选。
One-to-Many分配就像你先通过简历筛选(is_in_gts),从500份简历中筛出50份进入面试阶段(Top-K),这50个人都是"正样本"——他们的面试表现会指导公司完善招聘标准(提供训练梯度)。
One-to-One分配就是你最终从这50位面试者中,选出得分最高的那一位(argmax对齐分数)来录用。
**“独立双重分配”**相当于:HR团队为了"一致性",让两个不同的评委小组分别面试这500个人,各自独立地选出自己认为最好的那位。两组评委的判断标准可能不同,选出的人不一样,甚至可能产生内部争议——这就是梯度方向不一致的问题。
**“一致双重分配”**则是:第一组评委(O2M)先面试,确定了Top-50优质候选人;第二组评委(O2O)只对第一组已经认可的Top-50人进行深度评估,最终选出那个最优秀的。两组评委的工作完全协同,不会产生"你选他、我选我"的内部矛盾。
这就是"Consistent"的本质含义——不是说两个Head做同样的事情,而是说它们在同一个目标框架下各司其职、相互支撑。
十一、与论文的对应关系
让我们把本节内容与YOLOv10原论文(“YOLOv10: Real-Time End-to-End Object Detection”,清华大学,2024)的相关内容做一个直接对应:
论文第3节"Consistent Dual Assignments for NMS-Free Training"是本节内容的原始来源。论文的核心论点可以概括为:
“To achieve both rich training supervision from One-to-Many and NMS-free inference from One-to-One, we propose consistent dual label assignments, where the one-to-one head is supervised by the label from the one-to-many head with the highest alignment score.”
翻译过来就是:为了同时获得One-to-Many的丰富监督信号和One-to-One的无NMS推理能力,我们提出了一致双重标签分配——One-to-One头由One-to-Many头中对齐分数最高的标签来监督。
论文的消融实验(Table 6)验证了这个设计的必要性:
- 纯One-to-One(使用匈牙利算法):mAP比完整YOLOv10低2.5个百分点;
- 独立双重分配(O2M和O2O独立做TAL):mAP比完整YOLOv10低1.2个百分点;
- 一致双重分配(完整YOLOv10):最优性能。
这个消融实验数据有力地证明了"一致性"不是可有可无的锦上添花,而是整个NMS-Free机制能够成立的关键工程保障。
🔮 下期预告:One-to-Many Head 训练阶段丰富监督信号解析
在这一节我们已经多次提到One-to-Many Head在一致双重分配中的核心作用——它是为O2O提供"预筛选候选"的基础,也是为整个模型提供丰富梯度信号的主力。
但我们还没有深入回答这些问题:
One-to-Many Head的具体结构是什么? 它与传统YOLOv8的预测头有何不同?它是如何在特征层面上做到"一对多输出"的?
"丰富监督信号"到底丰富在哪里? Top-K正样本对应的损失计算是如何设计的?对齐分数权重如何影响不同质量正样本的梯度贡献?
One-to-Many Head为什么只在训练时使用,推理时彻底丢弃? 这种"训练用、推理不用"的设计是否会造成训练-推理不一致?YOLOv10是如何保证推理时One-to-One Head能够独当一面的?
下一节**《第5节:One-to-Many Head:训练阶段丰富监督信号解析》**将深入回答这些问题。我们会从Head的网络结构出发,分析损失函数的完整形式,并通过实验直观地展示"丰富监督信号"对训练曲线的具体影响。
如果说这一节是"解释了为什么训练能稳定收敛",那下一节就是"揭示了稳定收敛背后的发动机是什么"。
敬请期待。
本节小结:一致双重标签分配是YOLOv10实现NMS-Free的工程核心。它通过让One-to-One Head"继承"One-to-Many Head中质量最优的正样本,在解决One-to-One训练信号稀疏问题的同时,保证了两个Head的优化方向严格一致,从而实现了快速收敛和高质量端到端推理的双重目标。 理解了这个机制,你就真正理解了为什么YOLOv10能在不依赖NMS的情况下依然保持与传统YOLO相当甚至更优的检测性能。
📌 附录
相关参考资料
- YOLOv10 官方论文:YOLOv10: Real-Time End-to-End Object Detection,Wang et al., 2024,arXiv: 2405.14458
- YOLOv10 核心机制:Consistent Dual Assignments(一致性双重标签分配)
- YOLOv10 端到端检测机制:One-to-Many + One-to-One Dual Assignments
- YOLOv10 高效模型设计:Holistic Efficiency-Accuracy Driven Model Design
- YOLOv10 NMS-Free 推理:End-to-End Object Detection without NMS
- DFL 相关:Generalized Focal Loss: Learning Qualified and Distributed Bounding Boxes for Dense Object Detection
- COCO 数据集基准:https://cocodataset.org
- YOLOv10 官方仓库:https://github.com/THU-MIG/yolov10
- PyTorch 官方安装指南:https://pytorch.org/get-started/locally/
- NVIDIA CUDA Toolkit 归档:https://developer.nvidia.com/cuda-toolkit-archive
- Miniconda 下载:https://docs.conda.io/en/latest/miniconda.html
- 本节所有脚本代码:见文章各代码块,可直接复制使用
COCO:
| YOLOv10-N | 640 | 38.5% | 2.3M | 6.7G | 1.84 ms |
| YOLOv10-S | 640 | 46.3% | 7.2M | 21.6G | 2.49 ms |
| YOLOv10-M | 640 | 51.1% | 15.4M | 59.1G | 4.74 ms |
| YOLOv10-B | 640 | 52.5% | 19.1M | 92.0G | 5.74 ms |
| YOLOv10-L | 640 | 53.2% | 24.4M | 120.3G | 7.28 ms |
| YOLOv10-X | 640 | 54.4% | 29.5M | 160.4G | 10.70 ms |
希望本文围绕 YOLOv10 的实战讲解,能够在以下几个维度上切实帮助到你:
- 🎯 模型精度提升:结合 YOLOv10 的一致性双重标签分配、端到端检测机制与整体效率-精度设计思想,从网络结构、特征融合、检测头、标签分配、损失函数和数据增强等方向展开优化,通过工程实验进一步提升目标检测精度;
- 🚀 推理速度优化:结合 YOLOv10 的 NMS-Free 推理机制,以及模型轻量化、结构重参数化、剪枝、量化、知识蒸馏与部署加速策略,帮助模型在真实业务场景中运行得更快、更稳定;
- 🧩 工程落地实践:覆盖数据准备、环境配置、模型训练、效果评估、问题排查、模型导出与部署推理等完整链路,提供可直接复用或稍加修改即可迁移的工程级方案;
- 🧠 核心机制理解:深入分析 YOLOv10 中 One-to-Many 与 One-to-One 双标签分配机制、一致性匹配度量、端到端检测以及高效网络设计 的设计逻辑,帮助你理解模型性能提升背后的原因,而不是停留在简单调用层面;
- 🔬 改进方案验证:通过消融实验、指标对比与可视化分析,评估不同改进模块对 Precision、Recall、mAP、FPS、Latency、参数量和 FLOPs 的实际影响。
PS:如果你按照文中步骤对 YOLOv10 进行优化后仍然遇到问题,请不必焦虑或灰心。
YOLOv10 是一个涉及网络结构、特征提取、标签分配、梯度优化、端到端预测与部署环境的复杂目标检测框架,最终表现会受到 硬件环境、数据集质量、任务定义、类别分布、训练配置、代码版本与部署平台 等多重因素的共同影响。
这是目标检测项目中十分常见的客观现象,并不意味着某个改进模块一定无效。
如果你在实践过程中遇到以下问题:
- 🐛 模块替换后出现新的报错或 Bug;
- 📉 Precision、Recall 或 mAP 难以继续提升;
- 📈 训练损失异常、梯度不稳定或模型难以收敛;
- 🎯 One-to-One / One-to-Many 分支训练效果异常;
- ⏱️ 推理速度、Latency、显存占用或部署性能不达预期;
- 🔄 修改网络结构后出现维度、通道数或特征层不匹配;
- ⚙️ 修改检测头后端到端预测分支出现兼容性问题;
- 📦 模型导出 ONNX、TensorRT、OpenVINO 等格式时失败;
欢迎将 完整报错信息 + 环境版本 + 关键配置截图 + 网络配置文件 + 核心代码片段 粘贴至评论区,我们可以一起分析问题根因,并探讨更加可行的解决方案。
如果你已经摸索出更优的训练参数、网络结构、标签分配策略、模块组合或部署优化思路,也非常欢迎在评论区分享。
你的每一条实战经验,都可能成为其他开发者解决问题、减少试错成本的关键线索。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对 YOLOv10 的主流改进方案进行重构与再设计,使内容更加贴近工业检测、智慧交通、游戏分析、行为识别、遥感影像、无人机视觉与边缘设备部署等真实应用场景。
## 🧧🧧 文末福利,等你来拿!🧧🧧
📌 文中所涉及的技术内容,大多来源于本人在 YOLOv10 项目中的一线实践积累,部分案例参考了开源项目、公开论文、技术社区资料与读者反馈。
如有版权相关问题,欢迎第一时间联系,我将尽快核实并进行修改或下线处理。
部分问题分析思路与排查路径参考了技术社区及 AI 问答平台,在此一并致谢 🙏
最后想说的是:
YOLOv10 的优化本质上是一个高度依赖任务、数据和部署环境的系统工程问题,不存在“一招通杀”的银弹方案。
一致性双重标签分配、One-to-Many / One-to-One 检测策略、注意力机制、轻量化卷积、改进检测头、IoU 损失函数、特征融合模块和数据增强策略,都有其适用条件。
某个模块在公开数据集上取得提升,并不意味着它能够在所有自定义数据集、硬件平台和业务场景中获得同样收益。
尤其对于 YOLOv10 而言,在进行结构改进时还需要额外关注 端到端检测分支、标签分配一致性以及 NMS-Free 推理链路。某些直接从 YOLOv8、YOLOv9、YOLOv11 等模型迁移过来的模块,如果没有处理好检测头与训练分支之间的适配关系,也可能出现精度下降、训练不稳定或推理逻辑异常等问题。
真正有效的优化路径,永远源于:
- 对业务目标与评价指标的准确理解;
- 对数据质量和类别分布的持续分析;
- 对模型瓶颈的定位与针对性改进;
- 对 One-to-Many 与 One-to-One 分支机制的正确理解;
- 对实验变量的严格控制;
- 对精度、速度、Latency、参数量和部署成本的综合权衡;
- 以及一轮又一轮可复现的对比实验。
如果你已经在自己的项目中探索出了更加高效、稳定的 YOLOv10 优化路径,非常鼓励你:
- 💬 在评论区简要分享核心思路与实验结论;
- 📊 分享不同模块的消融实验结果;
- 📝 将完整过程整理成教程、博客或系列文章;
- 🔧 提交可复现的配置文件、代码或工程实践经验。
你的经验,或许正是别人卡关已久所缺少的最后一块拼图。
✅ 本期关于 YOLOv10 优化与实战应用 的内容就先聊到这里。
如果你想进一步深入:
- 🔍 系统理解 Consistent Dual Assignments 与 YOLOv10 的整体网络结构;
- 🎯 深入理解 One-to-Many 与 One-to-One 双标签分配机制;
- 🚀 掌握 YOLOv10 无 NMS 端到端目标检测的实现原理;
- 🧱 学习主干网络、颈部网络、检测头与特征融合模块的改进方法;
- 📉 掌握损失函数、匹配度量、样本分配与训练策略的优化技巧;
- ⚡ 对比不同场景下的模型轻量化与部署加速方案;
- 🧪 建立规范的消融实验、指标对比与模型评估流程;
- 🧠 系统构建一套属于自己的 YOLOv10 调优方法论;
欢迎继续关注专栏:《YOLOv10实战:从入门到深度优化》
期待这些内容能够在你的项目中真正落地见效,帮助你 少踩坑、多提效、快验证、稳部署,我们下期见。
✨ 当然,如果 YOLOv10 专栏已经无法满足你,也可以继续关注:
-
《YOLOv9实战:从入门到深度优化》
-
《YOLOv11实战:从入门到深度优化》
-
《YOLOv12实战:从入门到深度优化》
更多新版本、新模块与新论文的工程复现内容,也会持续更新。
✍️ 码字不易,如果这篇文章对你有所启发或帮助,欢迎给我来个 一键三连:关注 + 点赞 + 收藏。
你的支持,是我持续输出高质量 YOLOv10 技术内容与工程实战案例最直接的动力来源。
同时诚挚推荐关注我的技术号: 「猿圈奇妙屋」
在这里,你可以:
- 📡 第一时间获取 YOLOv10、目标检测、多目标追踪与多任务学习等方向的进阶内容;
- 🛠️ 获取视觉算法、深度学习与模型部署的最新优化方案和工程实战经验;
- 📚 学习 PyTorch、OpenCV、ONNX、TensorRT 等相关技术;
- 🎁 获取 BAT 大厂面经、技术书籍 PDF、工程模板与常用工具清单等实用资源。
期待在更多维度上与你一起进步、共同成长。
🫵 Who am I?
我是专注于 计算机视觉、图像识别、目标检测与深度学习工程落地 的讲师和技术博主,笔名 bug菌:
- 活跃于 CSDN|稀土掘金|InfoQ|51CTO|华为云开发者社区|阿里云开发者社区|腾讯云开发者社区|开源中国|博客园|墨天轮 等技术社区;
- CSDN 博客之星 Top 30、华为云多年度十佳博主及卓越贡献奖获得者、掘金多年度人气作者 Top 40;
- CSDN、掘金、InfoQ、51CTO 等平台签约作者及优质创作者;
- 全网粉丝累计 30w+。
更多高质量技术内容与成长资料,可查看合集入口:
👉 点击查看 👈️
硬核技术号 「猿圈奇妙屋」 期待你的加入,一起进阶、一起打怪升级。
– End –