自然语言处理NLP
(一)输入
在之前的项目实战学习过程中,已经完成了回归任务和分类任务,二者的输入分别为:向量(身高、体重等)和矩阵(图片等),此次学习过程中要学习剩下的一种常见输入,即序列(视频、文字段、声音段等)。
一个问题:如何用数据表示文字?
方法一:One-hot Encoding(独热编码)
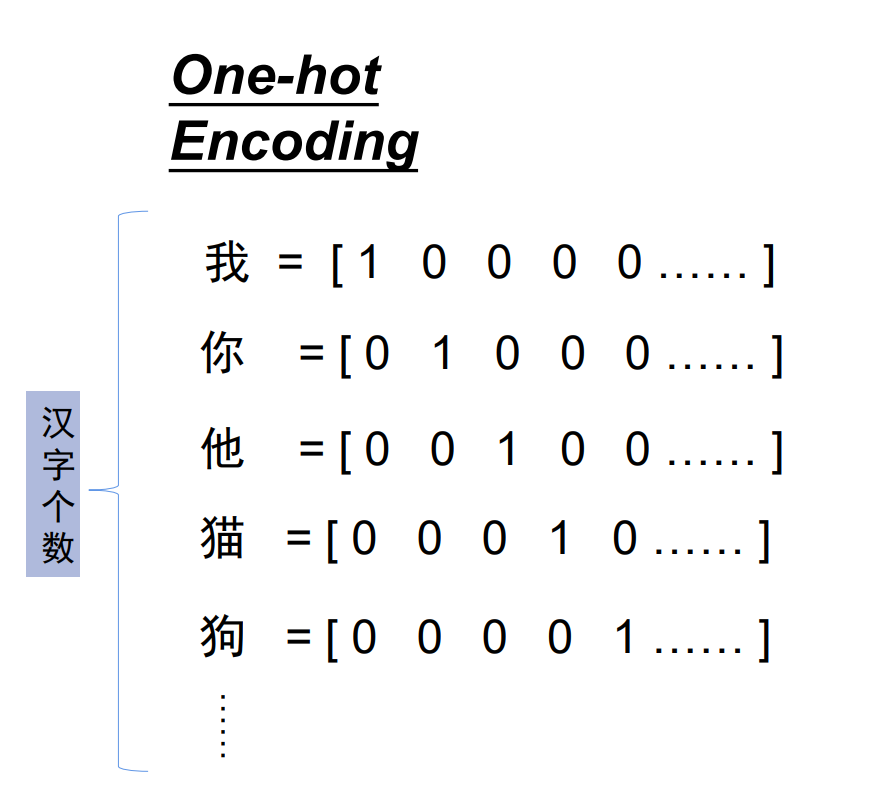
不足之处:
①太浪费空间:如果字典有10万个词,每个词都是一个长度10万的向量,里面99999个都是0。
②没有语义:比如计算机看不出“猫”和“狗”是相似的,因为它们的向量正交(完全不相关)。
方法二:Word Embedding(词嵌入)
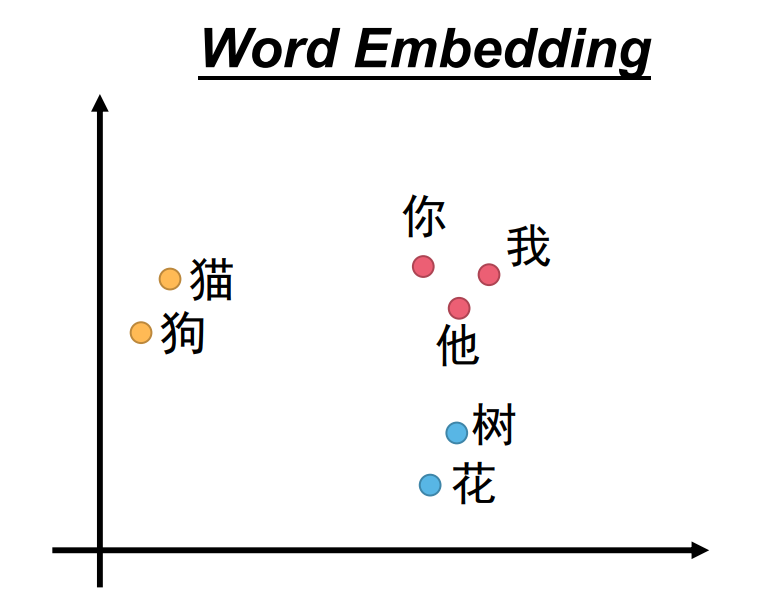
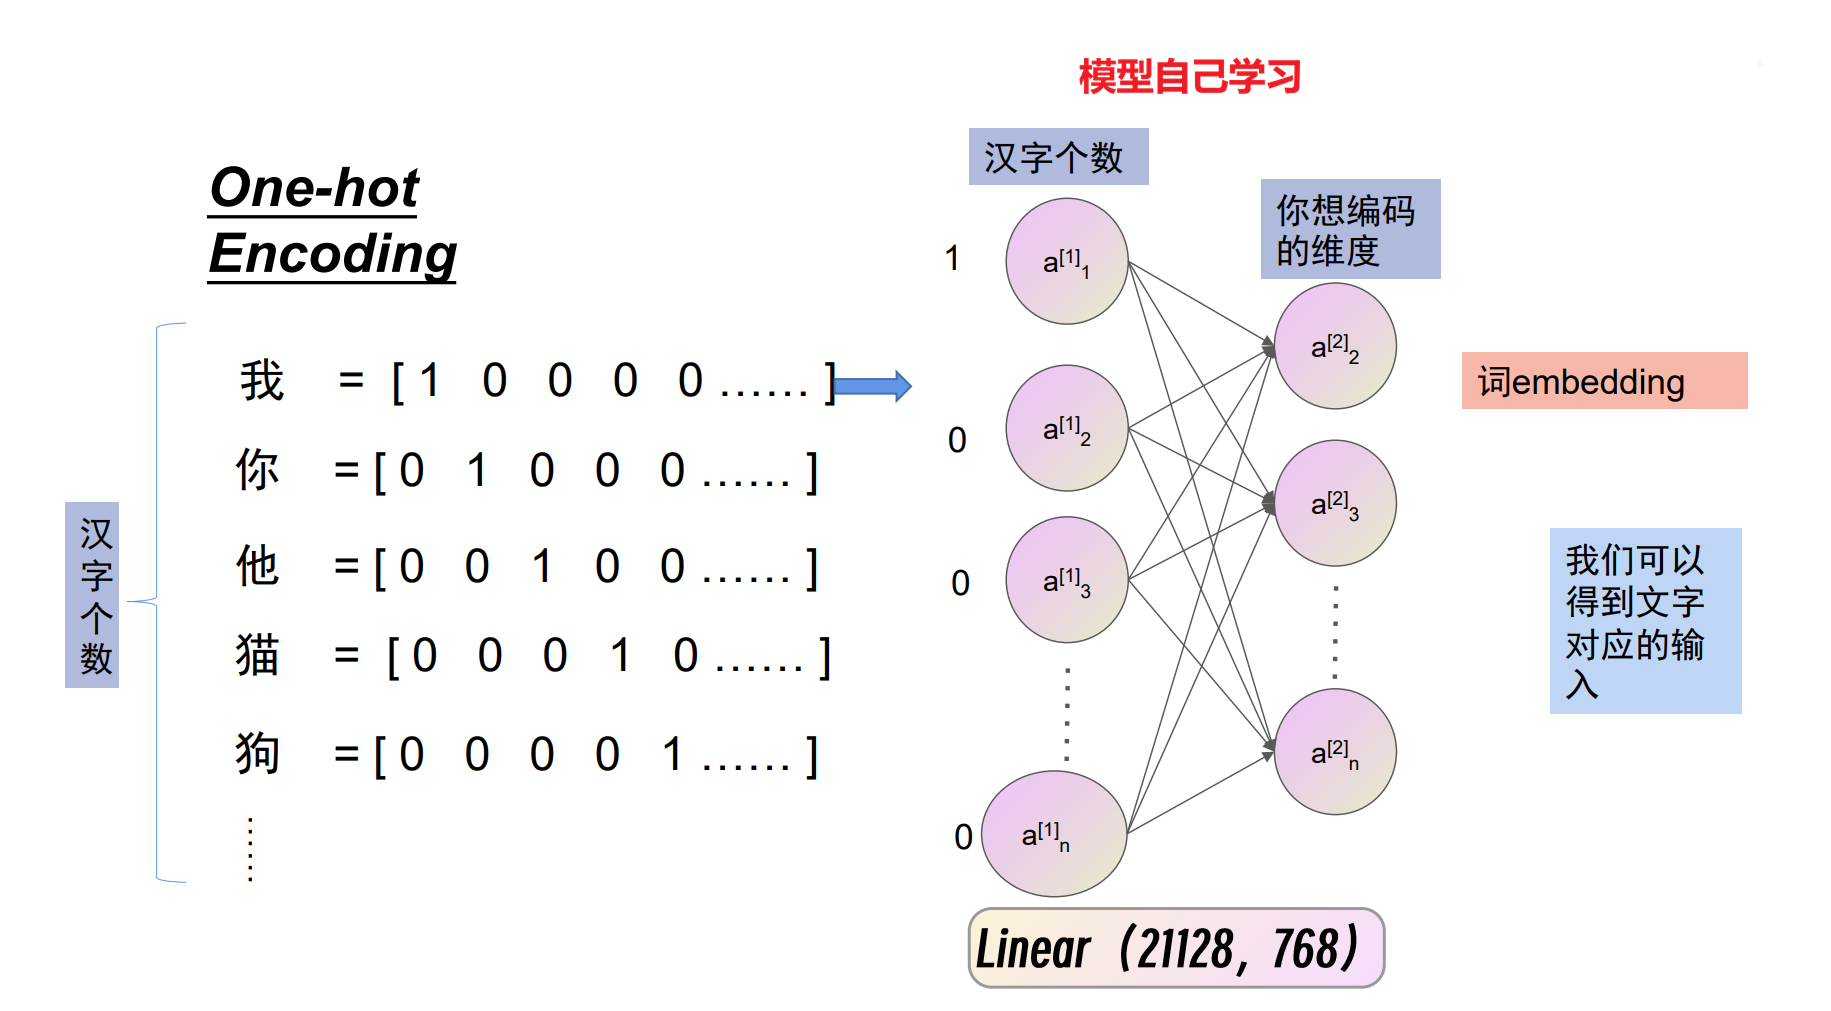
核心原理:把一个维数为所有词的数量的高维空间嵌入到一个维数低得多的连续向量空间中(即把用独热编码的字映射到一个维数更低的向量空间中)。不再用只有0和1的长向量,而是用一个较短的(比如768维)、密集的、全是小数的向量来表示一个词。可以把每一维看作是这个词的一个“属性”打分。在计算机里这些属性是自动学出来的,我们不知道具体代表什么。
一个例子:假设我们需要分辨“国王”、“王后”、“苹果”三个词,我们设定3个特征维度
| 维度含义 (假设) | 国王 (King) | 王后 (Queen) | 苹果 (Apple) |
| 特征 1:皇室等级 | 0.99 (很高) | 0.99 (很高) | 0.01 (很低) |
| 特征 2:性别 | 0.95 (男) | 0.05 (女) | 0.50 (中性) |
| 特征 3:是否生物 | 0.99 (是) | 0.99 (是) | 0.90 (是植物) |
真正的向量样子:
国王:[0.99, 0.95, 0.99] 王后:[0.99, 0.05, 0.99] 苹果:[0.01, 0.50, 0.90]
最终效果:
①语义相似性:语义相似的词距离可以靠得更近(例:“国王”和“王后”靠得很近,离“苹果”很远)。
②数学运算:神经网络学会了一种逻辑(例:国王 – 男人 + 女人 ≈ 王后)。
(二)输出
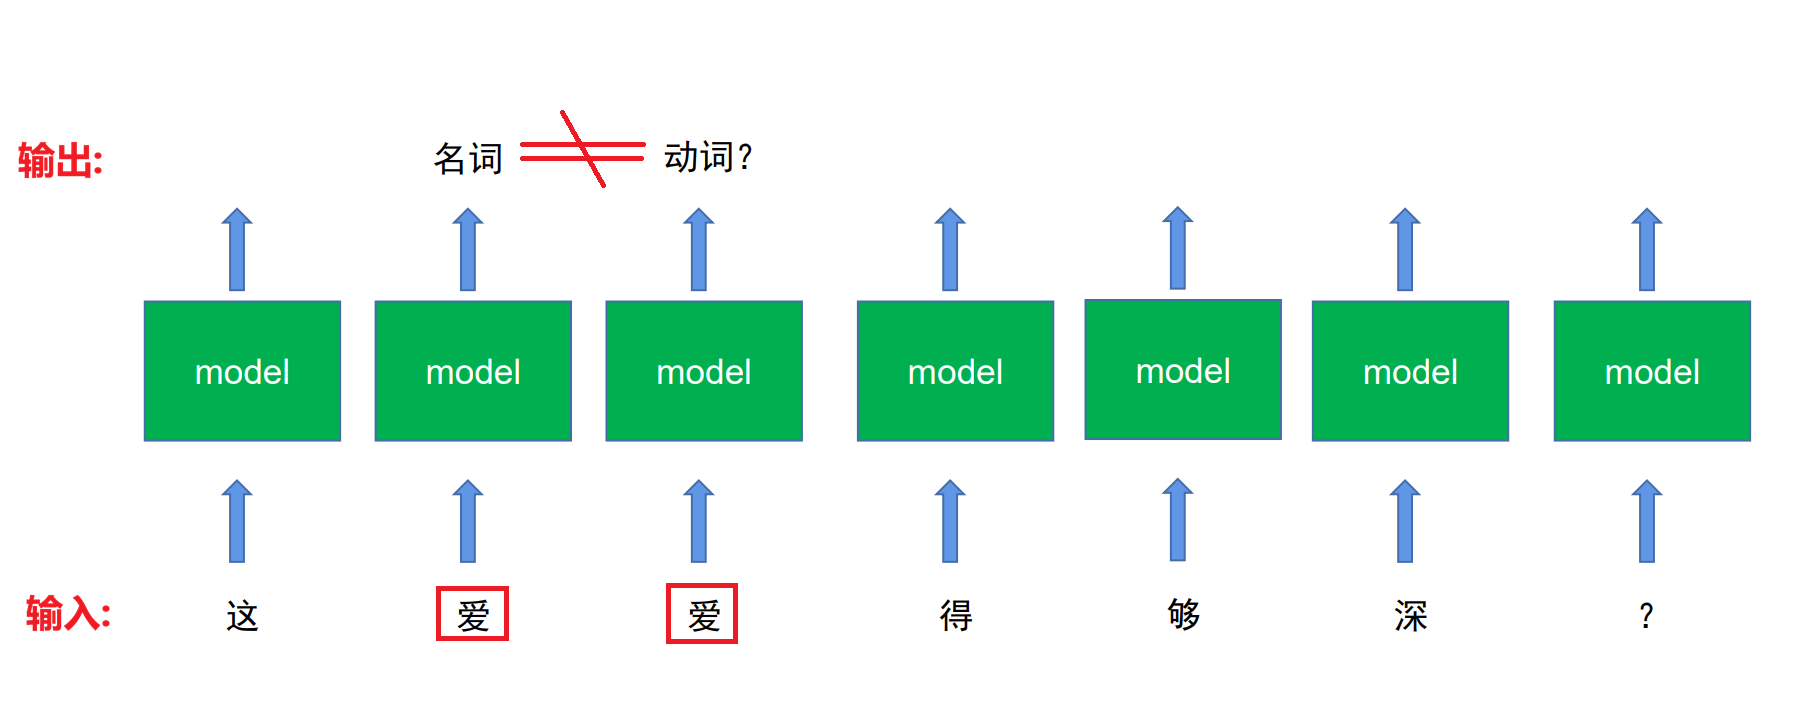
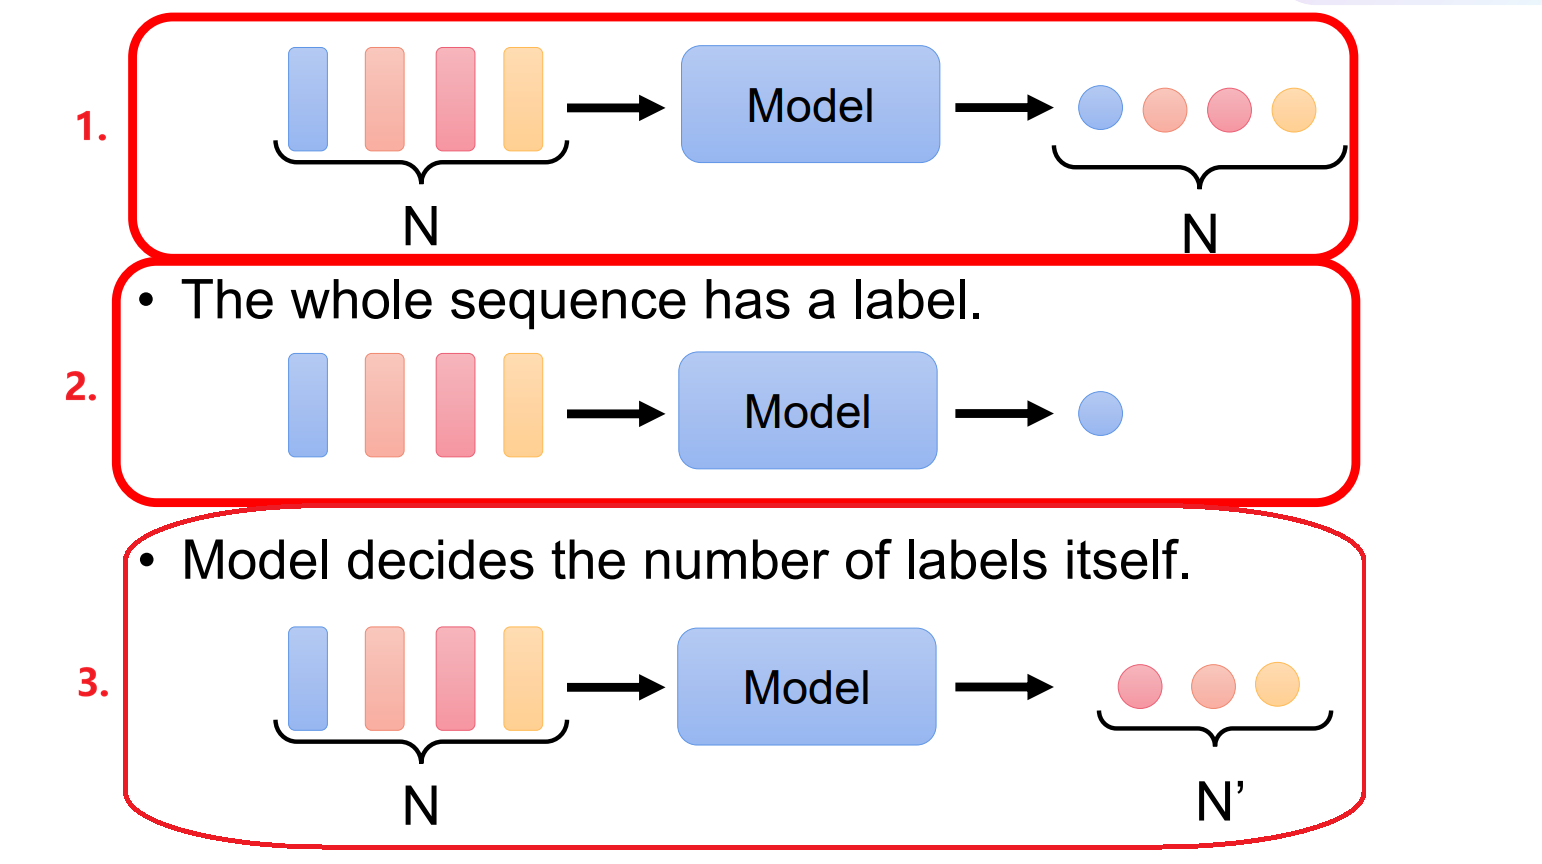
1.每个词都输出一个值(例:词性识别,我 爱 你→代词、动词、代词)
2.所有词共输出一个值(例:情感分类,你做的不错→正向,又emo了→负向)
3.输入输出长度不对应(例:翻译,我爱中国 = I love China)
(三)模型架构
一个注意:一段话是一种序列输入,每个字不仅和自己本身相关,字与字之间还有上下文关系,这种关系对于一个字在句中表达的意思有很大的影响,如果模型只根据一个字本身去学习它的种种含义,那么就不能完成读懂句子这样的任务。