1 链表的产生
在数据结构中,顺序表(数组)我在之前的文章里已经讲过,不明白的同学,可以翻一翻我前几天发的文章,这里我就不多做赘述了。
有没有同学发现顺序表查改元素固然方便,但它的容量扩容,会造成一定量的空间浪费?
比如我先设置内存为4个数组,当我要存第5个元素进去的时候,内存会扩容,为了平衡扩容次数和内存浪费的问题,size会由4*2变为8,保证不需要平繁扩容,同时也保证空间占有率至少有50%,但这本质上还是不可避免的造成空间的浪费,有没有办法解决这个问题?
还有插入删除需移动元素,当数组储存量大时,一次的删除中间值,就让这个工作量变的很大。那如果需要平繁的操作呢?这是不是需要大量的算力?所以,这时候人们就发明出了链表,弥补顺序表的缺陷,让链表成为顺序表的兄弟,解决不同的问题,不同的需求。本文会从链表的核心概念、实现逻辑、实战代码到应用场景,全方位拆解链表,帮你彻底搞懂这个链表。
2 链表的核心概念
2.1. 链表的基本单元:节点(Node)
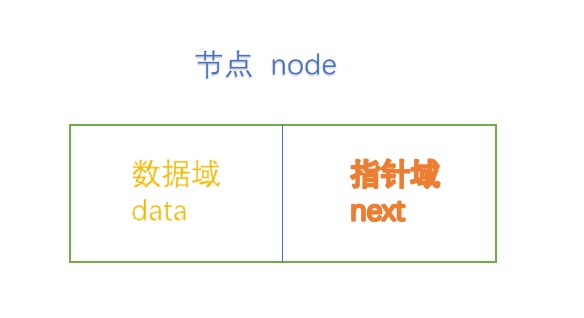
链表的最小组成单位是节点,每个节点包含两部分: 数据域:存储实际业务数据(比如整数、字符串、自定义结构体)。 指针域:存储下一个节点的内存地址(单链表)。
typedef struct Node {
int data; // 数据域:存储整数
struct Node* next; // 指针域:指向后继节点
} Node;
2.2 单链表结构特点
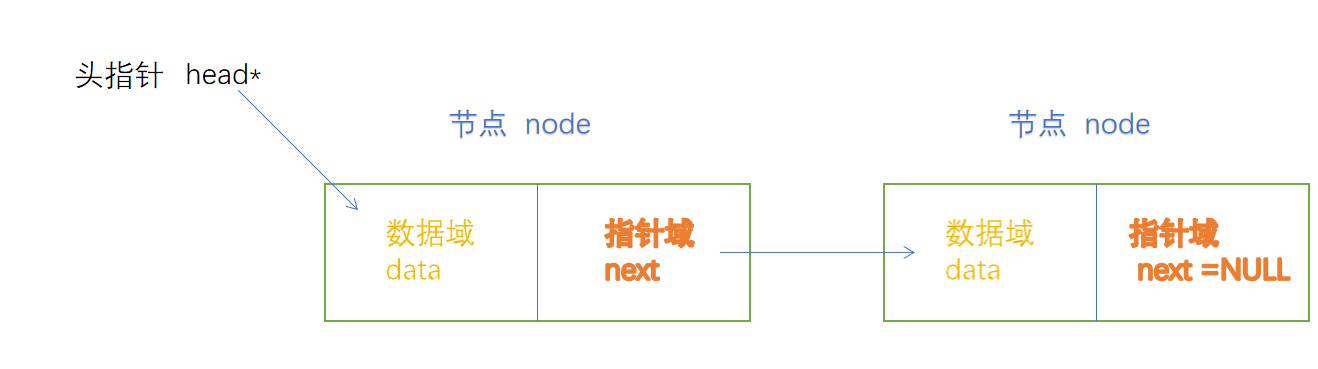
这里先介绍单链表,双链表后面再讲。 1.有一个「头指针」(head),指向链表的第一个节点; 2.最后一个节点的指针域为 NULL(尾节点); 3.链表为空时,头指针为 NULL; 4.访问节点必须从头部开始遍历,无法随机访问(这是链表对比数组的核心短板)。
3 单链表的核心操作:从实现到原理
接下来结合完整代码,拆解单链表的创建节点、插入、遍历、查找、删除、内存释放、文件读写等核心操作,代码均基于 C 语言实现。
3.1 基础准备:头文件与结构体(SList.h)
先定义链表的结构体和函数声明,实现接口与实现分离:
#pragma once
#define _CRT_SECURE_NO_WARNINGS
#include <stdio.h>
#include <stdlib.h>
// 链表节点结构体
typedef struct Node
{
int data; // 节点存储的数据
struct Node* next; // 指向下一个节点的指针
} Node;
// 函数声明
Node* createNode(int data); // 创建新节点
void insertAtHead(Node** head, int data); // 头插法插入节点
void insertAtTail(Node** head, int data); // 尾插法插入节点
void traverseList(Node* head); // 遍历并打印链表
Node* findNode(Node* head, int target); // 查找指定值的节点
int deleteNode(Node** head, int target); // 删除指定值的节点
void freeList(Node** head); // 释放链表所有内存
void saveListToFile(Node* head, const char* filename); // 链表保存到文件
void loadListFromFile(Node** head, const char* filename);// 从文件加载链表
3.2 核心操作实现(SList.c)
(1)创建节点:链表的 “基本砖块”创建节点的本质是申请内存、初始化数据和指针:
#include"SList.h"
// 创建新节点
Node* createNode(int data)
{
// 申请内存
Node* newNode = (Node*)malloc(sizeof(Node));
if (newNode == NULL)
{
printf("内存分配失败!\\n");
exit(1); // 内存分配失败直接退出程序
}
newNode->data = data; // 初始化数据域
newNode->next = NULL; // 初始化指针域(默认指向空)
return newNode;
}
注意:malloc 申请的内存需要在之后的函数操作中手动释放,否则会造成内存泄漏的严重问题!
(2)插入节点:头插 和 尾插 插入是链表的核心操作优势,常见的有「头插法」和「尾插法」。
头插法:新节点成为新的头节点。
// 头插法插入节点(**head 用于修改原头指针)
void insertAtHead(Node** head, int data)
{
Node* newNode = createNode(data);
newNode->next = *head; // 新节点指向原头节点
*head = newNode; // 头指针指向新节点
}
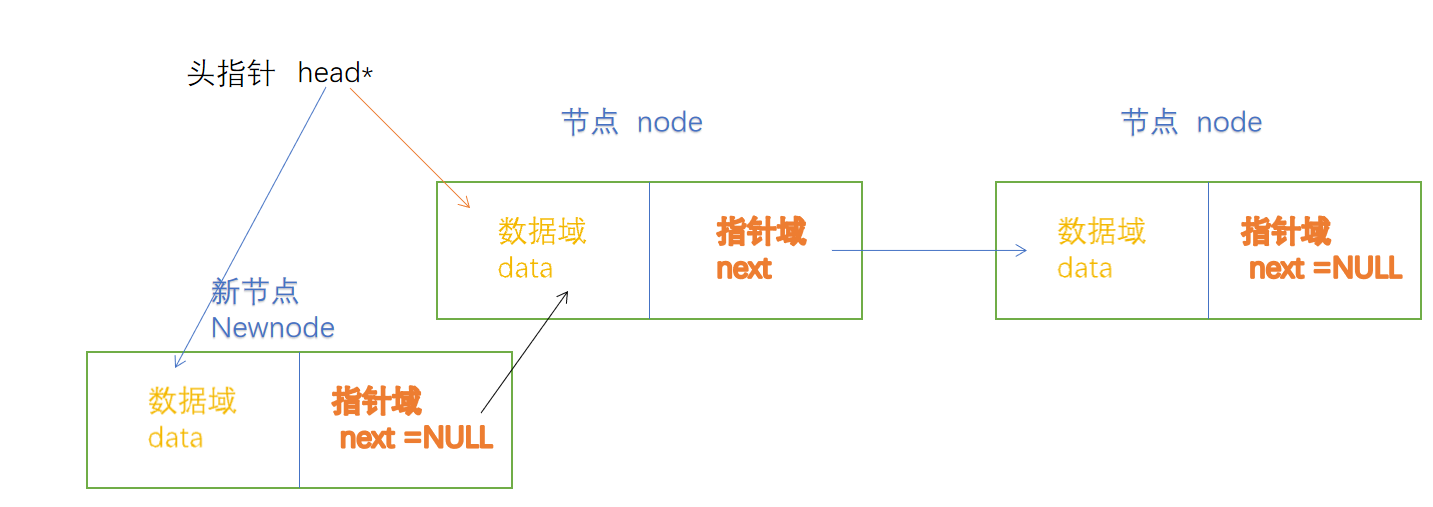
注意:要先将新节点指向原头节点,避免找不到旧的,造成节点丢失。
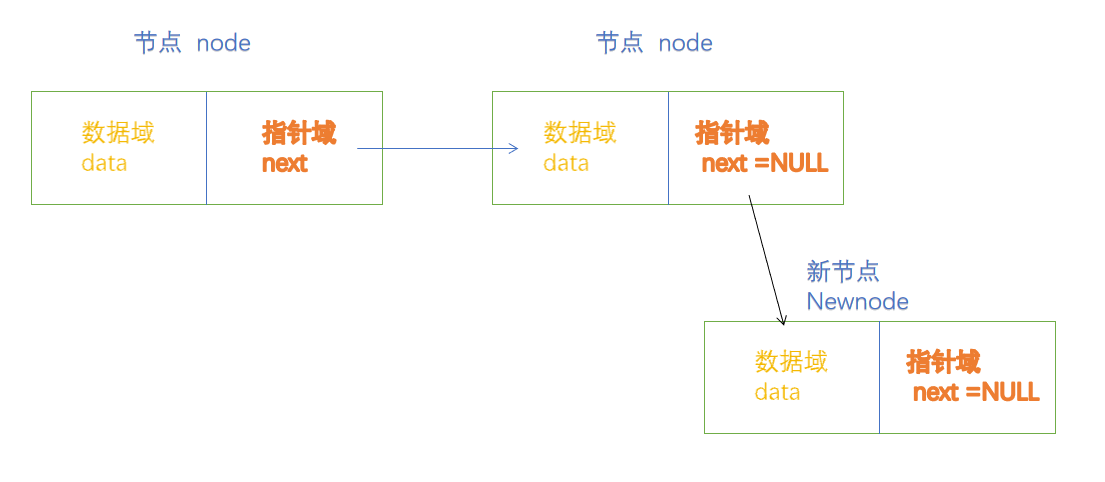
尾插法:新节点追加到链表尾部,同时要考虑链表为空的情况。
// 尾插法插入节点
void insertAtTail(Node** head, int data)
{
Node* newNode = createNode(data);
// 链表为空时,直接作为头节点
if (*head == NULL)
{
*head = newNode;
return;
}
// 找到最后一个节点
Node* temp = *head;
while (temp->next != NULL)
{
temp = temp->next;
}
temp->next = newNode; // 尾节点指向新节点
}
尾插对比头插来说,相对简单。只需要将原尾节点的指针域指向新建的节点的数据域就可以了。
(3)打印结果,遍历链表:从头走到尾
遍历是链表最基础的操作,核心是从头指针出发,通过指针域逐个访问,直到尾节点即next=NULL为止。
// 遍历链表并打印所有节点数据
void traverseList(Node* head)
{
if (head == NULL)
{
printf("链表为空\\n");
return;
}
Node* temp = head;
printf("链表数据:");
while (temp != NULL)
{
printf("%d ", temp->data);
temp = temp->next;
}
printf("\\n");
}
但要注意:我们不能改变头指针,要使用临时变量。
(4)查找节点:按值查找
这个就是链表的缺点,不能像数组一样快速遍历,要从头指针开始遍历整个链表。
// 查找指定值的节点,找到返回节点指针,未找到返回NULL
Node* findNode(Node* head, int target)
{
Node* temp = head;
while (temp != NULL)
{
if (temp->data == target)
{
return temp; // 找到目标节点
}
temp = temp->next;
}
return NULL; // 未找到
}
(5)删除节点
这个我们要考虑处理三种场景:删除头节点、删除中间节点、删除尾节点。其核心是找到待删节点的前驱节点,修改指针指向,并释放内存:
// 删除指定值的节点,成功返回1,失败返回0
int deleteNode(Node** head, int target)
{
// 链表为空直接返回失败
if (*head == NULL)
{
return 0;
}
Node* temp = *head;
Node* prev = NULL; // 记录前驱节点
// 场景1:删除头节点
if (temp != NULL && temp->data == target)
{
*head = temp->next; // 头指针指向原头节点的下一个节点
free(temp); // 释放原头节点内存
return 1;
}
// 场景2:删除中间/尾节点(先找到目标节点)
while (temp != NULL && temp->data != target)
{
prev = temp; // 记录前驱节点
temp = temp->next; // 继续遍历
}
// 未找到目标节点
if (temp == NULL)
{
return 0;
}
// 找到目标节点,修改前驱节点指针,释放内存
prev->next = temp->next;
free(temp);
return 1;
}
(6)释放链表内存:避免内存泄漏
链表的内存是碎片化申请的,必须逐个节点释放,最后将头指针置空。
// 释放链表所有内存(防止内存泄漏)
void freeList(Node** head)
{
Node* current = *head;
Node* nextNode;
while (current != NULL)
{
nextNode = current->next; // 先保存下一个节点地址
free(current); // 释放当前节点
current = nextNode; // 移动到下一个节点
}
*head = NULL; // 头指针置空,避免野指针
}
(7)链表的持久化:文件读写
像之前的顺序表一样,链表数据也需要持久化存储,这里实现链表数据保存到文件和从文件加载数据链表。
// 将链表数据保存到文件(每个节点值占一行)
void saveListToFile(Node* head, const char* filename)
{
FILE* fp = fopen(filename, "w");
if (fp == NULL)
{
printf("文件打开失败,无法保存链表\\n");
return;
}
Node* temp = head;
while (temp != NULL)
{
fprintf(fp, "%d\\n", temp->data); // 写入节点数据
temp = temp->next;
}
fclose(fp);
printf("链表已成功保存到文件:%s\\n", filename);
}
// 从文件加载链表(先清空原链表)
void loadListFromFile(Node** head, const char* filename)
{
// 清空原链表
if (*head != NULL)
{
freeList(head);
}
FILE* fp = fopen(filename, "r");
if (fp == NULL)
{
printf("文件打开失败,无法加载链表\\n");
return;
}
int data;
// 逐行读取数据,尾插法构建链表
while (fscanf(fp, "%d", &data) != EOF)
{
insertAtTail(head, data);
}
fclose(fp);
printf("已从文件 %s 加载链表\\n", filename);
}
4 测试
#include"SList.h"
int main()
{
Node* head = NULL; // 初始化头指针为NULL(空链表)
// 尾插法插入节点
insertAtTail(&head, 10);
insertAtTail(&head, 20);
insertAtTail(&head, 30);
traverseList(head); // 输出:链表数据:10 20 30
// 头插法插入节点
insertAtHead(&head, 5);
traverseList(head); // 输出:链表数据:5 10 20 30
// 查找节点
int target = 20;
Node* foundNode = findNode(head, target);
if (foundNode != NULL) {
printf("找到节点:%d\\n", foundNode->data); // 输出:找到节点:20
} else {
printf("未找到节点:%d\\n", target);
}
// 删除节点
int delTarget = 10;
if (deleteNode(&head, delTarget))
{
printf("成功删除节点:%d\\n", delTarget); // 输出:成功删除节点:10
traverseList(head); // 输出:链表数据:5 20 30
} else
{
printf("删除失败,未找到节点:%d\\n", delTarget);
}
// 释放链表内存
freeList(&head);
traverseList(head); // 输出:链表为空
// 保存链表到文件(此时链表为空)
saveListToFile(head, "slist_data.txt");
// 从文件加载链表(重新构建)
Node* newHead = NULL;
loadListFromFile(&newHead, "slist_data.txt");
printf("加载后的链表:");
traverseList(newHead); // 输出:链表为空(因为保存时链表已释放)
// 重新插入数据后再次测试保存/加载
insertAtTail(&newHead, 5);
insertAtTail(&newHead, 20);
insertAtTail(&newHead, 30);
saveListToFile(newHead, "slist_data.txt");
Node* newHead2 = NULL;
loadListFromFile(&newHead2, "slist_data.txt");
printf("重新加载后的链表:");
traverseList(newHead2); // 输出:链表数据:5 20 30
// 释放所有内存
freeList(&head);
freeList(&newHead);
freeList(&newHead2);
return 0;
}
5 总结
链表是数据结构的核心基础,它的核心思想是用指针串联非连续内存,以 “牺牲随机访问效率” 为代价,换来了动态扩容和高效插入删除的优势。
完整代码我已上传gitee,需要自取:https://gitee.com/xie-xiancong/linked-list.git