逆向题解之flower
flower
题目分析
这是一个花指令的题,题目中有所提示:什么是花指令?为什么我的F5不工作了?不了解花指令,所以我读了一些博文去学习花指令,在此先对花指令及其解决办法进行一个介绍。
花指令:企图隐藏掉不想被逆向工程的代码块(或其他功能)的一种方法,通过在真实代码中插入一些垃圾代码来使得程序无法正常反编译从而难以理解程序的内容进而达到混淆视听的效果。
花指令大致分为可执行和不可执行两类,不可执行式花指令利用反汇编器线性扫描算法的缺陷使得静态分析的时候会看到一些错误的代码。
flower绕开花指令
首先在IDA里面打开flower软件,先用F5尝试反汇编,我们发现程序竟然成功反编译了,于是按照正常逻辑我们需要先进入main函数的反汇编代码,从main函数入手因此进入函数中套用的函数来分析逻辑,在此先附上main函数的反汇编代码:
int __fastcall main(int argc, const char **argv, const char **envp)
{
__int64 v3; // rax
std::runtime_error *exception; // rbx
__int64 v5; // rax
char v7[32]; // [rsp+0h] [rbp-60h] BYREF
char v8[40]; // [rsp+20h] [rbp-40h] BYREF
unsigned __int64 v9; // [rsp+48h] [rbp-18h]
v9 = __readfsqword(0x28u);
check();
v3 = std::operator<<<std::char_traits<char>>(&std::cout, "Input your flag:\\n> ");
std::ostream::operator<<(v3, std::flush<char,std::char_traits<char>>);
if ( !main::zero )
{
exception = (std::runtime_error *)_cxa_allocate_exception(0x10uLL);
std::runtime_error::runtime_error(exception, "Division by zero");
_cxa_throw(exception, (struct type_info *)&`typeinfo for'std::runtime_error, std::runtime_error::~runtime_error);
}
v5 = std::ostream::operator<<(&std::cout, (unsigned int)(10 / main::zero), (unsigned int)(10 % main::zero));
std::ostream::operator<<(v5, std::endl<char,std::char_traits<char>>);
std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::basic_string(v7);
std::operator>><char,std::char_traits<char>,std::allocator<char>>(&std::cin, v7);
std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::basic_string(v8, v7);
solve(v8);
std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::~basic_string(v8);
std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::~basic_string(v7);
return 0;
}
这段代码的逻辑我们后面再说,先观察这段代码,我们发现main函数中套用了两个函数——check()和solve()函数,说明这两个函数都很重要,于是我们尝试去打开这两个函数(双击函数名),我们发现:我们成功打开了check()函数但solve()函数在点的时候报错了:
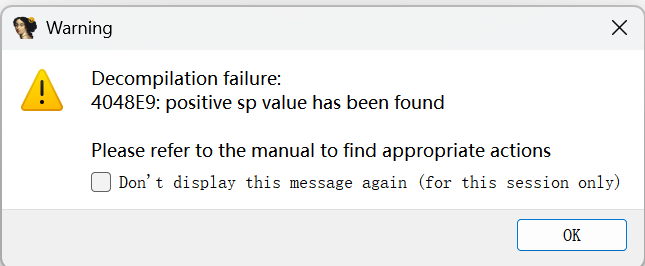 通过报错,我们推断4048E9处可能使用了花指令,于是我们回到IDA View-A窗口的text模式,找到4048E9,然后U一下E9使它转换成数据,我们发现:
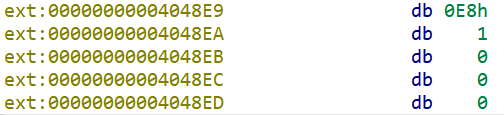 于是我们确定了4048E9是有问题的,我们需要把它NOP掉,但是为了确保不少NOP,我们还需要查看一下前后的代码:
 经过观察我们发现,这段代码逻辑符合花指令的一般构成:
.text:00000000004048E5 loc_4048E5: ; 这是一个标签位置
.text:00000000004048E5 jz short Label ; 花指令开始
.text:00000000004048E7 jnz short Label ; 花指令继续
.text:00000000004048E9 call near ptr Label+1 ; 花指令干扰
所以我们初步确定指令的大致范围,我们需要将这部分NOP掉才能让代码正常运行,我在IDC中执行了这一脚本来NOP掉这部分代码:
auto i;
for (i = 0x4048E5; i < 0x4048EA; i++) {
PatchByte(i, 0x90);
}
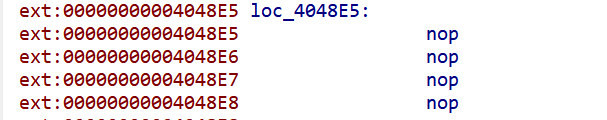
这段代码是一个for循环,然后其功能是将原花指令替换为"90 90 90 90 90”即NOP掉,代码执行后的结果如下:
 然后我们尝试F5反汇编solve()函数,发现函数成功反汇编:
unsigned __int64 __fastcall solve(__int64 a1)
{
char v1; // bl
bool v2; // r12
__int64 v3; // rax
char v5[40]; // [rsp+30h] [rbp-40h] BYREF
unsigned __int64 v6; // [rsp+58h] [rbp-18h]
v6 = __readfsqword(0x28u);
v1 = 0;
v2 = 1;
if ( (unsigned __int64)std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::length(a1) > 7 )
{
std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::substr(v5, a1, 0LL, 7LL);
v1 = 1;
if ( !(unsigned __int8)std::operator!=<char,std::char_traits<char>,std::allocator<char>>(v5, "moectf{")
&& *(_BYTE *)std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::back(a1) == 125 )
{
v2 = 0;
}
}
if ( v1 )
std::__cxx11::basic_string<char,std::char_traits<char>,std::allocator<char>>::~basic_string(v5);
if ( !v2 )
JUMPOUT(0x4048E5LL);
v3 = std::operator<<<std::char_traits<char>>(&std::cout, "FORMAT ERROR!");
std::ostream::operator<<(v3, std::endl<char,std::char_traits<char>>);
return v6 – __readfsqword(0x28u);
}
成功绕过花指令!
flag求解之路
从main出发
main函数作为一个系统的入口函数一直都是需要重点研究的对象,因此在此我先对main函数进行分析(main函数已经放至花指令中可上翻查看)
栈保护读取
_readfsqword(Ox28)这个函数一般是栈保护,表明编译器开启了栈保护(这部分我还不是很了解,仅上网搜索得到)
check()调用
这个函数通常是反调试或者初始化,需要特别关注该函数的具体内容,如果这个函数做了反调试就可能会影响IDA的正常分析,我们在看代码的时候需要特别注意这个函数的地址以及函数是否出现检测、是否有修改全局变量。
cout<<"Input your flag:\\n> "
在main的第11和12行中出现了"flag"字眼以及"std::flush",提示了我们应该从stdin提供flag,并且提示了字符串在.rodata里面(C++程序里写死的字符串都会被放在只读数据段里面即.rodata),我们可以通过strings定位并且作为cross-reference的线索。
全局变量main::zero
我们进入if语句接着分析,该语句里面有一段话:Division by zero,从中我们可以得到这是一个抛零操作(全局变量被读取并用于除法,若为0会抛异常),所以一般来说这会成为我们需要查找的一个地方,我们需要在check或入口位置查找对它的写入以确定其是否用于反调试(若为0程序会崩溃)
输入读取与参数传递
main第23行的std::operator>>(std::cin, v7);等价与std::cin >> v7;指明了从标准输入读取一段字符串并保存在v7中;第24行的basic_string(v8, v7);其实就是告诉我们把输入的字符串拷贝到另一个字符串变量v8里面;而第25行的solve((__int64)v8);又调用了solve函数将用户输入的字符串作为参数传了进去,因此这一步明显是检验逻辑的入口所以solve是整个校验逻辑的核心所在,我们后续的分析应该聚焦于solve函数。
分析check()
双击main()中的check()函数,定位到check()函数的伪代码如下:
bool check()
{
bool result; // al
__int64 v1; // rax
result = ptrace(0LL, 0LL, 0LL, 0LL) == -1;
if ( result )
{
v1 = std::operator<<<std::char_traits<char>>(&std::cerr, "Don't trace me:(");
std::ostream::operator<<(v1, std::endl<char,std::char_traits<char>>);
exit(1LL);
}
return result;
}
ptrace(0LL, 0LL, 0LL, 0LL) == -1;
首先我们来解释一下ptrace函数,经查阅,ptrace函数是一个系统调用方法,可以监视进程执行、查看/更改被监视进程的内存以及寄存器的情况,常常用于断点的测试。在逆向里,程序经常会利用 ptrace 的行为检测“是否有调试器存在”。常见方式是:程序自己尝试调用 ptrace(),如果调用返回错误(例如返回 -1 且 errno == EPERM),说明该进程已经被其它 tracer 跟踪;据此来判断“有人在调试我”,并做出应对(打印提示、退出、改变行为等)。
放在这道题里面,程序在进入关键的阶段之前先调用了ptrace(0LL, 0LL, 0LL, 0LL) == -1,如果该调用返回了-1(即调用失败),则表明"正在被调试",则打印Don't trace me:(并且立即终止。
通过对这部分代码的分析,我们可以得到一个信息:程序有"硬"反调试测试,必须绕过该调试才可能进入solve()函数。
返回值
代码最后"return result"表明如果没有检测到有测试则check()返回0,程序将正常继续,从该返回值中我们可以得知这个返回值并不会对后续的代码有什么影响说明check()函数只是起到一个"检测环境"的作用,对于解flag并没有直接的影响。
分析solve()
solve()的反汇编代码已放到上面,在此我就不再附了,我们接着分析solve()函数,代码如有需要请往上翻。
长度检查(if (…length(a1)>7))
length是求长度的函数,这里是要求输入的长度必须大于七(而我们已知的flag形式"moectf{"刚好长度为七),所以这个if是在检测flag格式是否满足(长度约束),不满足的时候会报错——"FORMAT ERROR!"。
取前缀子串并比较
在反汇编代码中"if ( !(unsigned __int8)std::operator!=<char,std::char_traits<char>,std::allocator<char>>(v5,"moectf{")…)"程序明确要求前七个字符等于常量"moectf{",而常量又在.rodata中,所以可以通过这一步定位出.rodata中常量字符串的位置方便后续的查找与求解。
后缀检查(back(a1) == 125)
"back(a1) == 125"将最后一个字符限定在了ASCII 125处,即'}',相当于将flag的形式限制死了,结合前缀,最终flag的形式应为'moectf{}'。
条件跳转到后续校验
伪代码中当格式校验通过时"JUMPOUT(0x4048E5LL);"表明格式检查通过时代码不会继续打印"FORMAT ERROR!"而是会跳转到0x4048E5LL地址,说明改=该地址可能是真正的校验逻辑,所以我们需要跳转到该地址去继续分析以还原具体的校验算法。
收集所需信息
跳转到solve函数所提供的地址,我发现该地址正是我之前NOP掉的地址,所以很遗憾,该线索貌似断了:
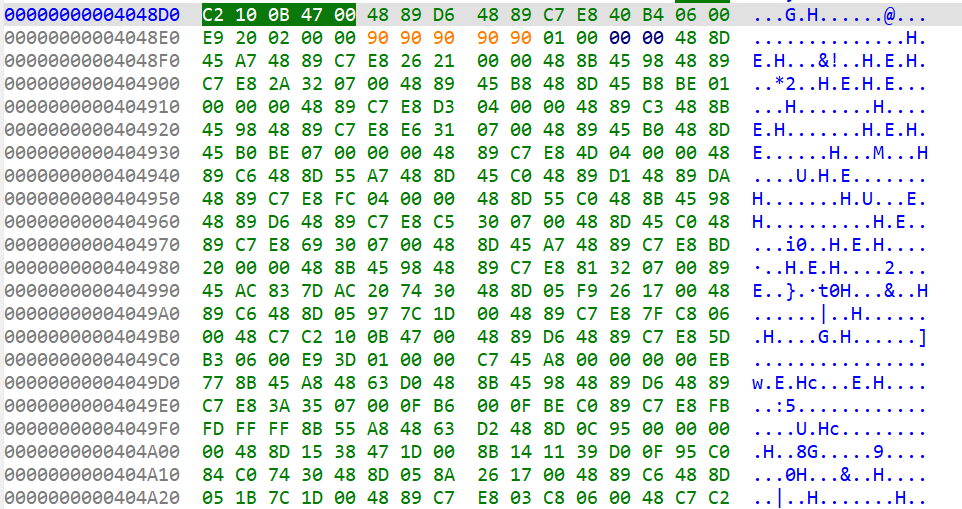
 但是由于之前solve函数显示"JUMPOUT(0x4048E5LL);"说明了真正校验逻辑所在,于是我们只能去想别的方法得到该处的内容,这时我们想到了本题还没怎么用过的Hex表,于是我们需要回到二进制文件本身来抓取该区域的真实字节再用python脚本自动化解析字节以定位真正的数据表位置并打印出来表的内容以供后续分析(我不会自己反汇只能借助python的帮助)。 由于跳转目标是0x4048E5LL,为了保证上下文的完整,我们再往前取几十个字节,从Oc4048D0开始,为了取得数据更加充分完整,我们多取一些数据,我在Hex表中查找了0x4048D0到0x404A20(总共336字节)的二进制数据并复制出来放在了txt文件里面方便后续使用:添加链接描述
定位隐藏的数据表(python脚本实现)
在ai的帮助下,我用了一个python的脚本来自动在二进制里面找到把数据地址加载到寄存器的那条指令并将它指向的静态数据打印出来方便我们来判断是不是加密表或者flag。python脚本如下:
from pathlib import Path
import struct, sys, re
BINARY = "flower"
SEARCH_START = 0x4048d0
SEARCH_END = 0x404a20
data = Path(BINARY).read_bytes()
def parse_phdrs(buf):
if buf[0:4] != b'\\x7fELF':
raise RuntimeError("Not ELF")
if buf[4] != 2:
raise RuntimeError("Not ELF64")
little = (buf[5] == 1)
endian = '<' if little else '>'
e_phoff = struct.unpack_from(endian + 'Q', buf, 0x20)[0]
e_phentsize = struct.unpack_from(endian + 'H', buf, 0x36)[0]
e_phnum = struct.unpack_from(endian + 'H', buf, 0x38)[0]
phs = []
for i in range(e_phnum):
off = e_phoff + i*e_phentsize
p_type, p_flags = struct.unpack_from(endian + 'II', buf, off)
p_offset, p_vaddr, p_paddr, p_filesz, p_memsz, p_align = struct.unpack_from(endian + 'QQQQQQ', buf, off+8)
phs.append({'p_type':p_type,'p_offset':p_offset,'p_vaddr':p_vaddr,'p_filesz':p_filesz,'p_memsz':p_memsz})
return phs
ph = parse_phdrs(data)
# map vaddr->file offset helper
def vaddr_to_offset(vaddr):
for seg in ph:
if seg['p_type'] == 1 and seg['p_vaddr'] <= vaddr < seg['p_vaddr'] + seg['p_filesz']:
return seg['p_offset'] + (vaddr – seg['p_vaddr'])
if seg['p_type'] == 1 and seg['p_vaddr'] <= vaddr < seg['p_vaddr'] + seg['p_memsz']:
return seg['p_offset'] + (vaddr – seg['p_vaddr'])
return None
start_off = vaddr_to_offset(SEARCH_START)
if start_off is None:
raise RuntimeError("Can't map search start vaddr")
region = data[start_off : start_off + (SEARCH_END – SEARCH_START)]
candidates = []
for i in range(0, len(region)–7):
b = region[i:i+7]
if b[0] == 0x48 and b[1] == 0x8d and (b[2] == 0x15 or b[2] == 0x05):
# disp32 is next 4 bytes (little endian)
disp = struct.unpack_from('<i', region, i+3)[0]
insn_vaddr = SEARCH_START + i
next_instr = insn_vaddr + 7
target_vaddr = (next_instr + disp) & 0xffffffffffffffff
candidates.append((insn_vaddr, b[:3].hex(), disp, next_instr, target_vaddr))
if not candidates:
print("No lea [rip+disp] pattern found in region. You may need to expand region.")
sys.exit(1)
print("Found candidate lea patterns (insn_vaddr, opcode, disp, next_instr, target_vaddr):")
for t in candidates:
print("0x{0:08x} op={1} disp={2:+#x} next=0x{3:08x} target=0x{4:08x}".format(*t))
chosen = None
for insn_vaddr,op,disp,nexti,target in candidates:
if target >= 0x500000: # heuristic
chosen = (insn_vaddr,op,disp,nexti,target)
break
if chosen is None:
chosen = candidates[0]
insn_vaddr,op,disp,nexti,target = chosen
file_offset_target = vaddr_to_offset(target)
print("\\nChosen candidate:")
print("insn at 0x{0:08x}, disp={1:+#x}, leads to enc_vaddr=0x{2:08x}".format(insn_vaddr, disp, target))
if file_offset_target is None:
print("Warning: target vaddr 0x{0:08x} not mapped to file offset (maybe it's dynamic).".format(target))
else:
print("Mapped file offset for enc_vaddr: 0x{0:x}".format(file_offset_target))
# print first 64 bytes at that file offset
sample = data[file_offset_target:file_offset_target+64]
print("First bytes at enc file offset (hex):", sample.hex())
# assume table of dwords; show first 16 dwords
import struct
vals = []
for i in range(16):
off = file_offset_target + i*4
if off+4 <= len(data):
vals.append(struct.unpack_from('<I', data, off)[0])
print("First 16 dword values (hex):")
print([hex(x) for x in vals])
我将脚本和flower文件放在了同一目录下用python来读取flower文件。首先将flower文件读进来当成大数据块来进行处理,然后对该文件进行解析(为了能够将虚拟地址和文件偏移量进行互相转换):首先在0x4048D0–0x404A20里扫描常见的lea r?, [rip + disp32]指令字节模式(LEA是Load Effective Address的缩写,它本质上是把一个内存地址计算出来放到寄存器里面,而在64位ELF文件里,静态数据通常存放在.rodata段即只读数据段。在代码中访问这些数据的时候不直接写绝对地址而是用RIP相对寻址来找正确的数据。在LEA指令中,有固定的机器码模式——48 8d 05 xx xx xx xx;lea rax,[rip+disp32],48 8d是LEA指令的前缀,后四个字节是32位偏移量,所以我们要"+disp32"来可以自动定位所有可能加载静态表的指令)在找到每一个LEA并读取了它的disp32(一个32位带符号小端数)之后,我们用公式next_instr_addr=insn_vaddr+7(LEA长度是7字节)来计算目标的虚拟地址,最后将这个目标虚拟地址映射成文件偏移并打印该处的原始字节。
从得到的原始字节中,我们可以判断这几个信息:是否是 ASCII/UTF-8 字符串——如果这些字节包含可打印字符(例如 flag{…} 或明显的文本),说明目标是字符串/flag;是否是查表(lookup table)结构——常见形式:很多 4 字节/8 字节整数排列整齐(例如CRC表、S-box、置换表),脚本打印 dword(4 字节整型)能快速看出这类结构;是否有低熵/重复模式——若大量重复或呈现递增规律,可能是索引表或序列;若高度随机,可能是加密密钥/随机数据;字节序/大小端的线索——打印 dword(按little-endian读)能帮你确认数值是否有意义(比如 0x00000001、0x3f800000 之类);是否是加密伪随机序列(需解密)——看起来像无规律的二进制,但长度和位置提示它可能是密钥或加密表,需要做 XOR / CRC /减法 /移位 等测试。
运行代码后运行结果如下:
"D:\\LJY\\python project\\1\\pythonProject\\.venv\\Scripts\\python.exe" "D:\\LJY\\python project\\1\\pythonProject\\chap2\\03.py"
Found candidate lea patterns (insn_vaddr, opcode, disp, next_instr, target_vaddr):
0x00404998 op=488d05 disp=+0x1726f9 next=0x0040499f target=0x00577098
0x004049a2 op=488d05 disp=+0x1d7c97 next=0x004049a9 target=0x005dc640
0x00404a01 op=488d15 disp=+0x1d4738 next=0x00404a08 target=0x005d9140
0x00404a14 op=488d05 disp=+0x17268a next=0x00404a1b target=0x005770a5
Chosen candidate:
insn at 0x00404998, disp=+0x1726f9, leads to enc_vaddr=0x00577098
Mapped file offset for enc_vaddr: 0x177098
First bytes at enc file offset (hex): 4c454e475448204552524f520057726f6e672100596f752057696e210a00496e70757420796f757220666c61673a0a3e20004469766973696f6e206279207a65
First 16 dword values (hex):
['0x474e454c', '0x45204854', '0x524f5252', '0x6f725700', '0x21676e', '0x20756f59', '0x216e6957', '0x6e49000a', '0x20747570', '0x72756f79', '0x616c6620', '0x3e0a3a67', '0x69440020', '0x69736976', '0x62206e6f', '0x657a2079']
Process finished with exit code 0
提取候选数据段并导出低字节(Python实现)
在映射到文件偏移之后,我又通过ai提供的脚本将他们按4字节读取出了若干值并导出了这些值的最低字节,下面我将附脚本代码并给一个合理的解释:
from pathlib import Path
import struct
BINARY = "flower"
ENC_VADDR = 0x005d9140
COUNT = 32
data = Path(BINARY).read_bytes()
# parse ELF phdrs (ELF64 little-endian)
def parse_phdrs(buf):
if buf[0:4] != b'\\x7fELF':
raise RuntimeError("Not ELF")
if buf[4] != 2:
raise RuntimeError("Not ELF64")
little = (buf[5] == 1)
endian = '<' if little else '>'
e_phoff = struct.unpack_from(endian + 'Q', buf, 0x20)[0]
e_phentsize = struct.unpack_from(endian + 'H', buf, 0x36)[0]
e_phnum = struct.unpack_from(endian + 'H', buf, 0x38)[0]
phs=[]
for i in range(e_phnum):
off = e_phoff + i*e_phentsize
p_type, p_flags = struct.unpack_from(endian + 'II', buf, off)
p_offset, p_vaddr, p_paddr, p_filesz, p_memsz, p_align = struct.unpack_from(endian + 'QQQQQQ', buf, off+8)
phs.append({'p_type':p_type,'p_offset':p_offset,'p_vaddr':p_vaddr,'p_filesz':p_filesz,'p_memsz':p_memsz})
return phs
ph = parse_phdrs(data)
def vaddr_to_offset(vaddr):
for seg in ph:
if seg['p_type'] == 1 and seg['p_vaddr'] <= vaddr < seg['p_vaddr'] + seg['p_filesz']:
return seg['p_offset'] + (vaddr – seg['p_vaddr'])
if seg['p_type'] == 1 and seg['p_vaddr'] <= vaddr < seg['p_vaddr'] + seg['p_memsz']:
return seg['p_offset'] + (vaddr – seg['p_vaddr'])
return None
off = vaddr_to_offset(ENC_VADDR)
if off is None:
raise RuntimeError("enc_vaddr not mapped to file")
vals = [struct.unpack_from('<I', data, off + i*4)[0] for i in range(COUNT)]
print("enc dwords:", [hex(x) for x in vals])
enc_bytes = [x & 0xff for x in vals]
print("enc low-bytes:", enc_bytes)
Path("enc_bytes.txt").write_text(" ".join(hex(x) for x in enc_bytes), encoding='utf-8')
print("Saved enc low-bytes to enc_bytes.txt")
首先,什么是最低字节?因为很多CTF题里"加密表"或"密文"存放为 32-bit 单元,但真正的数据可能只用到了每个dword的最低8位,所以我们将最低字节导出,能直接得到我们常需要的字节流以便做频率分析、XOR 尝试、ASCII 解码等操作。
代码解释:我们首先选取 ENC_VADDR = 0x005d9140(之前脚本列出的第三候选)并读取了从该地址开始的32个 dword(共128字节);然后通过ELF program headers将虚拟地址映射为文件偏移后,脚本按little-endian逐个读取dword,并把每个 dword 的最低字节导出为 enc_bytes.txt。(很多程序将字节以 4 字节对齐存放(低字节为有效数据),因此取 low-byte 可以直接获得我们需要的字节流用于后续的 ASCII/XOR/查表分析。)然后我们把 enc_bytes.txt 作为下一步分析的输入(例如尝试 ASCII 解码、XOR、查找 S-box、或在 IDA 中搜索相同字节串以定位使用位置。
运行代码后结果如下:
"D:\\LJY\\python project\\1\\pythonProject\\.venv\\Scripts\\python.exe" "D:\\LJY\\python project\\1\\pythonProject\\chap2\\04.py"
enc dwords: ['0x4f', '0x1a', '0x59', '0x1f', '0x5b', '0x1d', '0x5d', '0x6f', '0x7b', '0x47', '0x7e', '0x44', '0x6a', '0x7', '0x59', '0x67', '0xe', '0x52', '0x8', '0x63', '0x5c', '0x1a', '0x52', '0x1f', '0x20', '0x7b', '0x21', '0x77', '0x70', '0x25', '0x74', '0x2b']
enc low-bytes: [79, 26, 89, 31, 91, 29, 93, 111, 123, 71, 126, 68, 106, 7, 89, 103, 14, 82, 8, 99, 92, 26, 82, 31, 32, 123, 33, 119, 112, 37, 116, 43]
Saved enc low-bytes to enc_bytes.txt
Process finished with exit code 0
暴力恢复:猜测"单字节自增密钥"并解出明文(Python脚本)
最后我尝试用一个单字节起始密钥k0,并对每个字节按序递增(k0+i)来解密 enc(已知的字节流)来求得flag,即对所有 k0(0..255)逐一尝试,筛选出“全部字符可打印”的候选明文,作为可能的 flag/明文输出。下面我将附上破解flag的脚本以及详细的解释:
from pathlib import Path
def read_enc_from_file():
txt = Path("enc_bytes.txt").read_text().strip()
parts = txt.split()
return [int(p,16) for p in parts]
enc = read_enc_from_file()
count = len(enc)
print("Loaded enc bytes:", enc)
def is_printable(s):
return all(32 <= ord(c) < 127 for c in s)
cands = []
for k0 in range(256):
s = ''.join(chr(((k0 + i) & 0xff) ^ enc[i]) for i in range(count))
if is_printable(s):
cands.append((k0, s))
print("candidates count:", len(cands))
for k,s in cands:
print(k, s)
首先我们读取之前生成的enc_bytes.txt并把每一个0x.. 字符串转为整数(0..255),然后我们加载enc并判断s是否全部由可打印ASCII字符组成
def is_printable(s):
return all(32 <= ord(c) < 127 for c in s)
——真实的flag一般是可打印的,所以如果是非打印字符通常说明该k0不正确。接着我们对所有可能的起始密钥k0进行遍历:
cands = []
for k0 in range(256):
s = ''.join(chr(((k0 + i) & 0xff) ^ enc[i]) for i in range(count))
if is_printable(s):
cands.append((k0, s))
print("candidates count:", len(cands))
for k,s in cands:
print(k, s)
——对每个位置i,计算解密字节:((k0+i)&0xff)^enc[i],然后把它转换为字符并拼接成字符串s;& 0xff 用来保证(k0+i)在0..255范围(模256表示)。如果字符串s全部可打印,则认为它是一个“可疑候选”,加入 cands 列表。最后我们打印候选数量与每个候选(密钥k0和对应解密结果)来求得可能的flag。
暴力破解的数学逻辑
我们已经从二进制文件中提取到了一串加密字节enc,是一个脚本中获取的低8位字节:enc = [e0, e1, e2, e3, …, en-1],所以题目设计者加密逻辑很可能是 简单的异或(XOR)+ 线性偏移,即:enc[i]=(key+i)^plain[i](plain[i]是原始明文字节(可能就是flag的ASCII值);key(我们在脚本里称k0)是一个单字节初始密钥;(key+i)代表密钥随字节索引递增(i 从0开始;^是XOR(异或运算),这是典型的“可逆、简单混淆”方法。)而又因为XOR可逆(a^b=c<=>c^b=a),所以如果加密是enc[i]=(key+i)^plain[i]那么解密公式就应该是plain[i]=enc[i]^(key+i)((key+i)必须模256),所以说,我们只要知道了key,就可以完全地恢复明文。
运行代码后结果如下:
"D:\\LJY\\python project\\1\\pythonProject\\.venv\\Scripts\\python.exe" "D:\\LJY\\python project\\1\\pythonProject\\chap2\\05.py"
Loaded enc bytes: [79, 26, 89, 31, 91, 29, 93, 111, 123, 71, 126, 68, 106, 7, 89, 103, 14, 82, 8, 99, 92, 26, 82, 31, 32, 123, 33, 119, 112, 37, 116, 43]
candidates count: 2
40 g3s4w0s@KvLw^2oP6k2X`'l `:c44`2l
41 f0r3v3r_JuMp_1n_7h3_a$m_a9b35c3c
Process finished with exit code 0
我们从该运行结果中得到两个候选,又因为我们之前找到了flag的格式(见solve函数的分析),所以我们可以将这两个结果均输入比赛平台进行尝试:moectf{g3s4w0s@KvLw^2oP6k2X`'l `:c44`2l}和moectf{f0r3v3r_JuMp_1n_7h3_a$m_a9b35c3c},最终发现第二个输入比赛平台验证成功,成功拿下flag。
最终flag
moectf{f0r3v3r_JuMp_1n_7h3_a$m_a9b35c3c},完结撒花!!!