/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
企业声誉难以直接观测,公开媒体的正向报道强度为其提供了可复现的代理。
数据覆盖 2001—2025 年,观测层级为公司—年度,两项声誉指标随四类正面报道计数一并给出,可直接用于媒体关注、企业声誉与外部信息环境等主题的面板研究。
一、指标界定
企业声誉的经典测度思路之一是媒体关注法:公司在财经报刊与网络新闻中获得的正面报道越多,其呈现给外部信息使用者的声誉水平越高。本数据集据此以正面报道数量的对数变换作为企业声誉的度量,并做了两项口径区分:
-
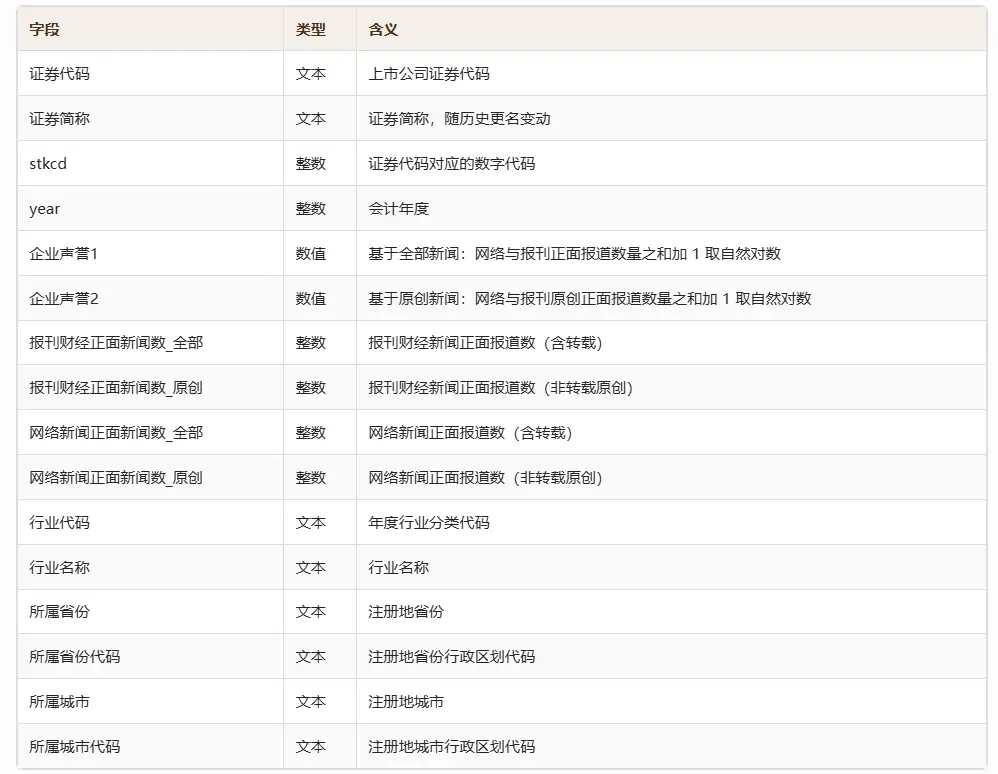
全部新闻口径(企业声誉1):将网络新闻与报刊财经新闻的正面报道数直接相加,其中包含同内容转载报道,反映媒体正面报道的总量强度。
-
原创新闻口径(企业声誉2):仅统计非转载的原创正面报道,避免同一内容被多次转载造成的重复计数,更贴近公司自身引发的关注。
两项指标均只使用正面报道:未纳入负面报道的净值,也未使用正面报道占全部报道的比例。换言之,指标刻画的是“正面曝光的绝对强度”,而非报道的净倾向。方法学与口径细节见文末参考文献及随附说明文档。
二、变量构造
两项声誉指标均由四类正面报道计数直接变换而来:
企业声誉1 = ln(报刊财经正面新闻数_全部 + 网络新闻正面新闻数_全部 + 1)
企业声誉2 = ln(报刊财经正面新闻数_原创 + 网络新闻正面新闻数_原创 + 1)
加 1 取自然对数的作用有二:一是将“零报道”映射为 0,使无报道公司得以保留在样本中;二是压缩报道量的长尾分布,使指标在横截面上更接近可比。
三、字段说明
四、样本示例(节选)
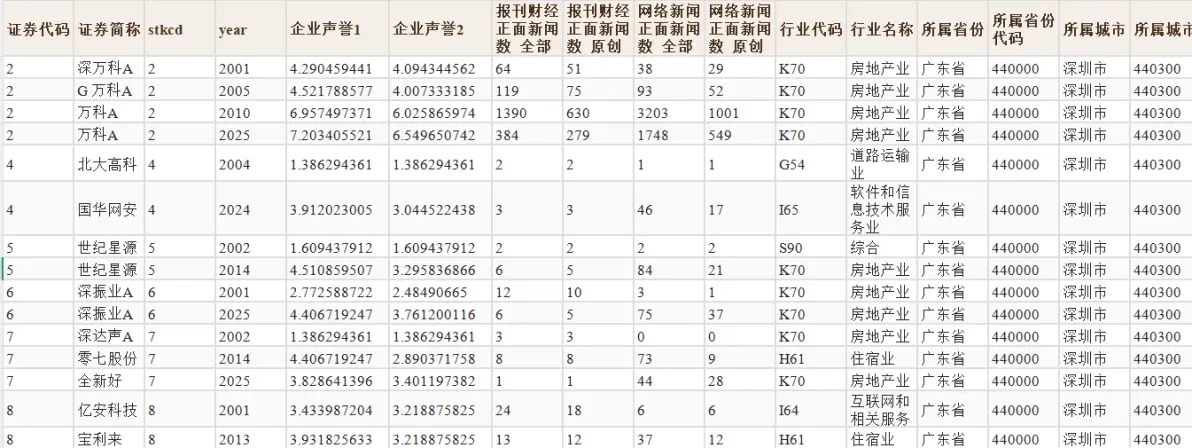
文件包括:原始数据+计算代码+计算结果
参考文献
郭文伟, 黄子聪, 何洁. 儒家文化与企业气候变化风险披露——基于文本分析和机器学习[J]. 经济学报, 2024, 11(02): 170-204.
顶部专栏分享更多内容
经管社科数据专栏合集
来源:Paper 数据分析