基于Qwen3-VL-WEBUI的多模态应用|支持图像、视频与长上下文推理
随着大模型在视觉-语言理解领域的持续演进,阿里云推出的 Qwen3-VL 系列标志着多模态能力的一次全面跃迁。其最新部署镜像 Qwen3-VL-WEBUI 内置了强大的 Qwen3-VL-4B-Instruct 模型,不仅支持高精度图像识别、跨模态语义生成,更在视频理解、长上下文建模和空间推理方面实现了突破性增强。
本文将深入解析 Qwen3-VL 的核心技术优势,并通过完整实践指南带你快速部署 WebUI 服务,掌握从环境配置到实际推理的全流程操作,同时提供关键问题排查建议,助你在本地或云端高效运行这一先进多模态系统。
核心特性:为何选择 Qwen3-VL?
🚀 全面升级的多模态能力矩阵
相比前代模型,Qwen3-VL 在多个维度实现显著提升:
| 视觉代理(Visual Agent) | 可识别并操作 PC/移动端 GUI 元素,调用工具完成任务自动化 |
| 高级空间感知 | 支持物体位置判断、视角分析、遮挡关系推理,为具身 AI 提供基础 |
| 长上下文支持 | 原生支持 256K 上下文,可扩展至 1M tokens,适用于书籍、报告、数小时视频处理 |
| 视频动态理解 | 支持秒级事件定位与时间戳对齐,精准捕捉视频中的行为序列 |
| OCR 扩展能力 | 支持 32 种语言,优化低光、模糊、倾斜场景下的文本提取 |
| STEM 推理增强 | 在数学、因果逻辑等复杂推理任务中表现优异 |
核心价值总结:Qwen3-VL 不再只是一个“看图说话”的模型,而是具备深度感知、长期记忆与主动交互能力的智能体雏形。
快速部署:一键启动 Qwen3-VL-WEBUI
A. 部署准备
硬件要求(推荐)
- GPU:NVIDIA RTX 4090D × 1(24GB 显存)
- 显存需求:FP16 推理约需 18–20GB
- 存储空间:模型权重 + 缓存 ≥ 30GB
软件依赖
# 安装 HuggingFace Transformers 主干版本(支持 Qwen3-VL)
pip install git+https://github.com/huggingface/transformers accelerate
# 或分步安装以避免冲突
git clone https://github.com/huggingface/transformers
cd transformers
pip install . accelerate
# 安装 Qwen 多模态专用工具包
pip install qwen-vl-utils torchvision
# 视频解析支持(必须)
pip install av
下载 WebUI 工程
git clone https://github.com/QwenLM/Qwen2-VL.git
cd Qwen2-VL
pip install -r requirements_web_demo.txt
⚠️ 注意:虽然项目名为 Qwen2-VL,但其代码已兼容 Qwen3-VL 模型加载,请确保使用最新的主分支代码。
B. 启动 WebUI 服务
方法一:启用 Flash Attention 2 加速(推荐)
python web_demo.py –flash-attn2 –server-port 7860 –inbrowser
- –flash-attn2:启用 Flash Attention 2,显著降低显存占用并提升推理速度
- –inbrowser:自动在默认浏览器打开界面
- –server-port:指定服务端口
方法二:CPU 推理模式(仅测试用)
python web_demo.py –cpu-only
💡 提示:若有多张 GPU,可通过设置 CUDA_VISIBLE_DEVICES=0 控制使用哪块显卡。
C. 运行效果展示
C.1 WebUI 界面预览
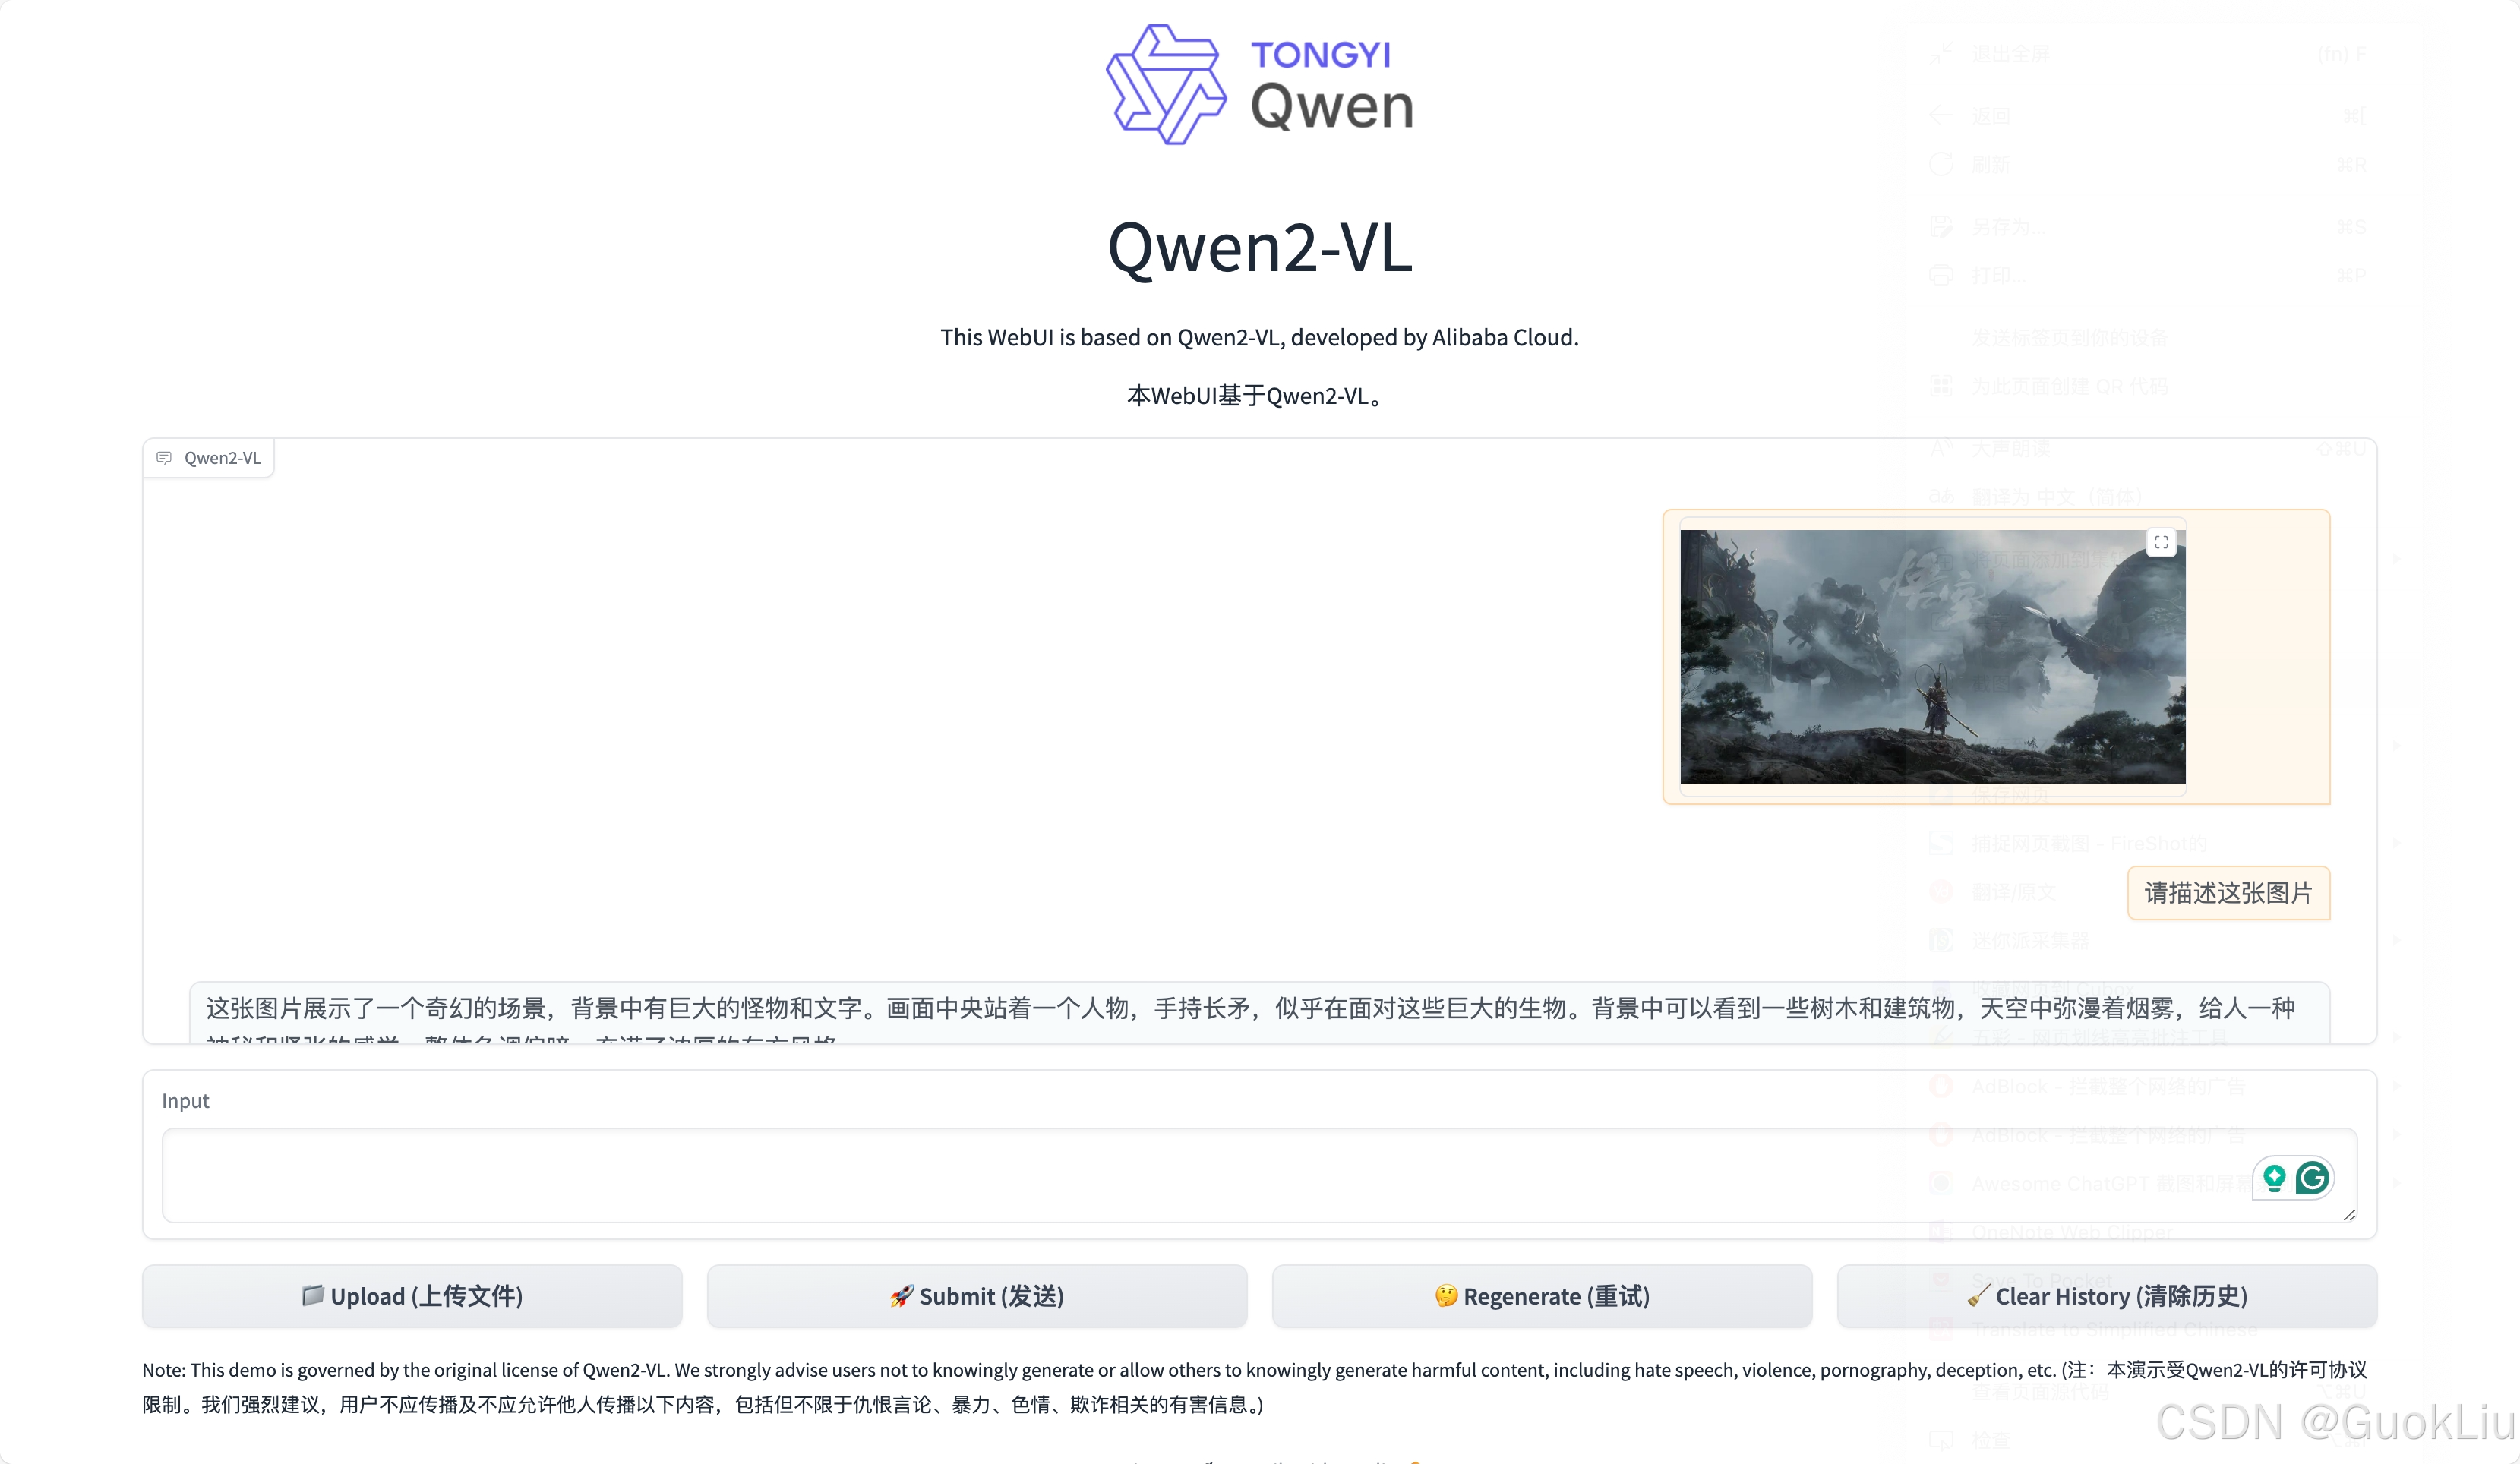
界面功能说明: – 支持拖拽上传图片/视频文件 – 实时流式输出响应内容 – 提供“重试”、“清空历史”等交互按钮 – 自动识别媒体类型并嵌入对话上下文
C.2 命令行版本调用示例
from transformers import Qwen2VLForConditionalGeneration, AutoProcessor
from qwen_vl_utils import process_vision_info
import torch
# 加载模型(支持 flash_attention_2)
model = Qwen2VLForConditionalGeneration.from_pretrained(
"/path/to/Qwen3-VL-4B-Instruct",
torch_dtype=torch.bfloat16,
attn_implementation="flash_attention_2",
device_map="balanced_low_0"
)
processor = AutoProcessor.from_pretrained("/path/to/Qwen3-VL-4B-Instruct")
# 构造多模态输入
messages = [
{
"role": "user",
"content": [
{"type": "image", "image": "file:///home/user/demo.jpg"},
{"type": "text", "text": "请详细描述这张图片的内容,并分析人物情绪。"}
]
}
]
# 预处理输入
text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
image_inputs, video_inputs = process_vision_info(messages)
inputs = processor(text=[text], images=image_inputs, videos=video_inputs, padding=True, return_tensors="pt").to("cuda")
# 生成输出
output_ids = model.generate(**inputs, max_new_tokens=512)
output_text = processor.batch_decode(output_ids, skip_special_tokens=True)[0]
print(output_text)
技术架构深度解析
1. 交错 MRoPE:突破长序列建模瓶颈
传统 RoPE(Rotary Position Embedding)在处理超长上下文时存在位置外推困难。Qwen3-VL 引入 Interleaved MRoPE(Mixed Resolution RoPE),在时间轴、高度和宽度三个维度上进行频率混合分配。
# 伪代码示意:MRoPE 的多维位置编码融合
def apply_mrope(pos_emb_t, pos_emb_h, pos_emb_w):
# 将时间、高、宽的位置编码交错拼接
interleaved = interleave([pos_emb_t, pos_emb_h, pos_emb_w])
return rotary_embedding(interleaved)
✅ 优势: – 支持长达数小时的视频帧序列建模 – 实现跨帧事件的因果关联推理 – 显著提升长文档问答准确率
2. DeepStack:多层次视觉特征融合
Qwen3-VL 采用 DeepStack 架构,融合 ViT 多层级特征图(patch embeddings + cls tokens),增强细粒度图像-文本对齐能力。
class DeepStackVLM(nn.Module):
def __init__(self, vit_model, lm_model):
super().__init__()
self.vit = vit_model
self.lm = lm_model
self.fusion_proj = nn.Linear(vit_hidden * 3, lm_hidden) # 融合 shallow/mid/deep 层特征
def forward(self, pixel_values):
# 获取 ViT 多层输出
hidden_states = self.vit(pixel_values, output_hidden_states=True).hidden_states
stack_features = torch.cat([
hidden_states[6], # mid-layer
hidden_states[12], # deep-layer
hidden_states[0] # shallow-layer (patch-level)
], dim=-1)
projected = self.fusion_proj(stack_features)
return self.lm(inputs_embeds=projected)
✅ 效果提升: – 更好地识别小物体与局部细节 – 提升图文匹配精度(如广告文案生成) – 改善复杂图表的理解能力
3. 文本-时间戳对齐机制
针对视频理解任务,Qwen3-VL 实现了超越 T-RoPE 的 精确时间戳基础建模(Timestamp Grounding),使模型能回答“第几分钟发生了什么?”这类问题。
{
"video": "file:///videos/soccer_match.mp4",
"query": "球员在什么时候进球?",
"response": "根据视频分析,进球发生在 00:23:15 时间点,一名身穿红色球衣的前锋接到角球传中后头球破门。"
}
该能力基于以下技术实现: – 视频按固定间隔抽帧(如每秒 1–3 帧) – 每帧附加时间元数据注入模型输入 – 训练阶段引入时间对比学习目标
实践技巧与性能优化
A. 显存优化策略
使用 Flash Attention 2 减少显存消耗
# 安装适配你 CUDA 和 PyTorch 版本的 flash-attn 包
pip install flash_attn-2.6.3+cu123torch2.4cxx11abiFALSE-cp310-cp310-linux_x86_64.whl –no-build-isolation
🔍 如何选择 cxx11abiTRUE/FALSE? – 若你的 GCC 编译器 ≥ 5.1 且 __GLIBCXX_USE_CXX11_ABI=1 → 选 True – 否则选择 False 保证兼容性
验证 ABI 设置方法:
// abi_check.cpp
#include <iostream>
int main() {
std::cout << "__GLIBCXX_USE_CXX11_ABI = " << __GLIBCXX_USE_CXX11_ABI << std::endl;
return 0;
}
编译运行后输出 1 表示启用 C++11 ABI。
B. 输入分辨率调节:平衡质量与成本
可通过 min_pixels 和 max_pixels 控制视觉 token 数量:
min_pixels = 256 * 28 * 28 # ≈ 200K pixels
max_pixels = 1280 * 28 * 28 # ≈ 1M pixels
processor = AutoProcessor.from_pretrained(
"Qwen/Qwen3-VL-4B-Instruct",
min_pixels=min_pixels,
max_pixels=max_pixels
)
| 256–1280 px | ~500 tokens | ~18GB | 1.2s/token |
| 默认全分辨率 | ~1600 tokens | ~22GB | 2.1s/token |
✅ 建议:对于大多数通用任务,适当降低最大像素可节省 30% 显存,性能损失小于 5%。
C. 多 GPU 负载均衡部署
当拥有 ≥2 张 GPU 时,推荐使用 device_map="balanced_low_0":
model = Qwen2VLForConditionalGeneration.from_pretrained(
"Qwen/Qwen3-VL-4B-Instruct",
device_map="balanced_low_0", # 自动分配到多卡,优先使用 GPU 0
torch_dtype=torch.bfloat16
)
❗ 注意事项: – 必须在导入 torch 前设置 CUDA_VISIBLE_DEVICES – 示例:os.environ['CUDA_VISIBLE_DEVICES'] = '0,1'
否则可能出现设备不一致错误:
ValueError: Input and model must be on the same device.
常见问题与解决方案
Q1:如何解决 Flash Attention 2 安装失败?
常见报错:
ValueError: Flash Attention 2.0 only supports torch.float16 and torch.bfloat16 dtypes.
✅ 解决方案: 1. 确保模型加载时指定半精度: python model = Qwen2VLForConditionalGeneration.from_pretrained( …, torch_dtype=torch.bfloat16, attn_implementation="flash_attention_2" ) 2. 卸载旧版 flash-attn: bash pip uninstall flash-attn 3. 下载预编译 WHL 文件(GitHub Release)并离线安装: bash pip install flash_attn-2.6.3+cu123torch2.4cxx11abiFALSE-cp310-cp310-linux_x86_64.whl –no-build-isolation
Q2:视频无法加载或解析失败?
原因分析: – 缺少 av 库支持 – 视频格式不受 FFmpeg 支持 – 路径包含中文或特殊字符
✅ 解决方案:
# 安装 PyAV(底层依赖 LibAV/FFmpeg)
pip install av
# 测试视频是否可读
import av
container = av.open("test.mp4")
for frame in container.decode(video=0):
print(frame.index)
建议转换为标准 MP4(H.264 编码)后再上传。
Q3:长上下文推理出现遗忘现象?
尽管支持 256K 上下文,但在极端长度下仍可能出现信息衰减。
✅ 缓解策略: – 使用 滑动窗口摘要法:将长文本分段处理,逐段生成摘要 – 启用 检索增强生成(RAG):结合向量数据库实现外部记忆 – 在 prompt 中加入关键词提示:“请特别注意开头部分提到的 XXX”
总结与展望
✅ 核心收获总结
| 技术能力 | 支持图像、视频、长文本的统一理解与生成 |
| 工程实践 | 提供开箱即用的 WebUI 与命令行双接口 |
| 性能优化 | Flash Attention 2 + DeepStack 显著提升效率 |
| 应用场景 | 适用于内容审核、教育辅导、智能客服、自动化测试等 |
🚀 下一步建议
参考资料
- QwenLM/Qwen2-VL GitHub 仓库
- Flash Attention 官方发布页
- Transformers 文档 – from_pretrained
- Swift 微调 Qwen2-VL 最佳实践
- ValueError: Flash Attention 2 dtype issue #28052