作者导读:本文基于2024-2025年最新技术栈,完整记录如何从0到1构建可落地的AI Agent系统。全文15000+字,包含完整代码、架构图和踩坑记录。适合有Python基础,希望掌握Agent工程化的开发者。
一、为什么现在必须掌握AI Agent开发?
1.1 从Chatbot到Agent的范式转移
2023年的大模型应用主要集中在单轮对话(ChatGPT式),2024年转向RAG增强检索,而2025年的核心战场是Agent自主决策。
|
阶段 |
特征 |
技术栈 |
局限性 |
|
Prompt工程 |
静态指令 |
GPT-3.5/4 |
无状态、无行动能力 |
|
RAG应用 |
知识增强 |
Vector DB + LLM |
只能检索,无法执行 |
|
Agent系统 |
自主决策+工具调用 |
LangChain/LangGraph |
复杂度高,需精心设计 |
关键认知:Agent不是”更聪明的Chatbot”,而是具备感知-决策-执行循环的自主系统。
1.2 企业级Agent的核心能力矩阵
一个生产可用的Agent必须满足:
✅ 工具调用(Tool Use):能调用API、查询数据库、执行代码 ✅ 记忆管理(Memory):短期上下文 + 长期知识库 ✅ 规划能力(Planning):任务分解、多步推理 ✅ 反思机制(Reflection):自我纠错、结果验证 ✅ 多Agent协作(Multi-Agent):角色分工、工作流编排
- 技术架构设计:三层架构模型
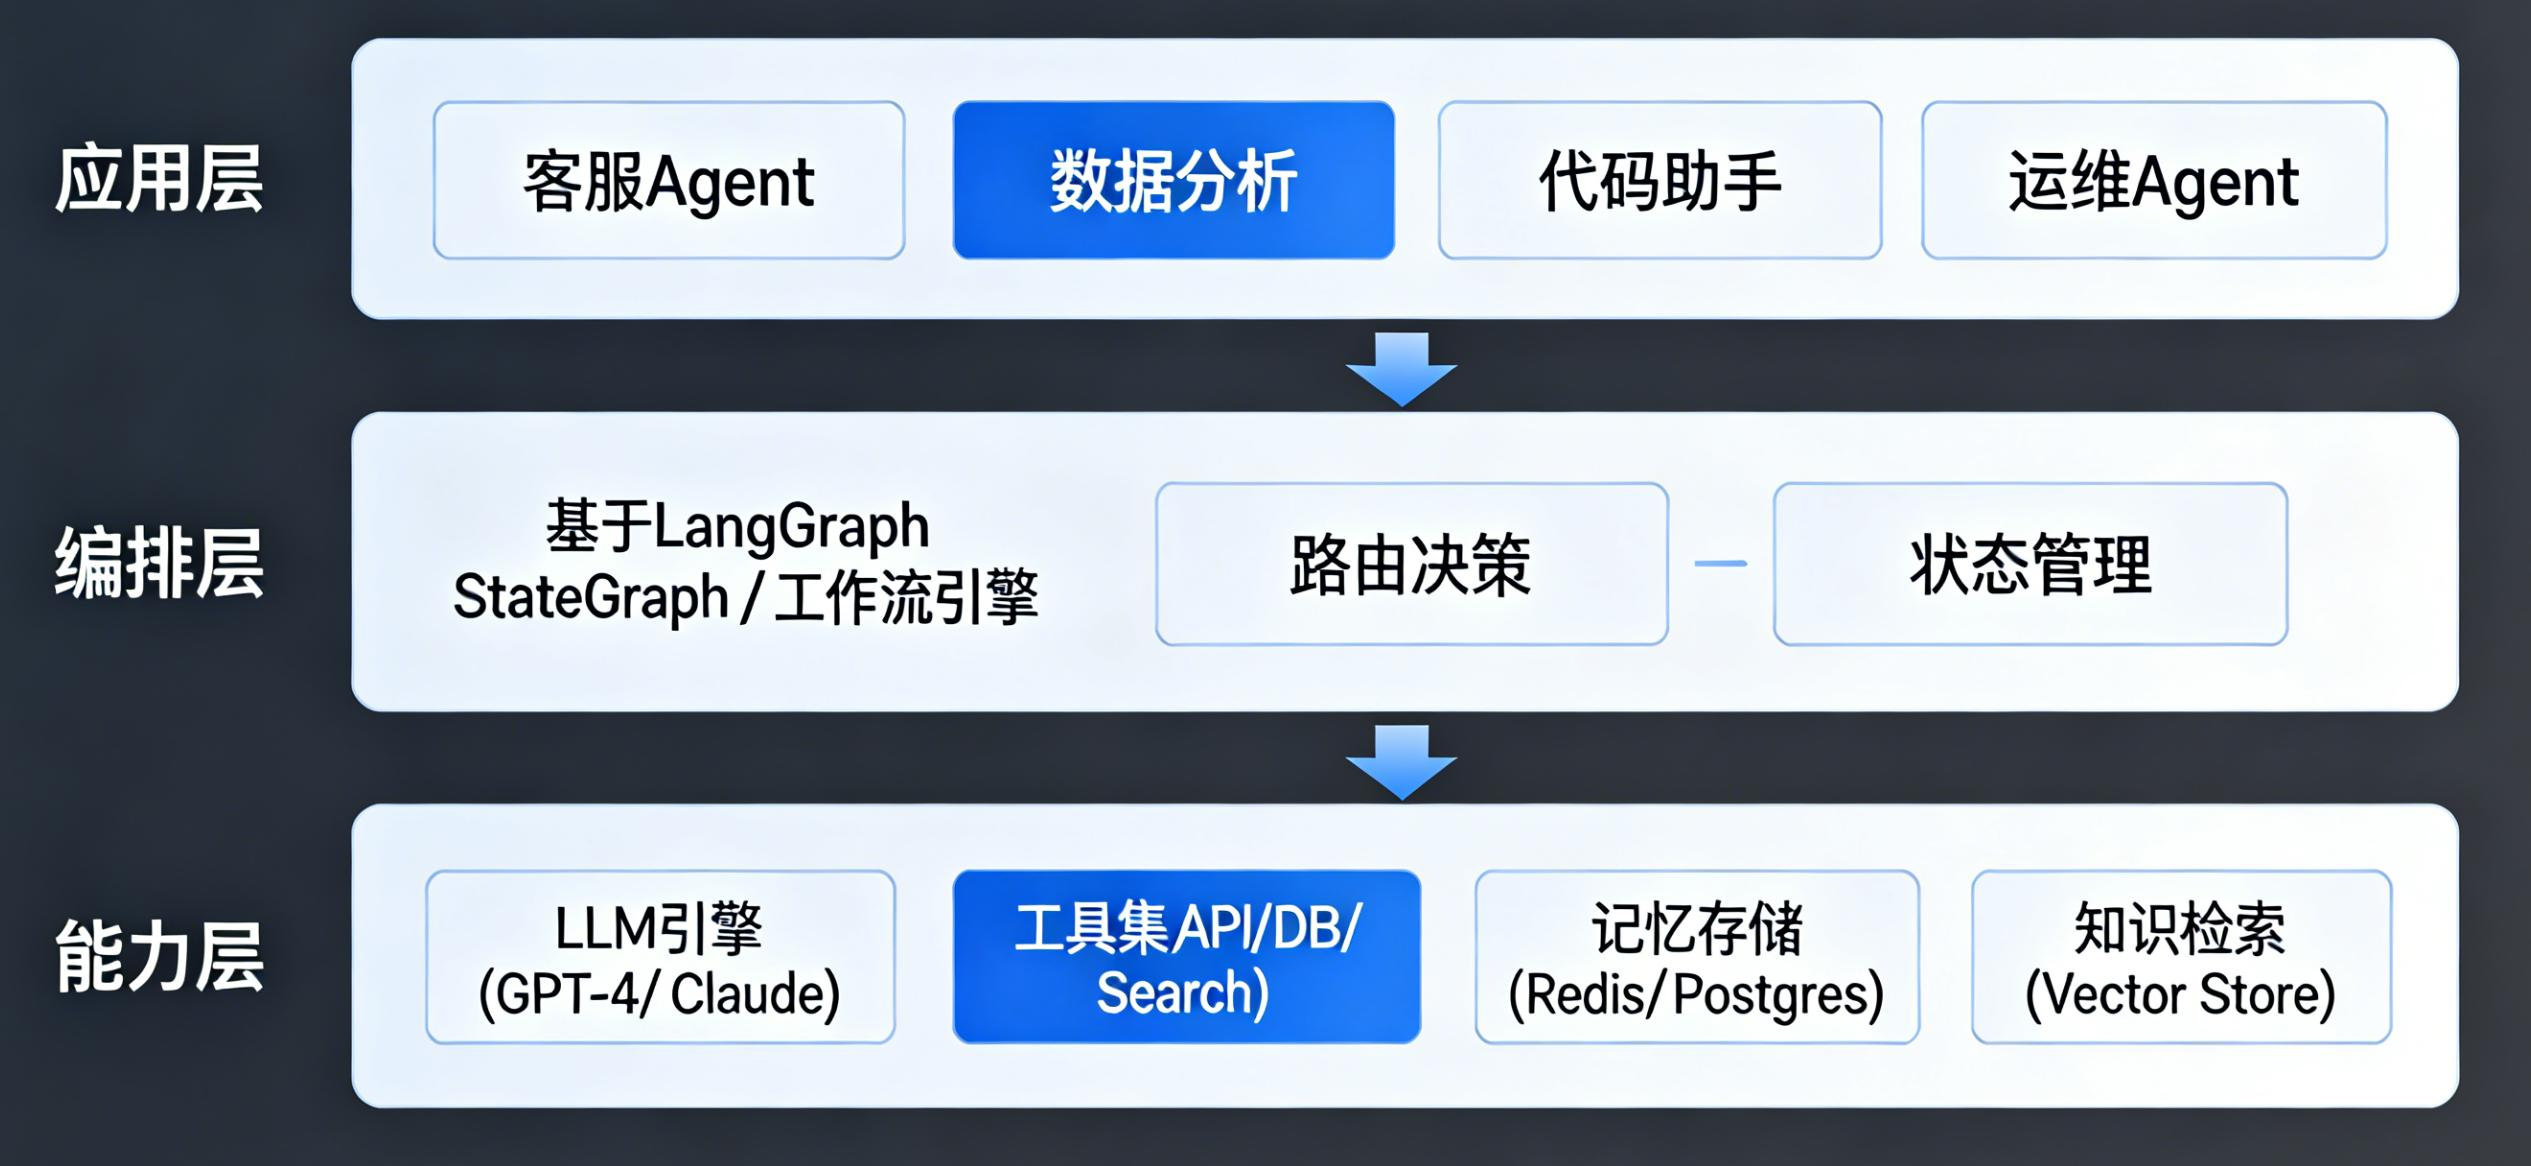
2.2 技术选型对比
|
组件 |
方案A(推荐) |
方案B |
选择理由 |
|
Agent框架 |
LangGraph |
AutoGen |
状态管理更灵活,适合复杂工作流 |
|
LLM |
Claude 3.5 Sonnet |
GPT-4o |
代码能力更强,性价比更高 |
|
向量库 |
Chroma/Milvus |
Pinecone |
本地化部署,数据安全 |
|
记忆存储 |
Redis + PostgreSQL |
纯内存 |
持久化 + 高性能 |
|
部署 |
Docker + FastAPI |
Serverless |
企业级可扩展 |
三、核心模块实战:构建ReAct Agent
3.1 基础环境搭建
# requirements.txt
langchain==0.3.0
langgraph==0.2.0
langchain-openai==0.2.0
langchain-community==0.3.0
redis==5.0.0
sqlalchemy==2.0.0
chromadb==0.5.0
fastapi==0.115.0
uvicorn==0.32.0
pydantic==2.9.0
python-dotenv==1.0.0
3.2 工具定义与装饰器模式
核心原则:工具是Agent的”手脚”,必须定义清晰的Schema。
# tools/base_tool.py
from typing import Type, Callable, Any
from pydantic import BaseModel, Field
from langchain.tools import BaseTool
from functools import wraps
class ToolRegistry:
\”\”\”工具注册中心 – 支持动态加载\”\”\”
_tools = {}
@classmethod
def register(cls, name: str, description: str, args_schema: Type[BaseModel]):
def decorator(func: Callable) -> Callable:
@wraps(func)
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
# 创建LangChain兼容的工具类
class DynamicTool(BaseTool):
name: str = name
description: str = description
args_schema: Type[BaseModel] = args_schema
def _run(self, **kwargs) -> Any:
return func(**kwargs)
async def _arun(self, **kwargs) -> Any:
return await func(**kwargs) if asyncio.iscoroutinefunction(func) else func(**kwargs)
cls._tools[name] = DynamicTool()
wrapper.tool_instance = cls._tools[name]
return wrapper
return decorator
@classmethod
def get_tools(cls):
return list(cls._tools.values())
# 使用示例
class SearchInput(BaseModel):
query: str = Field(description=\”搜索关键词\”)
limit: int = Field(default=5, description=\”返回结果数量\”)
@ToolRegistry.register(
name=\”web_search\”,
description=\”使用搜索引擎获取实时信息,适用于查询最新新闻、技术文档等\”,
args_schema=SearchInput
)
def web_search(query: str, limit: int = 5) -> str:
return f\”搜索结果:关于\'{query}\’的{limit}条结果…\”
class DatabaseQueryInput(BaseModel):
sql: str = Field(description=\”SQL查询语句,仅支持SELECT\”)
table_hint: str = Field(default=\”\”, description=\”表名提示\”)
@ToolRegistry.register(
name=\”db_query\”,
description=\”执行SQL查询数据库,用于获取业务数据。仅支持SELECT操作\”,
args_schema=DatabaseQueryInput
)
def db_query(sql: str, table_hint: str = \”\”) -> str:
return f\”执行SQL: {sql},返回数据…\”
3.3 记忆系统:短期+长期双轨设计
# memory/hybrid_memory.py
from typing import List, Dict, Any, Optional
from datetime import datetime, timedelta
import redis
import json
from langchain.memory import ConversationBufferMemory
from langchain.schema import BaseMessage, HumanMessage, AIMessage
class HybridMemory:
\”\”\”
混合记忆系统:
– 短期记忆:Redis存储,会话级,TTL 24小时
– 长期记忆:向量数据库,用户级,永久存储
– 实体记忆:关键信息提取,结构化存储
\”\”\”
def __init__(self,
redis_host: str = \”localhost\”,
vector_store=None,
session_id: str = None,
user_id: str = None):
self.redis_client = redis.Redis(host=redis_host, decode_responses=True)
self.vector_store = vector_store
self.session_id = session_id or self._generate_session_id()
self.user_id = user_id
# 短期记忆窗口
self.short_term_window = 10 # 保留最近10轮
def _generate_session_id(self) -> str:
return f\”sess_{datetime.now().strftime(\’%Y%m%d%H%M%S\’)}_{uuid.uuid4().hex[:8]}\”
def save_context(self, human_msg: str, ai_msg: str, metadata: Dict = None):
\”\”\”保存对话上下文\”\”\”
timestamp = datetime.now().isoformat()
# 1. 存入