聊天客户端 ChatClient
chatClient 是 SpringAI 框架中用于与 AI 模型进行对话交互的主入口,其封装了以下的逻辑:
- 提示词(Prompt)构建与模板化
- 多轮对话上下文管理(CahtMemory)
- 请求/响应的序列化与反序列化
- 同步/流式调用支持
- 模型无关的统一接口
- Advisors 扩展机制
ChatClient 核心 API
链式构建+函数式调用
构建阶段(Builder 配置)
定义 ChatClient 的全局默认行为(一次配置,多次复用);实际编写代码可放在一个配置类中使用
.defaultSystem(String systemMessage)
设置所有对话默认的系统提示词
注意:可被实际调用中的.system()覆盖
.defaultAdvisors(Advisor…advisors)
注册全局默认的 Advisor(记忆、日志、函数调用等),所有通过该 ChatClient 发起请求都会应用这些 Advisor
示例:
.defaultAdvisors(
new SimpleLoggerAdvisor(),
new MessageChatMemoryAdvisor(chatMemory)
)
.defaultTools(Tool …tools)
注册全局默认工具(Function Calling)
.defaultFunctions(List<String> functionNames)
显示指定默认启用哪些函数,适用于已有注册工具但只想开放部分
.defaultOptions(ChatOptions options)
用于设置底层模型通用参数
示例:
.defaultOptions(OpenAiChatOptions.builder()
.withTemperature(0.7)
.withMaxTokens(1000)
.build())
参数说明:
1.temperature(温度)——控制生成文本的随机性/创造性 0.0-2.0
说明
低值:模型更保守、更确定、可预测,适合事实问答,代码生成等场景
高值:模型更随机、多样、有创意,适合创作、头脑风暴等场景
2.maxTokens(最大生成长度)——限制模型单次回复最多生成多少个 token
说明
输出部分的最大长度
调用阶段(Prompt 链)
定义单次对话的具体内容和参数(每次请求动态设置);实际编写代码可放在对应控制器中使用
prompt()
说明:启动一次对话构建流程。所有消息(system/user/assistant)和参数在此设置
.system(String content)
设置系统消息(角色设定,行为约束)
注意:可多次调用,按顺序加入消息列表
.user(String content)
设置用户消息(即当前轮次的用户输入)
注意:必须调用!!!只调用一次
.advisors(Consumer<AdvisorSpec>)
注入运行时参数或行为增强
关键用途:通过 param(…)传入 converstaionId,实现多对话隔离
.advisors(a -> a.param(AbstractChatMemoryAdvisor.CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
.call()
执行同步非流式调用,返回 ChatResponse
.stream()
执行响应式流式调用,返回 Flux<ChatResponse>
区分流式与非流式:非流式就是一次性给出所有消息,流式就是一个字一个字的生成给出
.content()
从 ChatResponse 中快捷提取纯文本回复内容
等价于 response.getResult().getOutput().getContent()
.functions(List<Tool> tools)
为本次调用临时指定可用工具
注意:会覆盖默认的工具defaultTools()
实现最简单的 AI 文本对话(忽略依赖导入)
1.配置类
@Configuration
public class SpringAiConfig {
@Bean
public ChatMemory chatMemory() {
return new InMemoryChatMemory();
}
@Bean
public ChatClient chatClient(OpenAiChatModel chatModel, ChatMemory chatMemory) {
return ChatClient.builder(chatModel)
.defaultAdvisors(new MessageChatMemoryAdvisor(chatMemory))
.build();
}
}
2.控制器
@RestController
@RequestMapping("/ai")
public class ChatController {
private final ChatClient chatClient;
public ChatController(ChatClient chatClient) {
this.chatClient = chatClient;
}
@GetMapping("/chat")
public String chat(@RequestParam String prompt, @RequestParam String chatId) {
return chatClient.prompt()
.user(prompt)
.advisors(a -> a.param(AbstractChatMemoryAdvisor.CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
.call()
.content();
}
}
聊天记忆
What is Chat Memory?
聊天记忆是一种机制,用于存储和管理用户与 AI 助手之间对话历史,能让 AI 记住之前的对话内容,在后续的聊天交互中保持上下文的连贯性
Why need Chat Memory?
为了保持上下文的连续性,避免用户每次重新输入一些重复信息,提高用户的体验,解决复杂任务需要多轮交互对话完成的问题。
SpringAI 的 ChatMemory 封装
ChatMemory 接口
定义了聊天记忆的基本操作规范,包括添加,获取,删除消息的方法
// 添加消息
chatMemory.add("session123", userMessage);
chatMemory.add("session123", aiResponse);
// 获取最近的N条消息作为上下文
List<Message> recentMessages = chatMemory.get("session123", 10);
// 清除特定会话
chatMemory.remove("session123");
InMemoryChatMemory 实现类——基于内存的聊天记忆实现
JdbcChatMemoryRepository 实现类——基于关系型数据库的聊天记忆实现
消息顾问—— MessageChatMemoryAdvisor
在请求前后自动处理消息的存储与检索
public class MessageChatMemoryAdvisor extends AbstractChatMemoryAdvisor {
@Override
public ChatModelRequestInterceptor.Result intercept(ChatModelRequest request,
Map<String, Object> attributes) {
// 1. 在请求发送前执行
String conversationId = getConversationId(attributes);
// 2. 从记忆中获取历史消息
List<Message> historyMessages = chatMemory.get(conversationId, maxMessages);
// 3. 将历史消息插入到请求的前面
List<Message> allMessages = new ArrayList<>();
allMessages.addAll(historyMessages); // 先添加历史消息
allMessages.addAll(request.getMessages()); // 再添加当前消息
return ChatModelRequestInterceptor.Result.just(
ChatModelRequest.builder()
.messages(allMessages)
.options(request.getOptions())
.build()
);
}
@Override
public ChatModelResponseInterceptor.Result intercept(ChatModelResponse response,
Map<String, Object> attributes) {
// 4. 请求完成后执行:保存用户消息和AI响应到记忆中
String conversationId = getConversationId(attributes);
// 保存用户的问题
List<Message> originalMessages = (List<Message>) attributes.get("originalMessages");
for (Message msg : originalMessages) {
chatMemory.add(conversationId, msg);
}
// 保存AI的回答
String aiResponse = response.getResult().getOutput().getContent();
chatMemory.add(conversationId, new AssistantMessage(aiResponse));
return ChatModelResponseInterceptor.Result.just(response);
}
}
SpringAI 聊天记忆实现原理
实现机制
1.会话标识:使用conversationId区分不同的对话会话
2.消息存储:将用户消息和AI响应按顺序存储
3.上下文注入:在每次请求时,将历史消息作为上下文传递给AI模型
4.自动管理:通过advisor自动处理消息的存取
完整对话流程示例
第一次对话 (chatId = "user123"):
User: "你好"
System: 添加历史 -> [User: "你好"]
AI: "您好!我是小膳"
System: 保存响应 -> [User: "你好", Assistant: "您好!我是小膳"]
第二次对话 (chatId = "user123"):
User: "我想减肥"
System:
1. 从记忆获取历史: [User: "你好", Assistant: "您好!我是小膳"]
2. 构造完整请求: [User: "你好", Assistant: "您好!我是小膳", User: "我想减肥"]
3. 发送给AI
AI: "好的,根据您的情况…"
System: 保存到记忆 -> [User: "你好", Assistant: "您好!我是小膳", User: "我想减肥", Assistant: "好的,根据您的情况…"]
最小化实现示例
1.配置类
@Configuration
public class AiConfig {
@Bean
public ChatMemory chatMemory() {
return new InMemoryChatMemory(); // 支持多 conversationId
}
@Bean
public ChatClient chatClient(ChatModel chatModel, ChatMemory chatMemory) {
return ChatClient.builder(chatModel)
.defaultAdvisors(new MessageChatMemoryAdvisor(chatMemory))
.build();
}
}
2.控制器
@RestController
public class SimpleChatController {
private final ChatClient chatClient;
public SimpleChatChatController(ChatClient chatClient) {
this.chatClient = chatClient;
}
// 示例:GET /chat?prompt=你好&chatId=user123
@GetMapping("/chat")
public String chat(@RequestParam String prompt, @RequestParam String chatId) {
return chatClient.prompt()
.user(prompt)
.advisors(a -> a.param(AbstractChatMemoryAdvisor.CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
.call()
.content();
}
// 查看历史
@GetMapping("/history/{chatId}")
public List<Message> history(@PathVariable String chatId, ChatMemory chatMemory) {
return chatMemory.get(chatId, 100); // 最多100条
}
}
提示词
四大角色
系统角色
解释:系统的全局设定(比如是一个资深营养师、一位专业教师、一位创作诗人)
作用:设定模型全局行为、身份、规则或上下文
特点:对用户不可见(通常),但是强烈影响模型输出
用户角色
解释:就是用户,真人输入
作用:代表人类用户的输入或请求
特点:触发模型响应的起点
助理角色
解释:就是 AI 的回答,回复
作用:代表模型自身的回复
特点:是模型生成的内容;在多轮对话中会被记录,用于上下文记忆
工具/功能角色
解释:就是使用工具调用返回结果
作用:表示外部工具的返回结果
如何写好一份提示词——核心要素
1.明确目标
清楚模型需要完成什么任务
2.提供上下文(外部背景)
给出必要的背景信息,帮助模型理解任务场景。
3.具体指令
使用直接、明确的语言告诉模型做什么和怎么做
4.格式要求
指定输出格式
5.约束条件
包括字数限制、语气风格、避免的内容、语言种类、技术深度等等
6.示例
提供几个输入-输出示例,帮助模型理解期望输出的样式
通用模版结构
【角色设定】你是一位[角色,如资深科技编辑/Python开发者/高中物理老师]。
【任务目标】请[具体任务,如撰写一篇关于AI伦理的短文]。
【目标受众】面向[读者群体,如普通公众/高中生/企业高管]。
【内容要求】涵盖以下要点: – 要点1 – 要点2 – …
【格式要求】以[格式,如三段式结构/项目符号列表/JSON格式]输出。
【风格与语气】使用[语气,如专业但易懂/轻松幽默/严谨学术]的语气。
【其他约束】字数控制在[数字]字以内;避免使用专业术语;使用中文简体。
结构化输出
在没有结构化输出时,用户在与大模型交互时,对其说“我今天吃了牛肉炒饭,特别香,就是有点咸”,大模型回复内容可能会是“看起来你挺喜欢这碗牛肉炒饭,下次可以少放点盐”这种自由文本固然挺自然的,但是程序是很难直接提取关键的信息,当使用结构化输出时,就相当于告诉大模型:“请用固定格式告诉我:吃的什么、好吃吗、咸不咸?”于是大模型就会严格按照这个格式返回,比如:
{
"food":"牛肉炒饭",
"taste":"好吃",
"tooSalty":true
}
在经历结构化输出之后,应用就能很方便的将“牛肉炒饭”数据记入饮食记录,由“tooSalty:true”触发提醒“今日钠摄入可能偏高”,而省去了分析一大段文字。
即:让 AI 的回答变成“机器能直接用的数据”,而不是“人读起来舒服的话”。
概念
结构化输出是指通过大语言模型生成符合预定义数据格式(如 Java 对象,JSON Schema 等)的响应,而非自由文本。目标是确保 LLM 的输出可被程序直接解析和使用,提升系统集成的可靠性与类型安全性,Spring AI 通过将用户定义的 Java 类(POJO)自动转换为提示词中的 JSON Schema,并结合模型支持的结构化输出能力(如 OpenAI 的 response_format 参数),引导模型返回严格遵循该结构的数据。
案例
场景:用户输入一段商品描述,要求模型从中提取商品名称、价格和是否支持退货。
1.定义目标结构
public class ProductInfo {
private String name;
private double price;
private boolean returnable;
// 标准 getter/setter(或使用 record)
}
2.创建转换器
BeanOutputConverter<ProductInfo> converter = new BeanOutputConverter<>(ProductInfo.class);
3.构造带格式指令的提示词
String userDescription = "这款无线蓝牙耳机售价299元,支持7天无理由退货,音质出色。";
String template = """
请从以下商品描述中提取结构化信息:
{description}
{format}
""";
Prompt prompt = PromptTemplate.builder()
.template(template)
.variables(Map.of(
"description", userDescription,
"format", converter.getFormat() // ← 关键:注入格式指令
))
.build()
.create();
4.发送请求并转换结果
Generation generation = chatModel.call(prompt).getResult();
ProductInfo product = converter.convert(generation.getOutput().getContent());
工具调用
概念
工具调用(也称为函数调用)是 AI 应用程序中的一种常见模式,允许模型与一组 API 或工具交互,从而增强其功能。
作用:
1. 检索信息:这些信息可以来自于数据库,Web 服务,文件系统或搜索引擎。
2.执行一些业务:比如在数据库中实现增删改查,提交表单等。
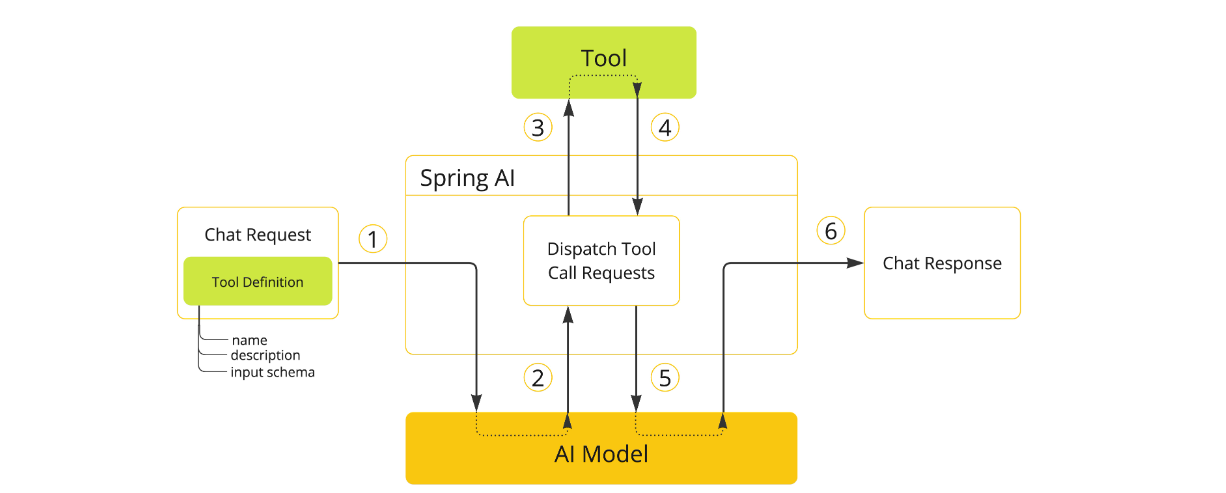
如何实现工具调用?
1. 创建工具
1. 采用声明式的方式
@Tools注解
name:工具名称。唯一,工具的标识,未提供默认用方法名
description:工具的描述。如何使用工具
…其余看文档扩展学习
@ToolParam注解
description:参数的描述,参数用什么格式,允许哪些值等等
required:参数是否必须
public class SportsTools{
@Tools(description="描述工具(方法)的作用")
public string getSportsInfoById(
@ToolsParam(description="查询条件",required=true) String SportId){
}
}
2.将工具添加到 ChatClient
ChatClient.create(chatModel)
.prompt()
.tools(new SportsTools())//运行时工具
.call()
.content();
//defaultTools(new SportsTools())默认工具
//同时提供运行时工具将覆盖默认工具
实际案例(课程客服)
1. 前置准备:配置好 pom 依赖与 application 配置,实现数据库,实现实体层与 mapper 层和业务 service 层。
pom文件
<!– openai依赖 –>
<dependency>
<groupId>org.springframework.ai</groupId>
<artifactId>spring-ai-openai-spring-boot-starter</artifactId>
</dependency>
application.yaml配置文件配置内容
spring:
application:
name: AiBase
ai:
openai:
api-key: ${OPENAI_API_KEY}
base-url: https://dashscope.aliyuncs.com/compatible-mode
chat:
options:
model: qwen-max-latest
2.可以编写一个查询条件类,定义一些工具调用的方法参数条件
@Data
public class CourseQuery {
@ToolParam(required = false, description = "课程类型:编程、设计、自媒体、其它")
private String type;
@ToolParam(required = false, description = "学历要求:0-无、1-初中、2-高中、3-大专、4-本科及本科以上")
private Integer edu;
@ToolParam(required = false, description = "排序方式")
private List<Sort> sorts;
@Data
public static class Sort {
@ToolParam(required = false, description = "排序字段:price或duration")
private String field;
@ToolParam(required = false, description = "是否是升序:true/false")
private Boolean asc;
}
}
3.定义一个工具 CourseTools 类,具体创建工具调用
@RequiredArgsConstructor
@Component
public class CourseTools {
private final ICourseService courseService;
private final ISchoolService schoolService;
private final ICourseReservationService reservationService;
@Tool(description = "根据条件查询课程")
public List<Course> queryCourse(@ToolParam(description = "查询的条件",required = false)CourseQuery query){
if(query==null){
//return List.of(); //用户没输入条件返回为空
return courseService.list(); //没条件返回全部的课程列表
}
QueryChainWrapper<Course> wrapper=courseService.query()
.eq(query.getType()!=null,"type",query.getType()) //type="编程"
.le(query.getEdu()!=null,"edu",query.getEdu()); //edu<=2
if (query.getSorts()!=null&&!query.getSorts().isEmpty()){
for (CourseQuery.Sort sort:query.getSorts()){
wrapper.orderBy(true,sort.getAsc(),sort.getField());
}
}
return wrapper.list();
}
@Tool(description = "查询所有校区")
public List<School> querySchool(){
return schoolService.list();
}
@Tool(description = "生成预约单,返回预约单号")
public Integer createCourseReservation(
@ToolParam(description = "预约课程") String course,
@ToolParam(description = "预约校区") String school,
@ToolParam(description = "学生姓名") String studentName,
@ToolParam(description = "联系电话") String contactInfo,
@ToolParam(description = "备注",required = false) String remark){
CourseReservation reservation = new CourseReservation();
reservation.setCourse(course);
reservation.setSchool(school);
reservation.setStudentName(studentName);
reservation.setContactInfo(contactInfo);
reservation.setRemark(remark);
reservationService.save(reservation);
return reservation.getId();
}
}
4.在模型中使用 defaultTools()
@Bean
public ChatClient serviceChatClient(OpenAiChatModel model, ChatMemory chatMemory, CourseTools courseTools){
return ChatClient
.builder(model)
.defaultSystem(SystemConstants.AIKEFU_PROMPT) //设置提示词
.defaultAdvisors(
new SimpleLoggerAdvisor(),
new MessageChatMemoryAdvisor(chatMemory)
)
.defaultTools(courseTools) //设置Tools
.build();
}
RAG 与向量数据库
基本概念
检索增强生成(Retrieval Augmented Generation)
解释:给 AI 配上专业领域的资料,让 AI 先根据资料进行回答
向量数据库
向量数据库执行的是相似性查找,给出给定向量进行查找时,返回与查询向量相似的向量。
PGvector
PGvector 是 PostgreSQL 的一个开源扩展,支持通过机器学习生成的嵌入进行存储和搜索。它提供多种功能,允许用户识别精确和近似的最近邻。它设计为与其他 PostgreSQL 功能无缝协作,包括索引和查询。
Embedding Models(嵌入模型)
解释:将文字转为一串有意义的数字(向量),在整个 RAG 流程中充当“翻译官”的角色。
嵌入是什么?
在自然语言处理(NLP)中,Embedding 是指将离散的符号(如单词、句子、文档)映射到连续的低维向量空间中的表示方法。
SpringAI 的 RAG 核心封装
统一的向量存储抽象接口 VectorStore
由于向量数据库有很多种,统一这抽象接口,方便应用程序独立于不同的具体的向量数据库
public interface VectorStore {
//添加文档到向量存储
List<String> add(List<Document> documents);
//相似度搜索
List<Document> similaritySearch(String query, int k, SimilaritySearchQueryRequest request);
//删除文档
void remove(List<String> ids);
}
vectorStore.add(batch);//文本转向量并添加到向量数据库
向量存储的基本单位———— Document
springAI 将 content 内容转换为向量,通过元数据来追踪文档来源与上下文
public class Document {
private String id;//文档唯一标识
private String content;//文档内容
private Map<String, Object> metadata;//元数据
}
documents.add(new Document(
id, //文档ID
chunk.trim(), //文本内容(实际被向量化的内容)
Map.of("page", pageNum, "source", sourceName) //元数据
));
向量检索核心请求对象—— SearchRequest
使用 Builder 模式构建
SearchRequest searchRequest = SearchRequest.builder()
.query(prompt) // 设置查询文本
.topK(3) // 返回最相似的文档数量
.build();
List<Document> results = vectorStore.similaritySearch(searchRequest);
RAG 完整流程
1.知识库准备
相关的 SpringAI 封装核心类:Document
文档预处理:将专业知识文档转换为适合的结构化格式(如 JSON)
文本分块:将长文档切割为适合向量化的文本块
2.向量化存储阶段
封装类:VectorStore(统一接口) 和 PgVectorStore(PgVector 实现)
文本向量化:使用 Embedding 模型将文本转换为向量
向量存储:将向量和元数据保存到向量数据库
3.检索增强阶段
封装类:SearchRequest(检索请求)
查询向量化:将用户的查询转换为向量表示
相似度匹配:在向量空间中查找最相关文档
4.检索执行阶段
核心方法:VectorStore.similaritySearch()
向量相似度计算:计算查询向量与存储向量的距离
结果排序:按相似度得分排序返回结果
5.上下文构建阶段
相关文档获取:从检索结果中提取最相关知识片段
上下文封装:将检索到的信息整合为提示上下文
元数据利用:使用 Document.metadata 进行信息溯源
6.AI 生成阶段
核心类:ChatClient——AI 对话客户端
增强提示:将检索到的知识作为上下文输入 AI 模型
智能回答:基于知识库核用户查询生成准确回答
完整实例
1.引依赖
<!– PGVector 向量存储(Spring AI 官方支持) –>
<dependency>
<groupId>org.springframework.ai</groupId>
<artifactId>spring-ai-pgvector-store-spring-boot-starter</artifactId>
</dependency>
<!– PostgreSQL 驱动 –>
<dependency>
<groupId>org.postgresql</groupId>
<artifactId>postgresql</artifactId>
</dependency>
2.配置 PgVector 向量数据库
配置过程中注意与主数据库(比如 MySQL)的冲突
pgvector:
datasource:
jdbc-url: jdbc:postgresql://localhost:5432/dietary_rag
username: postgres
password: 123456
driver-class-name: org.postgresql.Driver
@Configuration
public class PgVectorStoreConfig {
@Bean("pgVectorDataSource")
@ConfigurationProperties("pgvector.datasource")
public DataSource pgVectorDataSource() {
return DataSourceBuilder.create().build();
}
@Bean
public JdbcTemplate pgVectorJdbcTemplate(@Qualifier("pgVectorDataSource") DataSource dataSource) {
return new JdbcTemplate(dataSource);
}
@Bean
public PgVectorStore vectorStore(EmbeddingModel embeddingModel, JdbcTemplate pgVectorJdbcTemplate) {
return PgVectorStore.builder(pgVectorJdbcTemplate, embeddingModel)
.vectorTableName("dietary_chunks") // 指定向量表名
.dimensions(1536) // 向量维度
.initializeSchema(true) // 自动初始化表结构
.build();
}
}
3.加载知识库
定义一个通用的加载器
public class GenericKnowledgeIngestor {
/**
* 从指定资源加载知识库,并写入向量存储。
*
* @param knowledgeResource JSON 资源(classpath:xxx.json)
* @param sourceName 知识来源名称(如 "中国居民膳食指南(2022)")
*/
public void ingest(Resource knowledgeResource, String sourceName) {
// 读取JSON文件
List<Map<String, Object>> pages = objectMapper.readValue(is, new TypeReference<>() {});
// 转换为Document对象
for (Map<String, Object> page : pages) {
Integer pageNum = (Integer) page.get("page");
List<String> chunks = (List<String>) page.get("chunks");
for (String chunk : chunks) {
Document document = new Document(
UUID.randomUUID().toString(), // 文档ID
chunk.trim(), // 文本内容(用于向量化)
Map.of("page", pageNum, "source", sourceName) // 元数据
);
documents.add(document);
}
}
// 批量写入向量数据库
vectorStore.add(batch);
}
}
实现专门具体的知识库加载器
@Component
public class DietaryKnowledgeIngestor {
@PostConstruct
public void ingest() {
GenericKnowledgeIngestor ingestor = new GenericKnowledgeIngestor(vectorStore, objectMapper);
ingestor.ingest(dietaryKnowledgeJson, "中国居民膳食指南(2022)");
}
}
@Component
public class SportKnowledgeIngestor {
@PostConstruct
public void ingest() {
GenericKnowledgeIngestor ingestor = new GenericKnowledgeIngestor(vectorStore, objectMapper);
ingestor.ingest(sportKnowledgeJson, "ACSM运动测试与运动处方指南(第十版)");
}
}
4.RAG 检索
@RequestMapping(value = "/chat", produces = "text/html;charset=utf-8")
public String chat(String prompt, String chatId) {
// 构建检索请求
SearchRequest searchRequest = SearchRequest.builder()
.query(prompt) // 用户查询
.topK(3) // 返回最相似的3个文档
.build();
// 执行向量相似度搜索
List<Document> similarDocs = vectorStore.similaritySearch(searchRequest);
// 构建上下文(带页码)
String context = similarDocs.stream()
.map(doc -> {
Integer page = (Integer) doc.getMetadata().get("page");
String content = doc.getText();
return "[第" + page + "页]" + content;
})
.collect(Collectors.joining("\\n\\n"));
}