实验报告优缺点分析文档
——《第四次阶段汇报:模型产物的仓库瘦身、云端部署与评测链路打通》优点与不足逐项梳理
|
评析对象 |
16 页阶段实验报告 |
|
文档性质 |
优缺点专项分析,与《分析评价文档》配套 |
|
优点条目 |
8 项(含佐证与影响) |
|
不足条目 |
8 项(含佐证与影响分级) |
|
评析日期 |
|
目 录
一、评价定位与依据
二、报告的主要优点(8 项)
三、报告的主要不足(8 项)
四、优缺点综合对照
五、结论
一、评价定位与依据
本文档对该实验报告的优点与不足做逐项梳理。所有条目均以报告原文事实为依据:优点须能指出具体章节或做法,不足须能指出具体缺失或风险,并标注其对后续工作的影响程度(高/中/低)。评价立足「阶段实验报告」这一文体定位——它不是论文,不苛求统计显著性;但作为工程记录,其对准确性、可复现性与证据链闭合的要求不打折扣。
二、报告的主要优点
2.1 结构完整,叙事主线清晰
全篇按「背景与目标 → 四轮实验 → 归因沉淀 → 结论排期」推进,四轮实验与三个待答问题一一对应;开头的内容提要把关键数据前置,读者无需通读全文即可掌握结论。受阻步骤集中于「交接处」的观察贯穿全篇,使分散的四轮记录有了统一的解释框架。
2.2 归因超越现象层面,直指「假设未被验证」
报告没有停留在「推送失败→重建仓库」的操作层,而是把六项问题归并为版本控制、资源规划、接口契约三个层面,并进一步抽象为共同规律——「三处都不是能力不足,而是假设未被验证」。这种从个案到规律的提炼,使一次排查能沉淀为普适的检查项。
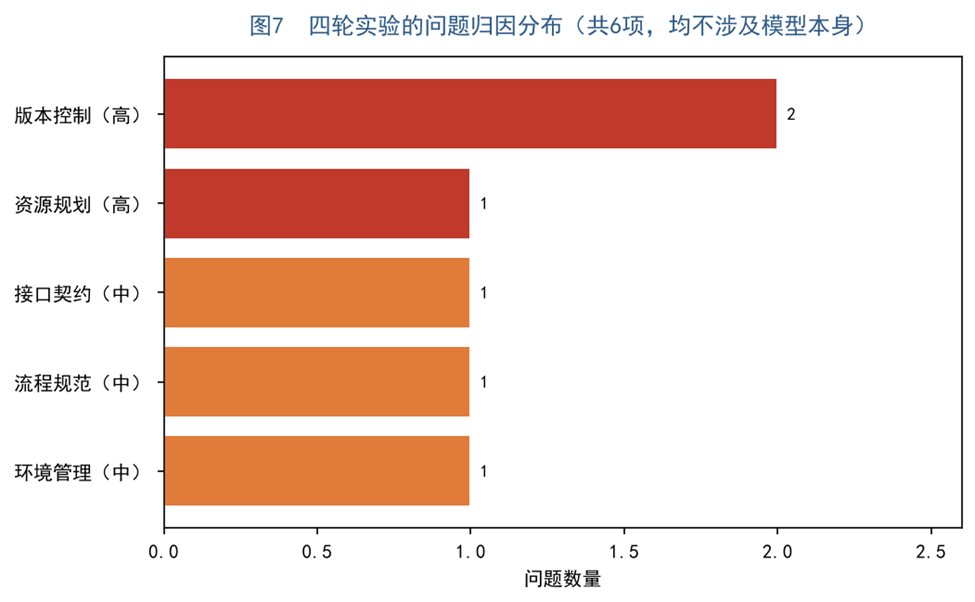
图 2-1 问题归因分布:六项问题均不涉及模型本身
2.3 数据翔实,关键论断量化到位
体积构成(277.6 GB 三类合计)、超限倍数(51 GB 为上限的 10.2 倍)、切分余量(2.3 GB 为上限的 46%)、并行效率等数字精确到可直接复核。这类表述把工程直觉转译成了可比较的量。
2.4 插图全部据数据重绘,规避截图依赖
2.5 如实记录误判、代价与不可逆操作
两处尤为可贵:其一,记录了「元数据开销嫌疑」这一被推翻的假设,并把「假设修正」本身作为经验写出;其二,坦承 –force 推送覆盖远端历史属不可逆操作、备份目录一度占用双份磁盘,并说明可接受的前提(单人维护的实验仓库)与多人协作时的正确替代(新建仓库)。不掩饰代价,是记录可信度的重要来源。
2.6 沉淀了五条可复用的工程做法
大文件预先分片(1 GB 以内、留足余量)、训练中间态不入库、历史污染时优先重建、关键参数显式声明并校验条数、输入输出路径分离——五条均直接由本轮失败推导而来,且给出了量化依据,可直接写入团队规范。
2.7 差异辨析能力强,避免方向性误判
两处辨析体现了扎实的系统知识:在现象与处置上的区分,避免了「加内存」的错误方向;「单文件超限是粒度问题、总量过大是策略问题」的区分,解释了为什么切分与重建缺一不可。
2.8 附录提供命令清单与记录索引,复现支持到位
附录 A 按环节汇总了从体积排查到评测运行的全部关键命令;附录 B 给出四份原始记录文档的索引。
三、报告的主要不足
3.1 评测样本仅 2 条,吞吐基线不可信(影响:高)
两轮评测分别只有 2 条样本,单轮实际计算不足 0.03 秒,被进程启动开销主导。报告虽自我声明「不能当成性能基线」,但正文仍以该数据绘制图 7/图 8 并拟合出,存在被读者误引的风险。千级样本的实测缺位使第四个结论目前只是量级推断。
图 3-1 并行度与吞吐:线性关系成立,但基线本身不可信(n=2)
3.2 实验三未完成,环境问题悬置(影响:高)
评测依赖安装因磁盘写满中断后,本轮仅给出三步处置方向(清缓存、分盘、扩容)与一项长期措施,未有任何一步在本轮执行验证。「清理后可安装成功」这一判断本身仍是未验证的假设——恰是报告自己批评的那类问题。
3.3 在与目标错位的算力底座上调试(影响:高)
下一阶段方向已是 GPU 评测,但实验四仍把调优精力花在 CPU 侧的进程数标定上。进程的对照数据对 GPU 迁移的参考价值有限,属于「在即将废弃的路径上做了过细的测量」,机会成本偏高。更优次序应是先确认算力选型,再做并行度标定。
3.4 合并脚本缺内容完整性校验(影响:中)
只校验部分号是否齐全,不校验内容是否完整。若分片传输损坏,合并仍会「成功」,直到加载权重时才报张量形状错误,排查成本被后移放大。报告在 3.2 节末尾已意识到并建议「合并前后各算一次 SHA256」,但未落实到脚本,属于「建议停在纸面」。
3.5 静默失败未设防:缺字段存在性与条数校验(影响:中)
既不检查指定字段是否存在,也不在「输入非空、输出为空」时告警。虽然修复了字段名,但脚本层的防御并未加入,同类问题换一个字段名仍会复现。
3.6 输入输出同路径,源样本曾被覆盖(影响:中)
异常产生的空数组直接覆盖了源样本。虽然样本可由 IDA 重新导出、损失有限,但「一次异常输出毁掉原始数据」暴露的流程缺陷是结构性的:脚本入口至今没有「输入输出路径不得相同」的断言。
3.7 部分关键数据为推算而非实测(影响:低)
报告注明了推断性质(值得肯定),但作为这一核心问题的输入,总体积本可通过一步实测,精度损失本可避免。
3.8 缺少对替代技术路径的评估(影响:低)
作为阶段汇报可接受,但作为方案选型记录则论证维度单一。
四、优缺点综合对照
表 4-1 优缺点对照与影响分级汇总
|
维度 |
优点(佐证) |
不足(佐证) |
不足影响 |
|
记录与归因 |
现象—定位—处置范式;「假设未被验证」的规律提炼(第六章) |
对自身整改建议同样未验证(实验三仅给方向) |
中 |
|
数据与证据 |
量化精确,插图全部据数据重绘 |
为推算 |
高 |
|
工程处置 |
切分+重建串联关系论证清楚;五条可复用做法 |
SHA256 校验、路径断言等建议未落实到脚本 |
中 |
|
方案视野 |
附录命令齐全,复现支持好 |
未评估对象存储等替代托管路径;CPU 侧过度调优 |
低/高 |
|
完成度 |
迁移链路四步闭环,24 个权重完整还原 |
实验三未闭环,实验四仅最小验证 |
高 |
总体而言,优点集中在「记录质量与归因深度」,不足集中在「评测证据强度与整改闭环」——即报告在「把失败讲清楚」上表现优秀,在「把验证做完」上还有明显距离。
五、结论
该报告是一份「过程可信、结论部分超前」的阶段记录:迁移链路的成果与三条工程经验已经过事实验证,可以采信并推广;而涉及评测吞吐与算力选型的第四个结论,需待千级样本与 GPU 环境的实测数据落地后方可作为决策依据。建议读者引用本报告时区分这两类结论的证据等级;建议作者在下一轮汇报中优先补齐 3.1、3.2 两项高影响缺口。