目录
一、排序基础概念与应用
(一)排序核心定义
(二)实际应用场景
(三)排序算法分类
二、直接插入排序
(一)算法思想
(二)详细步骤
(三)代码实现与细节
(四)复杂度与稳定性分析
三、希尔排序
(一)算法思想
(二)关键原理
(三) 算法步骤
(四)代码实现
一、排序基础概念与应用
(一)排序核心定义
排序是使一串记录按照某个或某些关键字的大小,递增或递减排列的操作。核心要素包括 “关键字”(排序依据,如商品价格、评论数)和 “排列方向”(升序 / 降序)。
(二)实际应用场景
1、课程列表排序:根据课程更新时间排序,最新更新的课程排在前列。
2、聊天群排序:按照群内最新发言时间倒序排列,最新有消息的群置顶。
3、电商商品排序:可按价格、销量、好评率等维度对商品进行排序展示。
4、院校排名:依据各类评估指标对院校进行名次排列。
(三)排序算法分类
1、插入排序:① 直接插入排序、② 希尔排序
2、选择排序:① 直接选择排序、② 堆排序
3、交换排序:① 冒泡排序、② 快速排序
4、归并排序:归并排序(递归版、非递归版)
5、非比较排序:计数排序
二、直接插入排序
(一)算法思想
1、核心逻辑
将待排序元素逐个插入已排好序的有序序列中,初始时将第一个元素视为 “有序序列”,后续元素依次与有序序列从后向前比较,找到插入位置后移动元素并插入。
通俗一点说,一开始第一个元素是有序序列,然后比较第二个元素,比他大还是小,小了放前面,大了放后面。然后第三个元素再与前面的有序序列进行比较,找到合适的位置再插入,直至全部数据遍历完全为止。
2、生活类比
类似扑克牌理牌 —— 左手持已排序的牌,右手每次取一张新牌,从右往左与左手的牌比较,插入到合适位置,最终左手的牌完全有序。
3、举例
初始乱序序列(如 [5,3,9,6,2,4,7,1,8])中,3 先插入 [5] 形成 [3,5],9 插入 [3,5] 形成 [3,5,9],以此类推,逐步扩展有序序列范围。
(二)详细步骤
以数组 int a[ ] = {5,3,9,6,2,4,7,1,8} 为例。
1、初始化
end = 0,指向有序序列末尾,初始为第一个元素 5,tmp = arr[end+1] = 3(待插入元素)。
2、比较移动
arr[end] = 5 > 3,将arr[end]后移至arr[end+1],数组变为 [5,5,9,6,2,4,7,1,8],然后end–。end = -1,越界。
3、插入元素
将temp = 3插入end+1 = 0位置,数组变为 [3,5,9,6,2,4,7,1,8]。
4、循环扩展
重复上述步骤,依次处理剩余元素,直至所有元素插入完成,最终得到 [1,2,3,4,5,6,7,8,9]。
本质上就是,待排序元素先存入临时变量保存起来,然后与有序序列中的所有元素进行比较,只要有序序列中的元素大于待排序元素就往后移动,依次比较。
最后到了一个比它的元素,就在这个元素前面,插入待排序的元素。
(三)代码实现与细节
1、按思路书写的容易理解的代码
void InsertSort(int* arr, int n)
{
// 外层循环:控制待插入元素(从第2个元素开始,下标1到n-1)
for (int i = 1; i < n-1; i++)
{
int end = i; //指向有序序列的最后一个位置
int tmp = arr[end + 1]; //这个是待排序的元素
// 内层循环:从后向前比较,找插入位置
while (end >= 0) {
if (arr[end] > temp)
{
arr[end + 1] = a[end]; // 元素后移
end–;
}
else {
break; // 找到插入位置,退出循环
}
}
arr[end + 1] = temp; // 插入待排序元素
}
}
(1)关键细节
① 外层循环从i=1开始,因第一个元素默认有序。
② 内层循环end >= 0避免越界,若arr[end] <= temp,说明当前位置即为插入点,无需继续比较。
③ 仅使用end和temp两个额外变量,空间复杂度为O(1)。
(2)设计细节
这个遍历保证把所有数据都排序一次。
n – 1即 end 只需要走到倒数第二个数据就行了,因为它指向的是有序数组的最后一个数据。
那么此时还剩一个数据,交给tmp,然后再去排序就可以了。如果end可以到最后,那么后面的越界元素也可以插入了
2、带哨兵位的代码实现
void InsertSort(int* arr, int n)
{
// 定义变量用于遍历
int i,j;
//控制插入元素,从第二个到最后一个
for(i = 2; i <= n; i++)
{
r[0] = r[i]; //暂存待插入记录,设置哨兵
//寻找插入位置
for(j = i – 1; r[0] < r[j]; j–)
r[j + 1] = r[j]; //大的元素后移
//将元素插入对应位置
r[j + 1] = r[0];
}
}
其实也是百变不离其宗。
首先你要保证你遍历的变量,可以完整遍历所有元素;其次要使用临时变量或者哨兵位,保存插入元素;然后寻找插入位置,大的元素往后移动;最后在比它小的元素前面完成插入操作。
(四)复杂度与稳定性分析
1、时间复杂度
(1)最坏情况(数组降序):需移动1+2+…+(n-1) = n(n-1)/2次,时间复杂度 O(n²) 。
(2)最好情况(数组升序):仅需n-1次比较,无需移动,时间复杂度 O(n) 。
(3)平均情况:O(n²)【一般情况下都很难达到这个量级,因为不可能是完全倒序的】
为了优化时间复杂度最坏的情况,我们发明了另一种插入排序 —— 希尔排序。
2、空间复杂度
仅使用常数个额外变量(end、tmp),空间复杂度为O(1)。
3、稳定性
如果两个相同的元素,相对次序不变,则称排序之后稳定。
使用直接插入排序时,因为当待插入元素与已排序序列中的元素相等时,会插入到相等元素的后面,保持原有相对顺序,所以是稳定的。
如数组 [2,5,3,5,1],两个 5 的相对顺序在排序后保持不变。
三、希尔排序
(一)算法思想
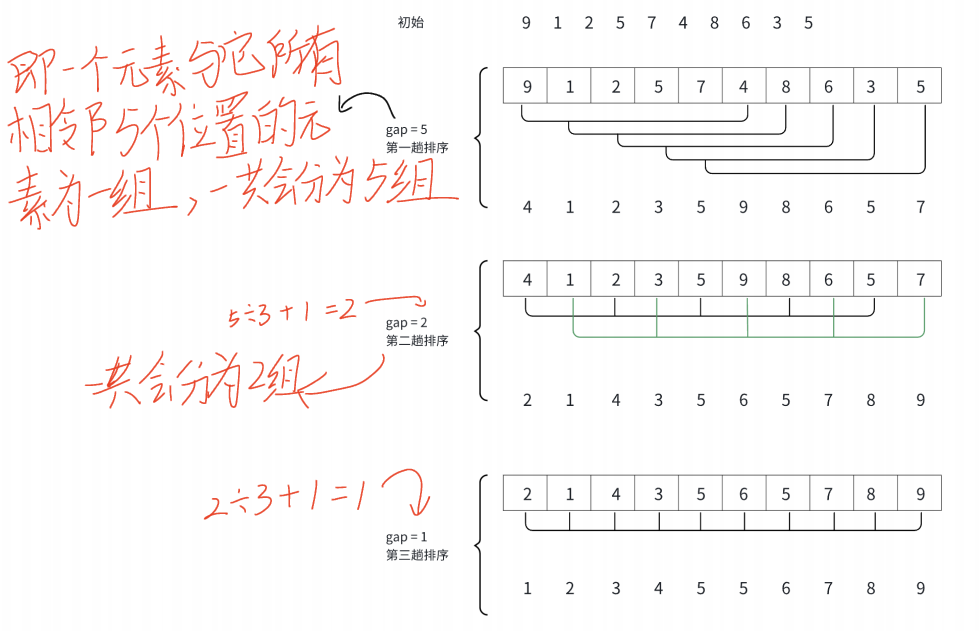
希尔排序又称 “缩小增量排序”,通过分组预排序优化直接插入排序:
1、分组规则
选定 “增量 gap”,将数组按 “元素间距为 gap ” 分成 gap 组。
如 gap = 3 时,数组 [9,1,2,5,7,4,8,6,3,5] 分为 [9,5,8]、[1,7,6]、[2,4,3]、[5] 四组。
2、组内排序
每组分别执行直接插入排序,减少组内逆序对。
3、缩小增量
gap逐步减小(常用gap = gap/3 + 1),重复分组与排序,直至gap=1。此时数组已基本有序,执行最后一次直接插入排序,即可减少时间复杂度。
(二)关键原理
1、预排序目的
通过 gap>1 的分组排序,将 “大元素后置、小元素前置”,减少直接插入排序在 gap=1 时的移动次数。例如数组 [9,8,7,6,5,4,3,2,1],gap=3预排序后变为 [3,2,1,6,5,4,9,8,7],gap=1时仅需少量移动即可有序。
2、增量选择
gap = gap/3 + 1确保最终gap=1,如n=9时,gap依次为 3、1。避免增量跳过 1 导致排序不完整,同时增量序列中无除 1 外的公因子。
(三) 算法步骤
以 arr[] = { 5,3,9,6,2,4,7,1,8 },n=9为例
1、预排序(gap > 1)
(1)分组:初始 gap=9/3+1=4,数组分为 4 组:[5,2,1]、[3,4,8]、[9,7]、[6]
(2)组内排序:[1,2,5]、[3,4,8]、[7,9]、[6],数组变为 [1,3,7,6,2,4,5,8,9]
(3)重复上述步骤:更新gap=4/3+1=2,分组为 [1,7,2,5,9]、[3,6,4,8],组内排序后数组变为 [1,3,2,6,5,4,7,8,9]。
2、直接插入排序(gap = 1)
当gap = 1时,即gap=2/3+1=1,对整个数组进行直接插入排序,得到最终有序数组。
(四)代码实现
void ShellSort(int* arr, int n)
{
//gap/3是为了不要分太多组,+1是为了避免0出现的情况,保证最小为1
int gap = n;
// 增量逐步缩小至1
while (gap > 1)
{
// 增量更新规则,刚好最后一遍为1
gap = gap / 3 + 1;
// 分组插入排序(每组元素间距为gap)
// i++的作用是:来到哪一组就排哪一组的数据,这样就可以少一个一组一组排的循环。
for (int i = 0; i < n – gap; i++)
{
int end = i; // 组内有序序列末尾下标
int tmp = arr[end + gap]; // 组内待插入元素
while (end >= 0)
{
if (arr[end] > tmp) {
arr[end + gap] = arr[end]; // 组内元素后移(步长gap)
end -= gap;
} else {
break;
}
}
arr[end + gap] = tmp; // 插入组内合适位置
}
}
}
(五)复杂度与稳定性分析
1、时间复杂度
希尔排序时间复杂度与gap增量序列相关,难以精确计算。
严蔚敏《数据结构(C 语言版)》中给出平均时间复杂度约O(n^1.3),最坏情况(如增量选择不当)接近O(n²),最好情况接近 O(n) 。
2、空间复杂度
O(1)(无额外空间消耗)
3、稳定性
不稳定。分组排序可能改变相同元素的相对顺序,如数组 [5,8,5,2,9],gap=2分组后排序,两个 5 的相对顺序可能反转。
一般来说,希尔排序这种依赖 “跳跃式” 的交换,都是不稳定移动。
跳跃式交换即排序过程中,元素不是相邻交换,而是跨越多个元素进行交换。这种方式可能导致值相等的元素被远距离移动,打乱原有顺序。