前言:在大型语言模型(LLM)飞速发展的今天,如何解决模型“幻觉”、知识更新滞后以及缺乏可解释性等痛点,是学术界和工业界共同关注的核心问题。2020年,Facebook AI Research (FAIR) 联合伦敦大学学院等机构提出了 RAG (Retrieval-Augmented Generation) 框架,开创了“检索+生成”的新范式。这篇论文不仅是 RAG 领域的奠基之作,更是当前许多联网大模型和知识库问答系统的理论基石。本文将对该论文进行深度精读,梳理其核心思想、方法论及实验结论。
📄 论文基本信息
| 论文标题 | Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks |
| 中文译名 | 检索增强生成用于知识密集型自然语言处理任务 |
| 作者 | Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, Sebastian Riedel, Douwe Kiela |
| 所属机构 | Facebook AI Research (FAIR), University College London (UCL) |
| 发表年份 | 2020 |
| 收录会议 | NeurIPS 2020 (Conference on Neural Information Processing Systems) |
| 核心领域 | RAG (检索增强生成), Open-Domain QA, Knowledge-Intensive NLP |
| 代码开源 | 已集成于 Hugging Face Transformers 库 (RagSequenceForGeneration, RagTokenForGeneration) |
研究背景与痛点
尽管 BERT、T5、BART 等大型预训练语言模型通过将海量知识压缩在参数中(参数化记忆)取得了巨大成功,但在处理知识密集型任务(如开放域问答、事实验证)时,仍面临以下四大痛点:
💡 核心思路:模仿人类解决问题的方式——先检索(查资料),再生成(综合回答)。RAG 旨在结合参数化记忆(模型内部权重)与非参数化记忆(外部知识库),构建一个既能利用内部推理能力,又能实时访问外部最新知识的混合系统。
核心方法:RAG 架构详解
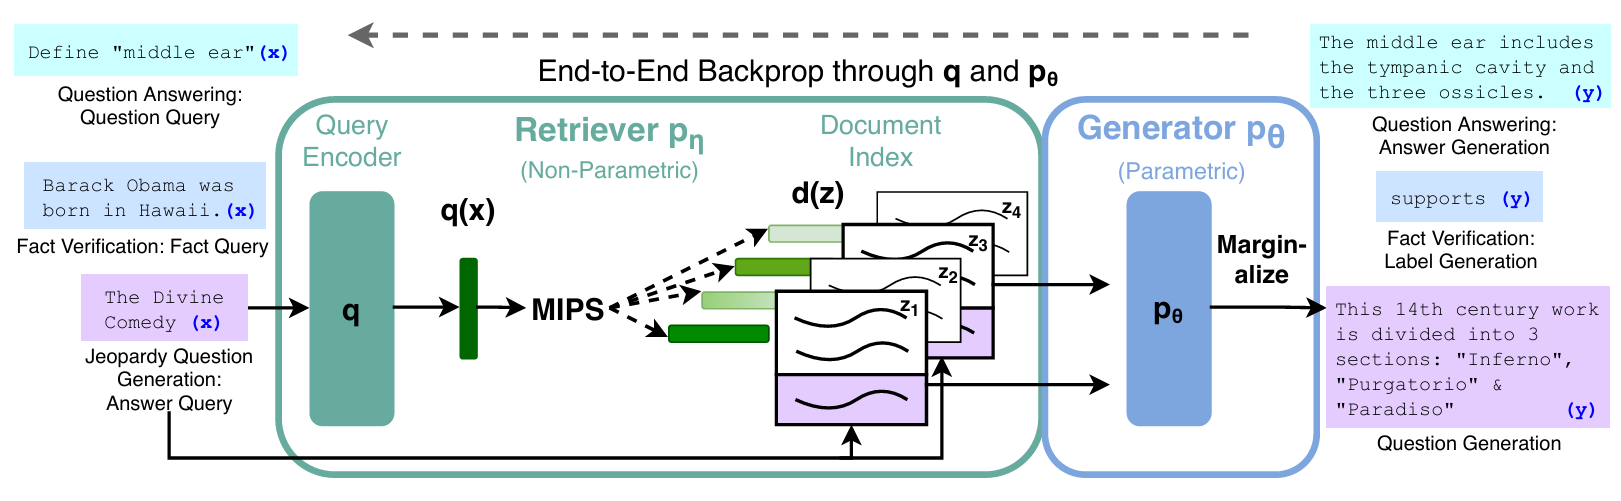
RAG (Retrieval-Augmented Generation) 是一个端到端的概率模型,其核心在于将预训练的序列到序列(Seq2Seq)模型与一个稠密向量检索器无缝结合。
1. 整体架构流程
RAG 的工作流程可以概括为三个步骤:
- Step 1 检索 (Retrieve):输入查询 x 进入检索器,从外部知识库(如维基百科)中检索出 Top-K 个最相关的文档片段 z 。
- Step 2 增强 (Augment):将原始查询 x 与检索到的文档 z 拼接,形成增强的上下文。
- Step 3 生成 (Generate):增强后的上下文输入生成器,生成最终的目标序列
 (如答案)。
2. 关键组件设计
(1) 非参数化记忆:检索器 (Retriever,  )
- 模型基础:基于 DPR (Dense Passage Retriever) 架构,采用双编码器(Bi-encoder)结构。
- 工作原理:
- 使用预训练的 BERT 模型分别将查询(Query)和文档(Document)编码为稠密向量。
- 通过最大内积搜索(MIPS)在包含 2100 万个文档片段(来自维基百科)的索引中进行相似度匹配。
- 特点:这部分知识是外部的、动态的,构成了模型的“外部大脑”。
(2) 参数化记忆:生成器 (Generator,  )
- 模型基础:基于预训练的 BART-large 模型(一种强大的 Seq2Seq Transformer)。
- 特点:负责逻辑推理、语言组织和流畅表达,构成了模型的“内部大脑”。
3. 两种模型变体
为了有效利用检索到的多个文档(Top-K),论文提出了两种不同的边缘化(Marginalization)策略:
| 核心假设 | 一篇文档定全局:假设同一个检索文档负责生成整个输出序列。 | 博采众长:允许每个生成的 Token 基于不同的检索文档。 |
| 适用场景 | 答案主要集中在单篇文档中的任务(如事实性问答)。 | 需要综合多篇文档信息的复杂生成任务(如生成综述、Jeopardy问题)。 |
| 解码策略 | 需采用“彻底解码”或“快速解码”策略,计算开销较大。 | 可直接使用标准的束搜索(Beam Search),解码速度较快。 |
4. 训练策略:端到端联合优化
- 无需监督信号:RAG 不需要人工标注“这个问题应该检索哪篇文章”。
- 潜在变量优化:将检索到的文档 z 视为潜在变量。通过最小化生成目标序列 y 的负对数似然损失,模型自动学习如何检索对生成任务最有帮助的文档。
- 固定文档编码器:为降低计算成本,训练时固定文档编码器(及索引),仅微调查询编码器和 BART 生成器。
实验结果与分析
作者在多个知识密集型任务上进行了广泛评估,结果令人瞩目:
1. 开放域问答 (Open-Domain QA) 👑
- 数据集:Natural Questions (NQ), WebQuestions, CuratedTrec, TriviaQA。
- 表现:RAG 在所有四个数据集上均刷新了 SOTA (State-of-the-Art) 记录。
- 对比优势:
- 优于纯参数模型(如 T5-11B,参数量是 RAG 的 18 倍)。
- 优于专门的“检索+抽取”模型(如 DPR)。
- 鲁棒性:即使正确答案未出现在检索到的文档中,RAG 也能利用内部参数知识生成正确回答,而抽取式模型则会直接失败。
2. 抽象问答与文本生成 ✍️
- 任务:MS-MARCO 问答、Jeopardy 问题生成。
- 表现:
- 事实性 (Factuality):RAG 生成的内容比纯 BART 模型更少幻觉,更多具体细节。
- 多样性 (Diversity):生成的 Jeopardy 问题更加丰富多样,不再千篇一律。
- 人工评估:人类评委显著偏好 RAG 生成的 Jeopardy 问题,认为其更具体、更符合事实。
3. 事实验证 (Fact Verification) 🔍
- 数据集:FEVER。
- 表现:在没有使用任何证据监督信号(即没人告诉模型哪句话是证据)的情况下,RAG 的性能接近那些经过复杂流水线训练且使用强监督的最强模型。
4. 杀手级功能:知识热插拔 (Hot-swapping) 🔄
这是 RAG 最具突破性的特性之一,验证了其在知识更新方面的巨大优势:
- 实验设计:将外部维基百科索引从 2016 版替换为 2018 版。
- 结果:模型对国家领导人变更等时效性问题的回答准确率随之大幅更新,无需任何重新训练。
- 对比:纯参数模型(如 T5)若要更新此类知识,必须使用新数据重新训练,成本极高。
主要创新点总结
局限性与未来展望
尽管 RAG 表现优异,但论文也诚实地指出了其局限性:
- 检索崩溃 (Retrieval Collapse):在某些不需要严格事实知识的任务(如创意故事生成)中,检索器可能会退化,总是检索相同的文档,导致模型退化为纯生成模型。
- 计算开销:检索过程和多次生成推断增加了推理时的计算成本和延迟。
- 数据依赖:模型的表现高度依赖于外部知识库(如维基百科)的质量和覆盖范围,若知识库存在偏见,模型也会继承这些偏见。
📝 总结
《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》是 NLP 领域的里程碑式论文。它不仅仅提出了一个具体的模型,更确立了一种解决知识密集型任务的标准范式。
参考文献:
[1] Lewis P, Perez E, Piktus A, et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks[C]//Advances in Neural Information Processing Systems. 2020, 33: 9459-9474.