**
个人主页
** 
文章目录
-
- 个人主页
- 一、基础语法
-
- 1. 标识符
- 2. 保留字符
- 3. 行和缩进
- 4.注释
- 5. print 输出
- 6. 代码组
- 二、基本数据类型
-
- (一)、变量赋值
-
- 1.1 无需类型声明
- 1.2 多种赋值方式
- (二)、标准数据类型
-
- 2.1 数字(Numbers)
-
- 2.1.1 不可变类型
- 2.1.2 支持类型
- 2.1.3 删除对象引用
- 2.2 字符串(String)
-
- 2.2.1 组成与索引
- 2.2.2 切片操作
- 2.2.3 运算符
- (三)、数据类型的转换
-
- 3.1隐式类型转换——自动完成
- 3.2显式类型转换——使用类型函数来转换
- (四)、复合数据类型
-
- 4.1列表
- 4.2 元组
- 4.3集合(set)
- 4.4字典(dict)
- 三、运算符
-
- 1. 算术运算符
-
- 1.1 基本运算
- 1.2 特殊运算
- 2. 比较运算符
- 3. 赋值运算符
-
- 3.1 基本赋值
- 3.2 复合赋值
- 4. 逻辑运算符
- 5. 位运算符
- 6. 成员运算符
- 7. 身份运算符
- 8. 运算符优先级
- 四、判断与循环
-
- 1.判断
-
- if 语句
- if – else 语句
- if – elif – else 语句
- 2. 循环语句
-
- for 循环
- while 循环
- 循环控制语句
- 五、函数
-
- (一)、函数基础
-
- 1. 定义函数
- 2. 调用函数
- (二)、函数参数
-
- 1. 默认参数
- 2. 可变参数
- (三)、匿名函数
- (四)、函数作为对象
- 六、文件操作
-
- (一)、文件操作基础
-
- 1. 打开文件
- 2. 读取文件
- 3. 写入文件
- (二)、上下文管理器
- (三)、二进制文件操作
- 七、模块导入与应用
-
- 1.Numpy:数值计算的基石
-
- 1.1 安装 Numpy
- 1.2 导入 Numpy
- 2.Pandas:数据处理的利器
-
- 2.1安装 Pandas
- 2.2 导入 Pandas
- 3.Matplotlib:数据可视化大师
-
- 3.1 安装 Matplotlib
- 3.2 导入 Matplotlib
- 4. 多模块协同使用
-
- 案例:分析学生成绩数据
- 3.2 导入 Matplotlib
- 4. 多模块协同使用
-
- 案例:分析学生成绩数据
本文只针对python在数学建模比赛中的应用,不是很全面哦~
一、基础语法
1. 标识符
由字母、数字、下划线组成,不能以数字开头,且区分大小写。单下划线开头的(_foo),表明是不能直接访问的类属性;双下划线开头的(__foo),代表类的私有成员;双下划线开头和结尾的(__foo__),用于特殊方法标识。
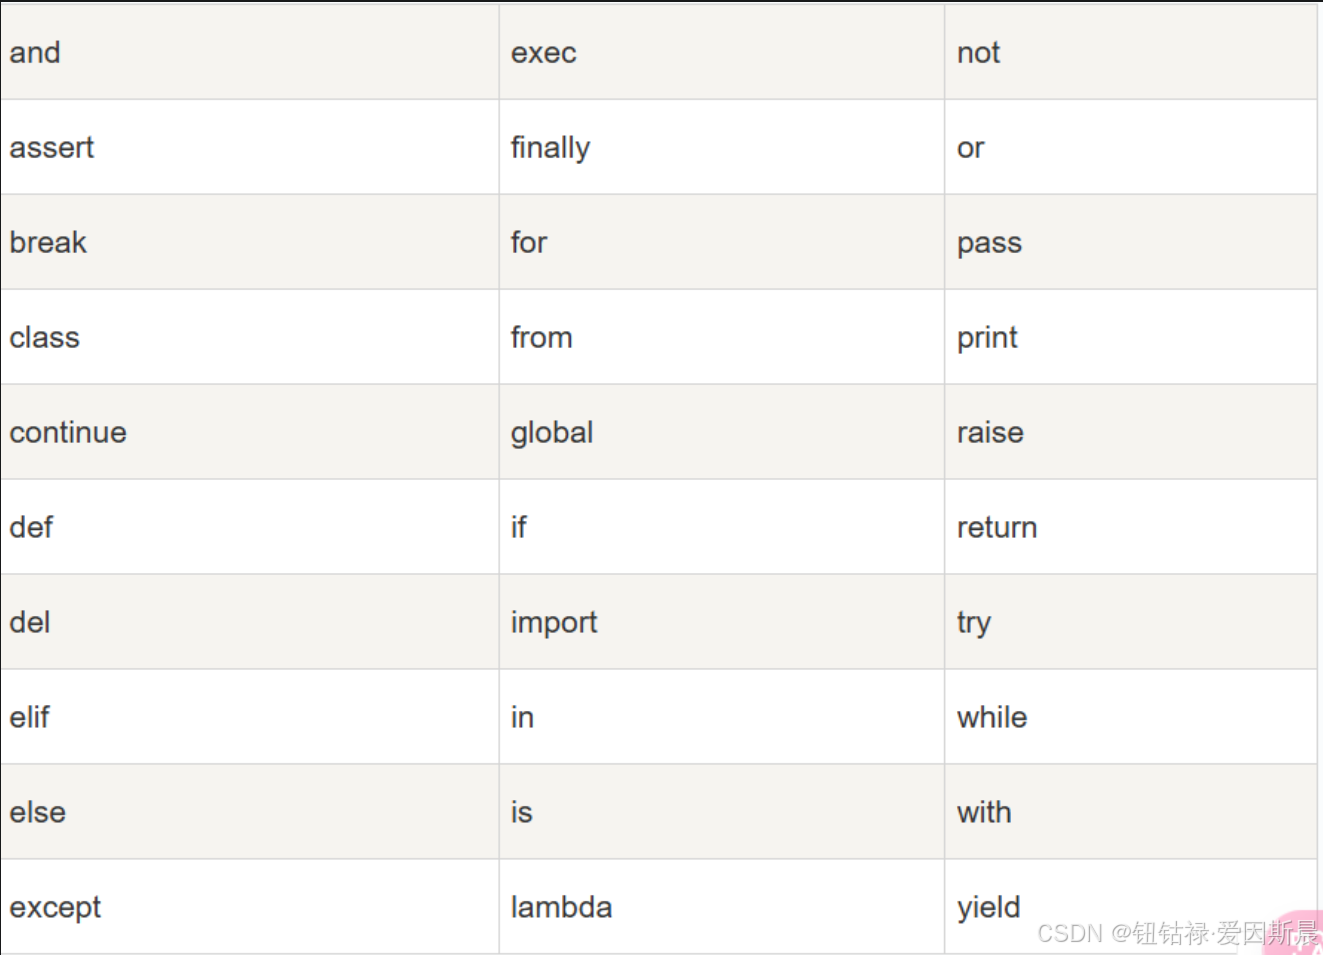
2. 保留字符
像and、if等关键词,不能用作标识符。
3. 行和缩进
Python 利用缩进来表示代码块,同一代码块内,缩进的空格数必须保持一致。建议使用单个制表符、两个或四个空格,严禁混用。
a=1
if a==1:
print(a)
print("ture")
print("a是等于1的")
print("go")
4.注释
单行注释以#开头;多行注释使用三个单引号’''或三个双引号"“”。
5. print 输出
默认情况下,print 会换行输出。在变量末尾加上逗号(, ),可实现不换行输出。
x="a"
y="b"
# 换行输出
print x
print y
print '———'
# 不换行输出
print x,
print y,
# 不换行输出
print x,y
在同一行书写多个语句时,使用分号(;)进行分隔。
6. 代码组
缩进相同的一组语句构成代码组。if、while等复合语句,首行以关键字开头,以冒号结束,后续的代码组构成子句。
二、基本数据类型
(一)、变量赋值
1.1 无需类型声明
Python 中的变量赋值不需要类型声明。
每个变量在内存中创建,都包括变量的标识,名称和数据这些信息。
每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建。
等号 = 用来给变量赋值。
等号**=** 运算符左边是一个变量名,等号**=** 运算符右边是存储在变量中的值。例如:
counter = 100 # 赋值整型变量
miles = 1000.0 # 浮点型
name = "John" # 字符串
print counter
print miles
print name
1.2 多种赋值方式
-
单个变量赋值:通过等号,直接将值赋予变量。如miles = 1000.0,将浮点型数据1000.0赋给变量miles。
-
多个变量赋相同值:使用a = b = c = 1的形式,系统会创建一个值为1的整型对象,让a、b、c三个变量同时指向这一内存空间。
-
多个变量赋不同值:采用a, b, c = 1, 2, "john"的方式,可分别将不同类型的值,对应地赋给多个变量。
(二)、标准数据类型
2.1 数字(Numbers)
2.1.1 不可变类型
数字数据类型用于存储数值。值得注意的是,当数字变量的值发生改变时,系统会为其分配新的对象。例如,当var1 = 1,若后续修改var1的值,系统将重新分配内存空间。
2.1.2 支持类型
-
int(有符号整型):主要用于表示整数,如10、-786等,涵盖了正整数、负整数和零。
-
long(长整型,仅 Python 2.X):在 Python 2.2 及之后的版本中,当int数据发生溢出时,会自动转换为long类型。在表示长整型数据时,可使用大写L或小写l,为避免与数字1混淆,建议使用大写L,如51924361L。
-
float(浮点型):用于表示带有小数部分的数值,如0.0、15.20等。
-
complex(复数):由实部和虚部组成,书写形式为a + bj,或者通过complex(a,b)函数创建,如3.14j。
2.1.3 删除对象引用
可使用del语句删除数字对象的引用。例如,del var1可删除变量var1的引用;del var_a, var_b则可同时删除多个变量的引用。
2.2 字符串(String)
2.2.1 组成与索引
字符串由数字、字母、下划线等字符组成。在字符串中,索引从左至右默认从0开始,从右至左默认从-1开始。例如,对于字符串’abcdef’,字符’a’的索引为0,字符’f’的索引为-1。
2.2.2 切片操作
借助[头下标:尾下标]的方式,可对字符串进行切片操作,从而截取子字符串。需要注意的是,截取的结果包含头下标对应的字符,但不包含尾下标对应的字符。如对’abcdef’执行[1:5]切片操作,将得到’bcde’。(包头不包尾)
2.2.3 运算符
字符串类型支持多种运算符:
- 连接运算符(+):将两个字符串连接成一个新的字符串,如’Hello,’ + 'World!‘结果为’Hello,World!’。
- 重复运算符(*):将字符串重复指定次数,如’Hi’ * 3结果为’HiHiHi’。
(三)、数据类型的转换
a=100
print (type(a))
b=100.9
print (type(b))
c=True
print (type(c))
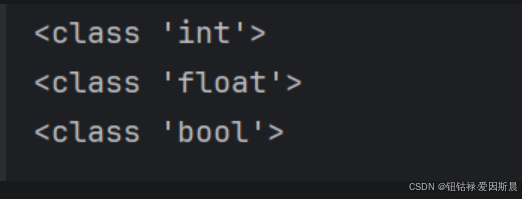
type()打印数据类型的函数
3.1隐式类型转换——自动完成
#隐式转换
ab=a+b
print(type(ab))
<class 'float'>
3.2显式类型转换——使用类型函数来转换
#强制转换
ab=a+int(b)
print(type(ab))
ab=int(a+b)
print(type(ab))
<class 'int'>
<class 'int'>
就是在想要转换的变量前面加一个身份
(四)、复合数据类型
4.1列表
基本概念:列表是一种有序、可变的数据类型,可以存储任意类型的数据,元素之间用逗号分隔,整体用方括号 [] 包裹。
创建列表
fruits = ['apple', 'banana', 'cherry']
numbers = [1, 2, 3, 4, 5]
mixed = [1, 'hello', True, [1, 2, 3]]
访问元素:
通过索引(从 0 开始)访问列表元素。
print(fruits[0])
修改元素:
可以直接通过索引修改指定位置的元素。
fruits[1] = 'orange'
添加元素
- append() 方法在列表末尾添加一个元素。
fruits.append('pear')
- insert() 方法在指定位置插入一个元素。
fruits.insert(1, 'grape')
删除元素
- 使用 del 语句删除指定位置的元素.
del fruits[2]
- pop() 方法删除并返回指定位置的元素(默认删除最后一个)。
removed = fruits.pop(1)
- remove() 方法删除指定值的第一个匹配项。
fruits.remove('pear')
注意点:
- 索引不能超出列表范围,否则会抛出 IndexError 异常。
- 列表的切片操作(如 fruits[1:3])会返回一个新的列表。
4.2 元组
基本概念:元组是一种有序、不可变的数据类型,元素之间用逗号分隔,整体用圆括号 () 包裹。虽然不可变,但元组内如果包含可变对象(如列表),可变对象本身是可以修改的。
创建元组
point = (1, 2)
fruits = ('apple', 'banana', 'cherry')
single = (1,) # 单个元素的元组需要逗号
访问元素:
和列表一样通过索引访问。
print(fruits[1])
注意点:
- 由于元组不可变,所以没有添加、删除、修改元素的方法。
- 元组在需要保证数据不被意外修改的场景下很有用,并且相比列表,元组的访问速度更快。
4.3集合(set)
基本概念:集合是一种无序、可变、不重复的数据类型,元素之间用逗号分隔,整体用花括号 {} 包裹(注意:创建空集合需用 set(),因为 {} 创建的是空字典)。
创建集合
numbers = {1, 2, 3, 4, 4} # 重复元素会被自动去除
fruits = set(['apple', 'banana', 'cherry'])
添加元素:
使用 add() 方法添加单个元素,update() 方法添加多个元素(可以是列表、元组等可迭代对象)。
numbers.add(5)
numbers.update([6, 7, 8])
删除元素:
remove() 方法删除指定元素(元素不存在时会报错),discard() 方法删除指定元素(元素不存在时不会报错)。
numbers.remove(3)
numbers.discard(9)
集合运算:支持并集(| 或 union() 方法)、交集(& 或 intersection() 方法)、差集(- 或 difference() 方法)等。
set1 = {1, 2, 3, 4}
set2 = {3, 4, 5, 6}
print(set1 | set2)
print(set1 & set2)
print(set1 – set2)
注意点:
- 集合中的元素必须是不可变的,所以不能包含列表等可变对象。
- 集合常用于快速判断元素是否存在、去除重复元素以及进行集合运算。
4.4字典(dict)
基本概念:字典是一种无序的、可变的数据类型,以键值对(key – value)的形式存储数据。键必须是唯一且不可变的(如字符串、数字、元组),值可以是任意数据类型。
创建字典
- 直接赋值
person = {'name': 'Alice', 'age': 25}
- 使用 dict() 函数
info = dict(name='Bob', age=30)
访问字典元素:通过键获取对应的值。
print(person['name'])
- 使用 get() 方法,避免键不存在时抛出异常。
print(person.get('height', '暂无数据'))
修改和添加元素:修改已有键的值,添加新的键值对。
person['age'] = 26
person['height'] = 165
删除元素
- 使用 del 语句删除指定键值对。
del person['height']
- 使用 pop() 方法删除并返回指定键的值。
age = person.pop('age')
遍历字典
- 遍历键
for key in person.keys():
print(key)
- 遍历值
for value in person.values():
print(value)
- 遍历键值对
for key, value in person.items():
print(key, value)
注意点:
- 键的唯一性:字典中键必须唯一,后出现的相同键会覆盖前面的值。
- 键的不可变性:键只能使用不可变数据类型,如不能使用列表作为键。
- 性能优势:字典查找速度快,适合大规模数据的快速查询场景。
三、运算符
1. 算术运算符
算术运算符主要用于执行基本的数学运算,涵盖加、减、乘、除等操作,既支持数值类型的运算,部分运算符还能作用于特定的序列类型。
1.1 基本运算
| + | 加法,用于数值相加,也可拼接字符串、列表等序列 | 5 + 3结果为8;'Hello ’ + ‘World’结果为’Hello World’ |
| – | 减法,实现数值相减 | 5 – 3结果为2 |
| * | 乘法,实现数值相乘,还能重复序列 | 5 * 3结果为15;‘abc’ * 3结果为’abcabcabc’ |
| / | 除法,结果以浮点数形式呈现 | 5 / 3结果为1.6666666666666667 |
1.2 特殊运算
| % | 取模,返回除法运算的余数 | 5 % 3结果为2 |
| ** | 幂运算,计算指数 | 5 ** 3结果为125 |
| // | 取整除,返回商的整数部分 | 5 // 3结果为1 |
2. 比较运算符
比较运算符用于对两个值进行大小或相等关系的比较,其运算结果为布尔类型(True或False),在条件判断语句中应用广泛。
| == | 判断两个值是否相等 | 5 == 3结果为False |
| != | 判断两个值是否不相等 | 5 != 3结果为True |
| > | 判断左侧值是否大于右侧值 | 5 > 3结果为True |
| < | 判断左侧值是否小于右侧值 | 5 < 3结果为False |
| >= | 判断左侧值是否大于或等于右侧值 | 5 >= 3结果为True |
| <= | 判断左侧值是否小于或等于右侧值 | 5 <= 3结果为False |
3. 赋值运算符
赋值运算符用于将数据值赋给变量,除了基本的赋值运算符=,还包括多种复合赋值运算符,以简化常见的运算操作。
3.1 基本赋值
| = | 将右侧的值赋给左侧变量 | a = 5 |
3.2 复合赋值
| += | a += b等价于a = a + b | a = 5; a += 3,执行后a的值为8 |
| -= | a -= b等价于a = a – b | a = 5; a -= 3,执行后a的值为2 |
| *= | a *= b等价于a = a * b | a = 5; a *= 3,执行后a的值为15 |
| /= | a /= b等价于a = a / b | a = 5; a /= 3,执行后a的值约为1.6666666666666667 |
| %= | a %= b等价于a = a % b | a = 5; a %= 3,执行后a的值为2 |
| **= | a **= b等价于a = a ** b | a = 5; a **= 3,执行后a的值为125 |
| //= | a //= b等价于a = a // b | a = 5; a //= 3,执行后a的值为1 |
4. 逻辑运算符
逻辑运算符用于组合多个条件语句,从而构建复杂的逻辑表达式,运算结果同样为布尔类型。
| and | 逻辑与,当且仅当所有条件都为True时,结果才为True | True and False结果为False |
| or | 逻辑或,只要有一个条件为True,结果就为True | True or False结果为True |
| not | 逻辑非,对条件的结果进行取反 | not True结果为False |
5. 位运算符
位运算符以二进制形式对数字进行操作,通过对二进制位的运算实现特定功能,在计算机底层操作、数据加密等领域应用频繁。
| & | 按位与,只有对应位都为1时,结果位才为1 | a & b结果为12(二进制0000 1100) |
| ` | ` | 按位或,只要对应位有一个为1,结果位就为1 |
| ^ | 按位异或,对应位不同时,结果位为1 | a ^ b结果为49(二进制0011 0001) |
| ~ | 按位取反,将二进制位中的0和1进行反转 | ~a结果为-61 |
| << | 左移,将二进制位向左移动指定的位数,低位补0 | a << 2结果为240(二进制1111 0000) |
| >> | 右移,将二进制位向右移动指定的位数 | a >> 2结果为15(二进制0000 1111) |
6. 成员运算符
成员运算符用于判断一个值是否属于某个序列,返回布尔类型的结果,在遍历和筛选数据时十分实用。
| in | 判断指定值是否存在于序列中 | my_list = [1, 2, 3, 4, 5]; 3 in my_list结果为True |
| not in | 判断指定值是否不存在于序列中 | my_list = [1, 2, 3, 4, 5]; 6 not in my_list结果为True |
7. 身份运算符
身份运算符用于判断两个对象是否引用自同一个对象,即是否在内存中占据相同的位置,同样返回布尔类型结果。
| is | 判断两个对象是否为同一个对象 | a = [1, 2, 3]; b = a; a is b结果为True |
| is not | 判断两个对象是否不是同一个对象 | a = [1, 2, 3]; c = [1, 2, 3]; a is not c结果为True |
8. 运算符优先级
当一个表达式中包含多个运算符时,Python 会依据既定的优先级规则来确定运算顺序。通常,乘除运算的优先级高于加减运算。合理使用括号可以改变运算的优先级,使表达式的逻辑更加清晰。
| 算术运算符 | ** > ~、+(正号)、-(负号) > *、/、%、// > +、- |
| 位运算符 | <<、>> > & > ^、` |
| 比较运算符 | ==、!=、>、<、>=、<= |
| 逻辑运算符 | not > and > or |
举例说明:
result = 3 + 5 * 2 # 先执行乘法,再执行加法,结果为13
result = (3 + 5) * 2 # 先执行括号内的加法,再执行乘法,结果为16
四、判断与循环
1.判断
if 语句
if语句是 Python 中最基本的条件判断结构,其作用是当指定条件为True时,执行相应的代码块。语法如下:
if condition:
# 条件为 True 时执行的代码块
pass
在上述代码中,condition是一个表达式,它的结果要么是True,要么是False。pass是占位符,当你暂时不想编写具体代码时,可以使用它。举个例子:
age = 18
if age >= 18:
print("你已成年")
if – else 语句
if – else语句用于在条件为True和False时,分别执行不同的代码块。语法如下:
if condition:
# 条件为 True 时执行的代码块
pass
else:
# 条件为 False 时执行的代码块
pass
沿用上面的例子,我们添加else分支:
age = 16
if age >= 18:
print("你已成年")
else:
print("你未成年")
if – elif – else 语句
if – elif – else语句用于多个条件的判断,会按顺序依次检查每个条件,一旦某个条件为True,就会执行对应的代码块,后续的条件将不再检查。语法如下:
if condition1:
# condition1 为 True 时执行的代码块
pass
elif condition2:
# condition2 为 True 时执行的代码块
pass
else:
# 所有条件都为 False 时执行的代码块
pass
假设我们要根据学生的成绩给出评级:
score = 85
if score >= 90:
print("A")
elif score >= 80:
print("B")
elif score >= 70:
print("C")
else:
print("D")
2. 循环语句
for 循环
for循环用于遍历可迭代对象,如列表、元组、字符串等。语法如下:
for item in iterable:
# 针对每个 item 执行的代码块
pass
遍历列表示例:
fruits = ["苹果", "香蕉", "橙子"]
for fruit in fruits:
print(fruit)
range()函数常与for循环搭配使用,生成一系列整数。例如,打印 0 到 4 的数字:
for i in range(5):
print(i)
while 循环
while循环会在指定条件为True时,重复执行代码块。语法如下:
while condition:
# 条件为 True 时执行的代码块
pass
比如,实现一个简单的倒计时:
count = 5
while count > 0:
print(count)
count -= 1
循环控制语句
break:用于立即终止循环,跳出整个循环体。例如,在遍历列表时,找到特定元素后终止循环:
nums = [1, 2, 3, 4, 5]
for num in nums:
if num == 3:
break
print(num)
continue:用于跳过当前循环的剩余代码,直接开始下一次循环。如,打印列表中的奇数:
nums = [1, 2, 3, 4, 5]
for num in nums:
if num % 2 == 0:
continue
print(num)
五、函数
(一)、函数基础
1. 定义函数
在 Python 中,使用def关键字定义函数,具体语法结构为def 函数名(参数列表): 函数体。下面以一个简单的加法函数为例:
def add(a, b):
return a + b
在这段代码里,add是函数名,它是函数的唯一标识,通过函数名可调用函数。a和b是参数,作为函数的输入数据,在函数被调用时,会接收外部传入的值。return语句用来返回函数的计算结果,将函数的处理结果反馈给调用者。
2. 调用函数
定义好函数后,就可以在代码的其他位置调用它。调用函数的方式是使用函数名,并在括号内传入相应参数。
result = add(3, 5)
print(result)
上述代码通过add(3, 5)的形式,将 3 和 5 作为参数传入add函数。程序会执行函数内部的代码,即计算a + b,然后返回计算结果,赋值给result变量,最后通过print函数输出结果。
(二)、函数参数
1. 默认参数
在定义函数时,可以为参数设置默认值。当调用函数时不传入该参数,函数会使用默认值。这在很多场景下都能简化函数调用,提高代码的灵活性。
def greet(name, message="Hello"):
print(f"{message}, {name}!")
greet("Alice")
greet("Bob", "Hi")
在上述代码中,message参数有默认值"Hello"。第一个调用greet(“Alice”)时,由于没有传入message参数,函数会使用默认的问候语"Hello";第二个调用greet(“Bob”, “Hi”)时,传入了新的问候语"Hi",函数会使用传入的值。
2. 可变参数
有时候,我们不确定会传入多少个参数,这时可以使用可变参数。可变参数有两种形式:*args和**kwargs。
*args用来收集多个位置参数,这些参数会被封装成一个元组。如下示例:
def print_args(*args):
for arg in args:
print(arg)
print_args(1, 2, 3)
**kwargs用来收集多个关键字参数,这些参数会被封装成一个字典,键为参数名,值为参数值。
def print_kwargs(**kwargs):
for key, value in kwargs.items():
print(f"{key}: {value}")
print_kwargs(name="Alice", age=25)
在实际开发中,这两种可变参数形式能让函数适应不同数量和类型的参数输入,增强函数的通用性。
(三)、匿名函数
Python 中的匿名函数,也叫lambda函数,通常用于定义简单的、一次性的函数。lambda 函数没有函数名,使用lambda关键字定义,后面跟着参数,冒号后面是返回值的表达式。
square = lambda x: x ** 2
print(square(4))
lambda 函数适用于一些简单的、不需要重复使用的函数场景。比如在sorted、map、filter等函数中作为参数。下面以sorted函数为例:
students = [
{"name": "Alice", "age": 20},
{"name": "Bob", "age": 18}
]
sorted_students = sorted(students, key=lambda item: item["age"])
print(sorted_students)
上述代码通过lambda item: item["age"]定义了排序的依据,让sorted函数按学生年龄对列表进行排序。
(四)、函数作为对象
在 Python 中,函数是一等公民,可以像其他数据类型一样进行传递、赋值和作为参数。这意味着函数可以被赋值给变量,作为参数传递给其他函数,甚至作为其他函数的返回值。
def operate(a, b, func):
return func(a, b)
def multiply(a, b):
return a * b
result = operate(3, 4, multiply)
print(result)
在operate函数中,func参数接收一个函数对象。通过这种方式,operate函数可以根据传入的不同函数,实现不同的运算逻辑,这为 Python 的函数式编程奠定了基础,使代码具备更高的灵活性和抽象性。
六、文件操作
(一)、文件操作基础
1. 打开文件
在 Python 里,借助open()函数打开文件。其最基本的语法是open(文件名name, 打开模式mode),打开模式决定了对文件的操作权限。
file = open('example.txt', 'r')
上述代码以只读模式(r)打开名为example.txt的文件。r表示只能读取文件内容,不能修改文件。其他常用的打开模式还有w(写入模式,会覆盖原有内容)、a(追加模式,在文件末尾添加内容)。
2. 读取文件
文件打开后,就可以读取文件内容。read()方法用于读取整个文件,readline()方法每次读取一行。
file = open('example.txt', 'r')
content = file.read()
print(content)
file.seek(0) # 将文件指针移到文件开头
line = file.readline()
print(line)
file.close()
seek(0)方法把文件指针移到文件开头,以便再次读取文件。使用完文件后,务必调用close()方法关闭文件,防止资源泄露。
3. 写入文件
若要写入文件,可使用write()方法。下面以写入模式打开文件,并写入内容:
file = open('example.txt', 'w')
file.write('这是新写入的内容')
file.close()
若使用追加模式a,新内容会添加到文件末尾,而不会覆盖原有内容。
(二)、上下文管理器
频繁地打开和关闭文件不仅繁琐,还容易引发错误。Python 的with语句能有效解决这一问题。
with open('example.txt', 'r') as file:
content = file.read()
print(content)
使用with语句时,文件会在代码块执行完毕后自动关闭,即便代码块中发生异常,也能确保文件正确关闭,极大地简化了代码,提高了代码的安全性。
(三)、二进制文件操作
除了文本文件,Python 也能处理二进制文件,如图片、音频、视频等。以读取和写入图片文件为例:
with open('image.jpg', 'rb') as input_file:
with open('new_image.jpg', 'wb') as output_file:
data = input_file.read()
output_file.write(data)
rb表示以二进制只读模式打开文件,wb表示以二进制写入模式打开文件。在处理二进制文件时,务必使用二进制模式,防止数据损坏。
七、模块导入与应用
1.Numpy:数值计算的基石
Numpy 是 Python 科学计算的基础库,它提供了高性能的多维数组对象,以及用于处理这些数组的工具。无论是简单的数学运算,还是复杂的机器学习算法,Numpy 都是不可或缺的工具。
1.1 安装 Numpy
如果你使用的是 Anaconda,那么可以在终端中使用如下命令进行安装:
conda install numpy
若你没有安装 Anaconda,也可以使用 pip 进行安装:
pip install numpy
1.2 导入 Numpy
在 Python 脚本或交互式环境中,通常使用如下方式导入 Numpy:
import numpy as np
这种导入方式,让np成为numpy的别名,后续使用 Numpy 功能时,调用np即可,极大提高代码的简洁性。比如创建一个一维数组:
arr = np.array([1, 2, 3, 4, 5])
print(arr)
2.Pandas:数据处理的利器
Pandas 是专门用于数据处理和分析的库,它提供了快速、灵活、明确的数据结构,旨在简单、直观地处理关系型、标记型数据。
2.1安装 Pandas
使用 Anaconda 安装 Pandas,在终端输入:
conda install pandas
使用 pip 安装的命令如下:
pip install pandas
2.2 导入 Pandas
在 Python 代码中,常用如下方式导入 Pandas:
import pandas as pd
以读取 CSV 文件为例,展示 Pandas 的基本用法:
data = pd.read_csv('example.csv')
print(data.head())
3.Matplotlib:数据可视化大师
Matplotlib 是 Python 中最常用的数据可视化库,它能帮助我们将数据以各种图表的形式呈现出来,让数据更加直观易懂。
3.1 安装 Matplotlib
通过 Anaconda 安装:
conda install matplotlib
使用 pip 安装:
pip install matplotlib
3.2 导入 Matplotlib
在 Python 脚本中,通常这样导入 Matplotlib 的pyplot模块:
import matplotlib.pyplot as plt
下面通过一个简单的示例,绘制一条折线图:
import numpy as np
import matplotlib.pyplot as plt
x = np.linspace(0, 10, 100)
y = np.sin(x)
plt.plot(x, y)
plt.show()
4. 多模块协同使用
在实际的数据分析项目中,这三个模块通常会协同工作。下面通过一个综合案例,展示它们如何配合完成一个简单的数据分析任务。
案例:分析学生成绩数据
假设有一份学生成绩的 CSV 文件,包含学生姓名、各科成绩等信息。我们将使用 Pandas 读取数据,Numpy 进行数据计算,Matplotlib 绘制成绩分布图表。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
# 读取数据
data = pd.read_csv('scores.csv')
# 计算平均成绩
data['Average'] = np.mean(data[['Math', 'Science', 'English']], axis = 1)
# 绘制平均成绩分布直方图
plt.hist(data['Average'], bins = 10, edgecolor = 'black')
plt.xlabel('Average Score')
plt.ylabel('Number of Students')
plt.title('Distribution of Average Scores')
plt.show()
使用 pip 安装:
```python
pip install matplotlib
3.2 导入 Matplotlib
在 Python 脚本中,通常这样导入 Matplotlib 的pyplot模块:
import matplotlib.pyplot as plt
下面通过一个简单的示例,绘制一条折线图:
import numpy as np
import matplotlib.pyplot as plt
x = np.linspace(0, 10, 100)
y = np.sin(x)
plt.plot(x, y)
plt.show()
4. 多模块协同使用
在实际的数据分析项目中,这三个模块通常会协同工作。下面通过一个综合案例,展示它们如何配合完成一个简单的数据分析任务。
案例:分析学生成绩数据
假设有一份学生成绩的 CSV 文件,包含学生姓名、各科成绩等信息。我们将使用 Pandas 读取数据,Numpy 进行数据计算,Matplotlib 绘制成绩分布图表。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
# 读取数据
data = pd.read_csv('scores.csv')
# 计算平均成绩
data['Average'] = np.mean(data[['Math', 'Science', 'English']], axis = 1)
# 绘制平均成绩分布直方图
plt.hist(data['Average'], bins = 10, edgecolor = 'black')
plt.xlabel('Average Score')
plt.ylabel('Number of Students')
plt.title('Distribution of Average Scores')
plt.show()