前言
随着大语言模型进入产业落地深水区,模型幻觉、知识滞后、无法使用私有数据、微调成本过高成为制约 AI 应用的四大核心痛点。传统大模型仅依靠预训练知识进行回答,无法实时对接企业内部文档、业务数据、专业知识库,且极易出现编造答案的情况;而模型微调需要大量数据、算力与时间,知识更新一次就要重新训练,难以满足实际业务的快速迭代需求。
在此背景下,RAG(检索增强生成) 技术凭借轻量化、低成本、高可控、易更新的特性,迅速成为大模型落地最主流、最实用的解决方案,广泛应用于智能客服、企业知识库、法律医疗、政务服务等场景,成为每一位 AI 开发者与工程人员必须掌握的核心技术。
一、什么是 RAG
RAG 全称 Retrieval-Augmented Generation,中文译为检索增强生成。
简单来说,RAG 是一种外挂式知识增强架构,它不修改大模型本身的参数,而是在模型生成答案之前,先从外部私有知识库中检索出与问题相关的真实资料,再将这些资料作为参考上下文,交给大模型进行精准回答。
可以理解为:让大模型实现 “开卷考试”,只依据给定资料作答,不再凭空想象。
RAG 的核心作用:连接大模型与私有数据、消除幻觉、更新知识、保障回答准确性。
二、RAG 的核心原理
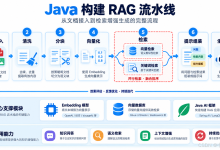
RAG 整体流程分为两大阶段:离线构建向量库、在线检索问答,下面结合《员工手册》实例,完整演示每一步细节。
2.1 RAG 整体工作流程
2.2 实例演示:基于员工手册的 RAG 全流程
(1)离线阶段:构建私有知识库(仅执行一次)
步骤 1:准备原始文档
plaintext
1. 公司上班时间为周一到周五,9:00–18:00,午休1小时。
2. 员工每年可享受5天带薪年假,入职满一年后生效。
3. 加班需要提前申请,经部门经理审批通过后才算有效加班。
步骤 2:文本分块(Chunk)将长文档切分成短文本片段,保证语义完整,提升检索精度。
步骤 3:向量化(核心步骤)使用向量模型(m3e-base/BGE 等),将每一段文本转为固定维度的浮点数数组,即向量数据。
plaintext
段落1 → 向量1:[0.12, -0.34, 0.56, …](768维)
段落2 → 向量2:[0.56, -0.78, 0.90, …](768维)
段落3 → 向量3:[-0.23, 0.45, -0.67, …](768维)
步骤 4:存入向量数据库将原文 + 向量一并存储,支持高速相似度检索。
(2)在线阶段:用户提问 → 检索 → 生成答案
用户问题:我年假有几天?
步骤 1:问题向量化使用同一个向量模型将问题转为查询向量。
步骤 2:向量相似度检索系统自动计算距离,找出最相关的文本段落:
plaintext
员工每年可享受5天带薪年假,入职满一年后生效。
步骤 3:构造 Prompt 送入大模型
plaintext
请根据以下资料回答问题,严禁编造信息。
参考资料:员工每年可享受5天带薪年假,入职满一年后生效。
用户问题:我年假有几天?
步骤 4:大模型输出答案
plaintext
你每年可享受5天带薪年假,需要在入职满一年后开始生效。
2.3 RAG 与大模型的交互关系
- 向量模型:负责文本→向量的语义转换
- 向量数据库:负责存储与高速匹配检索
- 大模型:负责理解意图、整合资料、生成流畅回答
RAG = 精准检索 + 可靠生成,大模型只负责 “生成”,不负责 “记忆私有知识”。
三、RAG 能带来什么价值
彻底解决大模型幻觉问题回答严格基于外部资料,不编造、不虚构,大幅提高可信度。
低成本接入私有数据无需训练、无需微调,PDF、Word、Excel、Txt 等格式均可直接接入,几分钟搭建专属知识库。
知识实时更新新增 / 修改文档后,重新向量化入库即可,支持动态维护,无需重新训练模型。
数据安全与合规可控支持私有化部署,数据不出内网,不泄露给第三方大模型,满足企业与政务合规要求。
通用性极强、落地门槛低适用于企业问答、法律文书、金融研报、医疗资料、教育题库、代码文档等几乎所有文本场景。
四、RAG 的工程化应用
RAG 已经是大模型产业落地的标配技术,主流应用场景包括:
企业智能问答助手对接员工手册、规章制度、产品文档、运维手册,实现 7×24 小时自动答疑。
法律 / 金融 / 医疗专业知识库基于合同条款、裁判文书、研报、病历、药典等专业资料,提供高精准专业回答。
智能客服与售后机器人对接商品手册、售后政策、物流规则,提供标准化、高一致性回答。
教育与学术辅助工具对接教材、论文、题库,实现知识点检索、智能答疑、内容总结。
政务与事业单位问答系统基于政策文件、办事指南、流程规范,提供合规、统一的政务咨询服务。
AI 智能体(Agent)知识底座为自主 AI 智能体提供外部知识支持,提升决策准确性与业务能力。
五、RAG 生态最新现状
截至 2026 年,RAG 已从基础版演进为高级 RAG、模块化 RAG、自适应 RAG,生态极度成熟:
向量模型(Embedding)国内开源主流:m3e、BGE-zh、text2vec(中文效果最优)云端 API:OpenAI Ada、阿里云、腾讯云、百度智能云向量服务
向量数据库开源轻量:FAISS、Chroma企业级:Milvus、Weaviate云服务:各大云厂商向量引擎
开发框架与低代码平台LangChain、LlamaIndex、Dify、FastGPT,支持可视化搭建、一键部署。
技术演进方向
- 多路召回 + 重排序(Rerank)
- 混合检索(向量 + 关键词)
- 自适应分块、多模态 RAG(文本 / 图片 / 音频)
- RAG + Agent 深度融合
六、总结
RAG(检索增强生成)是当前大模型落地最实用、最高效的解决方案,它通过 “外部检索 + 增强生成” 的轻量化架构,完美解决模型幻觉、知识滞后、私有数据对接等核心问题。
从原理上看,RAG 的核心就是:文档向量化、向量检索、大模型生成三大步骤;从价值上看,它具备低成本、易更新、高可控、高安全的优势;从生态上看,RAG 工具链成熟、落地门槛极低,是 AI 开发者必备技能。
未来,RAG 将持续作为大模型产业化的核心底座,与 Agent、多模态、知识图谱深度融合,拥有极高的学习与应用价值。