快速体验
创建一个Apache Flink流处理应用,从Kafka读取JSON格式的用户行为数据,计算每5分钟的页面访问量TopN,并将结果写入MySQL数据库。要求包含:1) Kafka消费者配置 2) JSON解析逻辑 3) 滑动窗口处理 4) TopN聚合计算 5) JDBC Sink实现。使用Java语言,给出完整可运行的代码。
如何用AI加速Flink流处理应用开发
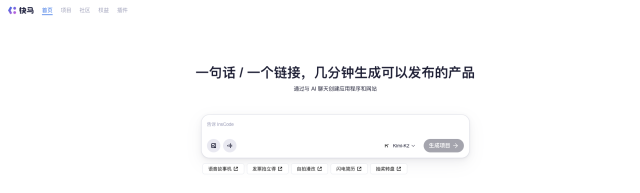
最近在做一个用户行为分析的需求,需要实时统计每5分钟最热门的页面访问量。传统方式从零开始写Flink应用要花不少时间,但这次尝试用InsCode(快马)平台的AI辅助功能后,开发效率提升了不少。下面分享下具体实现过程和经验。
整体架构设计
这个流处理应用需要完成几个关键步骤:
关键实现步骤
1. Kafka消费者配置
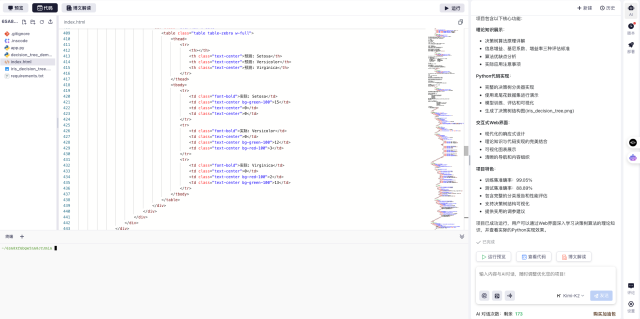
首先需要设置Kafka连接参数。在快马平台的AI对话区,我直接描述了需求:"帮我生成一个连接Kafka的Flink Java代码,主题是user_behavior,消费组是flink_consumer"。AI很快给出了包含bootstrap.servers、反序列化器等完整配置的代码片段。
2. JSON数据解析
用户行为数据是JSON格式,包含userId、pageId、timestamp等字段。通过告诉AI"需要解析包含xxx字段的JSON字符串",它生成了使用Flink JSON反序列化器的代码,还自动处理了可能的数据格式异常。
3. 窗口计算设置
这里需要5分钟的滑动窗口,每1分钟滑动一次。我输入"Flink滑动窗口5分钟步长1分钟"后,AI不仅给出了窗口配置代码,还解释了这种配置下窗口重叠的计算逻辑,帮助我理解数据会被如何处理。
4. TopN聚合实现
统计TopN页面是个关键点。AI建议先按窗口和pageId分组计数,再用窗口函数排序取前N条。当我询问"如何优化TopN性能"时,它还给出了使用状态后端和适当调整并行度的建议。
5. 结果写入MySQL
最后一步配置JDBC Sink时,AI生成了包含连接池、批量写入和错误处理的完整实现。我特别满意的是它自动添加了"ON DUPLICATE KEY UPDATE"语句来处理可能的重复数据。
开发体验优化
整个开发过程中有几个效率提升点:
部署与测试
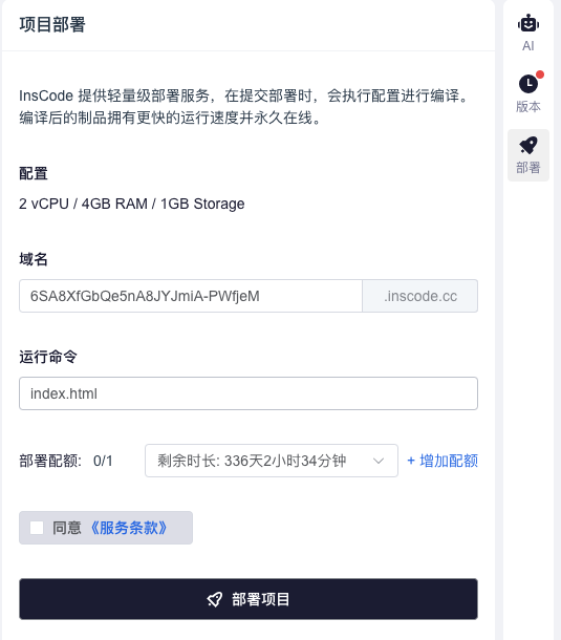
在InsCode(快马)平台上一键部署后,我模拟了一些测试数据发送到Kafka,通过平台内置的实时预览功能,可以直观看到处理结果是否正确。这种即时验证的方式比本地调试方便很多。
经验总结
这次体验让我感受到AI辅助开发的效率优势,特别是对于Flink这种需要较多样板代码的框架。如果你也在做实时计算相关开发,不妨试试在InsCode(快马)平台上用AI加速开发流程,从环境搭建到代码生成都能节省大量时间。
快速体验
创建一个Apache Flink流处理应用,从Kafka读取JSON格式的用户行为数据,计算每5分钟的页面访问量TopN,并将结果写入MySQL数据库。要求包含:1) Kafka消费者配置 2) JSON解析逻辑 3) 滑动窗口处理 4) TopN聚合计算 5) JDBC Sink实现。使用Java语言,给出完整可运行的代码。