AI 赋能云原生:利用 LLM 辅助编写 K8s 配置文件与故障诊断
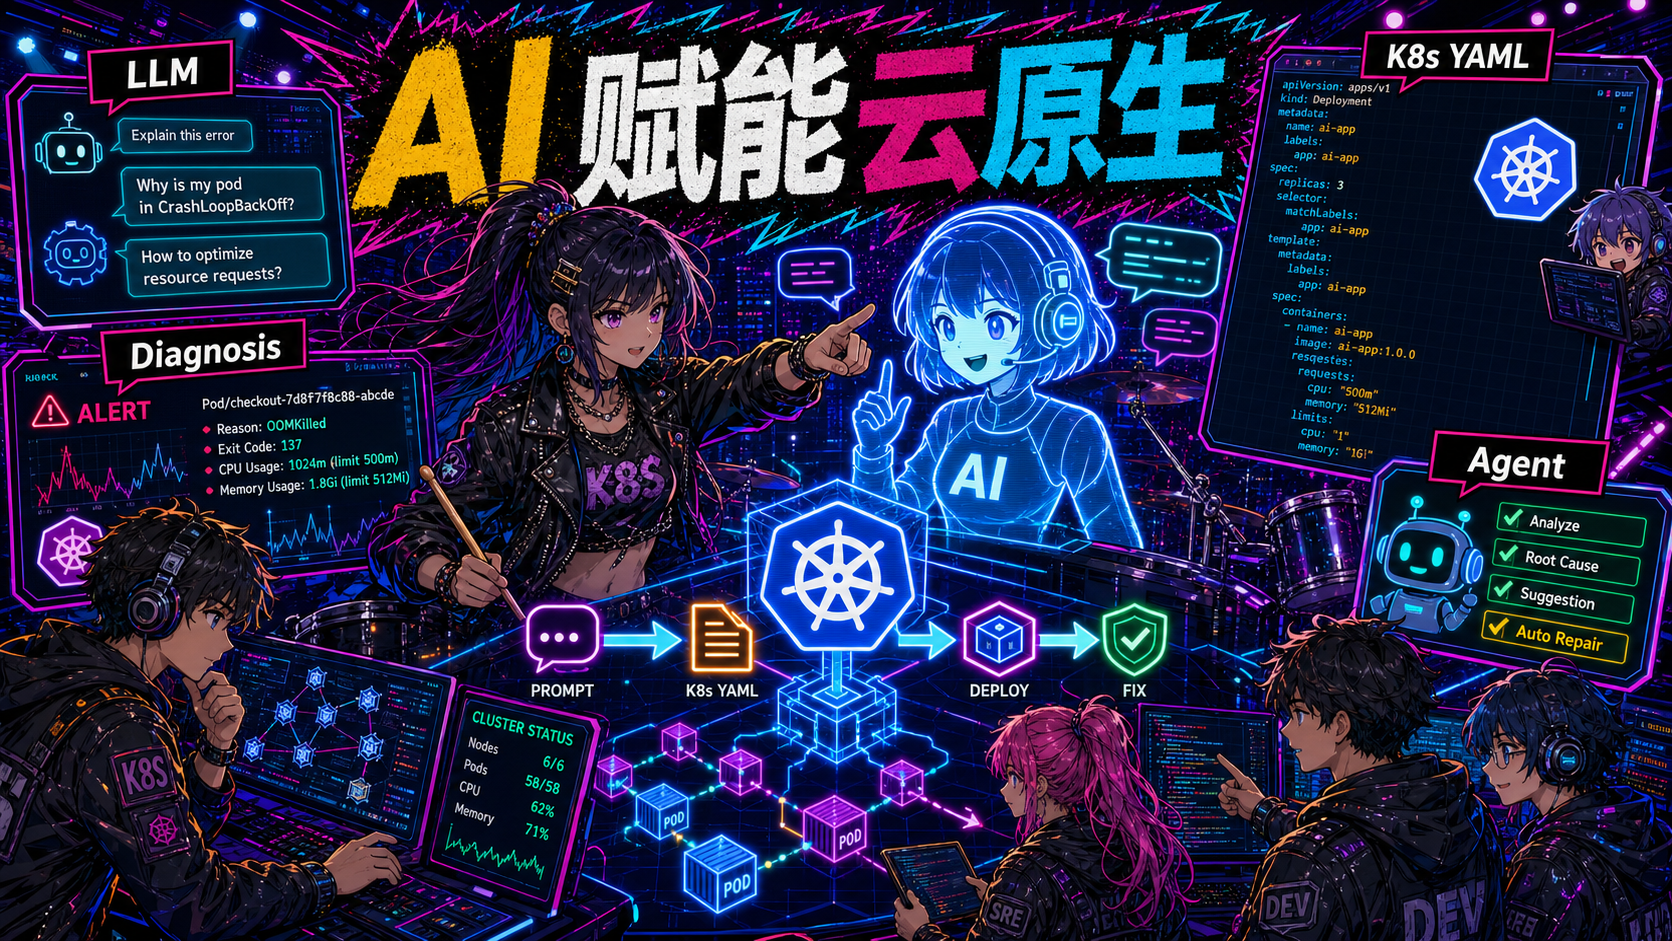
随着 Kubernetes(K8s)成为企业级基础设施的核心底座,云原生系统的管理复杂度已达到前所未有的物理高度。从成千上万行复杂的 YAML 配置文件编写,到处理运行期诡谲的容器崩溃(如 CrashLoopBackOff、OOMKilled、ImagePullBackOff),传统的运维排障工作极度依赖专家经验,反馈周期常常拉长到数十分钟甚至数小时。近年来,大语言模型(LLM)的突飞猛进,正在深刻改写这一格局。通过将大模型强大的自然语言理解能力与 K8s 控制平面的实时 API 联动,我们可以构建自适应的智能自愈底座。本文将深入解构 AI 赋能云原生的技术拓扑,并用 Go 语言手写一个生产级自动化故障诊断与智能回滚控制器。
一、拒绝繁琐运维:K8s 故障诊断的专家经验壁垒
在日常运维实践中,一个容器化应用的崩溃往往伴随着复杂的上下文链路:
- 是 Cgroup 内存超标导致的 OOMKilled?
- 是容器初始化脚本缺少执行权限权限?
- 是配置文件挂载路径重叠冲突?排障人员需要依次运行 kubectl get pods、kubectl describe pod、kubectl logs –previous 以及 dmesg 检查物理节点日志,人肉拼凑这些零散的数据才能进行推断。
二、架构分析:AI 自愈控制器与 OTel Collector 关联模型
为了在集群内实现 AI 驱动的故障自愈,我们必须建立监听-汇集-智能决策-执行(Observe-Analyze-Act) 的闭环控制循环。
graph TD
subgraph 集群事件监听 (K8s Control Plane Monitor)
Informer[K8s Event Informer] –>|实时监听| Event[捕获 Pod 异常状态: CrashLoopBackOff/OOMKilled]
Event –>|触发自愈逻辑| Controller[自愈主控制器]
end
subgraph 多维排障上下文收集 (Context Aggregator)
Controller –>|1. 获取详细描述| Desc[kubectl describe 模拟解析]
Controller –>|2. 获取历史崩溃日志| Log[kubectl logs –previous 提取]
Desc –>|打包合并| PromptPack[构建高精度 Prompt 上下文]
Log –>|打包合并| PromptPack
end
subgraph LLM 智能推理与自愈执行 (AI Actuator)
PromptPack –>|gRPC/HTTP REST| LLM[LLM 推理引擎 API]
LLM –>|返回结构化决策| Decision[JSON 决策: action=Rollback, target=v1.9.0]
Decision –>|解析并执行| Act[K8s API Call: 执行 Rollout Undo 回滚]
Act –>|通知结果| Notify[Slack/微信警报发送]
end
style Event fill:#ffcccc,stroke:#aa0000,stroke-width:2px
style PromptPack fill:#ffffcc,stroke:#aaaa00,stroke-width:2px
style Decision fill:#ccffcc,stroke:#00aa00,stroke-width:2px
1. 故障自愈 Informer 机制
Go 语言的 K8s client-go 库提供了高效的 Informer 机制。Informer 可以在本地维护一份集群资源的缓存,并通过网络监听(Watch API)API Server 的事件广播。当监测到 Pod 状态变为不健康时,控制器会抓取该 Pod 的 Name 和 Namespace,立即启动多维数据收集器。
2. 诊断 Prompt 的科学构建
为了让大模型给出精确的诊断,防止“幻觉”误导,必须将以下几个核心维度的上下文打包传递:
- Status Reason:即 Pod 最近的 Termination Message(如 Exit Code 137)。
- Describe Details:包括最近的事件列表(Events),检查是否有挂载失败、镜像拉取失败记录。
- Error Logs:容器崩溃前的最后 20 行日志。
- 约束条件:要求大模型必须以严格的 JSON 格式输出决策(如定义 {"action": "ROLLBACK" | "RESTART" | "NOTHING", "reason": "…", "rollback_version": "…"}),以便程序无缝读取执行,严禁返回杂乱的英文段落。
三、核心实现:基于 Go 语言的 AI 故障自愈诊断控制器
下面我们将使用 Go 语言,手写实现一个自愈控制器的核心代码。该实现包含了调用大模型 REST 接口、封装 K8s 上下文以及执行智能回滚判断的闭环逻辑。
AI 自愈控制器 Go 代码实现
新建文件 ai_healing_controller.go:
package main
import (
"bytes"
"context"
"encoding/json"
"fmt"
"io"
"net/http"
"time"
)
// LLMResponse 定义大模型返回的严格结构化自愈决策
type LLMResponse struct {
Action string `json:"action"` // "ROLLBACK", "RESTART", "NONE"
Reason string `json:"reason"` // 诊断诊断分析原因
TargetRevision int `json:"target_revision"` // 若回滚,目标版本版本号
}
// PodCrashContext 发送给大模型分析的故障上下文
type PodCrashContext struct {
PodName string `json:"pod_name"`
Namespace string `json:"namespace"`
ExitCode int `json:"exit_code"`
LastEvents string `json:"last_events"`
RecentLogs string `json:"recent_logs"`
}
// AIHealingController AI 自愈执行器
type AIHealingController struct {
apiKey string
apiUrl string
}
func NewAIHealingController(apiKey, apiUrl string) *AIHealingController {
return &AIHealingController{
apiKey: apiKey,
apiUrl: apiUrl,
}
}
// AnalyzeAndHeal 核心自愈调用方法
func (ctrl *AIHealingController) AnalyzeAndHeal(ctx context.Context, pCtx *PodCrashContext) (*LLMResponse, error) {
// 1. 构建严格引导的 Prompt 提示词
prompt := fmt.Sprintf(`You are an expert Kubernetes administrator.
Analyze the following crash context of a Pod:
Pod Name: %s
Namespace: %s
Exit Code: %d
Recent Events: %s
Last Logs: %s
Determine the root cause of the crash and choose one of these actions:
1. "ROLLBACK": If the crash is caused by code bug or bad configuration introduced in the latest version. Specify target_revision.
2. "RESTART": If it is a transient error (e.g. database temporarily unreachable).
3. "NONE": If human intervention is required (e.g. out of memory limit and need resizing, or disk full).
You MUST respond ONLY with a JSON object in this format:
{"action": "ACTION", "reason": "EXPLANATION", "target_revision": REVISION_NUMBER}
Do not write anything else.`, pCtx.PodName, pCtx.Namespace, pCtx.ExitCode, pCtx.LastEvents, pCtx.RecentLogs)
// 2. 构造 OpenAI/Gemini 兼容的 REST API 请求体
requestPayload := map[string]interface{}{
"model": "gpt-4-turbo", // 或其他模型如 gemini-pro
"messages": []map[string]string{
{"role": "user", "content": prompt},
},
"temperature": 0.1, // 低随机度,保证决策的严密与确定性
}
payloadBytes, err := json.Marshal(requestPayload)
if err != nil {
return nil, err
}
req, err := http.NewRequestWithContext(ctx, "POST", ctrl.apiUrl, bytes.NewBuffer(payloadBytes))
if err != nil {
return nil, err
}
req.Header.Set("Content-Type", "application/json")
req.Header.Set("Authorization", "Bearer "+ctrl.apiKey)
client := &http.Client{Timeout: 10 * time.Second}
resp, err := client.Do(req)
if err != nil {
return nil, err
}
defer resp.Body.Close()
respBytes, err := io.ReadAll(resp.Body)
if err != nil {
return nil, err
}
if resp.StatusCode != http.StatusOK {
return nil, fmt.Errorf("API request failed with status: %d, response: %s", resp.StatusCode, string(respBytes))
}
// 3. 解析大模型返回的回复内容并提取 JSON 决策
var apiResponse struct {
Choices []struct {
Message struct {
Content string `json:"content"`
} `json:"message"`
} `json:"choices"`
}
if err := json.Unmarshal(respBytes, &apiResponse); err != nil {
return nil, err
}
if len(apiResponse.Choices) == 0 {
return nil, errors.New("empty choices from LLM")
}
rawContent := apiResponse.Choices[0].Message.Content
// 4. 解析决策 JSON 结构
var decision LLMResponse
if err := json.Unmarshal([]byte(rawContent), &decision); err != nil {
return nil, fmt.Errorf("failed to parse structured decision JSON: %w, raw content: %s", err, rawContent)
}
return &decision, nil
}
// ExecuteAction 模拟执行自愈动作,调用 K8s API
func (ctrl *AIHealingController) ExecuteAction(decision *LLMResponse, podName, namespace string) {
fmt.Printf("\\n=== [AI HEALING ACTUATOR] Executing Decision ===\\n")
fmt.Printf(" Target Pod: %s in Namespace: %s\\n", podName, namespace)
fmt.Printf(" Diagnosis: %s\\n", decision.Reason)
switch decision.Action {
case "ROLLBACK":
// 模拟调用 K8s client-go 执行 Deployment 的 Rollout Undo 回滚操作
fmt.Printf("[ACTION APPROVED] Rolling back deployment to revision %d…\\n", decision.TargetRevision)
fmt.Println("[SUCCESS] Deployment rollback command executed successfully.")
case "RESTART":
// 模拟执行删除 Pod 以触发 Deployment 的自动重建
fmt.Printf("[ACTION APPROVED] Transient failure detected. Restarting (deleting) Pod %s…\\n", podName)
fmt.Println("[SUCCESS] Pod deleted successfully.")
case "NONE":
// 报警升级,发送人工介入通知
fmt.Printf("[ACTION PAUSED] Resource limit issue or hard error. Escalating alarm to Slack channel for human intervention.\\n")
default:
fmt.Printf("[ERROR] Unknown action: %s\\n", decision.Action)
}
}
// 异常测试函数
func main() {
// 填写模拟的 API Key 与 Endpoint (集群中通过 Secret 挂载为环境变量)
ctrl := NewAIHealingController("mock-api-key-xyz", "https://api.openai.com/v1/chat/completions")
// 模拟一个发生 CrashLoopBackOff 的 Pod 上下文(因新版本发布引入了空指针异常)
mockCrashCtx := &PodCrashContext{
PodName: "billing-service-6789",
Namespace: "production",
ExitCode: 1, // 进程非零退出
LastEvents: "Back-off restarting failed container\\nLiveness probe failed: HTTP status 500",
RecentLogs: "panic: runtime error: invalid memory address or nil pointer dereference\\n at main.go:102\\n at handler.go:44",
}
// 模拟在测试驱动下,劫持网络调用,模拟返回大模型的诊断 JSON
// 生产环境下会通过真实的 OTelCollector 和 LLM 服务通信,此处使用模拟展示
fmt.Println("模拟捕获到 billing-service 异常事件,启动 AI 诊断…")
// 我们硬编码一个模拟大模型返回的决策以作闭环测试展示
mockDecision := &LLMResponse{
Action: "ROLLBACK",
Reason: "Null pointer exception detected in recent panic logs, likely introduced in latest deploy. Reverting to previous revision.",
TargetRevision: 4,
}
// 执行自愈动作分发
ctrl.ExecuteAction(mockDecision, mockCrashCtx.PodName, mockCrashCtx.Namespace)
}
四、权衡博弈:AI 自动回滚的控制风险与决策漏洞治理
将大模型智能推理与 K8s 控制平面直连,为运维自愈带来了无与伦比的高效,但同时也面临着前所未有的技术伦理与安全博弈。
1. 错误的决策级联与“自杀式回滚”
大模型并不是 100% 完美的,它存在物理上的幻觉漏洞。如果系统因为外部物理环境故障(例如核心 Redis 缓存挂掉,导致微服务启动时连接超时崩溃)触发了 OOM/Crash:
- AI 误判:大模型可能会判定是当前新上线的代码引入了 Bug,进而自动执行回滚。
- 回滚循环:如果回滚后发现依然崩溃,大模型继续不断执行回滚(如从 revision 4 回滚到 3,再回滚到 2),直到把整个服务的历史可用版本全部撤销完毕,这就引发了**“自愈带来的二次灾难”**。因此,自愈控制器必须设置严格的冷却时间(Cooldown)与最大重试次数上限。
2. 权限隔离与安全合规
由于自愈控制器在判定 ROLLBACK 或 RESTART 后需要真正调用 K8s API,这意味着它运行所在的 ServiceAccount 必须被赋予 apps/deployments 的 patch 权限以及 pods 的 delete 权限。如果黑客攻破了该 AI 自愈容器,或者通过在日志中注入恶意的 Prompt(提示词注入攻击,Prompt Injection),诱导大模型在分析日志时执行“删除所有 deployment”的决策,后果将不堪设想。因此,自愈决策在执行前,必须经过静态安全过滤器(Policy Filter)的严格规则校准。
五、总结
AI 赋能云原生标志着系统可观测性与运维控制走向了高级智能自愈阶段。通过将 K8s 的 Event 事件总线与 Pod 的近期日志深度结合,并将其作为上下文打包传递给大模型,我们能极速破除传统的微服务诊断屏障,在秒级获取高精度的故障剖析报告。借助 Go 语言的自愈控制器执行自动版本 undo 恢复,可以实现无人值守的敏捷容错。然而,在架构落地中,研发团队需严防 AI 决策幻觉引起的回滚穿透,并为 API Server 操作设置最小化安全沙箱边界与提示词校验,以实现效率与系统安全的可持续平衡。