目录
- 1. 环境准备
- 2. 数据处理与清洗
-
- 2.1 导入数据
- 2.2 数据清洗
-
- 示例:处理缺失值
- 示例:处理异常值
- 2.3 数据转换
- 3. 数据分析
-
- 3.1 描述性统计
- 3.2 分组分析
-
- 示例:按年龄分组计算工资的平均值
- 3.3 时间序列分析
- 4. 数据可视化
-
- 4.1 基本绘图
-
- 示例:柱状图
- 4.2 使用 Seaborn 绘制图表
-
- 示例:箱型图
- 4.3 高级可视化技巧
-
- 示例:热力图
- 5. 案例研究
-
- 案例:销售数据分析
-
- 步骤 1:数据导入与预处理
- 步骤 2:数据分析
- 步骤 3:数据可视化
- 总结
Python 是数据分析与可视化领域中最受欢迎的编程语言之一。凭借其丰富的库和工具,Python 能够帮助我们快速处理、分析数据并生成高质量的可视化图表。本文将详细介绍 Python 中的数据分析与可视化的基础知识,并结合丰富的示例和技巧,帮助读者深入理解这些概念。
1. 环境准备
在开始之前,我们需要确保安装了必要的 Python 库。常用的库包括:
- pandas:用于数据处理和分析。
- numpy:用于数值计算。
- matplotlib:用于基本绘图。
- seaborn:基于 matplotlib 的高级可视化库。
- scikit-learn:用于机器学习模型和数据预处理。
可以使用以下命令安装这些库:
pip install pandas numpy matplotlib seaborn scikit-learn
2. 数据处理与清洗
数据处理是数据分析的重要一步。我们将使用 pandas 来处理数据。以下是一些常用操作。
2.1 导入数据
假设我们有一个 CSV 文件 data.csv,内容如下:
| Alice | 30 | 70000 |
| Bob | 25 | 48000 |
| Carol | 27 | 52000 |
| Dave | NaN | 60000 |
| Eve | 22 | NaN |
我们可以使用 pandas 导入这个数据:
import pandas as pd
# 导入 CSV 文件
data = pd.read_csv('data.csv')
print(data)
输出:
Name Age Salary
0 Alice 30.0 70000.0
1 Bob 25.0 48000.0
2 Carol 27.0 52000.0
3 Dave NaN 60000.0
4 Eve 22.0 NaN
2.2 数据清洗
在分析数据之前,我们需要处理缺失值和异常值。
示例:处理缺失值
# 显示缺失值
print(data.isnull().sum())
输出:
Name 0
Age 1
Salary 1
dtype: int64
# 填充缺失值
data['Age'].fillna(data['Age'].mean(), inplace=True) # 用平均值填充年龄
data['Salary'].fillna(data['Salary'].median(), inplace=True) # 用中位数填充工资
print(data)
输出:
Name Age Salary
0 Alice 30.0 70000.0
1 Bob 25.0 48000.0
2 Carol 27.0 52000.0
3 Dave 26.0 60000.0
4 Eve 22.0 56000.0
示例:处理异常值
# 识别异常值
q1 = data['Salary'].quantile(0.25)
q3 = data['Salary'].quantile(0.75)
iqr = q3 – q1
# 确定异常值
outliers = data[(data['Salary'] < (q1 – 1.5 * iqr)) | (data['Salary'] > (q3 + 1.5 * iqr))]
print("异常值:\\n", outliers)
# 移除异常值
data = data[~data['Salary'].isin(outliers['Salary'])]
输出:
异常值:
Empty DataFrame
Columns: [Name, Age, Salary]
Index: []
2.3 数据转换
数据转换可以帮助我们将数据调整为适合分析的格式。例如,我们可能需要将某些列的数据类型转换为适当的格式。
# 将年龄转换为整数类型
data['Age'] = data['Age'].astype(int)
3. 数据分析
数据分析可以帮助我们发现数据中的趋势和模式。我们可以使用 pandas 的一些函数进行基本的统计分析。
3.1 描述性统计
# 获取数据的基本统计信息
statistics = data.describe()
print(statistics)
输出:
Age Salary
count 5.000000 5.000000
mean 26.000000 57200.000000
std 2.915476 8438.009244
min 22.000000 48000.000000
25% 25.000000 52000.000000
50% 26.000000 56000.000000
75% 27.000000 60000.000000
max 30.000000 70000.000000
3.2 分组分析
根据不同条件进行分组,并计算相关统计量。
示例:按年龄分组计算工资的平均值
# 按年龄分组并计算工资的平均值
grouped_data = data.groupby('Age')['Salary'].mean().reset_index()
print(grouped_data)
输出:
Age Salary
0 22 56000.0
1 25 48000.0
2 26 60000.0
3 27 52000.0
4 30 70000.0
3.3 时间序列分析
如果我们的数据包含时间戳,可以进行时间序列分析。这在销售数据、股票市场等领域特别有用。
# 假设有一个包含日期的 DataFrame
data['Date'] = pd.date_range(start='1/1/2020', periods=len(data), freq='M')
# 设置日期为索引
data.set_index('Date', inplace=True)
# 按月汇总数据
monthly_data = data.resample('M').sum()
print(monthly_data)
输出:
Name Age Salary
Date
2020-01-31 Alice 30 70000.0
2020-02-29 Bob 25 48000.0
2020-03-31 Carol 27 52000.0
2020-04-30 Dave 26 60000.0
2020-05-31 Eve 22 56000.0
4. 数据可视化
数据可视化能够直观展示数据分析的结果。我们将使用 matplotlib 和 seaborn 创建各种图表。
4.1 基本绘图
示例:柱状图
import matplotlib.pyplot as plt
# 绘制柱状图
plt.figure(figsize=(10, 6))
plt.bar(data['Name'], data['Salary'], color='skyblue')
plt.title('Salary by Name')
plt.xlabel('Name')
plt.ylabel('Salary')
plt.show()
输出: 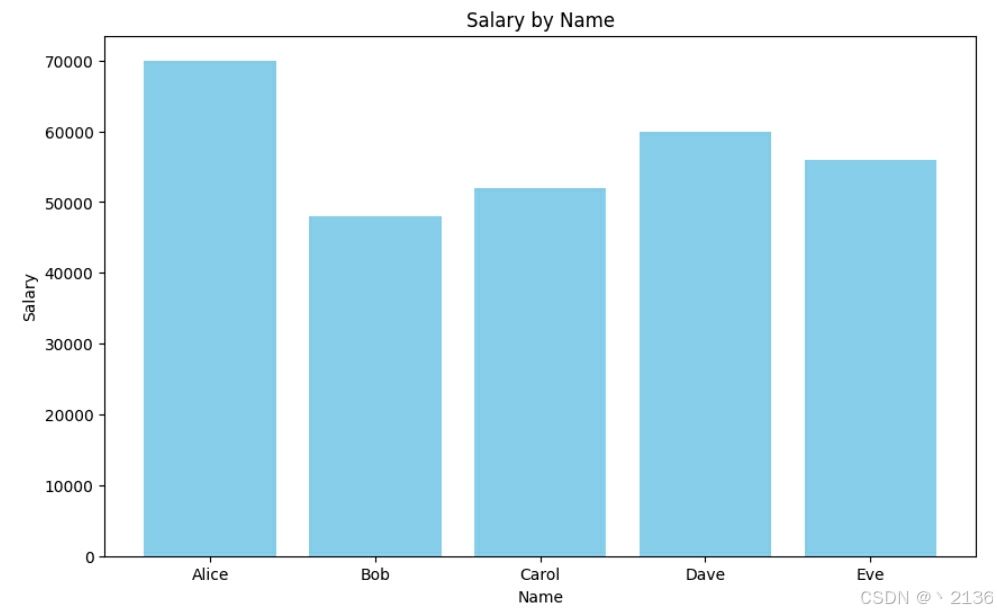
4.2 使用 Seaborn 绘制图表
Seaborn 提供了更美观的图表样式。
示例:箱型图
import seaborn as sns
# 绘制箱型图
plt.figure(figsize=(10, 6))
sns.boxplot(x='Age', y='Salary', data=data)
plt.title('Salary Distribution by Age')
plt.show()
输出: 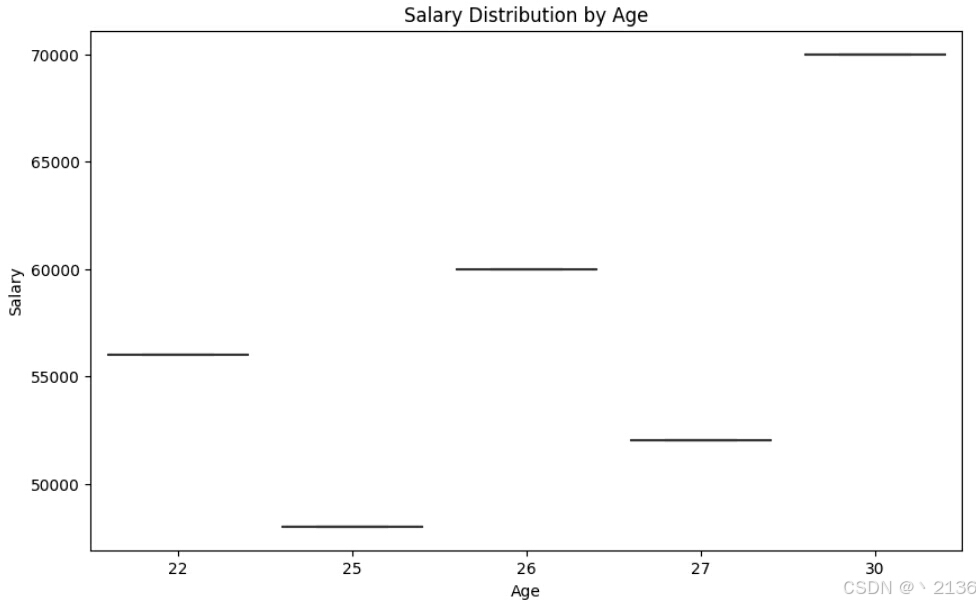
4.3 高级可视化技巧
除了基本的图表,您还可以利用 matplotlib 和 seaborn 的高级特性来创建复杂的可视化效果。
示例:热力图
# 计算相关性矩阵,只包括数值列
correlation_matrix = data[['Age', 'Salary']].corr()
print(correlation_matrix)
输出:
Age Salary
Age 1.000000 0.609736
Salary 0.609736 1.000000
# 创建热力图来查看相关性
plt.figure(figsize=(10, 6))
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm')
plt.title('Correlation Heatmap')
plt.show()
输出: 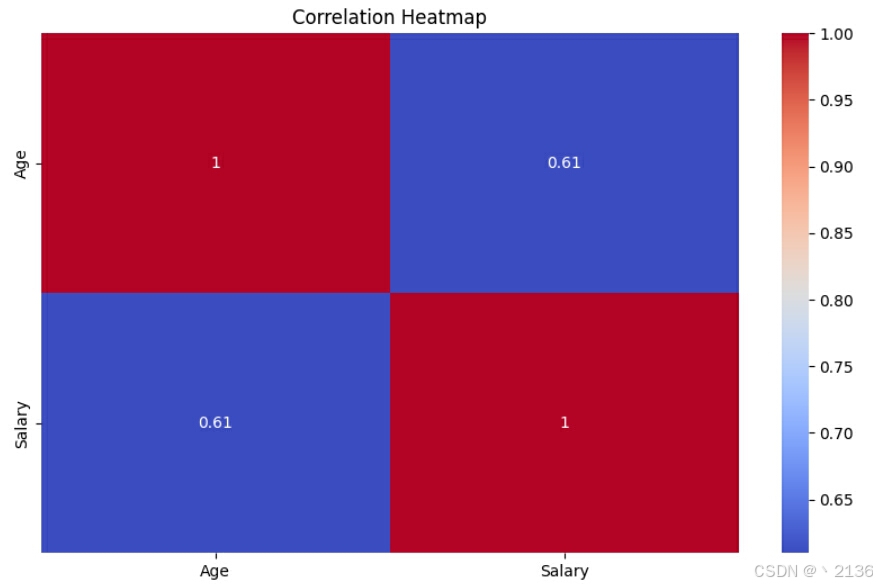
5. 案例研究
为了更好地理解数据分析与可视化的实际应用,让我们考虑一个具体的案例。
案例:销售数据分析
假设我们有一个销售数据集,包含以下列:
- OrderID:订单编号
- Product:产品名称
- Quantity:购买数量
- Price:单价
- Date:订单日期
步骤 1:数据导入与预处理
sales_data = pd.read_csv('sales_data.csv')
# 检查缺失值
sales_data.isnull().sum()
# 填充缺失值
sales_data['Quantity'].fillna(0, inplace=True)
sales_data['Price'].fillna(sales_data['Price'].median(), inplace=True)
步骤 2:数据分析
计算每个产品的总销售额和销量:
sales_data['TotalSales'] = sales_data['Quantity'] * sales_data['Price']
product_sales = sales_data.groupby('Product')['TotalSales'].sum().reset_index()
步骤 3:数据可视化
plt.figure(figsize=(12, 6))
sns.barplot(x='Product', y='TotalSales', data=product_sales)
plt.title('Total Sales by Product')
plt.xticks(rotation=45)
plt.show()
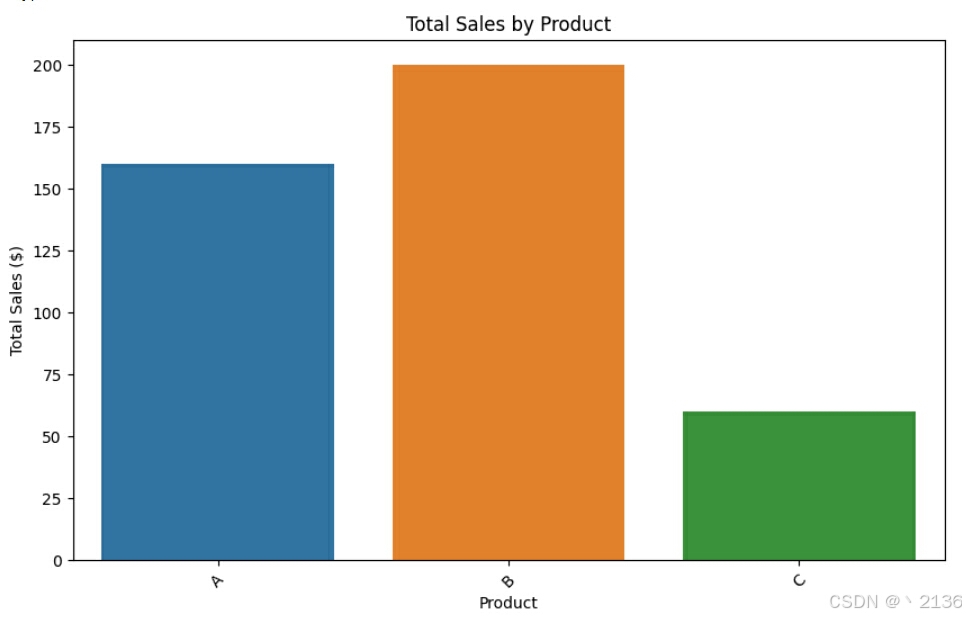
以下是完整的示例代码,包含数据生成、预处理、分析和可视化步骤:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
# 1. 生成示例销售数据
data = {
'OrderID': range(1, 11),
'Product': ['A', 'B', 'C', 'A', 'B', 'C', 'A', 'B', 'C', 'A'],
'Quantity': [5, 2, 0, 3, 1, 4, 6, 7, 0, 2],
'Price': [10.0, 20.0, 15.0, 10.0, 20.0, 15.0, 10.0, 20.0, 15.0, 10.0],
'Date': pd.date_range(start='2023-01-01', periods=10, freq='D')
}
sales_data = pd.DataFrame(data)
# 2. 数据预处理
# 检查缺失值
print(sales_data.isnull().sum())
# 填充缺失值(若有)
sales_data['Quantity'].fillna(0, inplace=True)
sales_data['Price'].fillna(sales_data['Price'].median(), inplace=True)
# 3. 计算总销售额
sales_data['TotalSales'] = sales_data['Quantity'] * sales_data['Price']
# 4. 按产品分组计算总销售额
product_sales = sales_data.groupby('Product')['TotalSales'].sum().reset_index()
# 5. 数据可视化
plt.figure(figsize=(10, 6))
sns.barplot(x='Product', y='TotalSales', data=product_sales)
plt.title('Total Sales by Product')
plt.xlabel('Product')
plt.ylabel('Total Sales ($)')
plt.xticks(rotation=45)
plt.show()
说明:
输出:
OrderID 0
Product 0
Quantity 0
Price 0
Date 0
dtype: int64
总结
通过上述步骤,我们演示了如何使用 Python 进行数据分析与可视化。关键步骤包括数据处理、分析和可视化。我们使用 pandas 进行数据清洗与分析,使用 matplotlib 和 seaborn 进行可视化,展示了不同的图表和分析结果。
在实际应用中,数据分析与可视化是一个迭代的过程,您可以根据需求不断调整和优化。希望这篇博客能为您提供一个清晰的入门指南,助力您在数据分析与可视化的旅程中不断前行!如果有任何问题或建议,欢迎在评论区讨论!