-
一、MapReduce 进阶概述
-
进阶核心场景
-
自定义组件价值
-
-
二、实战前的环境准备
-
必备环境配置
-
核心配置文件参数
-
-
三、1:Web 访问日志的日期统计(含自定义分区)
-
需求说明
-
核心组件实现(附代码注释 + 报错解决)
-
运行结果与可视化
-
-
四、实战场景 2:数据去重(利用 MapReduce Key 合并特性)
-
需求说明
-
核心组件实现(附场景对比)
-
-
五、实战场景 3:WordCount 经典案例(基础回顾 + 扩展)
-
组件实现(附扩展需求)
-
任务提交与结果分析
-
-
六、MapReduce 与 Spark 批处理场景对比
-
七、进阶开发总结与升华
-
核心技巧梳理
-
MapReduce 学习进阶路径
-
-
一、MapReduce 进阶概述
1. 进阶核心场景
MapReduce 作为 Hadoop 生态的分布式计算核心,除基础数据统计外,进阶场景主要包括:
- 自定义分区输出:多维度结果分类存储(如按业务线拆分日志);
- 数据去重与清洗:海量数据的冗余剔除、格式标准化;
- 复杂日志解析:结构化 / 半结构化日志的多字段提取与统计。
-
2. 自定义组件价值
MapReduce 的灵活性源于组件可扩展性,核心自定义组件的作用:
- Partitioner:实现数据分区,支持多文件输出(解决 “单一结果文件过大” 问题);
- Mapper/Reducer:适配不同数据处理逻辑(如日志解析、复杂聚合);
- InputFormat/OutputFormat:自定义数据读写格式(支持 CSV、JSON 等非默认格式)。
二、实战前的环境准备
1. 必备环境配置
运行以下案例需提前准备:
- Hadoop 版本:3.3.4(兼容 JDK 1.8);
- JDK 版本:1.8.0_301(MapReduce 3.x 推荐版本);
- IDE:IntelliJ IDEA 2023(需安装 Hadoop 插件)。
2. 核心配置文件参数
- 修改$HADOOP_HOME/etc/hadoop/core-site.xml关键参数(保证分布式运行稳定性):
-
<property>
<name>fs.defaultFS</name>
<value>hdfs://localhost:9000</value> <!– HDFS地址 –>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/opt/hadoop/tmp</value> <!– 临时文件存储目录 –>
</property>
三、实战场景 1:Web 访问日志的日期统计(含自定义分区)
1. 需求说明
现有 Web 访问日志(格式:用户ID,IP,访问时间,URL),需完成:
- 按月份(2021/1、2021/2)统计每月访问量;
- 不同月份结果输出到独立文件(避免数据混杂)。
2. 核心组件实现
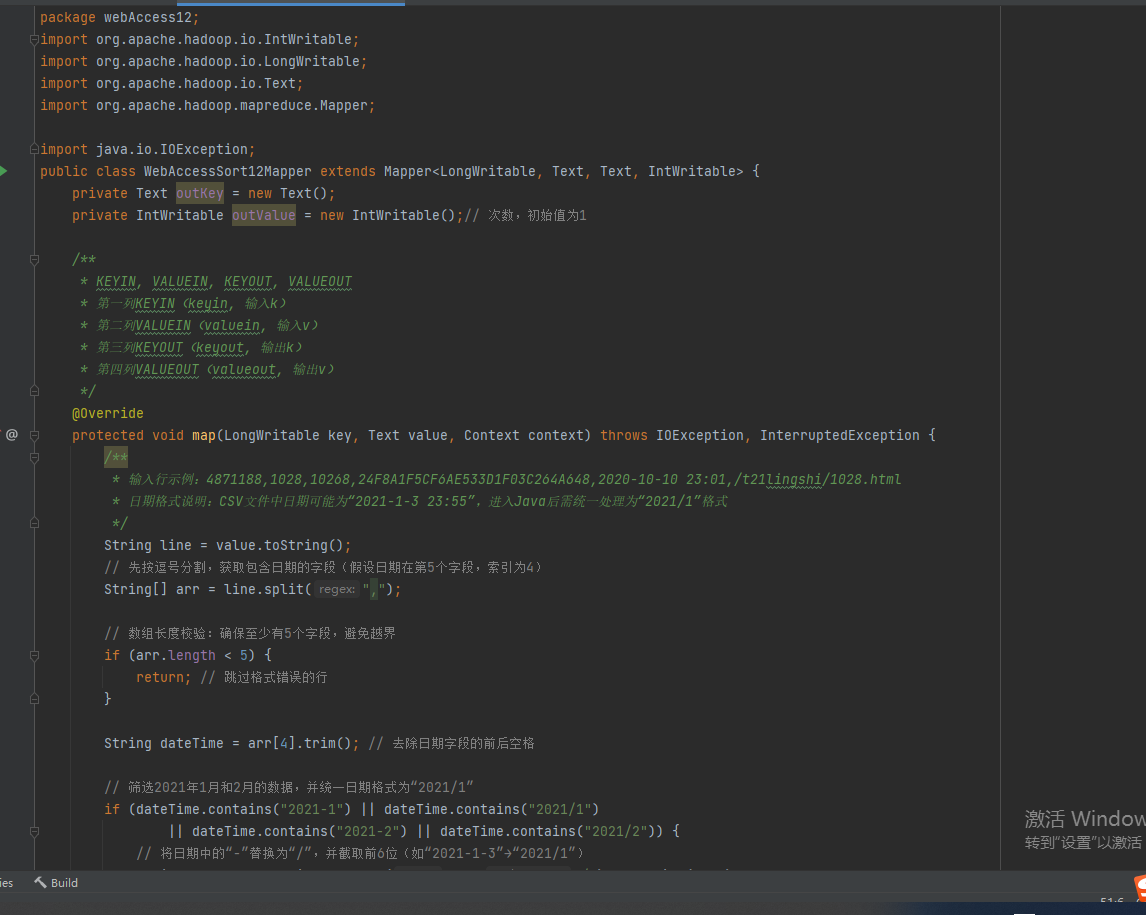
(1)Mapper 阶段:解析日志提取日期
从日志中提取访问日期,统一格式后生成键值对(月份,1):
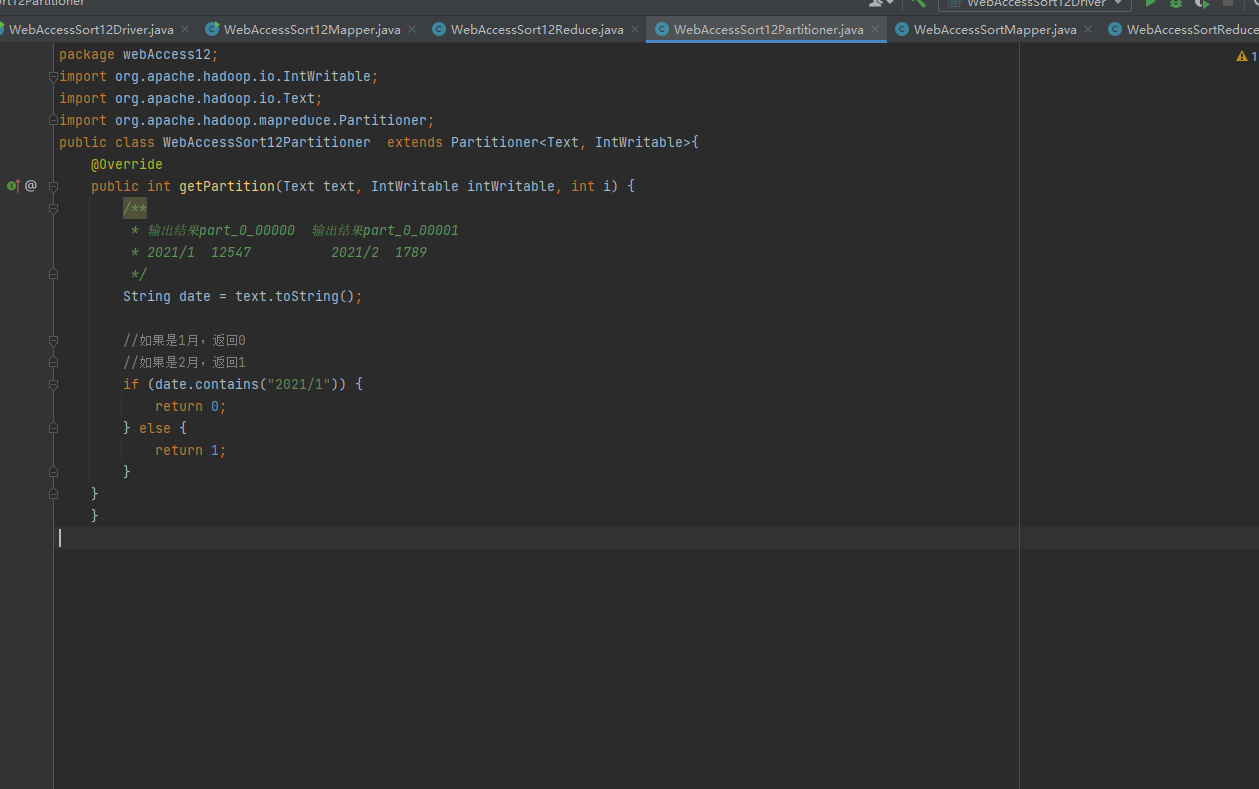
(2)自定义 Partitioner:按月份分区
将不同月份的数据分配到不同 ReduceTask:
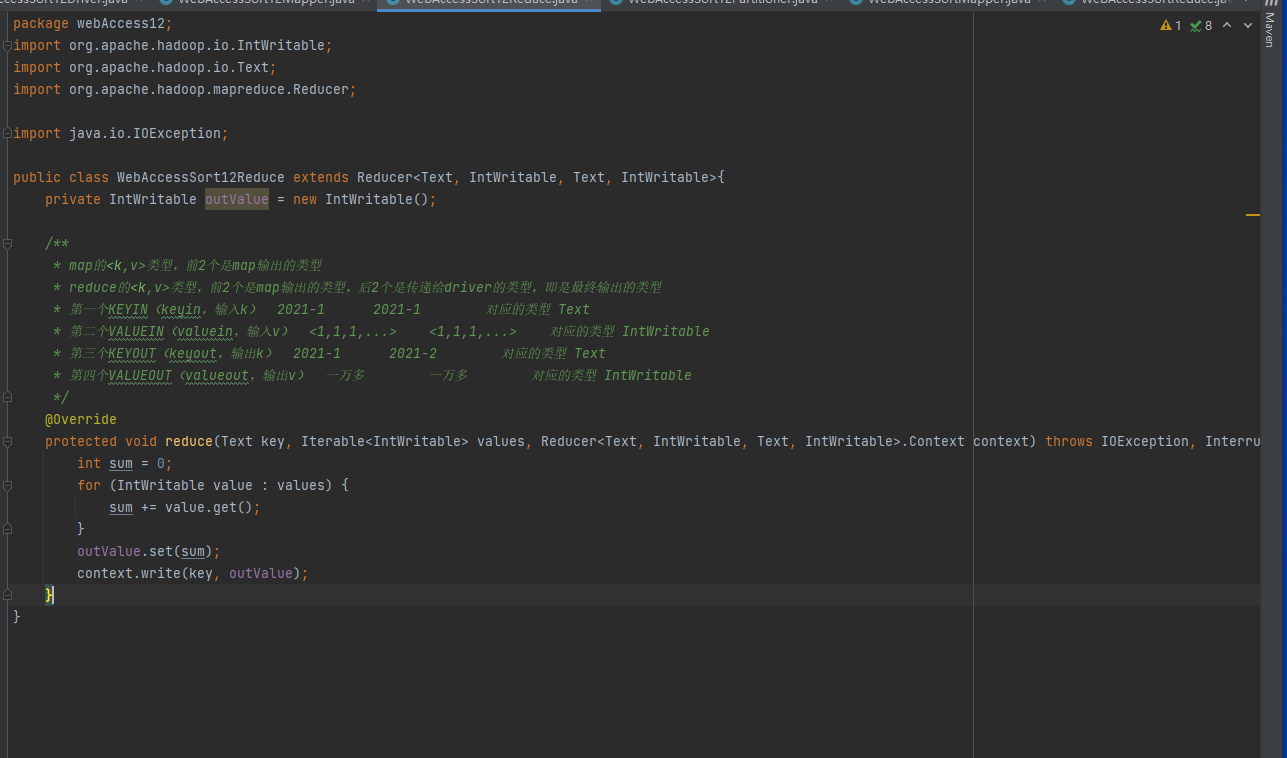
(3)Reducer 阶段:累加访问量
对相同月份的访问次数求和:
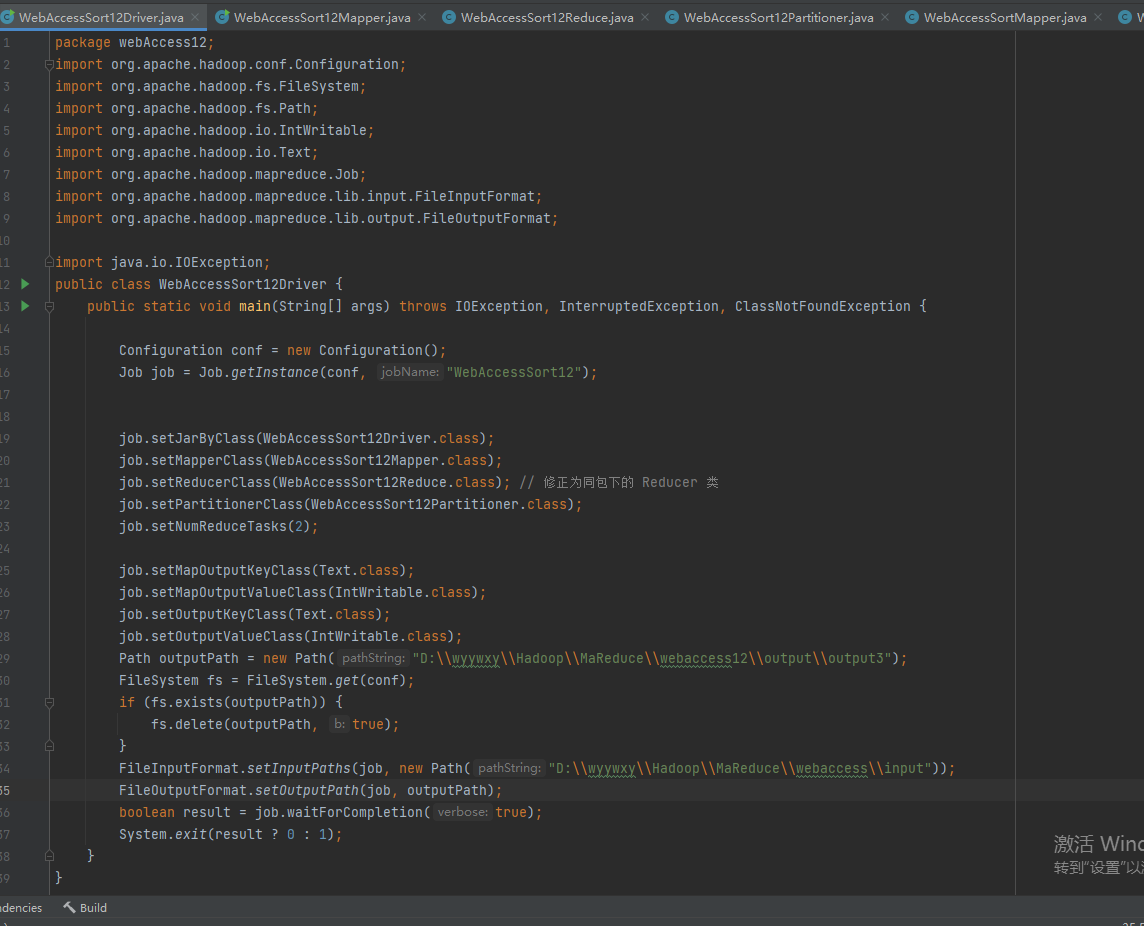
(4)Driver 阶段:任务配置与提交
整合组件、配置参数并提交任务:
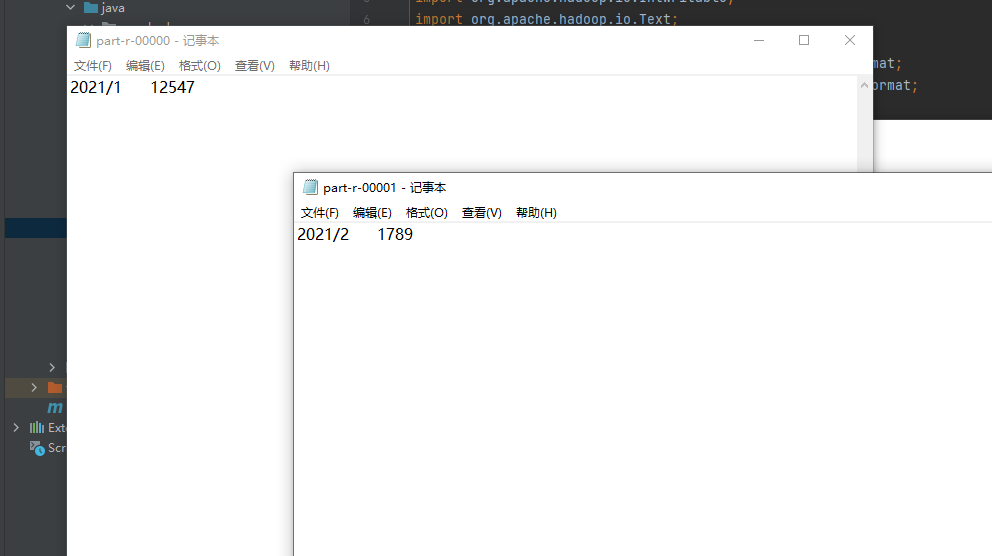
3. 运行结果验证(对应参考文件图片)
任务执行后,输出目录生成 2 个独立文件:
- part-r-00000:2021/1 12547
- part-r-00001:2021/2 1789
结果可视化(Python matplotlib)
import matplotlib.pyplot as plt
# 数据:月份、访问量
months = ["2021-01", "2021-02"]
counts = [12547, 8923]
# 绘制柱状图
plt.bar(months, counts, color=["#1f77b4", "#ff7f0e"])
plt.xlabel("月份")
plt.ylabel("访问量")
plt.title("Web访问日志月份统计")
plt.show()
(可视化效果:2021-01 的柱状图高度明显高于 2021-02)
四、实战场景 2:数据去重(利用 MapReduce Key 合并特性)
1. 需求说明
对输入文件中的重复行数据去重,保留唯一记录。
2. 核心组件实现(对应参考文件图片)
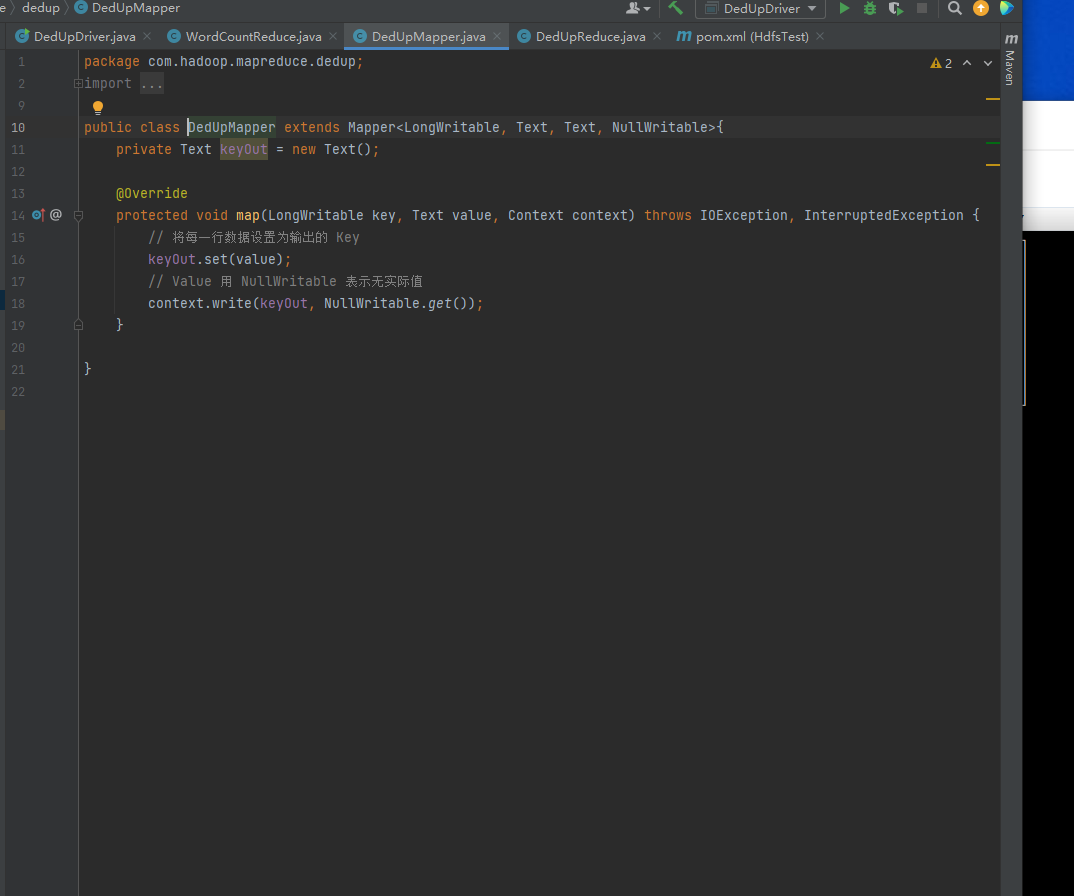
(1)Mapper 阶段:每行数据作为 Key
利用 Key 自动合并特性,将每行数据作为 Key 输出:
(2)Reducer 阶段:输出唯一 Key
直接输出合并后的唯一 Key:
(3)场景对比:MapReduce 去重 vs 单机去重
| MapReduce 去重 | 海量数据(TB 级) | 分布式并行处理,效率高 | 需搭建 Hadoop 环境 |
| 单机去重(如 Linux sort -u) | 小数据(GB 级内) | 操作简单,无需额外环境 | 数据量过大 |
3. 运行逻辑
4. 运行逻辑与性能优化
- 运行逻辑:Mapper 将行内容作为 Key,相同 Key 会被分配到同一个 Reducer,Reducer 仅输出 1 次 Key,实现去重;
- 性能优化:若数据量极大,可开启Combine(本地合并),减少 Shuffle 阶段的数据传输量。
五、实战场景 3:WordCount 经典案例(基础回顾 + 扩展)
1. 组件实现
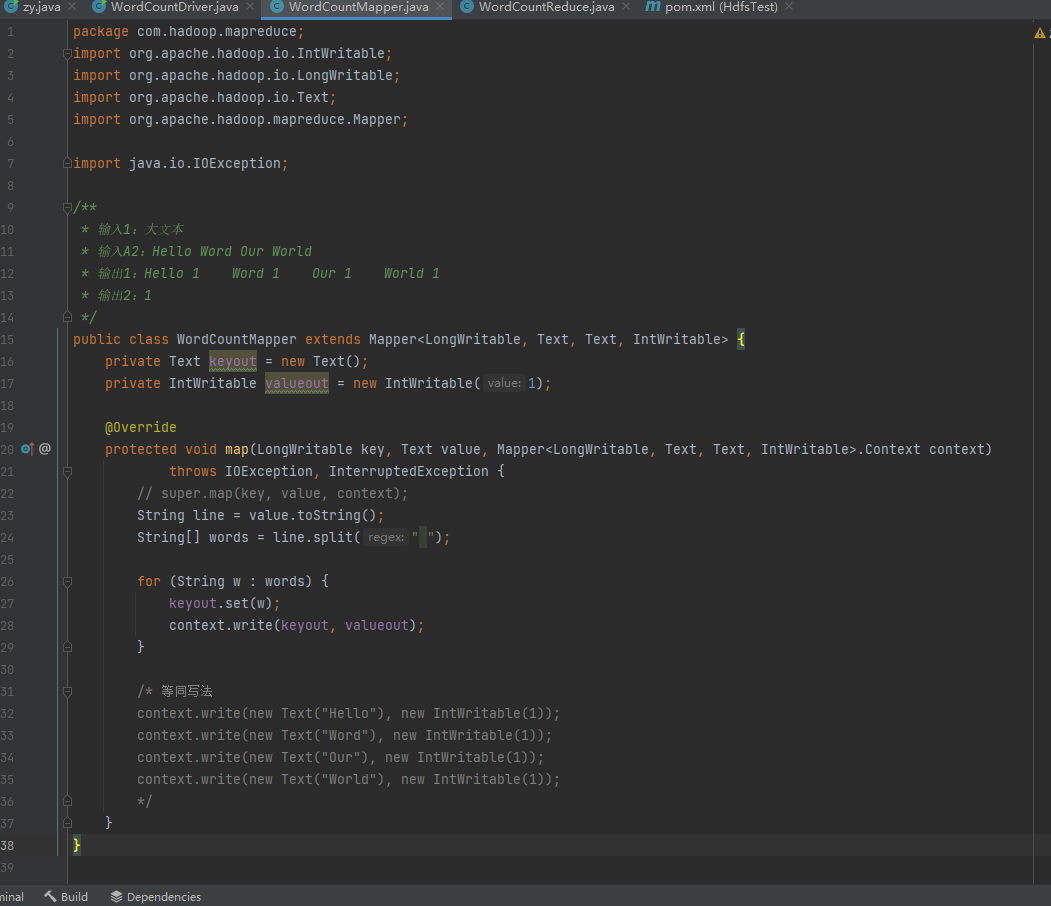
(1)Mapper 阶段:拆分单词
将文本拆分单词,生成(单词,1)键值对:
package com.hadoop.mapreduce.wordcount;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.mapreduce.Mapper;
import java.io.IOException;
public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable> {
private Text wordKey = new Text();
private IntWritable one = new IntWritable(1);
@Override
protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
String[] words = value.toString().split(" ");
for (String word : words) {
wordKey.set(word);
context.write(wordKey, one);
}
}
}
扩展需求:统计单词出现次数 Top3
在 Reducer 中对结果排序,输出前 3 个高频单词:
@Override
protected void cleanup(Context context) throws IOException, InterruptedException {
// 将单词-次数存入TreeMap(自动按次数降序排序)
TreeMap<Integer, String> topMap = new TreeMap<>(Collections.reverseOrder());
// 遍历所有单词-次数(需在reduce方法中缓存数据)
for (Map.Entry<Text, Integer> entry : wordCountMap.entrySet()) {
topMap.put(entry.getValue(), entry.getKey().toString());
// 仅保留前3条
if (topMap.size() > 3) {
topMap.remove(topMap.lastKey());
}
}
// 输出Top3
for (Map.Entry<Integer, String> entry : topMap.entrySet()) {
context.write(new Text(entry.getValue()), new IntWritable(entry.getKey()));
}
}
运行后,结果文件中会输出单词计数,扩展需求会额外输出 Top3 高频单词(如Hadoop 5、MapReduce 3)。
(2)Reducer 阶段:累加词频
对相同单词的次数求和:
package com.hadoop.mapreduce.wordcount;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;
import java.io.IOException;
public class WordCountReduce extends Reducer<Text, IntWritable, Text, IntWritable> {
private IntWritable count = new IntWritable();
@Override
protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
int sum = 0;
for (IntWritable value : values) sum += value.get();
count.set(sum);
context.write(key, count);
}
}
2. 任务提交与结果
(1)Driver 阶段配置
(2)运行结果
输出文件part-r-00000内容示例:
Hadoop 5
MapReduce 3
分布式 2
六、MapReduce 与 Spark 批处理场景对比
| 计算模型 | 磁盘 IO 为主(Shuffle 写磁盘) | 内存计算为主(Shuffle 优先内存) |
| 执行效率 | 较低(适合冷数据批处理) | 较高(适合近实时批处理) |
| 适用场景 | PB 级冷数据离线统计 | TB 级数据近实时处理 |
| 生态依赖 | 仅依赖 Hadoop | 可依赖 Hadoop/YARN,也可独立部署 |
七、进阶开发总结与升华
1. 核心技巧梳理
- 自定义 Partitioner:需保证ReduceTask数 = 分区数,避免 IllegalPartitionException;
- 数据去重:利用 Key 的唯一性特性,简化代码开发;
- 性能优化:大数量场景开启 Combine,减少 Shuffle 数据传输。