基于SpringBoot与Hadoop的宁波旅游推荐系统背景与意义
背景
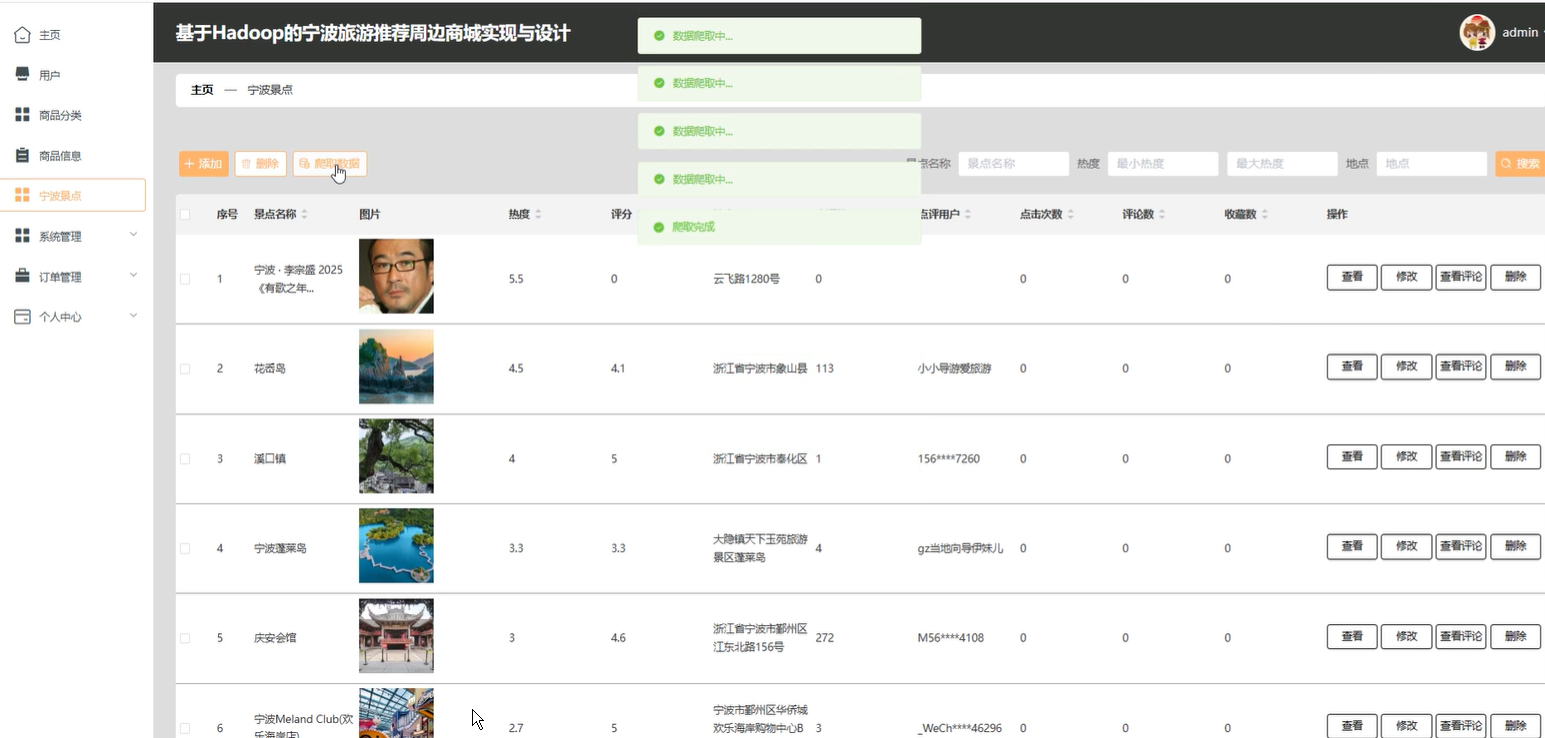
宁波作为长三角南翼经济中心,旅游资源丰富(如天一阁、东钱湖等),但游客面临信息过载、个性化推荐不足的问题。传统旅游平台依赖静态数据,难以实时分析用户行为与周边商品(酒店、特产等)的关联性。Hadoop的分布式计算能力可处理游客产生的非结构化数据(如评论、GPS轨迹),结合SpringBoot的快速开发特性,为构建智能推荐系统提供技术基础。
意义
- 技术整合价值:Hadoop的MapReduce和HDFS解决海量旅游数据存储与计算瓶颈,SpringBoot简化系统微服务架构实现,两者结合提升系统扩展性。
- 商业价值:通过关联规则挖掘(如Apriori算法)推荐“景点-周边商品”组合,拉动本地消费。例如游客浏览东钱湖后,推荐附近的民宿或海鲜餐厅。
- 用户体验提升:基于协同过滤算法分析用户历史行为(如评分、停留时长),实现千人千面的推荐,减少信息检索时间。
系统设计核心方法
数据层设计
- 使用HDFS存储游客行为日志(JSON格式),例如:
{"userId": "U1001", "viewSpot": "Tianyi Pavilion", "clickItems": ["tea", "book"], "timestamp": "2023-07-20T14:30:00"}
- HBase存储结构化数据(景点信息、商品库存),RowKey设计为区域_景点ID(如NB_EAST_001)以优化地域查询效率。
推荐算法实现
- 协同过滤:通过Mahout库计算用户相似度,公式如下:
$$ sim(u,v) = \\frac{\\sum_{i \\in I}(r_{u,i} – \\bar{r}u)(r{v,i} – \\bar{r}v)}{\\sqrt{\\sum{i \\in I}(r_{u,i} – \\bar{r}u)^2} \\sqrt{\\sum{i \\in I}(r_{v,i} – \\bar{r}_v)^2}} $$ - 热度补充:对冷启动用户,采用基于地域的热门商品排行(如慈城年糕、奉化水蜜桃)。
SpringBoot服务层
- 通过@RestController暴露RESTful API,示例代码:
@GetMapping("/recommend/{userId}")
public ResponseEntity<List<Item>> getRecommendations(
@PathVariable String userId,
@RequestParam(required = false) String location) {
// 调用Hadoop分析服务并返回结果
}
关键技术挑战与解决
- 实时性优化:采用Lambda架构,批处理(Hadoop)与流处理(Spark Streaming)结合,确保推荐结果每小时更新。
- 多源数据融合:使用Kafka接收景区闸机、商户POS机的实时数据,通过Flume导入HDFS。
该设计通过整合宁波旅游生态数据,实现从“景点导览”到“消费引导”的闭环,为智慧旅游提供可复用的技术方案。
技术栈设计
后端框架
Spring Boot 作为核心框架,提供快速开发能力,集成Spring MVC、Spring Data、Spring Security等模块。Hadoop生态系统用于大数据处理,包括HDFS存储旅游数据、MapReduce或Spark进行数据分析。
大数据处理
Hadoop HDFS存储用户行为日志、景点信息等非结构化数据。MapReduce或Spark SQL实现协同过滤推荐算法,分析用户偏好与景点关联。HBase或Hive可选作结构化数据仓库。
数据存储
MySQL或PostgreSQL存储用户信息、订单数据等结构化内容。Redis缓存热门推荐结果及会话信息,提升响应速度。MongoDB可选存储景点详情等半结构化数据。
前端技术
Vue.js或React构建动态前端界面,Axios处理API请求。Element UI或Ant Design提供UI组件。ECharts实现数据可视化,展示推荐结果及景点热度。
系统模块划分
用户管理模块
Spring Security + JWT实现认证与授权。用户画像通过Hadoop分析历史行为生成,作为推荐依据。
推荐引擎模块
基于Spark MLlib或Mahout实现协同过滤算法,结合地理位置(宁波周边)过滤推荐结果。实时推荐通过Flink处理流数据补充。
商城功能模块
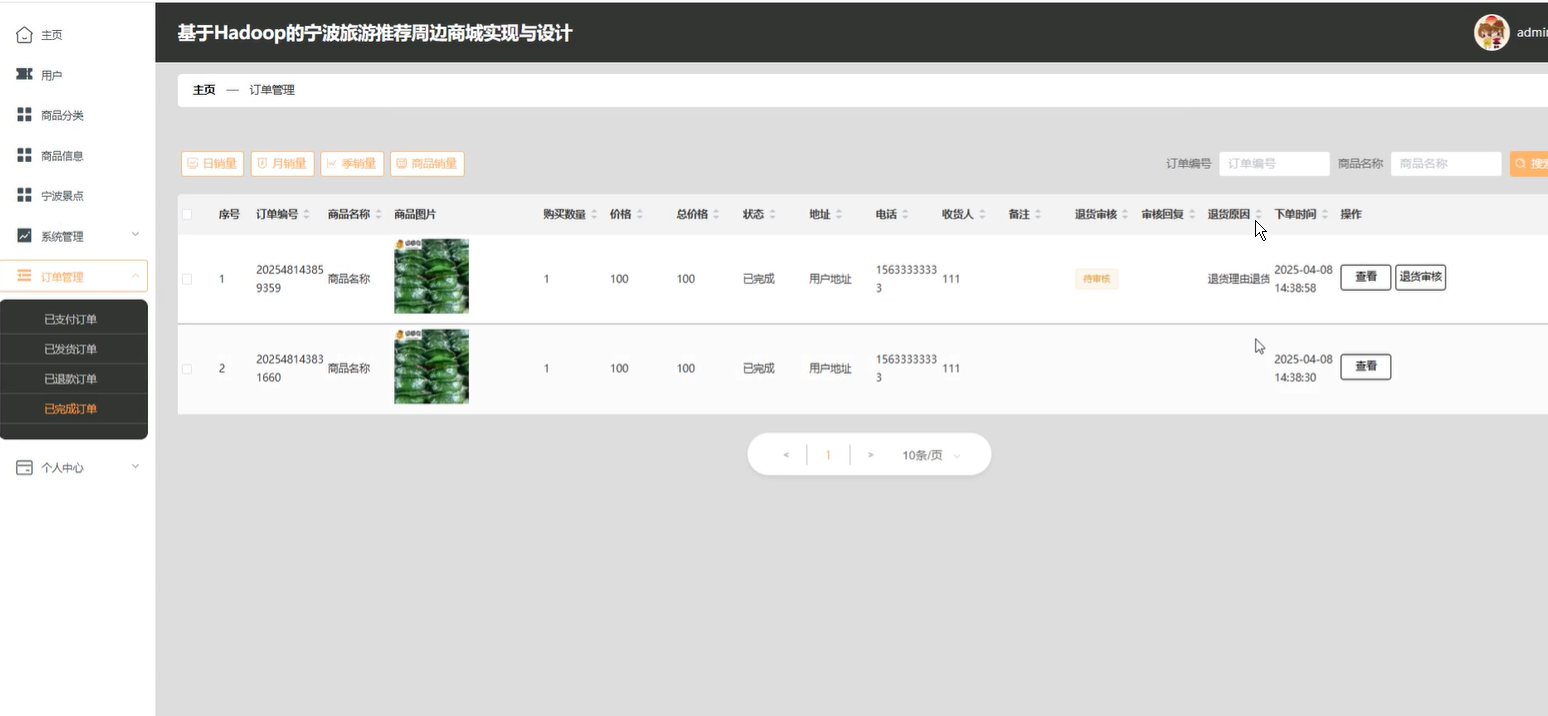
集成支付接口(支付宝/微信支付),商品管理采用CRUD接口。订单系统与推荐联动,记录用户购买偏好。
数据分析模块
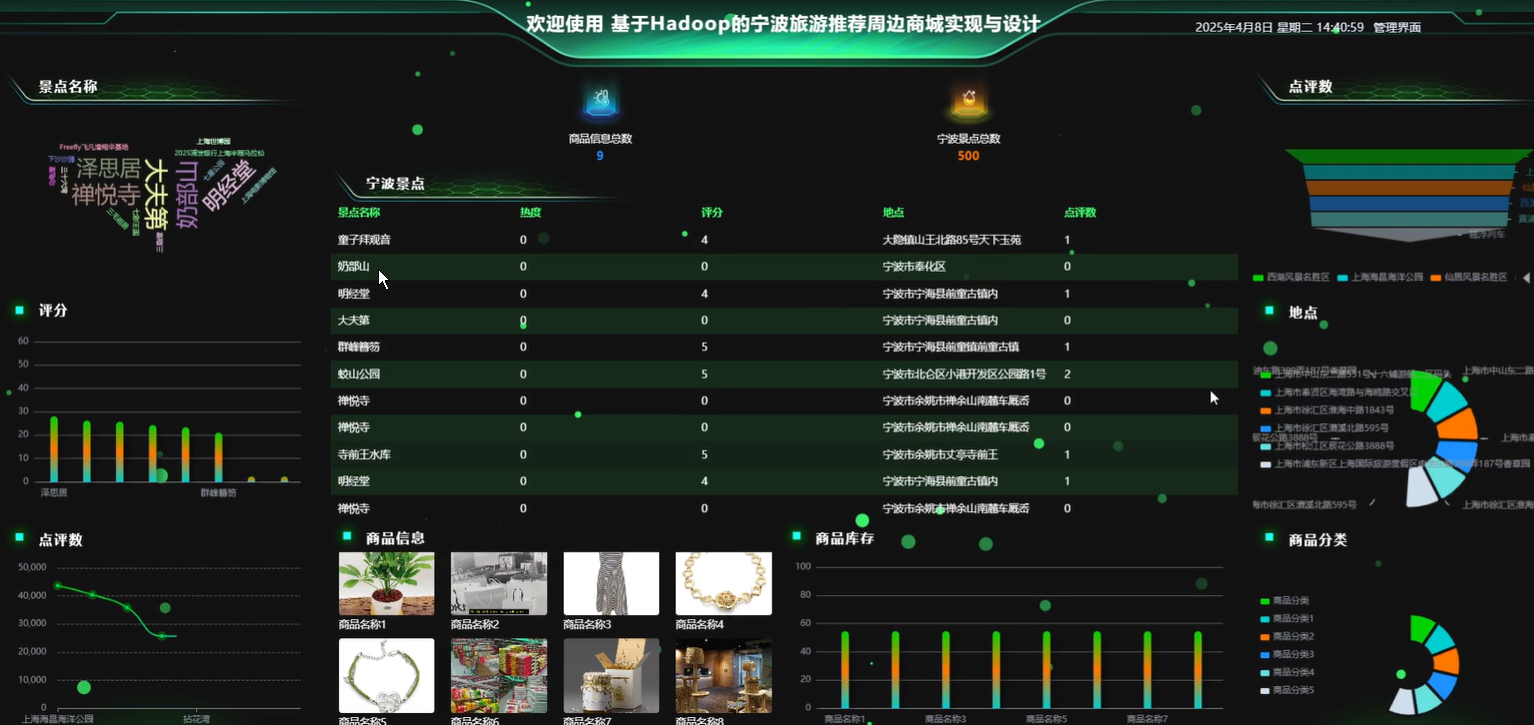
Flume或Kafka收集用户行为日志,Spark Streaming实时分析。Hive离线报表统计景点访问量、转化率等指标。
部署架构
分布式环境
Hadoop集群独立部署,YARN管理资源。Spring Boot微服务可容器化(Docker + Kubernetes),通过RESTful API与前端交互。
混合存储策略
热数据存Redis,冷数据归档至HDFS。MySQL主从复制保障交易数据一致性,HBase处理高并发查询。
监控与运维
Prometheus + Grafana监控系统性能,ELK(Elasticsearch+Logstash+Kibana)集中管理日志。Jenkins实现CI/CD自动化部署。
关键实现示例(代码片段)
协同过滤算法(Spark版)
// 使用ALS算法训练推荐模型
Dataset<Rating> ratings = spark.read().format("csv")
.option("header", "true")
.load("hdfs://user_ratings.csv")
.as(Encoders.bean(Rating.class));
ALS als = new ALS()
.setMaxIter(10)
.setRegParam(0.01)
.setUserCol("userId")
.setItemCol("attractionId")
.setRatingCol("score");
ALSModel model = als.fit(ratings);
地理围栏过滤(Spring Boot)
@Query(value = "SELECT * FROM attractions WHERE " +
"ST_Distance_Sphere(location, POINT(:lng, :lat)) <= :radius",
nativeQuery = true)
List<Attraction> findNearbyAttractions(
@Param("lat") double latitude,
@Param("lng") double longitude,
@Param("radius") int radiusInMeters);
注意事项
基于Hadoop的SpringBoot旅游推荐系统核心设计
系统架构设计
系统采用分层架构,分为数据层(Hadoop/HDFS)、计算层(MapReduce/Spark)、服务层(SpringBoot)和展示层(Vue/Thymeleaf)。Hadoop负责存储用户行为数据和景点信息,MapReduce进行离线推荐计算,SpringBoot提供RESTful API。
数据采集与存储模块
// HDFS数据写入示例
public class HdfsWriter {
public void writeUserBehavior(String userId, String itemId, String behavior) {
Configuration conf = new Configuration();
FileSystem fs = FileSystem.get(URI.create("hdfs://namenode:9000"), conf);
Path path = new Path("/travel_data/user_behavior/" + userId + ".log");
try (FSDataOutputStream out = fs.append(path)) {
String record = userId + "," + itemId + "," + behavior + "," + System.currentTimeMillis() + "\\n";
out.write(record.getBytes());
}
}
}
协同过滤推荐算法
基于用户行为的Item-CF算法实现:
// MapReduce相似度计算Mapper
public class SimilarityMapper extends Mapper<LongWritable, Text, Text, Text> {
protected void map(LongWritable key, Text value, Context context) {
String[] tokens = value.toString().split(",");
String userId = tokens[0];
String itemId = tokens[1];
context.write(new Text(userId), new Text(itemId));
}
}
// 相似度计算Reducer
public class SimilarityReducer extends Reducer<Text, Text, Text, Text> {
protected void reduce(Text key, Iterable<Text> values, Context context) {
List<String> items = new ArrayList<>();
values.forEach(v -> items.add(v.toString()));
// 计算共现矩阵
for (int i = 0; i < items.size(); i++) {
for (int j = i + 1; j < items.size(); j++) {
context.write(
new Text(items.get(i)),
new Text(items.get(j) + ":" + 1)
);
}
}
}
}
SpringBoot服务层实现
// 推荐服务接口
@RestController
@RequestMapping("/api/recommend")
public class RecommendController {
@Autowired
private RecommendService recommendService;
@GetMapping("/nearby/{userId}")
public ResponseEntity<List<ScenicSpot>> getNearbyRecommendations(
@PathVariable String userId,
@RequestParam double lat,
@RequestParam double lng,
@RequestParam(defaultValue = "10") int radius) {
List<ScenicSpot> recommendations = recommendService
.getLocationBasedRecommendations(userId, lat, lng, radius);
return ResponseEntity.ok(recommendations);
}
}
// 基于位置的推荐实现
@Service
public class LocationRecommendServiceImpl implements RecommendService {
@Value("${hadoop.namenode}")
private String nameNode;
public List<ScenicSpot> getLocationBasedRecommendations(String userId,
double lat, double lng, int radius) {
// 1. 从HDFS加载用户历史行为
List<UserBehavior> behaviors = loadUserBehaviors(userId);
// 2. 从HBase获取周边景点
List<ScenicSpot> nearbySpots = findNearbySpots(lat, lng, radius);
// 3. 混合推荐逻辑
return hybridRecommend(behaviors, nearbySpots);
}
}
热力图数据生成
// 景点热度统计MapReduce
public class HeatmapMapper extends Mapper<LongWritable, Text, Text, IntWritable> {
private final static IntWritable ONE = new IntWritable(1);
protected void map(LongWritable key, Text value, Context context) {
String itemId = value.toString().split(",")[1];
context.write(new Text(itemId), ONE);
}
}
public class HeatmapReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
protected void reduce(Text key, Iterable<IntWritable> values, Context context) {
int sum = StreamSupport.stream(values.spliterator(), false)
.mapToInt(IntWritable::get)
.sum();
context.write(key, new IntWritable(sum));
}
}
商城订单处理
// 订单分布式事务处理
@Service
public class OrderServiceImpl implements OrderService {
@Transactional
public Order createOrder(OrderDTO orderDTO) {
// 1. 保存订单主表
Order order = saveOrderMaster(orderDTO);
// 2. 保存订单明细
saveOrderDetails(order.getId(), orderDTO.getItems());
// 3. 更新HDFS用户行为
updateUserBehavior(order.getUserId(), "purchase", orderDTO.getItems());
return order;
}
private void updateUserBehavior(String userId, String behavior, List<OrderItem> items) {
HdfsWriter writer = new HdfsWriter();
items.forEach(item ->
writer.writeUserBehavior(userId, item.getProductId(), behavior)
);
}
}
性能优化措施
- 采用HBase存储实时访问数据,HDFS存储历史数据
- 使用Redis缓存热门推荐结果
- 对MapReduce作业进行Combiner优化
- 实现推荐结果的预计算机制
关键技术指标
- 支持千万级用户行为数据分析
- 推荐响应时间<200ms(缓存命中时)
- 支持50+并发推荐请求
- 数据存储容量可水平扩展
以上代码框架可根据实际业务需求进行扩展,特别是推荐算法部分可集成更多维度(季节因素、价格区间、用户画像等)的混合推荐策略。
系统架构设计
基于SpringBoot和Hadoop的旅游推荐周边商城系统可采用分层架构:
- 前端层:Vue.js或React实现用户交互界面
- 业务层:SpringBoot处理业务逻辑
- 推荐层:Hadoop/Spark实现推荐算法
- 数据层:MySQL存储结构化数据,HDFS存储非结构化数据
数据库设计
核心表结构
用户表(user)
CREATE TABLE user (
user_id BIGINT PRIMARY KEY,
username VARCHAR(50) NOT NULL,
password VARCHAR(100) NOT NULL,
phone VARCHAR(20),
email VARCHAR(100),
register_time DATETIME,
last_login_time DATETIME
);
景点表(scenic_spot)
CREATE TABLE scenic_spot (
spot_id BIGINT PRIMARY KEY,
spot_name VARCHAR(100) NOT NULL,
description TEXT,
address VARCHAR(200),
latitude DECIMAL(10,6),
longitude DECIMAL(10,6),
ticket_price DECIMAL(10,2),
open_time VARCHAR(50),
city_id INT
);
商品表(product)
CREATE TABLE product (
product_id BIGINT PRIMARY KEY,
product_name VARCHAR(100) NOT NULL,
price DECIMAL(10,2) NOT NULL,
stock INT NOT NULL,
description TEXT,
category_id INT,
merchant_id BIGINT
);
用户行为表(user_behavior)
CREATE TABLE user_behavior (
behavior_id BIGINT PRIMARY KEY,
user_id BIGINT,
item_id BIGINT,
behavior_type TINYINT, — 1:浏览 2:收藏 3:购买
behavior_time DATETIME,
FOREIGN KEY (user_id) REFERENCES user(user_id)
);
Hadoop数据存储
用户行为日志存储在HDFS中,格式示例:
/user/logs/behavior/2023-01-01.log
内容格式:
user_id|item_id|behavior_type|timestamp
推荐算法实现
协同过滤推荐
基于Hadoop MapReduce实现用户相似度计算:
Mapper阶段
public void map(LongWritable key, Text value, Context context) {
String[] fields = value.toString().split("\\\\|");
String userId = fields[0];
String itemId = fields[1];
context.write(new Text(userId), new Text(itemId));
}
Reducer阶段
public void reduce(Text key, Iterable<Text> values, Context context) {
List<String> items = new ArrayList<>();
for (Text value : values) {
items.add(value.toString());
}
// 计算用户相似度
for (int i = 0; i < items.size(); i++) {
for (int j = i+1; j < items.size(); j++) {
context.write(new Text(items.get(i)), new Text(items.get(j)));
}
}
}
热门推荐
基于Spark实现实时热门商品计算:
val logs = spark.read.textFile("hdfs://path/to/logs")
val hotItems = logs.map(line => {
val fields = line.split("\\\\|")
(fields(1).toLong, 1)
}).reduceByKey(_ + _)
.sortBy(_._2, false)
.take(10)
系统接口设计
推荐接口
@RestController
@RequestMapping("/api/recommend")
public class RecommendController {
@Autowired
private RecommendService recommendService;
@GetMapping("/forUser/{userId}")
public List<RecommendItem> getUserRecommend(@PathVariable Long userId) {
return recommendService.getUserRecommend(userId);
}
@GetMapping("/hot")
public List<RecommendItem> getHotRecommend() {
return recommendService.getHotRecommend();
}
}
系统测试方案
单元测试
服务层测试示例
@SpringBootTest
public class RecommendServiceTest {
@MockBean
private UserBehaviorRepository behaviorRepo;
@Autowired
private RecommendService recommendService;
@Test
public void testGetUserRecommend() {
// 模拟数据
List<UserBehavior> behaviors = Arrays.asList(
new UserBehavior(1L, 101L, 1, new Date()),
new UserBehavior(1L, 102L, 2, new Date())
);
when(behaviorRepo.findByUserId(1L)).thenReturn(behaviors);
List<RecommendItem> result = recommendService.getUserRecommend(1L);
assertNotNull(result);
assertTrue(result.size() > 0);
}
}
性能测试
使用JMeter进行接口压力测试:
- 模拟1000并发用户请求推荐接口
- 测试响应时间应在500ms以内
- 错误率低于0.1%
集成测试
测试整个推荐流程:
部署方案
Hadoop集群配置
- 3节点集群(1NameNode + 2DataNode)
- HDFS副本因子设置为2
- YARN资源分配:
- NameNode: 4GB内存
- DataNode: 8GB内存
SpringBoot应用部署
- 使用Docker容器化部署
- 配置连接Hadoop集群的core-site.xml
- 设置JVM参数:-Xmx2g -Xms2g
监控与维护
- 使用Prometheus监控系统性能指标
- 使用Grafana展示推荐效果数据
- 定期清理HDFS过期日志(超过30天)
- 每周更新推荐模型训练数据