一.题目
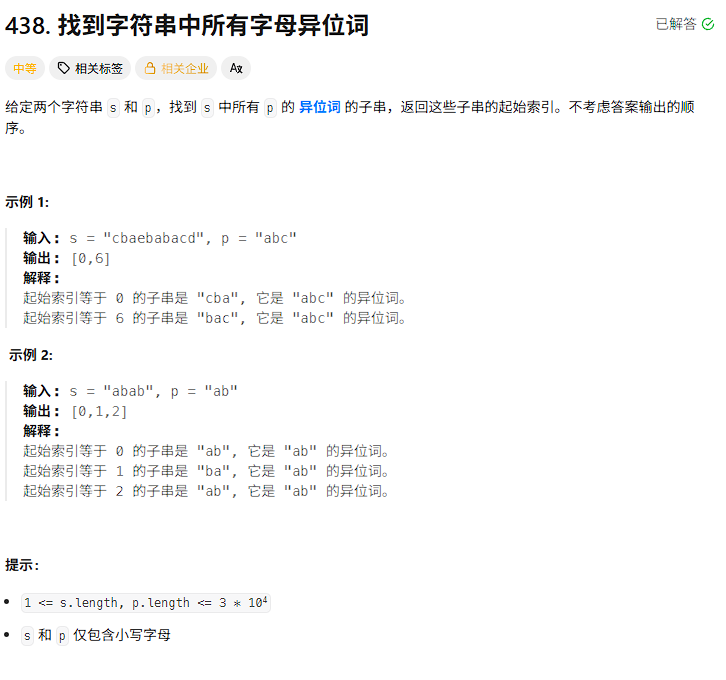
438. 找到字符串中所有字母异位词 – 力扣(LeetCode)
二.思路
2.1 审题
首先,我们需要明确什么是异位词。这里的含义是指,由相同元素组成但顺序不同的序列,比如对于三个字符 a、b、c,"abc"、"acb"、"bca" 等都属于异位词。也就是说,只要元素及其个数相同,无论排列顺序如何,它们就互为异位词。
2.2 思路讲解
对于这道题,题目要求在字符串 s 中找到所有与 p 互为字母异位词的子串,并返回这些子串的起始索引。由于子串是连续的,我们很自然地会想到用滑动窗口来处理。同时,判断两个字符串是否为异位词,本质上就是比较它们包含的字符种类和数量是否完全相同,而与顺序无关。因此,我们需要一个能快速统计字符频率的工具。
考虑到提示中明确说明 s 和 p 仅包含小写字母,范围只有 26 个,所以我们可以用一个固定大小的数组(长度为 26)来模拟哈希表,分别记录 p 的字符频率以及当前窗口内字符的频率。
三.代码演示
class Solution {
public:
vector<int> findAnagrams(string s, string p)
{
vector<int>v;
int hash1[26] = {0};//p的哈希表
int n1 = p.size();
for(auto i : p)
{
hash1[i – 97]++;//a的ASCII码就是97
}
int n2 = s.size();
int hash2[26] = {0};//s的哈希表
for(int left = 0,right = 0;right < n2;right++)
{
int flag = 1;
hash2[s[right] – 97]++;//进窗口
//判断条件
if(right – left + 1 == n1)
{
for(int i = 0;i < 26;i++)
{
if(hash1[i] != hash2[i])
{
flag = 0;
break;
}
}
//更新结果
if(flag == 1)
v.push_back(left);
hash2[s[left] – 97]–;//出窗口
left++;
}
}
return v;
}
};
class Solution {
public:
vector<int> findAnagrams(string s, string p)
{
vector<int>v;
int hash1[26] = { 0 };//p的哈希表
int n1 = p.size();
//范围for
for (auto i : p)
{
hash1[i – 97]++;//a的ASCII码就是97
}
int n2 = s.size();
int hash2[26] = { 0 };//s的哈希表
for (int left = 0, right = 0, count = 0; right < n2; right++)
{
//就是看s指向的元素双方存在p,存在就进窗口
int out1 = s[right] – 'a';
hash2[out1]++;//进窗口
if (hash2[out1] <= hash1[out1])
{
count++;//计时器++
}
//判断条件
if (right – left + 1 > n1)
{
int out2 = s[left] – 'a';
if(hash2[out2] <= hash1[out2])
{
count–;//计时器–
}
hash2[out2]–;//出窗口
left++;
}
if (count == n1)
v.push_back(left);//更新结果
}
return v;
}
};
四.代码比对
对于这道寻找字符串中所有字母异位词的题目,核心在于判断窗口内的子串是否与目标字符串 p 互为异位词。下面给出的两种代码实现,本质区别在于比较两个哈希表是否相等的方式。
第一种方法:循环直接比较
-
定义两个长度为 26 的数组 hash1 和 hash2,分别记录 p 和当前窗口内各字符的出现次数。
-
当窗口大小等于 p 的长度时,通过一个 for 循环遍历 26 个下标,逐一比较 hash1[i] 与 hash2[i] 是否相等。如果所有下标都相等,则说明当前窗口是 p 的一个异位词,记录起始索引。
-
然后执行出窗口操作:将左指针指向的字符在 hash2 中减 1,左指针右移。
-
这种方法直观但效率较低,因为每次都要遍历整个数组(尽管长度只有 26,常数时间可接受)。
第二种方法:计时器优化
-
同样使用两个数组 hash1 和 hash2,但引入一个计数器 count,用来记录当前窗口内属于 p 且数量未超出的字符个数。
-
进窗口时,将右指针字符在 hash2 中加 1,如果加 1 后该字符在 hash2 中的数量 ≤ hash1 中的数量,说明这个字符是有效匹配的一部分,count 加 1。
-
出窗口时,当窗口长度超过 p 的长度时,先判断左指针指向的字符在移出前是否属于有效匹配(即 hash2[out2] ≤ hash1[out2]),如果是,则 count 减 1;然后将该字符在 hash2 中的计数减 1,左指针右移。
-
当窗口大小等于 p 的长度时,判断 count 是否等于 n1(即 p 的长度)。如果相等,说明窗口内所有字符都恰好匹配,即当前窗口是异位词,记录起始索引。
-
这种方法通过 count 避免了每次完整遍历数组,只需在进出窗口时更新计数器,效率更高,尤其适用于窗口频繁移动的场景。