你是否曾经好奇过,当你在网上购物或使用手机应用时,背后的数据是如何被存储和分析的?答案就在数据仓库中。本文将为你揭开数据仓库的神秘面纱,深入探讨其核心组成部分,以及这些组件如何协同工作,将海量数据转化为有价值的商业洞察。 
目录
-
- 引言:数据仓库的魔力
- 1. 数据源和数据集成:数据仓库的\”进水口\”
-
- 1.1 多样化的数据源
- 1.2 数据集成:ETL过程
- 1.3 实时数据集成:从批处理到流处理
- 1.4 数据质量管理
- 1.5 数据血缘和影响分析
- 2. 数据存储:数据仓库的\”心脏\”
-
- 2.1 数据模型:星型模式vs雪花模式
-
- 星型模式
- 雪花模式
- 2.2 分区和分桶
-
- 分区(Partitioning)
- 分桶(Bucketing)
- 2.3 列式存储vs行式存储
-
- 行式存储
- 列式存储
- 2.4 数据压缩
- 2.5 数据分层
- 2.6 数据湖与数据仓库的融合
- 3. 元数据管理:数据仓库的\”大脑\”
-
- 3.1 元数据的类型
- 3.2 元数据仓库
- 3.3 元数据管理工具
- 3.4 数据目录
- 4. 数据访问和分析工具:数据仓库的\”出口\”
引言:数据仓库的魔力
想象一下,你正在经营一家全球性的电子商务公司。每天,成千上万的订单涌入,客户遍布全球各地,产品种类繁多。如何从这些看似杂乱无章的数据中,提取出有价值的信息,指导业务决策?这就是数据仓库发挥魔力的地方。
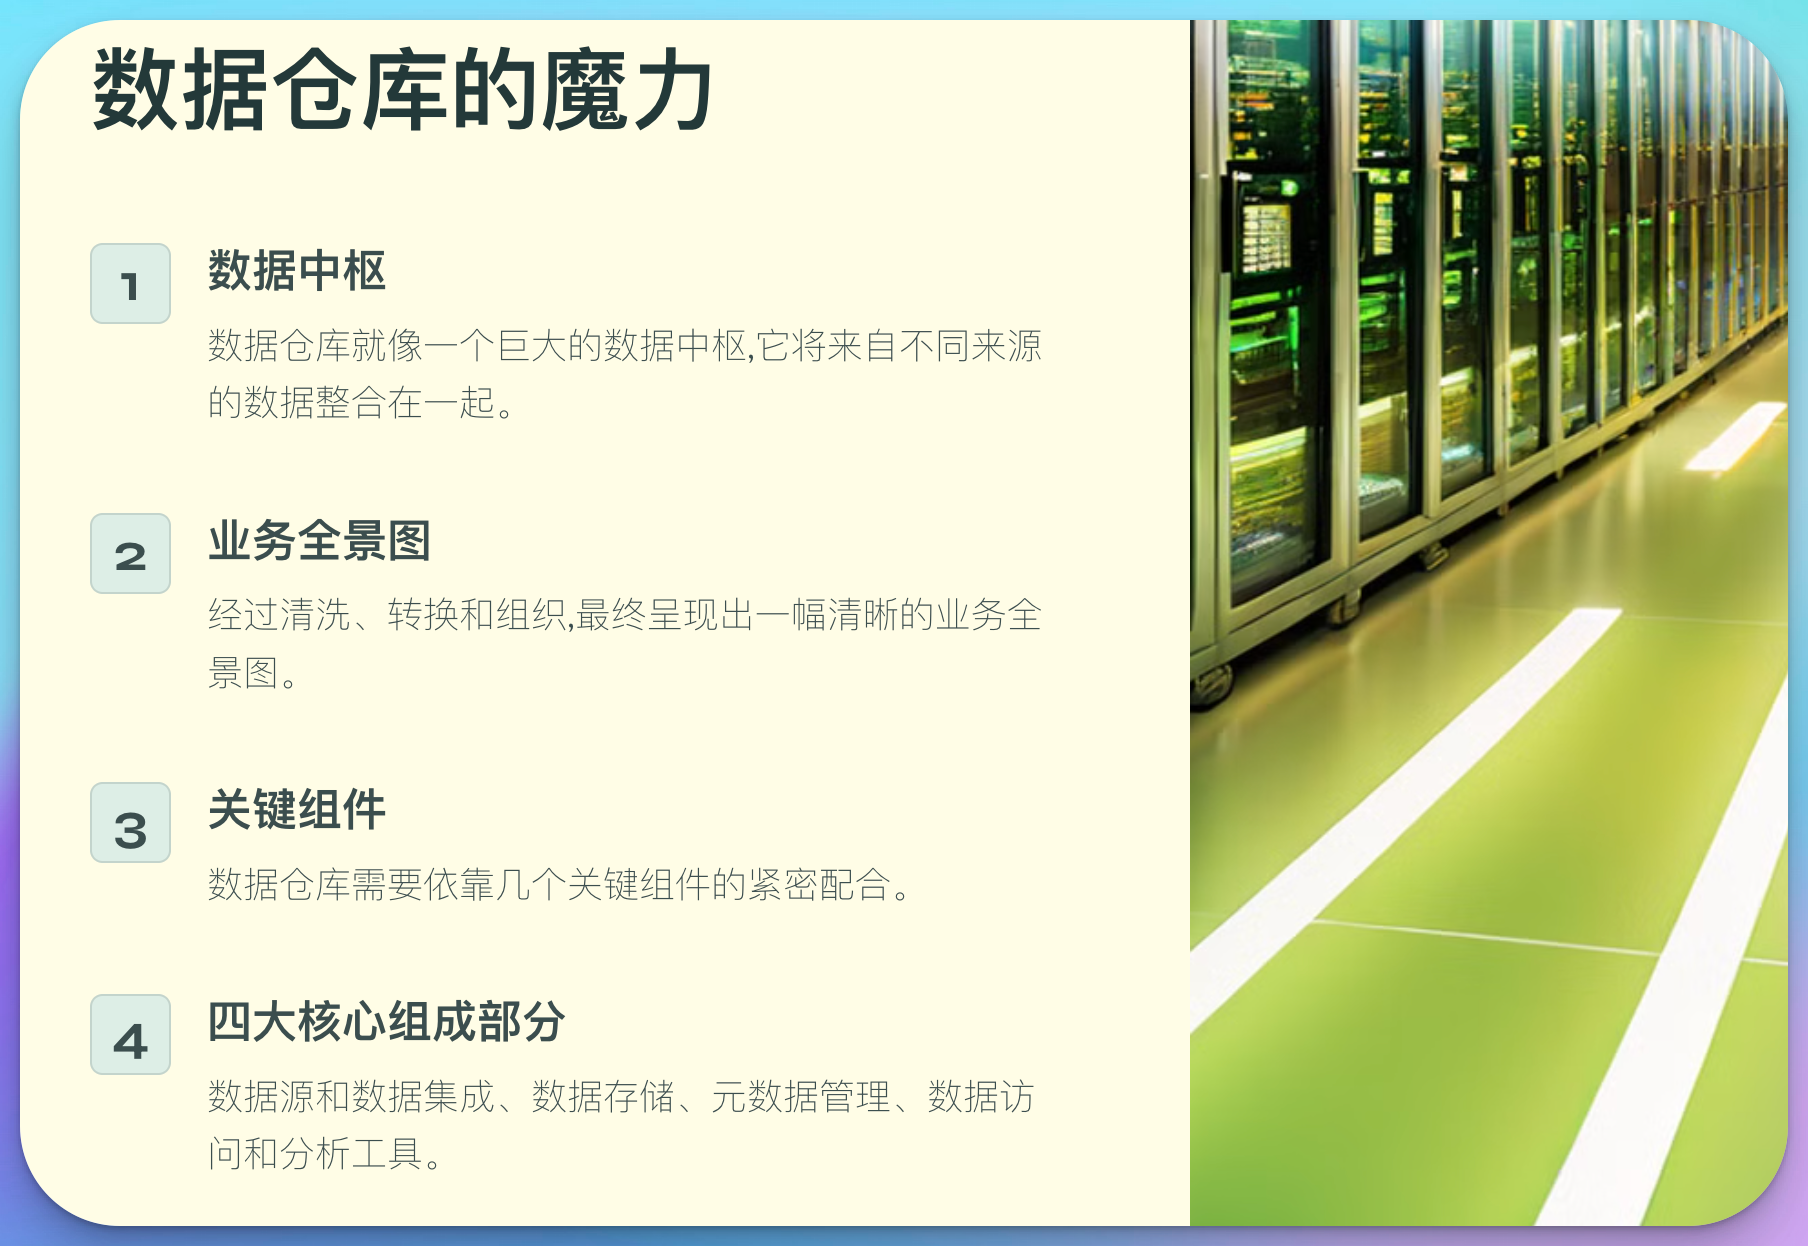
数据仓库就像是一个巨大的数据中枢,它将来自不同来源的数据整合在一起,经过清洗、转换和组织,最终呈现出一幅清晰的业务全景图。但是,要实现这一点,数据仓库需要依靠几个关键组件的紧密配合。
接下来,我们将深入探讨数据仓库的四大核心组成部分:
让我们开始这段探索数据仓库内部结构的奇妙旅程吧!
1. 数据源和数据集成:数据仓库的\”进水口\”
1.1 多样化的数据源
数据仓库的第一个关键组成部分是数据源。在我们的电子商务公司示例中,数据可能来自以下几个方面:
- 交易系统:记录每一笔订单的详细信息
- 客户关系管理(CRM)系统:存储客户的个人信息和互动历史
- 库存管理系统:跟踪产品库存和供应链信息
- 网站和移动应用:捕获用户行为数据,如浏览历史、点击流等
- 社交媒体平台:收集客户评论和反馈
- 外部数据源:如市场调研报告、竞争对手信息等
这些数据源的格式可能各不相同,有结构化的(如关系型数据库中的表格数据),也有半结构化的(如JSON或XML格式的日志文件),还有非结构化的(如客户评论文本)。 
1.2 数据集成:ETL过程
将这些杂乱的数据转化为有意义的信息,需要经过一个被称为ETL(Extract, Transform, Load)的过程:
让我们通过一个具体的例子来说明ETL过程:
假设我们需要整合来自交易系统和CRM系统的数据,以分析客户购买行为。
import pandas as pd
from sqlalchemy import create_engine
# 连接到源数据库
transaction_db = create_engine(\’postgresql://user:password@localhost:5432/transaction_db\’)
crm_db = create_engine(\’mysql://user:password@localhost:3306/crm_db\’)
# 提取数据
transactions = pd.read_sql(\”SELECT * FROM orders WHERE date >= \’2023-01-01\’\”, transaction_db)
customers = pd.read_sql(\”SELECT * FROM customers\”, crm_db)
# 转换数据
# 1. 统一日期格式
transactions[\’date\’] = pd.to_datetime(transactions[\’date\’])
# 2. 合并客户信息
merged_data = pd.merge(transactions, customers, on=\’customer_id\’, how=\’left\’)
# 3. 计算客户总消费金额
customer_spending = merged_data.groupby(\’customer_id\’)[\’amount\’].sum().reset_index()
# 4. categorize客户
def categorize_customer(spend):
if spend > 1000:
return \’VIP\’
elif spend > 500:
return \’Regular\’
else:
return \’Occasional\’
customer_spending[\’category\’] = customer_spending[\’amount\’].apply(categorize_customer)
# 连接到数据仓库
data_warehouse = create_engine(\’postgresql://user:password@localhost:5432/data_warehouse\’)
# 加载数据到数据仓库
customer_spending.to_sql(\’customer_segments\’, data_warehouse, if_exists=\’replace\’, index=False)
在这个例子中,我们:
这个过程看似简单,但在实际的大规模数据仓库中,ETL过程可能要处理数百个数据源,涉及复杂的业务规则和数据质量检查。因此,许多公司会使用专门的ETL工具来管理这个过程,如Apache NiFi、Talend或Informatica。 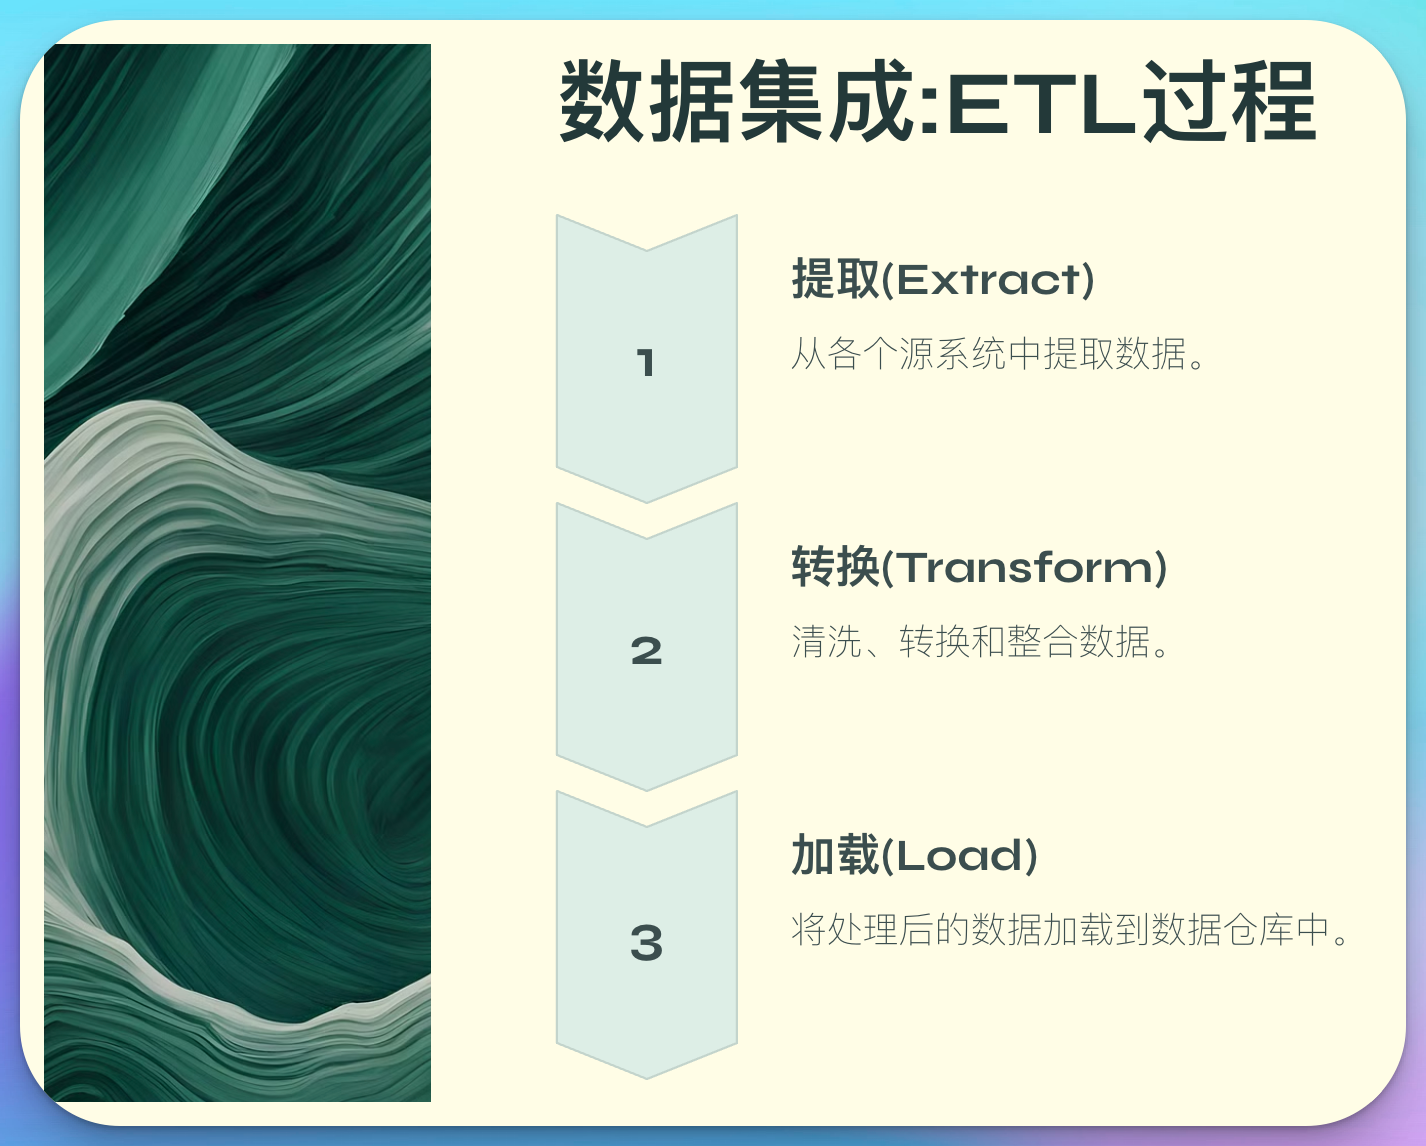
1.3 实时数据集成:从批处理到流处理
随着业务对实时数据的需求增加,传统的批量ETL过程正在向实时或近实时的数据集成方式演变。这种方式通常被称为ELT(Extract, Load, Transform)或流式ETL。
在ELT模式下,数据首先被提取并直接加载到数据仓库或数据湖中,然后在目标系统中进行转换。这种方法的优势在于可以更快地获取原始数据,并且可以根据需要灵活地进行转换。
以下是一个使用Apache Kafka和Apache Flink进行实时数据集成的简化示例:
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
public class RealTimeETL {
public static void main(String[] args) throws Exception {
final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// 配置Kafka消费者
Properties properties = new Properties();
properties.setProperty(\”bootstrap.servers\”, \”localhost:9092\”);
properties.setProperty(\”group.id\”, \”test\”);
FlinkKafkaConsumer<String> consumer = new FlinkKafkaConsumer<>(\”topic\”, new SimpleStringSchema(), properties);
// 创建数据流
DataStream<String> stream = env.addSource(consumer);
// 数据转换
DataStream<CustomerEvent> customerEvents = stream
.map(json -> parseJson(json)) // 解析JSON
.filter(event -> event.getType().equals(\”PURCHASE\”)) // 只处理购买事件
.map(event -> enrichCustomerData(event)); // 使用CRM数据丰富事件信息
// 数据汇总
DataStream<CustomerSegment> customerSegments = customerEvents
.keyBy(event -> event.getCustomerId())
.window(TumblingEventTimeWindows.of(Time.hours(1)))
.aggregate(new CustomerSegmentAggregator());
// 输出结果到数据仓库
customerSegments.addSink(new JdbcSink<>(
\”INSERT INTO customer_segments (customer_id, total_spend, segment) VALUES (?, ?, ?)\”,
new JdbcStatementBuilder<CustomerSegment>() {
@Override
public void accept(PreparedStatement statement, CustomerSegment segment) throws SQLException {
statement.setString(1, segment.getCustomerId());
statement.setDouble(2, segment.getTotalSpend());
statement.setString(3, segment.getSegment());
}
},
new JdbcConnectionOptions.JdbcConnectionOptionsBuilder()
.withUrl(\”jdbc:postgresql://localhost:5432/data_warehouse\”)
.withDriverName(\”org.postgresql.Driver\”)
.withUsername(\”user\”)
.withPassword(\”password\”)
.build()
));
env.execute(\”Real-time Customer Segmentation\”);
}
}
这个例子展示了如何:
实时数据集成使得企业能够更快地对市场变化做出反应,例如实时调整定价策略,或者在客户正在浏览网站时推送个性化优惠。 
1.4 数据质量管理
在数据集成过程中,确保数据质量至关重要。常见的数据质量问题包括:
- 缺失值
- 重复数据
- 不一致的格式(如日期格式不统一)
- 错误的数据类型
- 业务规则违反(如负数的价格)
为