论文题目:MixerCSeg: An Efficient Mixer Architecture for Crack Segmentation via Decoupled Mamba Attention(一种基于解耦曼巴注意力的高效混合器结构)
会议:CVPR2026
摘要:特征编码器通过塑造精细纹理和薄结构的表示,在像素级裂纹分割中起着关键作用。现有的基于CNN、Transformer和mamba的模型只捕获了部分所需的空间或结构信息,在复杂裂缝模式的建模中留下了明显的空白。为了解决这个问题,我们提出了MixerCSeg,一个像协调专家团队一样设计的混合器架构,其中像cnn一样的路径专注于局部纹理,变形风格的路径捕获全局依赖关系,而曼巴启发的流模型序列上下文在单个编码器内。MixerCSeg的核心是TransMixer,它探索了曼巴的潜在注意力行为,同时建立了自然表达局部和全球意识的专用路径。为了进一步提高结构保真度,我们引入了空间块处理策略和方向引导边缘门控卷积(DEGConv),以最小的计算开销增强不规则裂纹几何形状下的边缘灵敏度。然后使用空间细化多层次融合(SRF)模块在不增加复杂性的情况下对多尺度细节进行细化。在多个裂纹分割基准测试中进行的大量实验表明,MixerCSeg仅以2.05 GFLOPs和2.54 M参数实现了最先进的性能,既高效又具有强大的表征能力。
该代码可从https://github.com/ spiderforest/MixerCSeg获得。
MixerCSeg:面向裂缝分割的高效混合架构
一、研究背景与问题动机
随着道路、桥梁等基础设施的老化,裂缝问题日益突出。道路裂缝分割技术作为监测和维护道路健康状况的关键手段,能够及时检测潜在的裂缝威胁。然而,高精度像素级裂缝分割至今仍面临重大挑战,核心难点在于:
- 形态多样性极高:裂缝可能呈线状、网状、树枝状延伸,宽窄不一;
- 纹理分布不均:裂缝区域与背景之间对比度低,背景噪声干扰严重;
- 拓扑结构复杂:裂缝常在多个方向上分叉,形成交叉和重叠路径,极难追踪。
针对上述难点,现有裂缝分割方法主要依赖三类基础架构,但各有明显局限:
(1)CNN-based 方法:具备强大的局部特征提取能力和计算效率优势,代表工作如 DeepCrack、SDDNet、SFIAN、BARNet 等。然而,有限的感受野使其难以有效建模长程像素依赖关系,在处理复杂形态裂缝时表现欠佳。
(2)Transformer-based 方法:借助注意力机制显式建模像素间长程依赖,代表工作如 Crackmer、DTrCNet、CrackFormer 等,性能优于 CNN 方法。然而,注意力机制带来二次方计算复杂度,推理效率大幅下降。
(3)Mamba-based 方法:Mamba 是一种具有线性计算复杂度的全局注意力机制,代表工作如 SCSegamba、CrackMamba 等。但其逐步的数据处理机制限制了在单次前向传播中捕获和利用全局上下文的能力。
在混合架构方面,MambaVision、RestorMixer、VAMBA 等工作已尝试将上述架构组合,但现有混合模型普遍存在一个共同缺陷:仅仅是将不同模块简单顺序或并行堆叠,没有深入分析各架构内在的关系与差异,导致多样架构的优势未能充分发挥。
核心问题总结:如何在一个统一编码器中,让 CNN、Transformer、Mamba 三种路径各司其职、协同互补,同时保持极低的计算开销?
二、核心创新点
针对上述问题,本文提出了 MixerCSeg,一个面向道路裂缝分割的高效混合架构模型,包含三大核心创新组件:
创新点一:TransMixer —— 基于Mamba隐式注意力的解耦混合编码器
本文首先深入分析了 Mamba 模块内部的隐式注意力机制。
在 Mamba 的 SSM(状态空间模型)中,每个时间步的输出可以表达为:
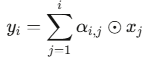
其中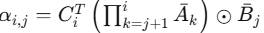 是第j个 token 对第i个 token 的贡献权重,类似于 Transformer 中的注意力分数。
进一步地,时间步长 决定了历史 token 对当前 token 的影响程度:
- 当
 :当前 token 被丢弃,历史 token 被保留(局部注意力行为);
- 当
 > 0$:当前时间步的 token 与历史 token 加权融合(全局注意力行为)。
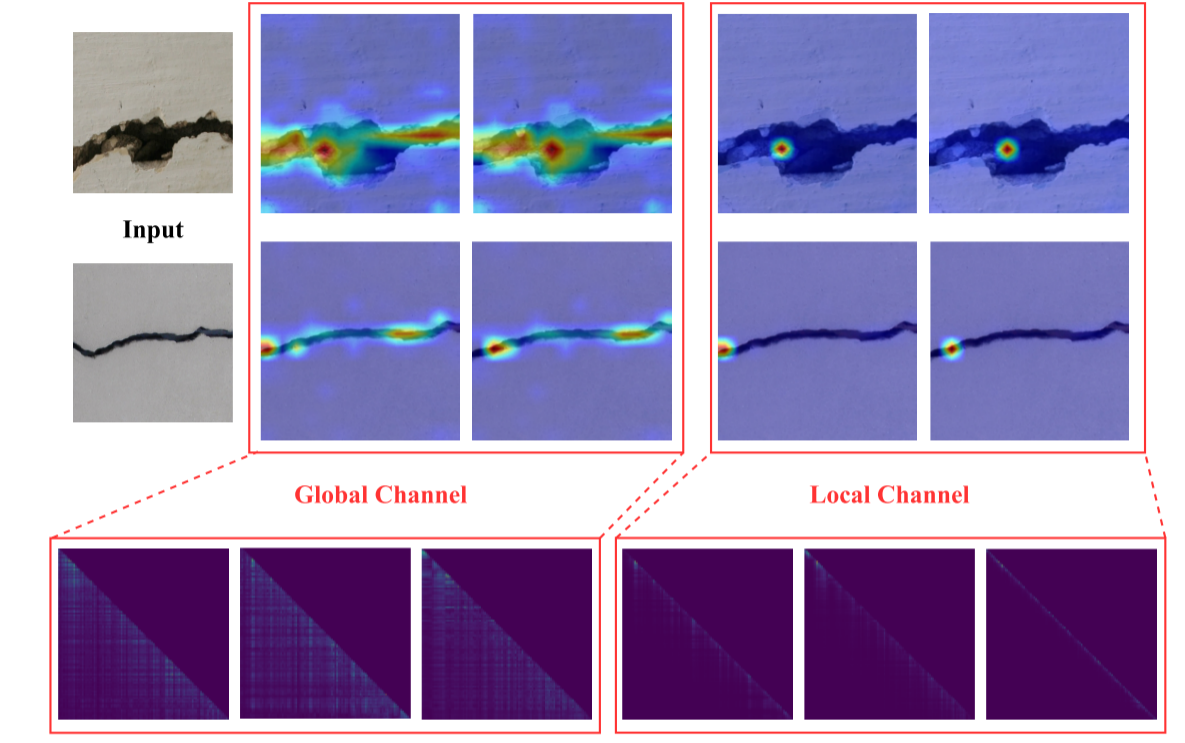
论文图1 —— VMamba 中热力图和注意力图的可视化结果,展示全局通道与局部通道的不同感受野
基于这一发现,TransMixer 的设计思路如下:
在通道维度上排序,将前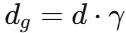 个通道选为全局 token,其余
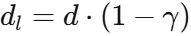 个通道选为局部 token(默认
 );
这种设计使得 CNN 负责局部纹理、Transformer 负责全局依赖、Mamba 负责序列上下文,三者各自承担明确职责,而非简单堆叠。
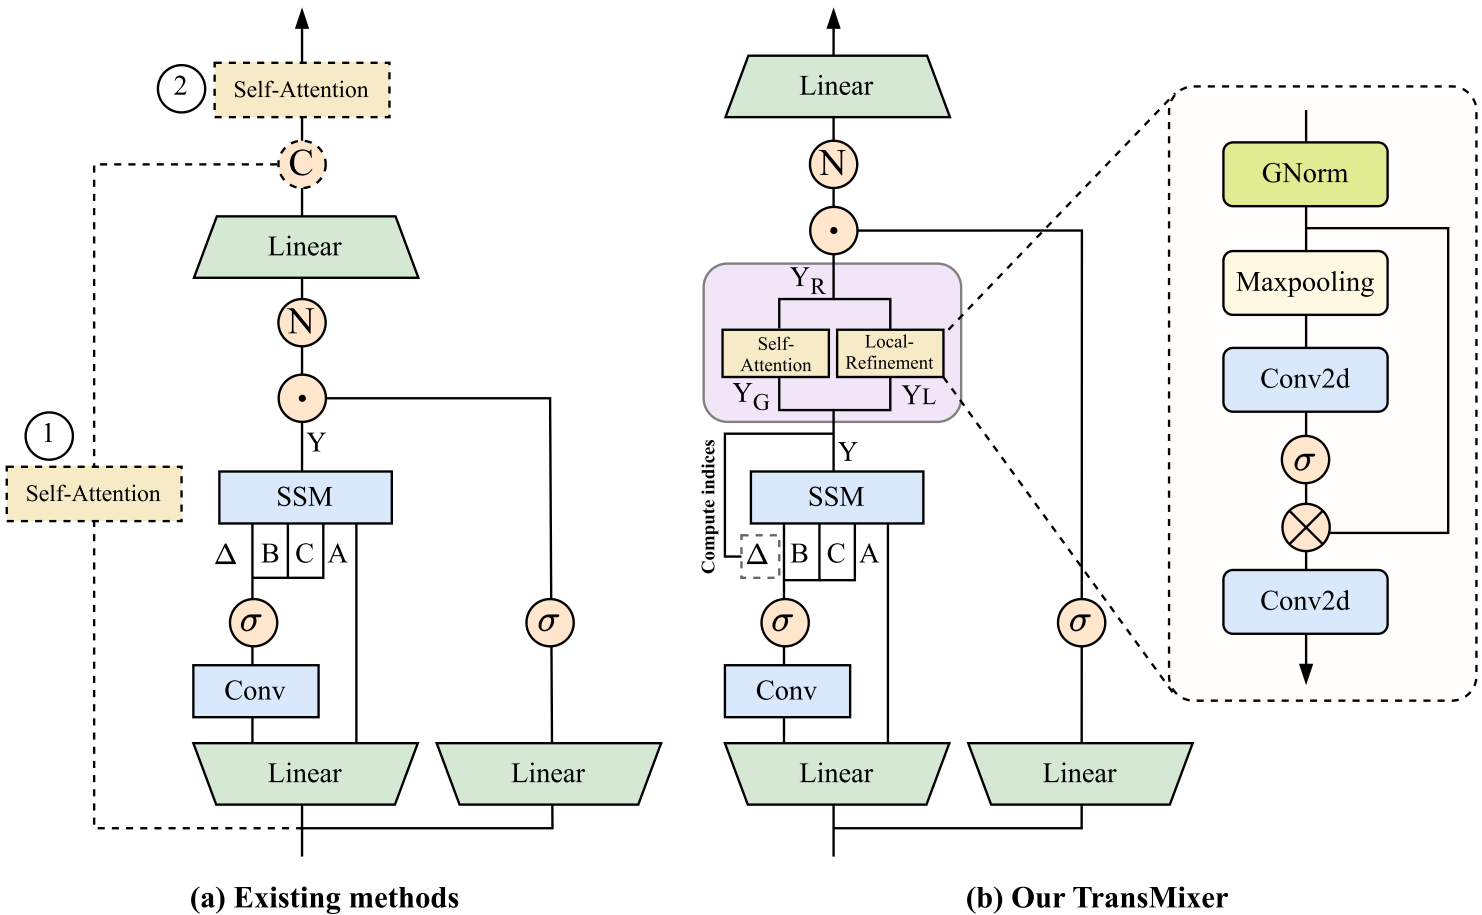
论文图3 —— TransMixer 与现有方法的对比图,展示(a)现有并行/顺序堆叠模式,(b)TransMixer 的全局-局部解耦设计细节
创新点二:DEGConv —— 方向引导的边缘门控卷积
由于裂缝常在多个方向延伸分叉,作者设计了 Direction-guided Edge Gated Convolution(DEGConv) 模块,以极小的计算开销增强对不规则裂缝几何结构的边缘敏感性。
DEGConv 包含四个子步骤:
(1)空间块重排(Rearrange):将特征图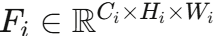 划分为N个不重叠的局部视图,大小为
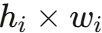 ,实现空间块级处理。
(2)方向嵌入生成(Direction Embedding Generation):
- 利用 Sobel 算子计算每个视图的水平梯度 dx 和垂直梯度 dy;
- 通过反正切函数得到像素级方向角
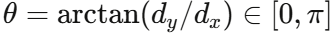 ;
- 将视图进一步划分为若干细胞(cell),并将方向角区间均匀分为n个 bin,统计每个 cell 内各方向 bin 的像素数,加权得到方向直方图特征;
- 最终通过 Conv1×1 和 Conv3×3 将方向先验压缩为方向嵌入向量
 。
(3)边缘卷积(Edge Convolution):采用点卷积降维后,用 1×k 和k×1的条形卷积分别沿水平和垂直方向提取裂缝的方向性特征,并经深度可分离卷积融合输出。
(4)门控机制(Gating):将方向嵌入叠加到特征图后,通过 EdgeConv + Sigmoid 生成门控权重g,再与原始特征的 EdgeConv 输出做逐元素乘法:
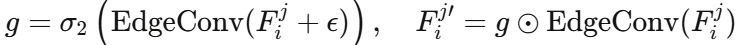
最后,各空间块独立处理完毕后重新排列,并通过一个额外的 EdgeConv 层消除边界错位。
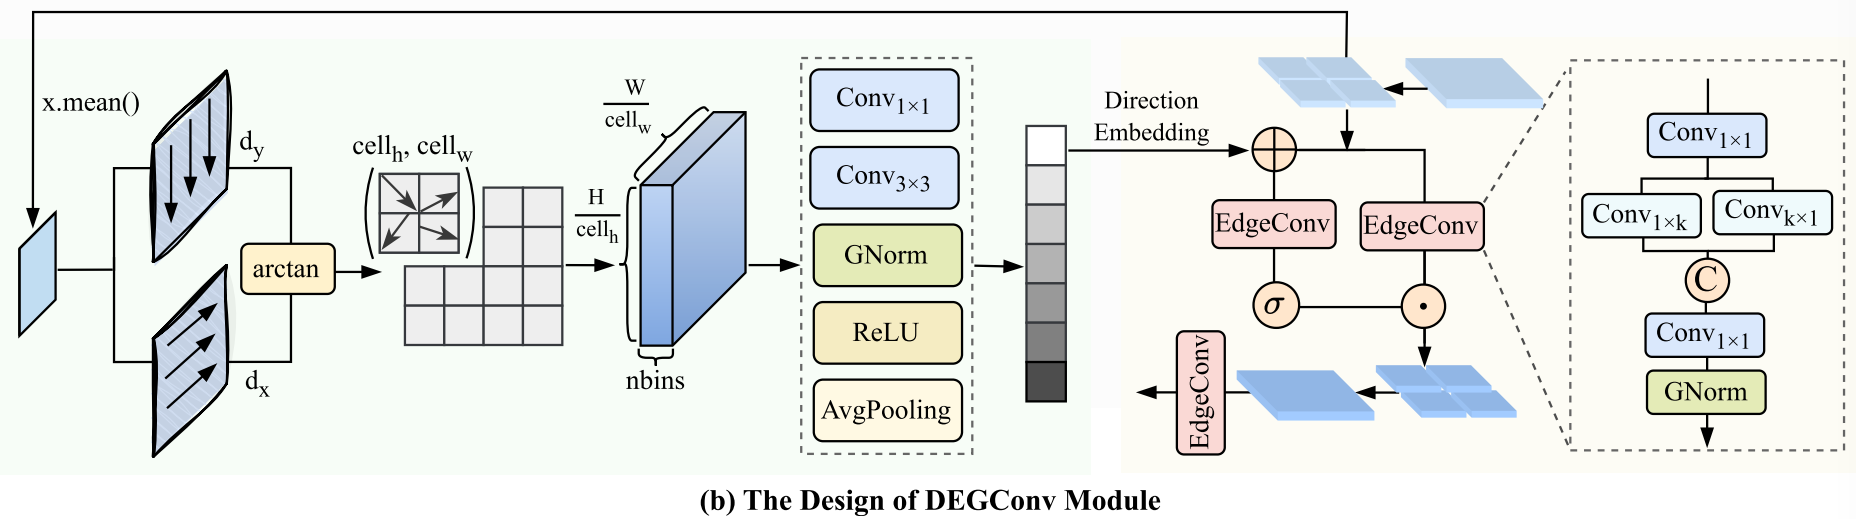
论文图2(b) —— DEGConv 模块的详细设计图,包含方向嵌入生成流程与门控机制
创新点三:SRF —— 空间精化多尺度特征融合模块
直接上采样融合多尺度特征会导致分割边界空间不一致性和边界错位。为此,作者设计了 Spatial Refinement Multi-Level Feature Fusion(SRF)模块。
其核心思路是:用高分辨率特征 的空间注意力图引导低分辨率特征的精化融合:
生成空间注意力图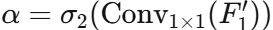 ;
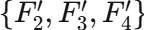 上采样至与相同的空间尺寸;
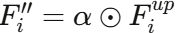 ;
SRF 在不引入额外计算开销的同时,将高层语义与低层细节有效融合。与 SegFormer 解码器相比,SRF 将计算复杂度降低了 89.3%,参数量减少了 33.8%,GPU 内存使用降低了 67.2%,且分割性能同步提升(mIoU 在 DeepCrack 上提升 0.59%,CamCrack789 上提升 0.32%)。

论文图2(a) —— MixerCSeg 整体架构图,展示 TransMixer Block、DownSample、DEGConv 和 SRF Module 的串联关系
三、方法框架总览
MixerCSeg 的整体处理流程如下:
 经过 Stem 层投影为视觉特征;
 ;
 。
损失函数采用 Binary Cross-Entropy(BCE)与 Dice Loss 的混合损失,比例为 1:5。

论文图2 —— MixerCSeg 整体架构图
四、实验设置
数据集
实验在四个裂缝分割基准数据集上进行:
| DeepCrack | 537 | 墙壁、沥青路面、水泥表面等多种场景 |
| Crack500 | 3368 | 含大量背景噪声,裂缝宽度大、曲率小 |
| CamCrack789 | 789 | 多种形态和尺度的裂缝 |
| CrackMap | 120 | 复杂环境下的裂缝图像 |
所有图像均调整为512像素,按 7:1:2 比例随机划分训练/验证/测试集。
评估指标
采用 F1 score、ODS(Optimal Dataset Scale)、OIS(Optimal Image Scale)、mIoU 四项指标全面评估模型性能。
实现细节
- 硬件:单张 NVIDIA A100 GPU
- 训练:50 个 epoch,batch size = 1,AdamW 优化器,初始学习率 5e-4
- DEGConv 中 cell 大小为 8
- bin 数量 n:DeepCrack/CrackMap/CamCrack789 数据集设为 180;Crack500 设为 36(因其裂缝形态简单、曲率小)
五、实验结果
5.1 性能对比
MixerCSeg 与 7 个 SOTA 方法进行比较,包括 U-Net、CarNet、RINDNet、DTrCNet、RestorMixer、SCSegamba 和 MambaVision。

以 DeepCrack 数据集为例,MixerCSeg 取得了最优结果:
- 相比次优模型 SCSegamba,mIoU 提升 1.43%,F1 提升 1.04%;
- 相比混合架构 MambaVision,mIoU 提升 1.78%,F1 提升 4.61%。
在其他三个数据集上,MixerCSeg 同样在多数指标上取得最优或次优性能,展示了方法的泛化性与鲁棒性。
5.2 计算效率对比

MixerCSeg 仅需 2.54M 参数、2.05 GFLOPs,训练显存为 1190 MiB。与专门面向轻量化设计的 SCSegamba 相比:
- 参数量减少 9.3%
- 计算量减少 88.7%(18.16G → 2.05G)
- 显存减少 1016 MiB(2206 → 1190 MiB)
与其他混合架构相比,MixerCSeg 的计算开销几乎是所有对比方法中最低的:MambaVision(642.86G)的计算量是 MixerCSeg 的 313 倍,RestorMixer(98.71G)是其 48 倍。
5.3 定性可视化

在可变尺寸、多样形态以及背景噪声干扰等挑战性场景下,MixerCSeg 能够有效捕获裂缝区域,而对比方法在局部漏检、边缘模糊等问题上均有不同程度的表现。
六、消融实验
6.1 各组件贡献分析

以 VMamba 为编码器、SegFormer 为解码器作为基线,逐步引入 TransMixer、DEGConv、SRF 三个模块:
- 引入 TransMixer:mIoU 在 DeepCrack 上从 0.8826 提升至 0.9016,提升 1.90%;
- 引入 DEGConv:进一步将 mIoU 提升至 0.9097,但计算量仅增加 0.08 GFLOPs,参数增加 0.14M;
- 替换解码器为 SRF:计算量骤降(从 19.18G 降至 2.05G),显存从 3626 MiB 降至 1190 MiB,参数减少 0.1M,同时 mIoU 进一步提升至 0.9151。
6.2 TransMixer 对比不同混合架构编码器

在相同解码器条件下,TransMixer 相比 MambaVision(0.9020)和 RestorMixer(0.9087)均取得更优的 mIoU(0.9151),充分验证了"基于 Mamba 隐式注意力解耦设计"的有效性。
6.3 超参数分析

(1) 全局通道比例 γ:实验对比了 γ ∈ {0.3, 0.5, 0.7, 0.9},结果表明 γ = 0.5 时模型性能最优,偏离 0.5 均导致不同程度的性能下降,与 Mamba 最后一层中全局注意力通道和局部注意力通道数量相近的观察结果一致。
(2) DEGConv 中的 cell 大小:对比 2×2、4×4、8×8 三种配置,8×8性能最优。原因在于裂缝图像中有效裂缝区域占比低,小 cell 对噪声极其敏感。
(3) DEGConv 中的 bin 数量 n:随 n 增大,性能呈先升后降趋势。n 过大时,每个 bin 仅包含单一值,违背了统计细胞内方向分布的初衷;n=180 为 DeepCrack 等数据集的最优值,n=36 适合 Crack500(裂缝曲率小、宽度大)。
6.4 TransMixer 内部结构消融

分别移除全局 token 处理和局部 token 处理:
- 移除整个 TransMixer:mIoU 在 DeepCrack 下降 0.76%;
- 仅保留全局 token:mIoU 为 0.9136;
- 仅保留局部 token:mIoU 为 0.9120;
- 同时保留两者(完整TransMixer):mIoU 最优为 0.9151。
两个子路径缺一不可,各自发挥了不可替代的作用。
6.5 DEGConv 各子组件消融

逐步加入四个子组件后,性能持续提升。其中 DEG(方向嵌入生成) 贡献最显著,在 DeepCrack 和 CamCrack789 上分别提升 mIoU 0.36% 和 0.46%。Rearrange 操作单独贡献较小,但为后续 DEG 和 EdgeConv 提供了结构化的空间输入。
6.6 网络深度分析

在 depth=1 时,模型以 2.05G FLOPs、2.54M 参数 获得最优性能。深度增至 2 时,计算量增加 71.2%,参数增加 87.4%,但性能反而下降。原因在于裂缝分割高度依赖像素级局部细粒度特征,多层传播会导致边缘过平滑问题,且参数优化难度增大。
七、SRF 模块的可视化分析

从可视化结果可以清晰看出,经过 SRF 模块处理后,各尺度特征图中裂缝区域与背景的语义可分性显著增强。原始特征4仅有微弱的纹理响应,但经特征1的高分辨率细节引导精化后,裂缝区域的激活值大幅增强,语义边界更加清晰,有效缓解了高层语义与低层细节融合不足的问题。
八、总结与评价
方法总结
MixerCSeg 提出了一套系统性的裂缝分割解决方案:
主要优势
| 性能 | 在四个裂缝分割基准上达到或超越 SOTA |
| 效率 | 仅 2.05 GFLOPs,2.54M 参数,业界最优水平 |
| 创新性 | 首次从 Mamba 隐式注意力角度出发设计混合编码器 |
| 实用性 | 极低显存(1190 MiB)和参数量,适合边缘设备部署 |
潜在局限
- 方法主要面向裂缝分割场景设计,向更通用的分割任务迁移的验证尚不充分;
- 部分超参数(如 n、cell size)在不同数据集上需要人工调整,自适应选择机制有待探索;
- 对极细微、极低对比度的裂缝检测性能(如 Crack500 数据集)仍有提升空间。