在 Redis 高可用架构中,主从同步是实现读写分离、数据备份的核心机制。本文结合两张流程图,带你一步步拆解全量同步和增量同步的完整过程,让你彻底搞懂主从节点如何保持数据一致。
一、核心概念先铺垫
在看流程图之前,先明确几个关键术语:
- replid(Replication ID):数据集的唯一标记,每个主节点都有独立的 replid,从节点会继承主节点的 replid。如果 replid 一致,说明是同一数据集;不一致则需要全量同步。
- offset(复制偏移量):记录节点同步的字节位置,主节点每发送 N 字节数据,offset 就增加 N;从节点每接收 N 字节,offset 也增加 N。两者 offset 一致,说明数据完全同步。
- repl_backlog(复制积压缓冲区):主节点上的环形缓冲区,保存最近的写命令,用于断连后的增量同步。
二、图 1:初次连接的全量同步流程
这是从节点第一次连接主节点时的完整流程,也是数据差异较大时的同步方式:
建立主从关系从节点执行 replicaof {master_ip} {port} 命令,主动发起与主节点的连接。
从节点请求同步从节点向主节点发送 PSYNC 命令,携带自身记录的 replid(初次为 ?)和 offset(初次为 -1),表示需要同步数据。
主节点判断同步类型主节点检查从节点的 replid:如果是 ? 或与自身 replid 不一致,判定为第一次同步,需要全量复制。
主节点返回版本信息主节点回复 FULLRESYNC {master_replid} {master_offset},告知从节点需要全量同步,并把自己的 replid 和当前 offset 发给从节点。
从节点保存版本信息从节点记录主节点的 replid 和 offset,作为后续同步的基准。
主节点生成 RDB 快照主节点执行 bgsave 命令,fork 子进程生成当前全量数据的 RDB 文件。
主节点发送 RDB 文件主节点将生成的 RDB 文件通过 TCP 连接发送给从节点。
从节点加载 RDB 文件从节点先清空本地旧数据,再接收并加载 RDB 文件,此时数据与主节点生成 RDB 时的状态一致。
主节点缓存新写命令在生成和发送 RDB 的过程中,主节点会把新收到的写命令缓存到 repl_backlog 中,避免数据丢失。
主节点发送缓存命令RDB 发送完成后,主节点将 repl_backlog 中缓存的写命令发送给从节点。
从节点执行缓存命令从节点执行这些命令,让自己的数据与主节点完全同步,此时两者的 offset 保持一致。
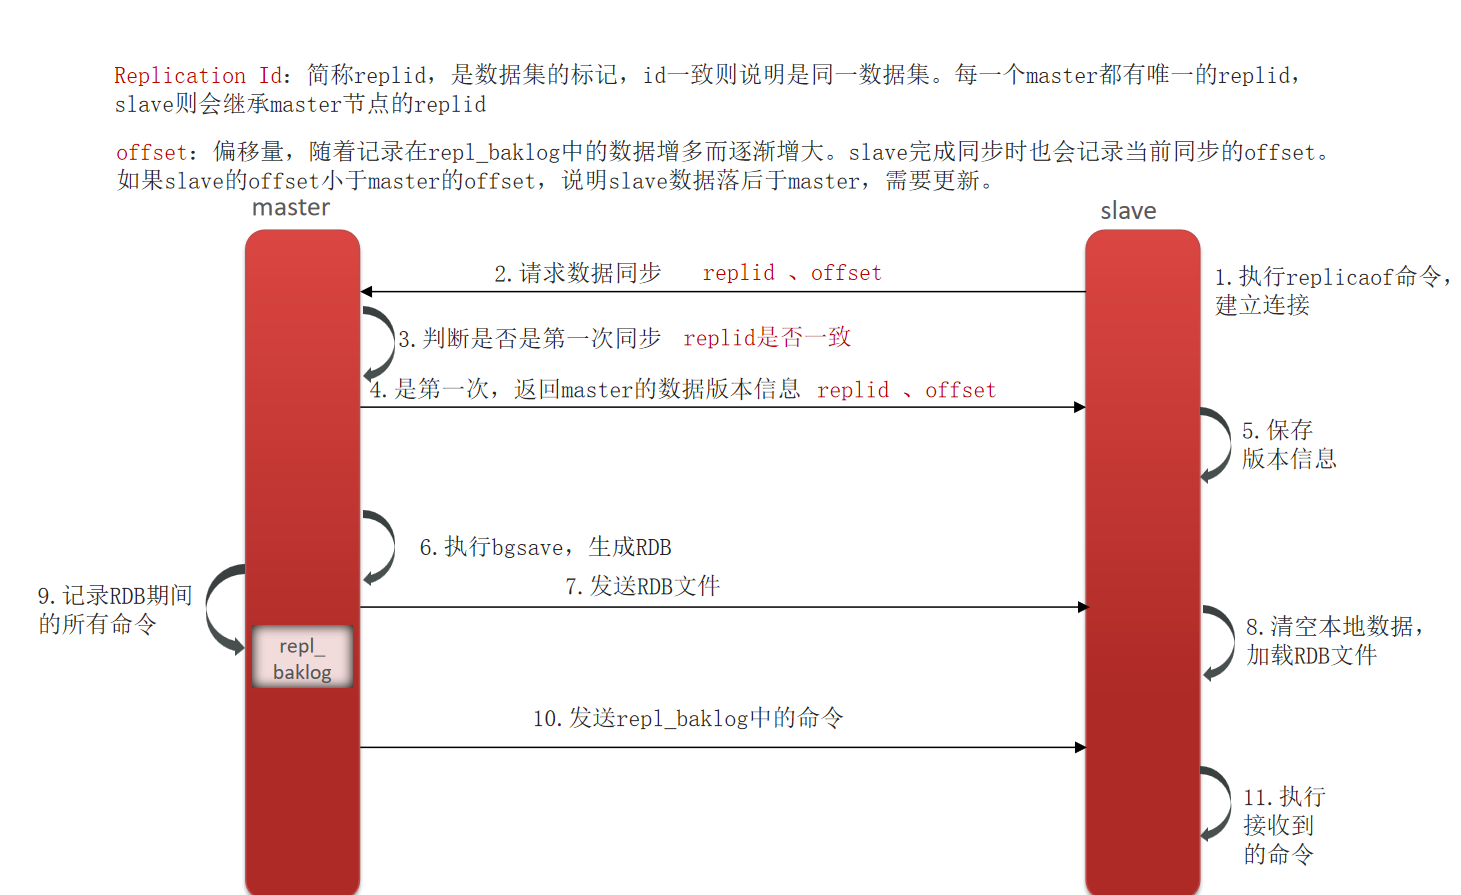
图1
三、图 2:断连重连的增量同步流程
当主从网络短暂中断后,从节点重连时会触发增量同步,避免全量复制的性能开销:
从节点重启 / 重连网络恢复后,从节点主动发起重连请求。
从节点发送同步请求从节点发送 PSYNC {old_replid} {old_offset},携带之前记录的主节点 replid 和自己当前的 offset。
主节点验证一致性主节点检查 old_replid 是否与自身 replid 一致:
- 一致 → 说明是同一数据集,继续下一步。
- 不一致 → 触发全量同步(回到图 1 流程)。
主节点检查偏移量主节点判断从节点的 old_offset 是否在自己 repl_backlog 的覆盖范围内。
主节点返回增量数据如果 old_offset 有效(即 repl_backlog 中仍有该位置之后的命令),主节点回复 CONTINUE。
从节点保存版本信息从节点更新主节点的 replid 和 offset。
主节点发送增量命令主节点将 repl_backlog 中 old_offset 之后的命令发送给从节点。
从节点执行增量命令从节点执行这些命令,快速追平与主节点的 offset,恢复数据一致。
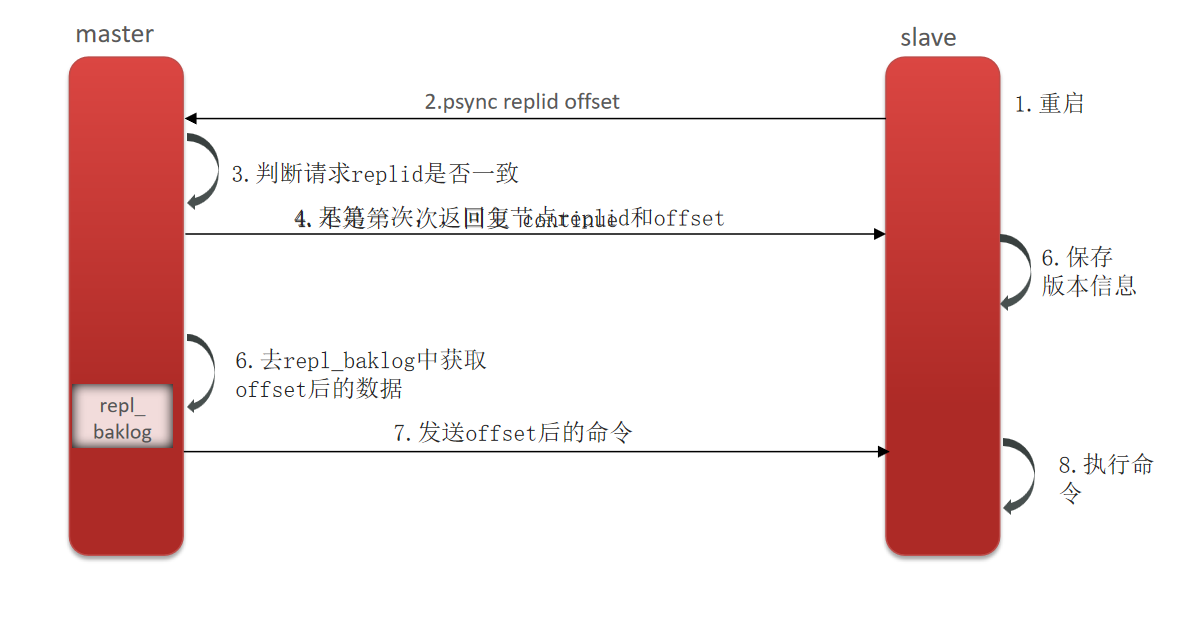
图2
注意:repl_backlog 大小有上限,写满后会覆盖最早的数据。如果 slave 断开时间过久,导致数据被覆盖,则无法实现增量同步,只能再次全量同步。
四、关键配置优化建议
为了减少全量同步的概率,提升同步稳定性,建议在 redis.conf 中配置:
# 复制积压缓冲区大小,建议1GB以上(根据业务写量调整)
repl-backlog-size 1gb
# 无从节点连接时,backlog保留的时间(秒)
repl-backlog-ttl 3600
- repl-backlog-size 越大,能保存的历史命令越多,断连后增量同步的成功率越高。
- repl-backlog-ttl 避免缓冲区长期占用内存,当没有从节点连接时自动释放。
五、总结
- 全量同步:初次连接或数据差异大时触发,通过 RDB 快照 + 缓存命令实现全量数据复制。
- 增量同步:日常同步和断连重连时触发,仅同步主节点新的写命令,效率更高。
- 核心依赖:replid 识别数据集、offset 跟踪同步进度、repl_backlog 支持增量同步。