本文深入剖析了 Agent 技术在大模型落地过程中面临的八大挑战,从模型自身能力到系统级特性,再到多 Agent 协作和工程化难题,详细阐述了每层级的难点与解决方案。文章指出,Agent 技术虽前景广阔,但仍需克服诸多技术瓶颈,才能从实验室走向实际应用,并鼓励读者持续关注行业发展。
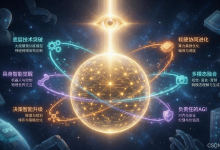
先上一张总结图,后面逐条剖析。

一、写在前面
2025 年大家都在说"Agent 元年",2026 年这一波又改口叫"Agent 工程化年"。但工程化不等于成熟。
我自己用 Agent 这一年多下来,最大的体感是:它真的能干活,但你不能放手不管。让它跑十次相对复杂的工作流,大概有六到七次是顺利的,剩下两三次你会看见它在某个莫名其妙的地方卡住、走偏,或者一脸自信地交付一个错误结果。这种"成功率不够稳"的状态,恰好是 Agent 当前最尴尬的地方——demo 看着很神,跑生产业务就开始掉链子。
为此,这总结了上面这张图:所有让 Agent 真正"能用"的难题,本质上不是模型不够大、不够新,而是模型之外的所有事——它怎么记、怎么想、怎么调工具、怎么和别人配合、怎么被人类信任。换句话说,这不是一个模型问题,是一个系统工程问题。
二、为什么我把它分成三层
8 条难点放在一张图里,乍看是平的。结合跑过几个 Agent 项目以后我发现,它们之间是有清晰的层次的:
底下四条(01–04)是模型自身的能力天花板——靠训练新模型、改架构来推;
中间两条(05、06)是长期运行才暴露的系统级特性——靠工程外挂 + 持续对齐来缓解;
上面两条(07、08)是多 Agent 时代和规模化落地才会出现的工程问题——靠生态、协议、平台来撑。
不同层有不同的解法,也意味着不同的时间表。混在一起谈,容易得出"Agent 还差得远"或者"Agent 已经无所不能"这种简单结论。但真实情况是——有些层已经接近能用,有些层根本还没起步。

三、能力层:模型自身的硬天花板
最底下、也是最显眼的四条,是 Agent 当前能力的"硬件天花板"。这一层最依赖底模和训练范式的进步,最难"工程外挂"补救。

01 复杂任务的规划与推理。一个真实的 Agent 任务往往是几十步:拆目标、拉数据、调工具、改方案、回头检查、写报告。模型现在做单步推理已经很强,但跨几十步的稳定规划仍然脆弱。它会在中间某一步累积一个小错误,然后整条链一起崩。比如我跑的任务是 80 步,第 47 步它把一个变量名记反了,后面 33 步全废,复盘时看不出错在哪——因为它一路都在自我合理化。开放环境里目标拆解和子任务依赖建模,是这一两年最难啃的方向。
02 工具使用的可靠性。Agent 的本事一半来自工具——API、数据库、搜索、计算器、代码沙箱。但模型对工具的理解仍然不够稳:参数生成会漏字段、调用顺序会错、对返回结果的解读会跑偏。最典型的场景是接一个新接口,泛化能力立刻打折,老接口能稳定跑通的逻辑换成新版本就翻车。所以现在很多团队的做法是:给 Agent 喂"工具说明书"还不够,得喂"工具教程 + 错误样例 + 兜底逻辑",几乎是在手把手训练它怎么用每一个工具。
03 记忆与上下文管理。这一条我自己最有感触。所有人都在说"AI 像失忆症患者",可它不是模型不努力——是这件事本身就难。怎么决定哪些信息进短期记忆、哪些沉淀进长期记忆库、哪些到了下次对话该被召回、又该如何让旧记忆不污染新判断,每一步都是工程难题。再叠加一个细节:长对话里上下文窗口虽然到 1M 了,但塞得越满,关键信息丢失的概率反而越高——这叫"中间遗忘/迷失",英文全名是Lost in the Middle 。现在所有大厂都在做记忆系统,没有一家敢说完全解了。
04 环境感知与理解。Agent 不只是处理文字,它要理解屏幕、视频、声音、传感器读数。多模态融合是这两年的进展焦点,但面对带噪声、模糊、不完整的真实信号——比如一张拍糊的发票、一段方言录音、一个加载到一半的网页——模型仍然很挣扎。Demo 里它能"看懂屏幕",真把它丢进一个企业内网的复杂界面,准确率立刻掉一大截。环境越乱、信号越脏,Agent 就越像一个"考过试但没干过活"的新人。
四、进化层:长期跑下来才暴露的问题
第 5 和第 6 条,看起来像两个独立的特性,其实是 Agent 长期运行后才暴露的系统级问题。它们的共同点是:短期看不出来,跑久了就要命。

05 自主学习与自我改进。模型一旦训练好就基本"定型"了。一个 Agent 跑了一千次任务、踩过一百次坑,下一次面对相似任务,它不会变得更聪明——除非你重新训练它,或者用很重的工程手段把经验沉淀出来。这是一个根本性的限制。强化学习、反思机制、经验回放这些方向都在做,但效果距离"真正会从经验中学习"还很远。我打个形象的比比喻:现在的 Agent 更像一个永远在第一天上班的实习生,每天热情满满,但昨天的错误第二天还会再犯。这件事不解决,"Agent 越用越聪明"就只是一句口号。
06 可靠性、可控性与安全性。幻觉问题没归零,关键场合仍然会编;越狱、提示注入、误导仍然能绕过对齐机制;对齐和价值观的控制更多还停留在工程外挂层面,比如外面套一层敏感词过滤、套一层意图分类。安全这件事天然不对称——攻击者只要找到一个漏洞,防御者要堵住所有漏洞。Agent 越能干,越需要笼子。但笼子怎么造、造多结实,本身就是一个全新的工程学科。再往后,随着 Agent 接手越来越多不可逆操作(发邮件、转账、改数据库),可靠性这件事会从"质量问题"升级成"事故问题"。
五、系统层:多 Agent 时代的真正挑战
最上面两条,是当 Agent 不再单打独斗时才会浮出水面的问题。

07 多智能体协作。多个 Agent 同时在线,每个有自己的角色和工具,理论上能做的事更多——但现实是:它们的通信协议不统
一、意图对齐困难、冲突解决机制粗糙。让 5 个 Agent 合作完成一个项目,比让 1 个 Agent 跑 5 倍长的任务更难。原因很简单:单 Agent 的错误是局部的,多 Agent 的错误会通过通信被放大、被传染。一个 Agent 的小幻觉,到了下游 Agent 那里可能变成大事故。群体智能是个美好的词,工程上还远没成立。
08 工程化与成本。模型推理一次几毛到几块,跑一个完整的 Agent 任务几块到几十块。看起来不贵,乘上规模就是个大数字——某些 to B 客户上线 Agent 第一个月,账单直接超出预期 10 倍是常态。系统集成、调试、监控、运维的复杂度也在指数上涨。更麻烦的是,没人说得清"一个 Agent 跑得好不好"该怎么评估——传统的精度、召回率不适用,新的评估体系还在摸索。最近开始有人讲"Agent Eval"专项,但行业共识远未建立。落地过 Agent 的团队都知道:模型选型只是第一步,真正贵的是后面的工程化。
六、哪些进展快、哪些进展慢
光列难点容易让人沮丧,但其实这 8 条里,前进速度并不平均。这一年我观察下来,大致可以分成三档:

进展最快的是第 02 条(工具使用)和第 04 条(环境感知)。MCP 协议这两年统一了模型调工具的接口,主流模型对工具的稳定性提升肉眼可见;多模态从 2024 年到 2026 年从"看图说话"走到了"操作屏幕",是质变。这两条已经从"研究问题"变成"工程问题"——意味着只要砸资源就能往前推。
进展中等的是第 01、06、08 条。复杂任务规划靠 Harness Engineering 在工程层面打补丁,可靠性靠对齐技术 + 外挂式安全层在缓慢推进,工程化和成本靠模型蒸馏 + 推理优化在一点点往下压。这三条都是"工程能补一半、模型还得继续努力"的状态——往前走需要双轮驱动。
最难、也最慢的是第 03、05、07 条——记忆、自我改进、多 Agent 协作。这三条的共同特征是:它们不是工程能补的,是模型本身的范式问题。需要新的训练目标、新的架构、甚至新的硬件支持。短期内别指望大跃进,更现实的预期是"每年挪一点点"。
所以这张图我总结完不悲观也不乐观。Agent 不是"已经无所不能",但也确实不是停滞。它现在的状态像一辆改装得很猛、但底盘还没换的赛车——开起来确实快,但你不能在它过弯的时候松手。
七、写在最后
小结:Agent 真正成熟的标志,不是某个基模发布,而是上面 8 条至少解了 6 条。
这件事不会在一年内完成。但每解一条,都意味着 AI 从"实验室惊喜"往"日常工具"靠近一步。一年前我们对 Agent 的期待是"能不能用",今年的问题已经变成"在哪些场景下值得用",明年大概会是"怎么用得更便宜更稳"。问题在变,方向也在变。
所以下次有人跟你说"Agent 已经无所不能",你可以礼貌地把这张图甩过去——然后告诉他:还差 8 步。但每一步都在走。
最后
2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!
很多程序员、职场新人纷纷入局大模型领域,绝非盲目跟风,而是实实在在看到了不可替代的价值优势,这也是2026年最值得抓住的职业风口:
1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;
2、技术可复用,上手速度翻倍:如果你有前后端开发、测试、数据分析等基础,在大模型落地、系统部署、Prompt工程等环节会更具优势,无需从零开始,复用原有技术能力就能快速进阶;
3、懂业务更吃香,竞争力翻倍:单纯懂技术已不够,2026年大厂更看重“技术+业务”的复合型人才,有垂直领域(金融、医疗、工业等)经验者,能精准定位模型落地痛点,薪资比纯技术岗高出30%以上;
更重要的是,即便没有转型需求,用AI大模型工具为工作赋能、提升效率,也已经成为80%企业的硬性要求——不会用大模型提效,未来很可能被行业淘汰!

那么2026年,小白/程序员该如何高效学习大模型?
很多人想入门大模型,却陷入两大困境:要么到处搜集零散资料,不成体系,越学越懵;要么被收费高昂的课程割韭菜,花了钱却学不到实战技能,白白浪费时间走弯路。
今天就给大家精心整理了一份2026年最新、免费、系统化的AI大模型学习资源包,覆盖从零基础入门到商业实战、从理论沉淀到面试通关的全流程,所有资料均已整理归档,无需拼凑,直接领取就能上手学习,小白可照做,程序员可进阶!

👇👇扫码免费领取全部内容👇👇

1、大模型系统化学习路线
这份学习路线结合2026年行业趋势和新手学习规律,由行业专家精心设计,从零基础到精通,每一步都有明确指引,帮你节省80%的无效学习时间,少走弯路、高效进阶,避免踩坑。

2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

3、大模型学习书籍&电子文档
涵盖2026年最新技术要点,包括基础入门、Transformer核心原理、Prompt工程、RAG实战、模型微调与部署等内容

4、AI大模型最新行业报告
报告包含腾讯、阿里、甲子光年等权威机构发布的核心内容,还有2026年中文大模型基准测评报告、AI Agent行业研究报告等,帮你站在行业前沿,把握技术风口。

5、大模型项目实战&配套源码
项目包含Deepseek R1、GPT项目、MCP项目、RAG实战等热门方向,还有视频配套代码,手把手教你从0到1完成项目开发,既能练手提升技术,又能丰富简历,为求职和职业发展加分。

6、2026大模型大厂面试真题
2026年大模型面试已全面升级,不再单纯考察基础原理,而是转向侧重技术落地和业务结合的综合考察,很多程序员和新手因为缺乏针对性准备,明明技术不错,却在面试中失利。

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
7、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
https://mp.weixin.qq.com/s/7f7iKln9olMBZisBGCsTkA