摘要:我是微学AI,作为一名工程从业者,把自己随口哼出的旋律做成 8 首完整歌曲并发行上线的全过程。内容包括哼唱旋律的数字化归档、AI 演唱与编曲的生成筛选、出品前的音频工程处理、2026 年 AI 音乐合规要点,核心:旋律都是我自己哼的,AI 只是我的歌手。
一、背景
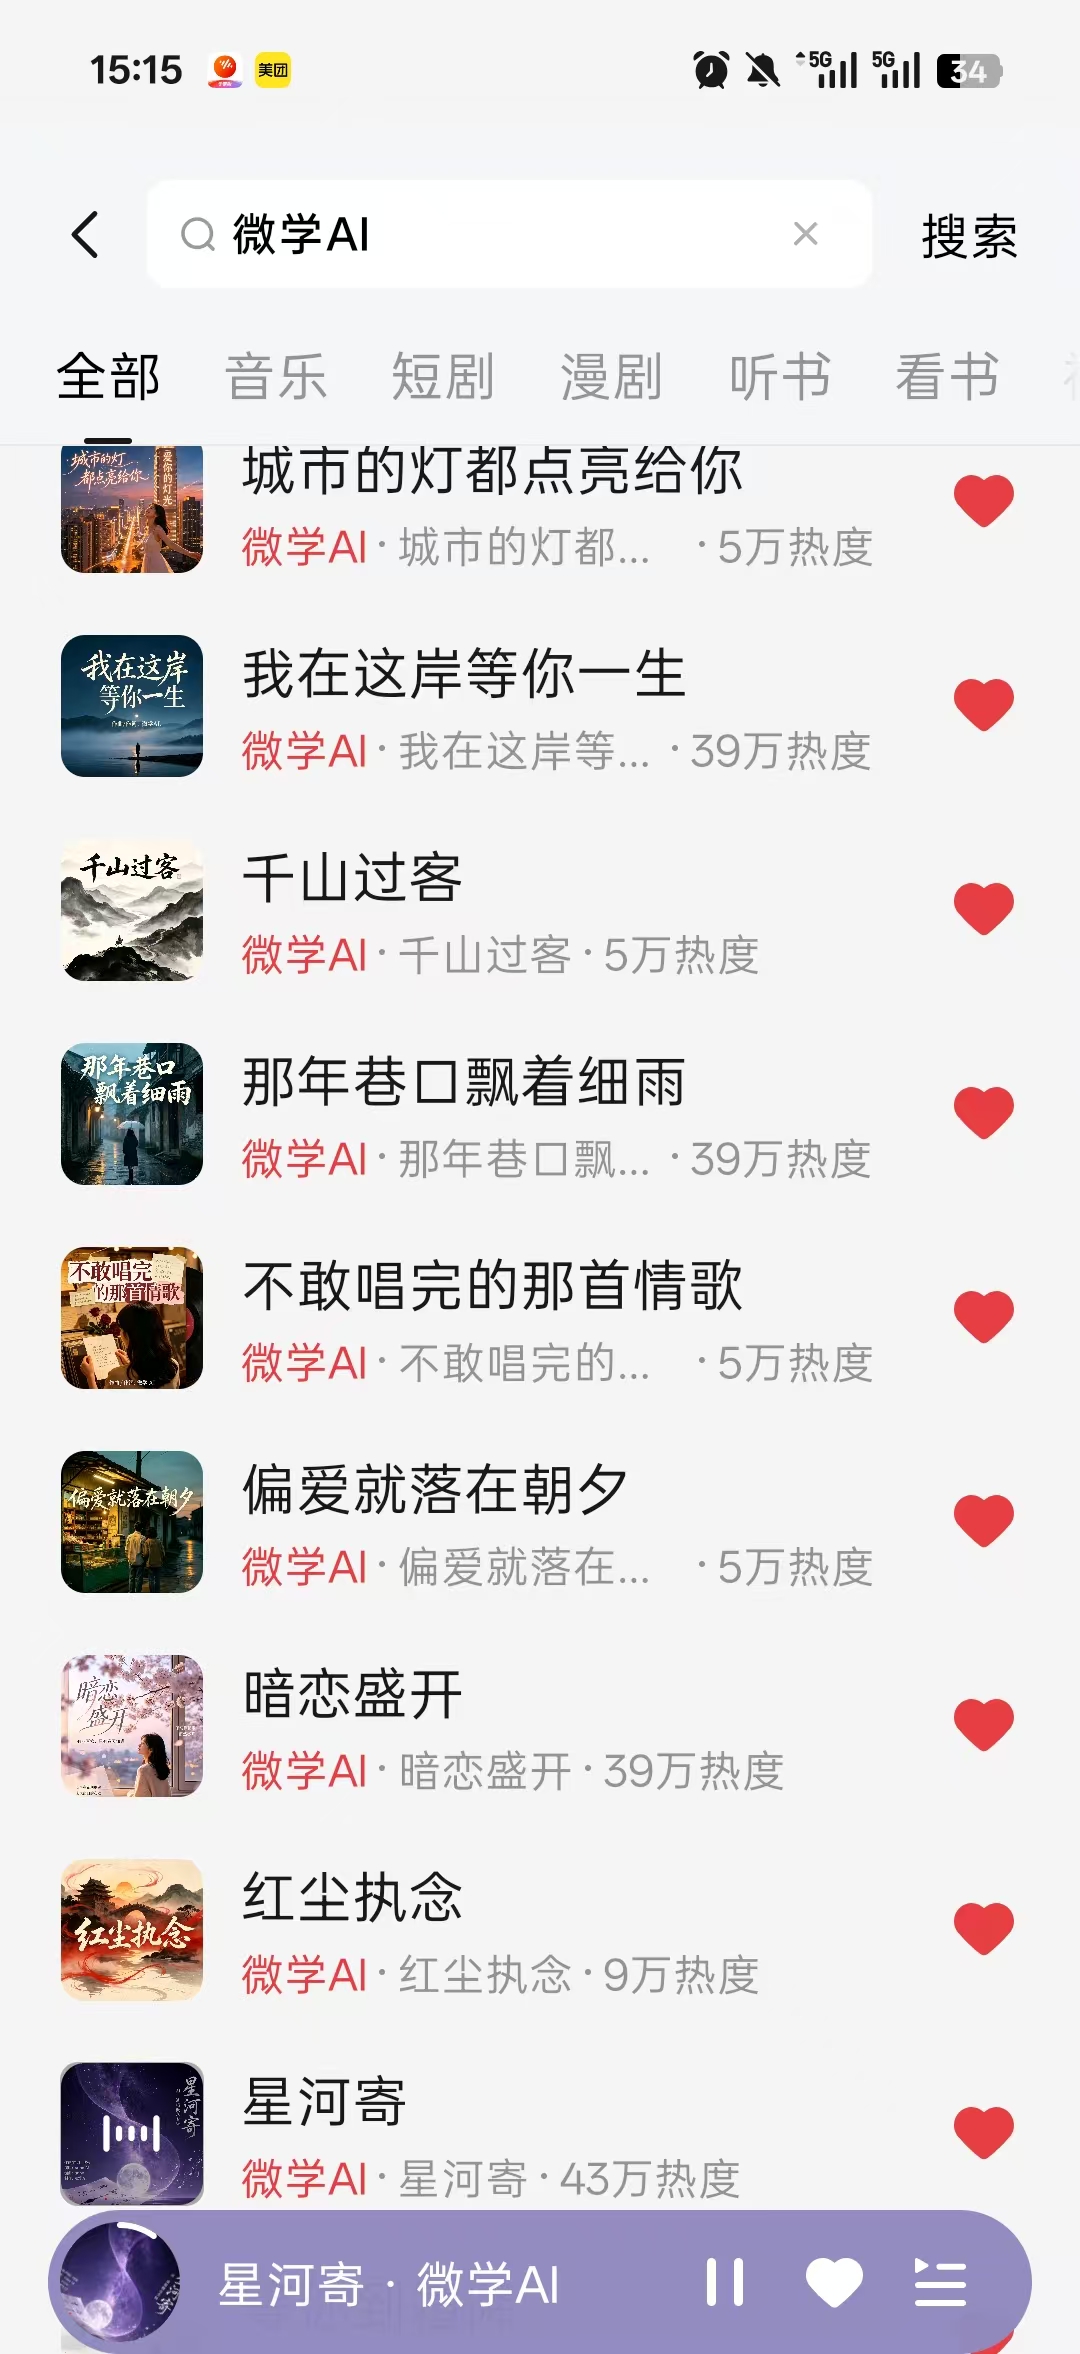
我不是音乐专业出身,但常年随手哼旋律。2026 年开始尝试用 AI 音乐工具把这些片段做成完整作品,累计产出十几首 首并完成发行上架,全部在番茄音乐上架,而且都神曲啊。核心:旋律都是我自己哼的,AI 只是我的歌手。
整个过程和我熟悉的软件开发很像:需求是一段模糊的哼唱,中间要经过"转写—实现—测试—构建—部署"五个环节,每个环节都有自己的工程标准和失败模式。这篇文章就是把这条链路完整摊开,重点讲三件事:
二、整体链路
哼唱录音 → 旋律归档/验证 → AI 编曲演唱 → 多版本筛选 → 音频工程处理 → 元数据标注 → 发行上架 → 数据复盘
原始资产 质量控制 产能环节 人工主导 交付标准 合规红线 冷启动
其中最容易被人忽略、也最容易出事的是这三环:旋律归档(决定版权证据链)、元数据标注(决定作品会不会被下架)、冷启动(决定有没有人听)。下面逐一展开。
三、环节一:哼唱旋律的资产化
3.1 录音标准
手机录音完全够用,但要满足两个底线:采样率不低于 44.1kHz、不要开降噪。手机自带的通话降噪会削掉泛音,后面做音高分析会失真。
统一转成标准 WAV 归档:
ffmpeg -i input.m4a -ar 44100 -ac 2 -c:a pcm_s16le hum.wav
3.2 为什么要归档原始哼唱
这是整条链路里我最想强调的一点:原始哼唱录音是"人类智力投入"最直接的证据。
2026 年国内对 AI 音乐的实际判定口径已经比较清晰——纯一键生成、无任何人工调整的内容无法登记著作权;而人工提供词曲、反复调试、多版筛选、参与编曲决策的作品,著作权归属创作者本人。能不能登记,核心区别就在于你有没有留下证明"这旋律是人写的"的过程材料。
所以我的做法是:
- 每条哼唱原始文件按 日期_编号.wav 命名,永不覆盖;
- 建立一份旋律索引表,记录哼唱时间、场景、当时的想法;
- AI 生成时使用的提示词、每一版生成结果、每一次修改决定,全部留痕。
一份完整的证据链大概是:
evidence/
├─ hum/2026-03-11_01.wav # 原始哼唱
├─ prompt/v3_prompt.txt # 生成提示词及各修改版本
├─ gen/candidate_01~07.mp3 # 候选生成结果
├─ notes/decision.md # 为什么选第 5 版,改了什么
└─ master/final_44.1k_16bit.wav # 最终母带
3.3 验证旋律是否"真的有东西"
我自己哼的旋律往往有比较多的转折,这是它的优点,但也容易在 AI 转写时被"抹平"成套路走向。可以用音高提取做一次客观校验:
# 示例:用 basic-pitch 从哼唱中提取音高序列,导出 MIDI 做比对
# 具体 API 以所安装版本为准
from basic_pitch.inference import predict
model_output, midi_data, note_events = predict("hum.wav")
midi_data.write("melody.mid")
# 输出前 20 个音符,观察音程走向
for n in note_events[:20]:
print(f"start={n[0]:.2f}s end={n[1]:.2f}s pitch={n[2]} vel={n[3]}")
把导出 MIDI 的走向和生成结果做一次人工比对,如果转折处被拉直了,说明提示词约束不够,需要调整而不是接受。
四、环节二:AI 演唱与编曲生成
4.1 多版本生成是必须的
单条生成的可用率很低。我的经验是同一段旋律至少跑 5–7 个候选版本,然后从三个维度筛:
| 旋律保真 | 原始哼唱的转折是否还在,有没有被洗成套路和声走向 |
| 段落完整 | 主歌/预副歌/副歌结构是否清晰,有没有明确的记忆点 |
| 人声自然度 | 换气、咬字、尾音处理是否接近真人,同曲自我制度化感是否过重 |
这里有个反直觉的结论:候选数量不是越多越好。跑 20 个版本往往只是在同一套概率分布里打转,最后挑出来的反而更"平庸"。控制在 5–7 个,每个版本明确改一个变量(乐器配置 / 人声类型 / BPM / 段落长度),比无脑刷量有效得多。
4.2 提示词要写"结构"而不是写"感觉"
把"伤感的歌"换成可执行的参数描述,可用率高很多:
风格:中国风抒情,钢琴 + 弦乐铺底,少量民乐点缀
结构:Intro 8s / Verse 16s / Pre-chorus 8s / Chorus 16s / Verse / Chorus / Outro
速度:72 BPM
调性:A 小调
人声:干净的中音女声,咬字清晰,不做过度颤音
约束:保留原始旋律的音程走向,尤其是第 3–4 小节的转调
最后那句"约束"是关键——它把你的创作意图写进了生成条件,而不是让模型自由发挥。
4.3 声线合规红线
这条必须单独讲:不要克隆任何在世真实歌手的声线。
2026 年在执行层面已经很严格——这涉及声音人格权与表演者权双重侵权,各大平台都在批量清理这类内容。无论用什么工具,"复刻明星音色"只适合自己私下听,一旦上传发行变现就是确凿的侵权。使用工具前务必阅读官方版权条款,尤其是免费账户的出品能否商用、商用是否需要付费订阅,一切以工具官方条款为准。
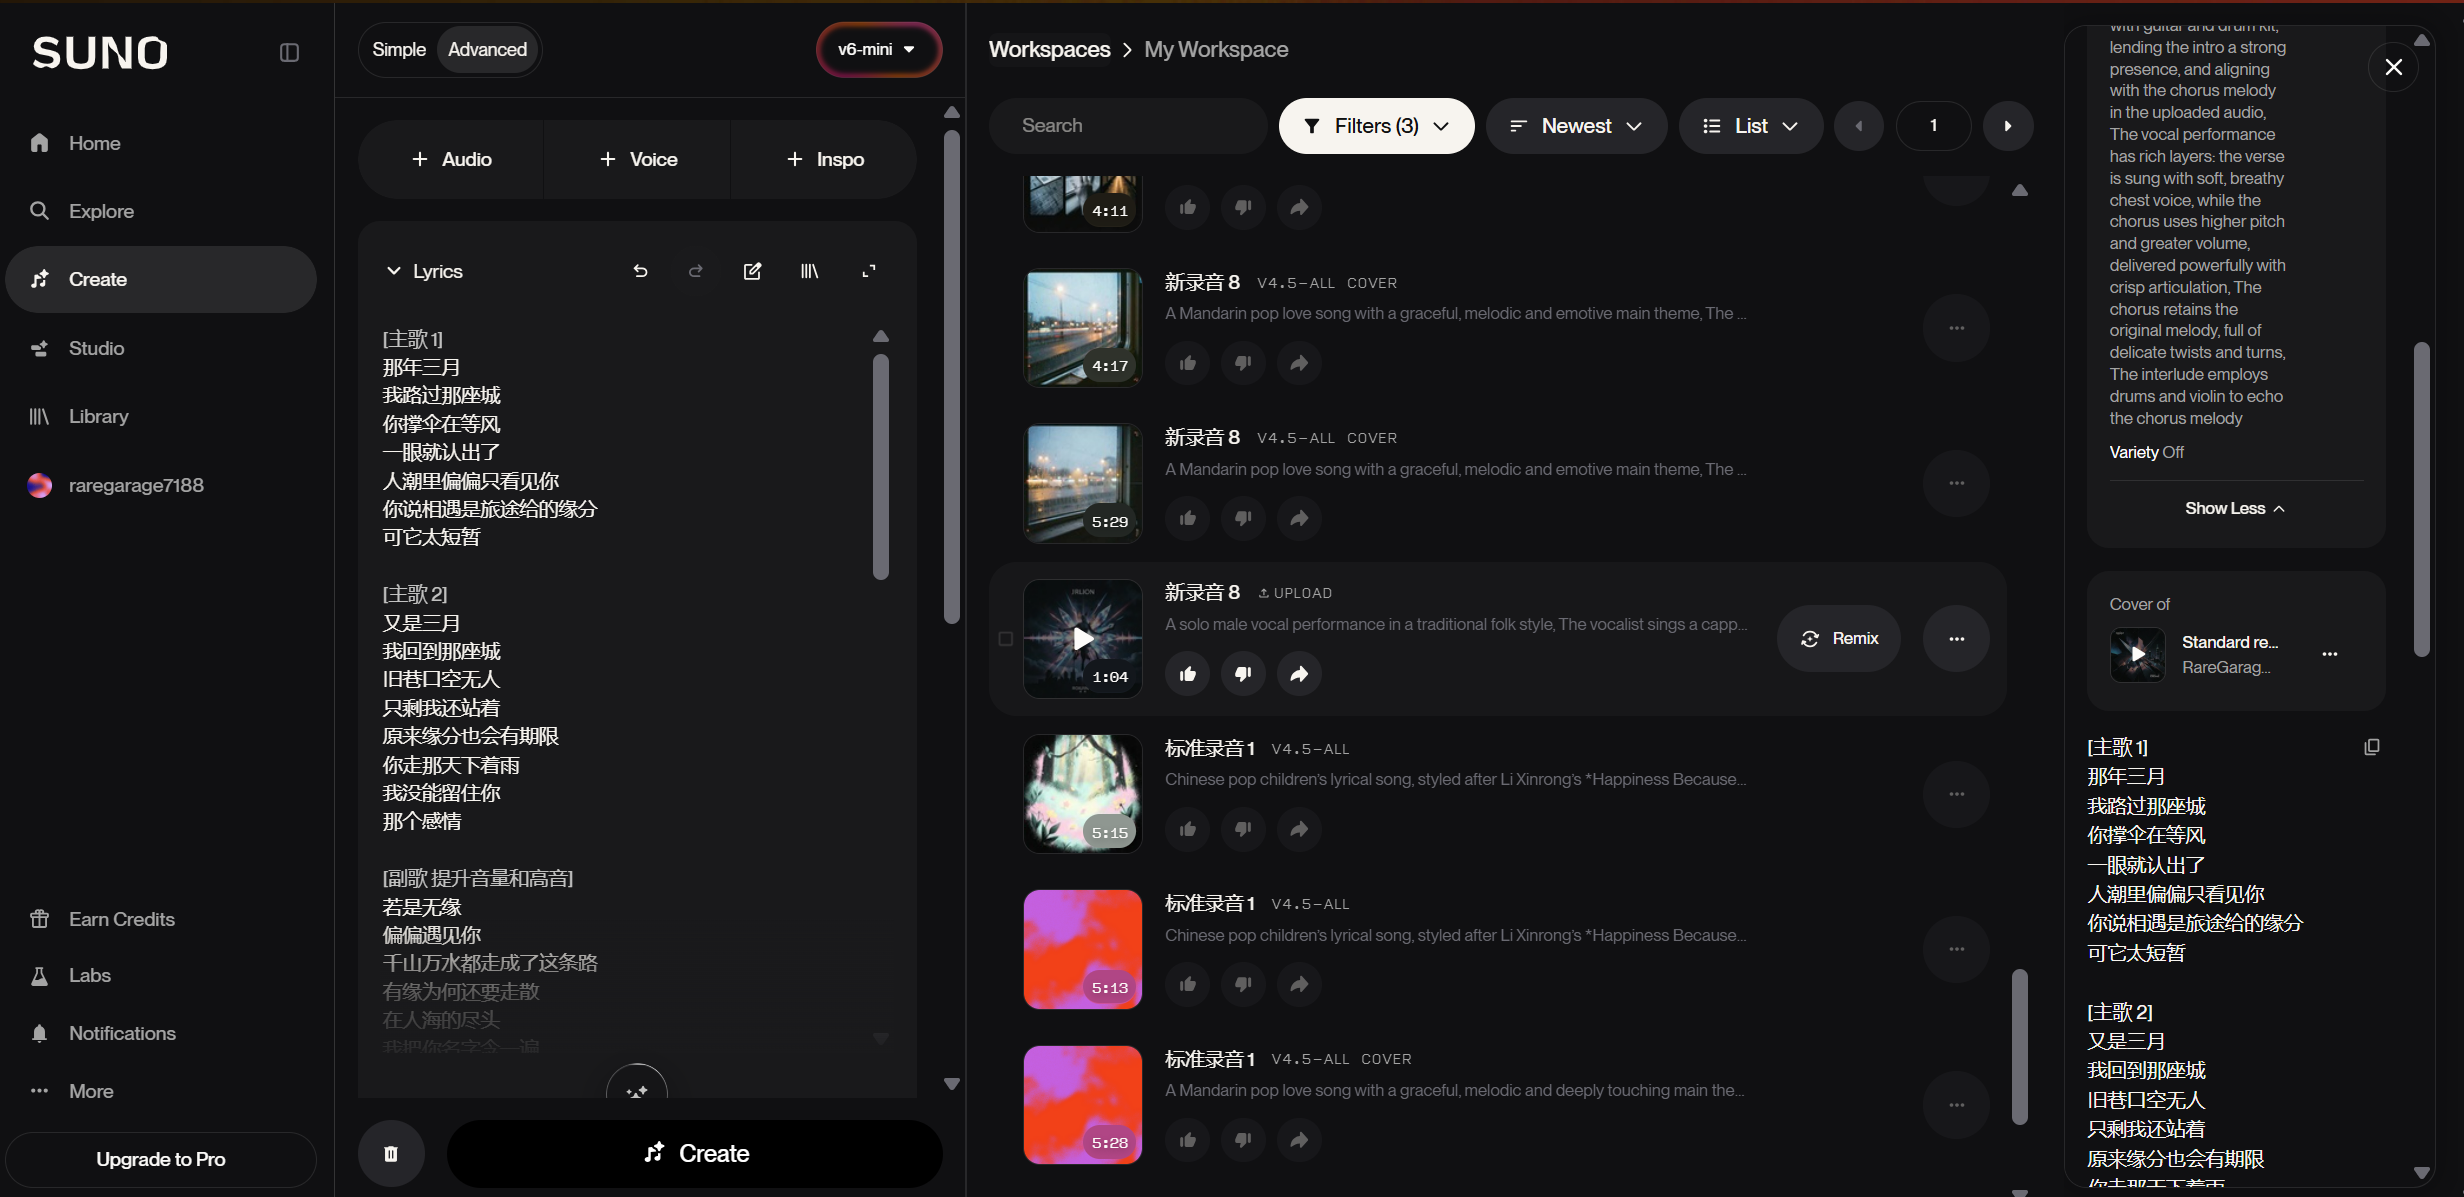
4.4 suno平台帮助我
1.上传哼唱曲目
2.写好歌词,歌词用AI辅助写,这里就不多说了
3.风格提示词:
例如:
prompt:
一首华语流行情歌,主旋律优美婉转,荡气回肠,情感层层递进。上传的音频是副歌阶段旋律,主歌部分旋律另外创作,歌曲融入华丽的花腔式转音,曲调雅致精巧,营造出沉浸式的深深的情感氛围感。旋律适配人声音域,音色婉转悠扬,曲调线条通透。 编曲和伴奏以吉他和架子鼓声音开篇,前奏有气场,符合上传音频的副歌旋律。人声演绎层次丰富,声音要洪亮清晰,真声音演唱,副歌采用较高音与高音量,且有力气,而且演唱声音要清晰;副歌保留原曲旋律,有转折委婉丰富,间奏曲用架子鼓和小提琴贴近副歌的旋律。
五、环节三:出品前的音频工程处理
5.1 平台规格
不同平台要求不同,以我当时投稿的实际门槛为例(请以各自后台当前要求为准):音频时长不低于 1 分 30 秒,封面分辨率不低于 1440×1440,优先提交 WAV 无损。
封面尺寸调整是最容易卡住的一步,用 ImageMagick 批量处理即可:
magick cover.jpg -resize 1440×1440^ -gravity center -extent 1440×1440 cover_final.jpg
5.2 响度标准化
不同平台的回放增益不同,母带建议做一次统一响度处理。常见做法是目标综合响度落在 -16 ~ -14 LUFS、真峰值不超过 -1 dBTP,具体以平台规范为准:
ffmpeg -i master.wav \\
-af loudnorm=I=-16:TP=-1.5:LRA=11 \\
-ar 44100 -c:a pcm_s16le final.wav
不做这一步的后果是:你的歌在别人的歌单里明显偏小声或明显炸耳朵,这两种情况都会直接推高前 3 秒的跳出率。
5.3 人声与伴奏分离
有时需要对某一版生成的伴奏或人声单独再处理,可用 Spleeter 做分轨:
spleeter separate -i song.wav -p spleeter:2stems -o output/
分轨文件的另一个用途是作为原创性证明材料提交——部分平台审核时会要求提供分轨。
六、环节四:发行与合规(2026 年版)
这是最容易翻车的一环,而且翻车代价是作品下架 + 账号扣分。
6.1 强制标识
自 2025 年 9 月 1 日《人工智能生成合成内容标识办法》实施以来,到 2026 年各平台已全面执行双标识:
- 显性标识:作品标题、简介、封面、评论区等显著位置标注 AI 相关属性,不得隐瞒创作方式、不得冒充真人;
- 机器可读标识:平台会在音频元数据中留存溯源信息,人工一般感知不到,但可被后台核查。
务必注意:不要尝试去除底层溯源水印。首次漏标一般是整改提醒,但如果刻意清除或篡改水印,处理会升级到下架、扣分甚至永久封禁。
可以在导出成品时用脚本写入元数据(示例,依封装格式调整):
from mutagen import File
audio = File("final.wav")
audio["ICMT"] = "AI-assisted vocal; melody composed by human author"
audio.save()
6.2 各平台差异
不同平台策略不同,但方向一致:标记透明即可保留收益,隐瞒才会被处置。
- 抖音 / 汽水音乐:上架时勾选 AI 创作标签,系统会重点管控批量流水线的低质内容;
- 网易云音乐:音乐人后台需说明 AI 参与情况,部分类目可能要求提交创作过程存证;
- 腾讯音乐:AI 内容走专门通道,需主动勾选 AI 生成 / AI 辅助,隐瞒直接退稿;
- B 站:AI 翻唱类视频需在标题或简介标注,不标算作误导内容。
核心区别在于——AI 作为辅助工具不影响正常分发,AI 冒充真人才会被处理。这在业内被称为"工具"与"伪装"的分界。
6.3 版权登记
- 纯一键生成、无人工深度参与:无法登记,也不建议商用变现;
- 人工提供词曲、参与编曲与筛选决策:可以以创作者身份申请登记。
建议流程:先做区块链存证(成本低、时效快),再到当地音著协办理纸质登记。各地执行口径会有差异,例如已有地方音著协明确只受理人类深度参与创作的 AI 音乐,纯一键生成不予备案,这个标准大概率会逐步统一。
6.4 签约前务必逐条看授权条款
发行平台的合同要自己读完再签。我遇到过的一类条款是:作品上架后即授予长期甚至永久的权利,且不支持创作者自主下架。如果你的曲子以后打算出售完整版权,签独家之前一定要把这条想清楚。
七、冷启动:一次失败复盘
8 首歌全部上架后,很长一段时间播放数据接近零。这才有意思——这才是真实情况。
7.1 我的数据
| 星河寄 | 43 万 |
| 那年巷口飘着细雨 | 39 万 |
| 暗恋盛开 | 39 万 |
| 爱写下来 | 39 万 |
| 泪痕无人见 | 39 万 |
| 谁把思念种成红豆 | 39 万 |
| 月光漫过青野 | 20 万 |
| 一次次的的相遇 | 20 万 |
两个观察:
7.2 根因分析
结论有点扎心:不是平台不给我机会,是我把"仓库"当成了"发现渠道"。
这类免费+看广告模式的曲库型应用,用户是来找已知歌曲听的,不是来发现陌生人的。上传等于入库,入库不等于分发。平台推荐系统的典型逻辑是:给一小批测试流量 → 看数据反馈 → 数据达标才放量。我的歌零点击零收藏,自然永远拿不到第二批。
再叠加一层行业背景:公开统计显示全网 AI 音乐日均新增已达数万首量级,而整体播放占比不足 3%。这一背景下,指望被系统"发掘"的概率趋近于零。
7.3 复盘方法论
我把它当成一个漏斗诊断问题来处理:
# 伪代码:冷启动漏斗
funnel = {
"曝光": 0, # 平台未给测试流量 → 卡死在第一层
"点击": 0,
"完播": 0,
"收藏": 0,
"分享": 0,
}
# 结论:问题不在转化,在于曝光层根本没流量进入
# 解法:从站外自带流量注入,补齐前 1000 次真实播放
一旦确认瓶颈在最上层,解法就很明确了:在站外内容平台生产钩子内容,人为注入初始流量,再用这批数据去喂平台的推荐算法。
具体到我这批作品,验证下来有效的判断指标只有两个:
| 3 秒完播率 | > 60% | 开头钩子是否成立 |
| 收藏 / 播放比 | > 3% | 作品本身是否打动人(收藏比点赞更真实) |
播放高但收藏低,说明是钩子套路骗了点击,换歌;收藏高但播放低,说明内容没问题而开头不行,换前 3 秒。这两个数字的交叉判断,比任何主观评价都可靠。
7.4 一个过程教训
上架前的信息校验没做好,有一首歌名打成了"一次次的的相遇"(多了一个"的")。这类曲库平台审核通过后不支持修改信息,只能重新发行一版来承接搜索。教训很简单:把歌名、歌词、创作者署名当成发布前的最后一道 code review 清单逐项过。
八、总结
三点可复用的结论:
如果你也在做类似的事,欢迎在评论区交流链路上的具体实现问题,尤其是"如何保持旋律在 AI 生成过程中不被洗平"这一点,我目前的方案还不够好。