MogFace人脸检测镜像技术解析:ResNet101主干+FPN增强+GPU推理加速设计逻辑
1. 引言:从合影人数统计说起
你有没有遇到过这样的场景?公司年会拍了大合影,需要快速统计人数;或者整理家庭相册,想知道每张照片里有多少人。传统方法要么靠肉眼一个个数,既费时又容易出错,要么依赖一些在线工具,又担心照片隐私泄露。
今天要介绍的,就是一个能完美解决这些问题的本地化工具——基于MogFace模型的人脸检测镜像。它就像一个装在你自己电脑上的“智能眼睛”,不仅能快速、准确地找出照片里的每一张脸,还能告诉你它有多“自信”找到了正确目标。
这个工具的核心,是2022年CVPR会议上发表的MogFace模型。但论文归论文,真正要用起来,总会遇到各种工程上的“坑”:比如新版本的PyTorch不兼容旧模型、没有好用的可视化界面、推理速度太慢等等。
我们做的,就是把这些“坑”都填平了。通过修复兼容性问题、搭建直观的操作界面、并利用GPU全力加速,最终把这个学术界的优秀模型,变成了一个开箱即用、高效可靠的实用工具。接下来,我就带你深入看看,这个工具背后有哪些精妙的设计。
2. 核心架构:为什么MogFace能看得更准?
要理解这个工具的强大之处,得先看看它的“大脑”——MogFace模型。这可不是一个普通的人脸检测器,它在设计上针对实际场景中的各种难题,做了三重强化。
2.1 强大的视觉基础:ResNet101主干网络
你可以把检测人脸想象成在一幅画里找特定图案。如果这幅画细节模糊、色彩失真,那找起来就非常困难。因此,第一步是需要一个强大的“视觉系统”,来提取画中最清晰、最有用的信息。
MogFace选择了ResNet101作为它的主干网络(Backbone)。这是一个在图像识别领域久经考验的经典架构,有101层深度。层数多意味着什么?意味着它能从图片中提取出非常丰富和抽象的特征。
- 浅层特征:捕捉边缘、角落、纹理等基础信息(比如脸的轮廓、眼睛的线条)。
- 中层特征:组合基础信息,形成更复杂的模式(比如眼睛、鼻子、嘴巴的局部组合)。
- 深层特征:理解全局的、语义级别的信息(这是一张人脸,这是一个物体)。
这种多层次的特征提取能力,是准确检测的第一步。尤其是对于远处的小脸、或者侧脸,丰富的特征信息是模型做出正确判断的关键依据。
2.2 多尺度的信息融合:FPN特征金字塔
在实际照片中,人脸的大小千差万别。前景中的人脸可能很大,占据半个屏幕;后排或远处的人脸可能只有几十个像素点。一个只在单一尺度上工作的检测器,很容易漏掉那些“非常规”大小的人脸。
MogFace引入了特征金字塔网络(FPN)来解决这个尺度变化问题。它的工作原理很巧妙:
最终,FPN输出了一系列不同尺度的特征图。大尺度的特征图负责检测小目标(远处的小脸),小尺度的特征图负责检测大目标(近处的大脸)。这就好比给了模型一套从“望远镜”到“放大镜”不同倍率的工具,无论人脸大小,都能清晰捕捉。
2.3 针对人脸优化的检测头与损失函数
有了好的特征,还需要一个高效的“决策系统”来告诉模型:哪里是人脸?有多大?这就是检测头(Head)的任务。MogFace的检测头经过专门优化,能更精准地预测人脸框的位置和大小。
更重要的是它的损失函数设计。模型在训练时,需要知道自己预测得“好不好”,从而调整内部参数。MogFace使用了一种经过改进的损失函数,它特别关注那些难以检测的样本,比如被遮挡的、模糊的、或者极端角度的人脸。通过给这些“难题”更高的权重,迫使模型花更多精力去学习如何解决它们,从而在复杂场景下依然保持高鲁棒性。
正是ResNet101、FPN和优化损失函数这三者的结合,让MogFace在面对多尺度、多姿态、部分遮挡的人脸时,依然能交出优秀的答卷,这也是我们选择它作为核心模型的根本原因。
3. 工程实现:如何让模型跑得又快又稳?
模型能力强是一回事,能方便、快速、稳定地用起来是另一回事。我们的镜像在工程实现上,重点解决了三个关键问题:兼容性、可视化和速度。
3.1 兼容性修复:打通新旧版本的桥梁
技术栈的快速迭代有时会带来“断代”问题。MogFace原始模型基于较旧的PyTorch版本,而现在的PyTorch 2.6+在内部接口和数据结构上有了变化,直接加载会导致失败。
我们的核心工作之一就是进行兼容性修复。这不仅仅是改个版本号那么简单,而是需要深入理解模型保存(序列化)和加载(反序列化)的机制,找到新旧版本之间不兼容的API或数据格式,并编写适配代码来平滑过渡。
通过这一层“转换器”,我们确保了最新的PyTorch环境也能无缝运行这个优秀的CVPR 2022模型,用户无需操心复杂的版本降级或环境配置。
3.2 交互界面:Streamlit带来的零门槛操作
对于大多数用户,尤其是非开发者,命令行和代码是令人望而生畏的。为了让工具真正可用,我们使用Streamlit搭建了一个轻量级、交互式的Web界面。
它的设计直观明了:
- 左侧边栏:用于上传图片,支持常见的JPG、PNG格式。
- 主界面双列布局:左边实时显示你上传的原图,右边则展示检测后的结果。这种并排对比的方式,效果一目了然。
- 一键操作:点击“开始检测”按钮,所有复杂的模型加载、推理、后处理过程都在后台自动完成。
- 透明化调试:除了直观的图片结果,我们还提供了“查看原始输出数据”的选项。点击后,你可以看到模型返回的所有原始框坐标和置信度,这对于开发者调试或想深入了解过程的人来说非常有用。
这个界面将技术复杂性完全隐藏,用户需要做的只是:上传图片 -> 点击按钮 -> 查看结果。真正的零门槛。
3.3 性能加速:GPU推理与本地化隐私
速度和隐私是现代应用的两个核心诉求,我们的设计同时满足了这两点。
GPU加速推理:人脸检测涉及大量的矩阵计算,这正是GPU(显卡)的强项。我们在代码中强制指定使用CUDA(NVIDIA GPU的计算平台),当检测开始时,所有的计算任务都会从CPU转移到GPU上执行。对于一张包含多人合影的图片,GPU推理通常能将处理时间从秒级缩短到毫秒级,实现“瞬间”出结果。即使你只有一块消费级的游戏显卡(如GTX 1060以上),也能感受到显著的加速效果。
纯本地运行:所有过程——从图片上传、模型加载到推理计算、结果展示——全部在你的本地计算机上完成。图片数据永远不会离开你的设备,彻底杜绝了上传到云端可能带来的隐私泄露风险。同时,这也意味着没有网络延迟,没有使用次数限制,没有服务费用,你可以随时随地、无限次地使用它。
4. 工具使用全指南
了解了背后的原理,现在让我们看看如何实际使用这个工具。整个过程非常简单,几乎不需要任何技术背景。
4.1 环境启动与界面概览
当你通过镜像启动工具后,在浏览器中打开提供的本地地址(通常是 http://localhost:8501),你会看到如下界面:
如果界面正常加载且没有红色错误提示,说明MogFace模型已经成功加载到你的GPU内存中,准备就绪。
4.2 三步完成人脸检测
整个检测流程可以浓缩为三个步骤:
第一步:上传图片 在左侧边栏,点击“上传照片”区域,从你的电脑中选择一张包含人脸的图片。工具对合影、单人照、生活照、证件照等都支持良好。上传后,主界面的左侧列会立即显示这张原始图片。
第二步:执行检测 查看右侧列,你会看到一个“开始检测 (Detect)”的按钮。点击它。此时,后台会进行以下操作:
- 将图片预处理成模型需要的格式。
- 送入MogFace模型进行推理。
- 对模型输出的成千上万个候选框进行筛选,只保留置信度高的。
- 在图片上绘制框体和标注。
这个过程在GPU加速下非常快,你会几乎感觉不到等待。
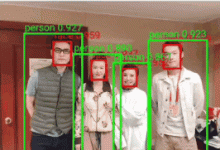
第三步:解读结果 检测完成后,右侧列会更新为结果图片:
- 绿色矩形框:每个检测到的人脸都会被一个绿色方框圈出。
- 置信度分数:在每个绿框的上方,会有一个像“0.98”这样的数字。这代表模型对该检测结果的把握程度,分数越高越可信。我们设定了一个阈值(0.5),只显示置信度高于0.5的结果,以确保准确性。
- 人脸计数:在结果上方,会有明确的文字提示,例如“✅ 成功识别出 15 个人!”,让你一眼就知道总数。
4.3 结果深度查看与调试
对于绝大多数用户,看到带框的图片和人数统计就足够了。但如果你有兴趣,或者遇到某些检测结果想探究原因,可以点击“查看原始输出数据”。
这里会展示模型最原始的输出,是一个包含多个列表的字典。你可以看到所有候选框的坐标(boxes)、置信度(scores)等信息。通过对比原始数据和最终可视化结果,你可以理解模型是如何从大量预测中筛选出最终那几个“正确”人脸的。
5. 实际应用场景展示
这个工具不是一个玩具,它在很多实际场景中都能发挥巨大价值。让我们看几个具体的例子:
场景一:活动合影人数统计 公司团建、会议合影、婚礼现场……活动结束后,组织者经常需要统计参与人数。手动清点数百人的大合影既耗时又易错。使用本工具,只需上传合影照片,一秒内就能获得准确人数,结果还可以截图保存作为记录。
场景二:照片库人脸管理与检索 如果你有一个庞大的个人或家庭照片库,想快速找出所有包含某个人、或者包含人物的照片,这个工具可以作为预处理的第一步。它可以批量处理照片,输出每张照片的人脸数量和人脸位置信息,为后续的归档、分类或搜索建立索引。
场景三:安防与图像分析辅助 在需要监控区域人流量、或者分析特定场景人员构成的场合(需符合法律法规和伦理规范),该工具可以提供快速的初步分析。它能从静态图片中定位每一个人脸,为进一步的分析(如属性分析)提供基础。
场景四:图像内容审核与编辑 对于内容平台或编辑人员,有时需要确认图片中是否包含人物,或者需要对人物进行模糊处理(如打码)。工具可以快速定位所有人脸区域,为后续的自动化或半自动化编辑提供精确的坐标输入。
它的核心优势在于:高精度(得益于MogFace模型)、高速度(GPU加速)、高隐私(完全本地运行)、易使用(可视化界面)。这四者的结合,使得它从众多方案中脱颖而出。
6. 总结
从CVPR 2022的前沿论文,到一个可以一键运行、开箱即用的实用工具,我们为MogFace人脸检测模型搭建了一座通往实际应用的桥梁。
这个工具的技术核心,是融合了ResNet101强大特征提取能力、FPN多尺度感知优化以及针对人脸任务专门设计的MogFace检测架构。而在工程层面,我们解决了新旧框架的兼容性问题,通过Streamlit提供了极致的交互便利,并充分利用GPU硬件将推理速度提升到实时级别,同时坚守了数据隐私的底线。
无论你是需要快速统计合影人数的活动组织者,还是希望管理海量照片的普通用户,亦或是需要进行图像分析的开发者,这个工具都提供了一个高效、准确、私密的解决方案。它证明了,将先进的AI研究成果进行精心打磨和工程化封装,能够真正让技术服务于广泛的实际需求。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。