引言
在当今数据驱动的时代,高效处理海量数据已成为开发者必备技能。Milvus 作为一款开源的向量数据库,专门为 AI 应用(如相似性搜索、推荐系统)而生;而 Redis 作为久经考验的内存数据存储,则是缓存、会话管理和实时应用的利器。本文将手把手教你如何安装、配置并使用这两款强大的数据存储工具,涵盖 Docker、源码编译等多种方式,并提供实战代码示例。
1. 环境准备
在开始安装前,请确保你的系统满足以下基本要求:
- 操作系统:Linux (Ubuntu 20.04/22.04, CentOS 7/8)、macOS 或 Windows (WSL2 推荐)。
- 内存:建议至少 4GB RAM(Milvus 对内存要求较高)。
- 存储:至少 10GB 可用磁盘空间。
- 网络:可访问 Docker Hub 或 GitHub 以下载镜像和源码。
- 权限:确保你有 sudo 权限或管理员权限来安装软件包。
可选工具:
- Docker & Docker Compose:用于容器化部署(强烈推荐)。
- Python 3.8+:用于后续的客户端操作示例。
- Git:用于克隆源码。
2. Milvus 安装指南
Milvus 支持多种部署方式,我们以最常用的 Docker Compose 和 源码编译 为例。
2.1 使用 Docker Compose 安装(推荐)
这是最快、最干净的安装方式,适合开发和测试环境。
下载配置文件
打开终端,执行以下命令下载官方提供的 docker-compose.yml 文件:
wget https://github.com/milvus-io/milvus/releases/download/v2.3.3/milvus-standalone-docker-compose.yml -O docker-compose.yml
启动 Milvus 服务
在包含 docker-compose.yml 文件的目录下,运行:
sudo docker-compose up -d
此命令会拉取并启动 Milvus 及其依赖(如 etcd、minio)的容器。
验证安装
使用以下命令检查容器状态:
sudo docker-compose ps
你应该看到 milvus-standalone、etcd 和 minio 三个容器的状态均为 Up。
连接测试
安装 pymilvus 客户端并运行一个简单的连接测试脚本:
pip install pymilvus
# test_milvus_connection.py
from pymilvus import connections, utility
# 连接到本地 Milvus 服务(默认端口 19530)
connections.connect(alias="default", host='localhost', port='19530')
# 检查连接是否成功
if utility.has_collection("hello_milvus"):
print("连接成功,且存在测试集合。")
else:
print("连接成功,但未找到测试集合。")
2.2 源码编译安装(适用于深度定制)
如果你想了解内部机制或进行定制化开发,可以尝试源码编译。
安装依赖
对于 Ubuntu/Debian 系统:
sudo apt-get update
sudo apt-get install -y g++ cmake make git curl zip unzip
克隆源码并编译
git clone https://github.com/milvus-io/milvus.git
cd milvus
make standalone
编译过程可能需要较长时间(10-30分钟),请耐心等待。
启动 Milvus
编译完成后,进入输出目录并启动:
cd milvus/bin
./milvus run
2.3 安装后配置
- 修改配置:配置文件通常位于 milvus/configs/milvus.yaml(源码安装)或容器内的 /milvus/configs 目录。你可以调整 common.retentionDuration(数据保留时间)、quota.maxMemory(最大内存)等参数。
- 数据持久化:在 Docker 部署中,确保将容器内的 /var/lib/milvus 目录挂载到宿主机,以防止数据丢失。
3. Redis 安装指南
Redis 的安装同样简单,我们介绍 包管理器安装 和 Docker 安装 两种主流方法。
3.1 使用包管理器安装(Linux/macOS)
在 Ubuntu/Debian 上:
sudo apt update
sudo apt install redis-server -y
sudo systemctl start redis-server
sudo systemctl enable redis-server
在 CentOS/RHEL 上:
sudo yum install epel-release -y
sudo yum install redis -y
sudo systemctl start redis
sudo systemctl enable redis
在 macOS 上(使用 Homebrew):
brew install redis
brew services start redis
3.2 使用 Docker 安装
运行一个 Redis 容器非常简单:
docker run –name my-redis -p 6379:6379 -d redis:alpine
如果需要数据持久化,可以添加卷挂载:
docker run –name my-redis -p 6379:6379 -v /path/to/redis/data:/data -d redis:alpine redis-server –appendonly yes
3.3 基本配置与验证
测试连接
使用 Redis 命令行客户端 redis-cli 进行测试:
redis-cli ping
如果返回 PONG,说明服务运行正常。
关键配置
配置文件通常位于 /etc/redis/redis.conf。你可以修改:
- bind 127.0.0.1 → bind 0.0.0.0 (允许远程连接,生产环境需配合密码)
- requirepass yourpassword (设置访问密码)
- maxmemory 256mb (设置最大内存,防止 OOM)
修改后重启服务:sudo systemctl restart redis-server
4. 基础使用与实战示例
安装完成后,让我们通过一些代码示例来快速上手。
4.1 Milvus 基础操作
以下示例演示了如何创建集合、插入向量并进行搜索。
from pymilvus import connections, FieldSchema, CollectionSchema, DataType, Collection, utility
import numpy as np
# 1. 连接
connections.connect("default", host='localhost', port='19530')
# 2. 定义集合模式
fields = [
FieldSchema(name="id", dtype=DataType.INT64, is_primary=True, auto_id=True),
FieldSchema(name="embedding", dtype=DataType.FLOAT_VECTOR, dim=128) # 假设向量维度为128
]
schema = CollectionSchema(fields, description="一个测试向量集合")
collection_name = "test_collection"
# 3. 创建集合
if utility.has_collection(collection_name):
collection = Collection(collection_name)
else:
collection = Collection(collection_name, schema)
# 4. 插入数据
num_entities = 1000
embeddings = np.random.random((num_entities, 128)).tolist() # 生成随机向量
entities = [embeddings]
collection.insert(entities)
collection.flush() # 确保数据持久化
# 5. 创建索引(加速搜索)
index_params = {
"index_type": "IVF_FLAT",
"metric_type": "L2",
"params": {"nlist": 128}
}
collection.create_index(field_name="embedding", index_params=index_params)
collection.load() # 将集合加载到内存
# 6. 向量搜索
search_vectors = np.random.random((1, 128)).tolist()
search_params = {"metric_type": "L2", "params": {"nprobe": 10}}
results = collection.search(
data=search_vectors,
anns_field="embedding",
param=search_params,
limit=5, # 返回最相似的5个结果
output_fields=["id"]
)
for hits in results:
for hit in hits:
print(f"向量ID: {hit.id}, 距离: {hit.distance}")
4.2 Redis 基础操作
以下示例展示了 Redis 作为缓存和简单键值存储的基本用法。
import redis
import json
# 1. 连接 Redis
r = redis.Redis(host='localhost', port=6379, db=0, decode_responses=True)
# 如果设置了密码:redis.Redis(…, password='yourpassword')
# 2. 字符串操作
r.set('user:1000:name', 'Alice')
print(r.get('user:1000:name')) # 输出: Alice
# 3. 哈希操作(存储对象)
user_data = {'age': 30, 'city': 'Beijing'}
r.hset('user:1000:profile', mapping=user_data)
print(r.hgetall('user:1000:profile')) # 输出: {'age': '30', 'city': 'Beijing'}
# 4. 列表操作
r.lpush('task_queue', 'task1', 'task2', 'task3')
task = r.rpop('task_queue') # 从右侧弹出任务
print(f"Processing: {task}")
# 5. 设置过期时间(缓存典型用法)
r.setex('api_response:query123', 300, json.dumps({'data': 'some result'})) # 300秒后过期
cached = r.get('api_response:query123')
if cached:
print(f"Cached data: {json.loads(cached)}")
# 6. 发布/订阅(简单示例)
pubsub = r.pubsub()
pubsub.subscribe('news_channel')
# 在另一个进程或线程中:r.publish('news_channel', 'Breaking News!')
5. 进阶使用与性能调优
5.1 Milvus 性能调优建议
- 索引选择:根据数据规模和查询模式选择索引。IVF_FLAT 适合中等规模、高精度;HNSW 适合大规模、高召回;SCANN 适合超大规模。
- 分区管理:对于超大规模数据集,使用分区(Partition)来提升查询和管理效率。
- 资源监控:使用 milvus-insight(Milvus 的可视化工具)监控集群状态、查询延迟和资源使用情况。
- 批量操作:尽量使用 insert() 批量插入数据,而非单条插入,以提升吞吐量。
5.2 Redis 性能与高可用
- 持久化策略:根据数据重要性在 RDB(快照)和 AOF(追加日志)之间权衡,或同时使用。
- 内存优化:使用 ziplist 编码优化小哈希、列表和集合;启用 maxmemory-policy(如 allkeys-lru)防止内存溢出。
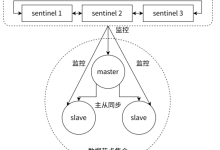
- 主从复制与哨兵:配置主从复制以实现读写分离和数据备份;使用 Redis Sentinel 实现自动故障转移。
- 集群模式:对于海量数据,使用 Redis Cluster 进行分片,实现水平扩展。
6. 常见问题排查(FAQ)
Q1: Milvus 启动失败,提示端口被占用?
A1: 检查 19530、2379(etcd)、9000(minio)端口是否被其他进程占用。使用 sudo lsof -i :端口号 查看并终止冲突进程,或修改 docker-compose.yml 中的端口映射。
Q2: Redis 连接被拒绝?
A2: 检查 Redis 服务是否运行 (systemctl status redis),防火墙是否放行 6379 端口,以及配置文件中 bind 设置是否允许当前客户端 IP 连接。
Q3: Milvus 搜索速度慢?
A3: 1) 确保已为集合创建了合适的索引;2) 检查 search_params 中的 nprobe 参数,值越大精度越高但越慢;3) 确认集合已正确加载 (collection.load())。
Q4: Redis 内存使用率过高?
A4: 1) 检查是否有大量未设置过期时间的键;2) 使用 redis-cli –bigkeys 分析大键;3) 考虑升级 maxmemory 配置或启用淘汰策略。
总结
通过本文,你已经掌握了 Milvus 和 Redis 从安装、配置到基础使用的完整流程。Milvus 帮助你轻松应对向量相似性搜索等 AI 场景,而 Redis 则是提升应用性能的缓存利器。建议在开发环境先用 Docker 快速搭建,生产环境则根据数据量、并发和可用性要求进行细致的配置与集群部署。不断实践,探索它们更强大的高级功能吧!