DAC 2026;Agentic EDA;前端;EDA;DV验证;DFT测试;后端实现;证据化研究AI4EDA;芯片设计;工具链;Benchmark;论文综述
芯片人-晒AI · DAC2026 调研报告
约15000字 / 阅读约25分钟
DAC 2026Agentic EDA前端EDADV验证DFT测试后端实现证据化研究AI4EDA芯片设计工具链Benchmark论文综述
面向芯片架构师与 DE/EDA/DV/DFT/后端团队的证据化研究报告
1. 技术摘要
芯片架构师看AI|研究版
DAC 2026 的清单摊开以后,最容易做的是翻译题名,最容易做错的也是只看题名。这份报告想追的是另一件事,前端 EDA、DV、DFT/Test 和后端实现到底在解哪些约束;Agentic EDA 究竟只是多了个对话入口,还是已经接上工具、验证和回滚;哪些判断有全文撑着,哪些只能停在 Topic、Session 与题名这一层。
报告冻结的总体清单包含 581 项,其中 544 篇是 Research Manuscript,37 篇是 Late Breaking Results;Research Manuscript 覆盖 5 条主 Track、31 个一级 Topic、63 个口头报告 Session。〔CLM-CORPUS-001〕〔CLM-CORPUS-002〕
本地能够逐页核验的公开全文只有 54 篇,其余 527 篇仍是官方元数据。这个比例不是抽样设计的结果,而是公开链接、预印本和作者仓储的可得性结果。因此,报告把 581 项用于「版图与密度」,把 54 篇用于「方法、结果与工程成熟度」,绝不把后者冒充前者的随机样本。〔CLM-COVERAGE-001〕〔CLM-LIMIT-001〕
· · ·
1.1 先给结论
先看会议结构。DAC 2026 的 AI 含量确实高,但「AI 多」和「EDA 已被 Agent 接管」是两回事。官方清单里 Artificial Intelligence 最大,有 158 篇;Electronic Design Automation 139 篇,Design 126 篇。Security、Systems 与 LBR 分别为 64、57、37 篇。AI 已经进了硬件设计会议的主干,不过这组数量不能证明每篇 AI 论文都在推进 EDA。〔CLM-CORPUS-003〕
按工程链重排,后端相关的题名和 Topic 足迹最宽。确定性规则的全标签口径命中前端 EDA 66 篇、DV 28 篇、DFT/Test 7 篇、后端 131 篇。标签允许重叠,它既不是官方 Track,也不是论文质量榜单。〔CLM-TAXONOMY-001〕
前端 EDA 也远不止「LLM 写 RTL」。公开全文里,生成与修复、benchmark 与污染控制、综合/映射算法演化、跨抽象层结构恢复正在同时推进。变化出现在任务边界上,一次性代码生成开始接到生成、综合、等价、QoR、再修改的回路里。SoberDSE、NotSoTiny、Hierarchical Boundary Recovery 和 MappingEvolve 分别落在搜索策略选择、评测基础设施、综合后结构恢复和带硬门的算法演化上。〔CLM-FE-DSE-001〕〔CLM-FE-BENCH-001〕〔CLM-FE-BOUNDARY-001〕〔CLM-FE-AGENT-001〕
DV 是眼下最容易做出可信 Agent 回路的环节,原因很实在。编译过没过、仿真败没败、assertion 有没有被证明、coverage 有没有增长、counterexample 长什么样,都能由工具执行。Agent 受这些信号约束,不必靠自然语言给自己打分。Lyra把生成模型接到 FPGA 加速的差分验证,Stitch把 patch 接到 model checker 与 testsuite,PRO-V-R1把多种程序化工具接进端到端训练回路。LeGend与 miter-aware LEC 还提醒了一点,AI 之外的表示重构,一样能改变形式验证的可解性。〔CLM-DV-LYRA-001〕〔CLM-DV-STITCH-001〕〔CLM-DV-PROV-001〕〔CLM-DV-LEGEND-001〕〔CLM-DV-LEC-001〕
DFT/Test 是证据最薄的一章,也最不能装懂。官方 EDA9 Session 有 7 篇,题名涉及低功耗 LBIST、ATPG-free test-point insertion、wafer defect、lithographic SEM、fault tolerance 与 functional safety;目前恢复的公开全文却是 0/7。题名可以用来辨认研究对象,算法、数据集、PPA 代价和 fault coverage 都不能跟着猜。〔CLM-DFT-001〕〔CLM-COVERAGE-002〕
后端的矛盾不在于学习方法要不要替代传统优化器,而在于近似模型怎样接回离散库、非线性签核、多 corner、物理约束和封装拓扑。Quad-gradient gate sizing、YMCA 与 wafer-on-wafer network design 有个共同点,物理约束一直留在回路里。合法 cell move、nonlinear STA 校准、PVT corner、reticle placement 和能耗/延迟约束,都不是训练结束后再补上的装饰。〔CLM-BE-GATESIZE-001〕〔CLM-BE-YIELD-001〕〔CLM-BE-WAFER-001〕
Agentic EDA 的分水岭是验证门,不是模型尺寸。可核验全文中相对成熟的原型都在收窄自由度,限定编辑区、工具与输出格式,再让编译、仿真、等价检查、model checking 或 QoR evaluator 决定接受、退回还是继续搜索。Agent 自动化的不是猜答案,而是提出候选、调用工具、读取证据,再淘汰错误候选。〔CLM-AGENT-GUARDED-LOOP-001〕
1.2 给工程团队的一句话版本
做芯片设计平台规划时,DAC 2026 更值得带回去的不是「买一个更大的模型」。先把任务改写成可验证的回路;再把模型、工具、数据和验证门的贡献拆开计量;最后列清论文 QoR 与生产签核之间缺的接口、corner、回滚与审计证据。〔CLM-AGENT-MODEL-001〕〔CLM-MATURITY-001〕
· · ·
官方清单:581 · 官方 roster 全部项目,含 Research Manuscript 与 LBR。
Research Manuscript:544 · 用于 Track、Topic 与 Session 分析的 Research Manuscript。
已验证全文:54 · 通过 PDF 文件头、页数、标题与 SHA-256 校验的公开全文;不是随机样本。
一级 Topic:31 · Research Manuscript 覆盖的官方一级 Topic。
口头 Session:63 · Research Manuscript 所属口头报告 Session。
四条技术主线
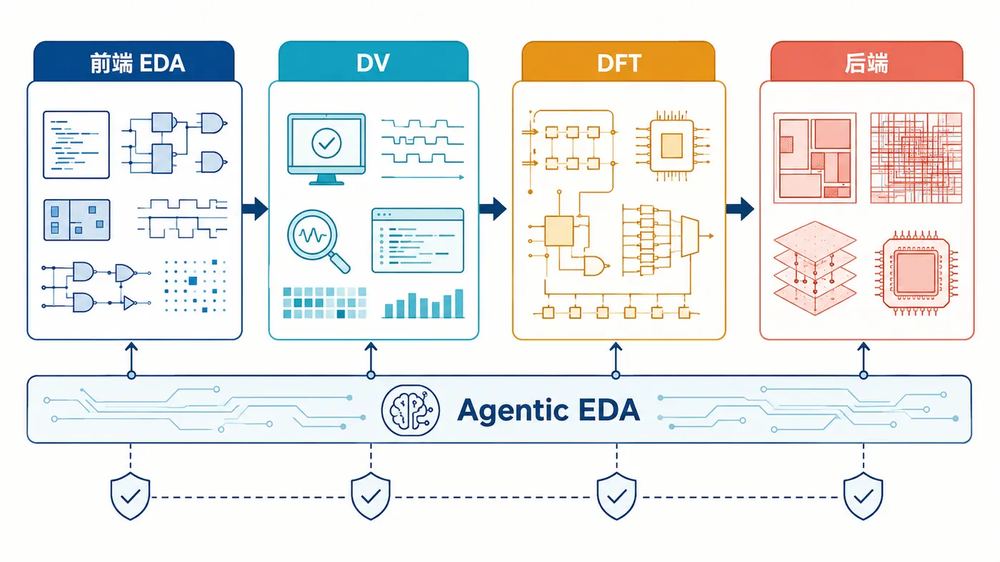
原创解释图(基于本报告归纳):DAC 2026 四条 EDA 技术主线与 Agentic EDA 横切层。。不含论文实验数据。
2. 证据地图与口径
2.1 三层证据,不混着用
报告把证据分成 A、B、C 三层。
A 层:已验证全文。 本地 PDF 必须通过文件存在、%PDF- 文件头、页数、标题覆盖和 SHA-256 一致性校验;随后按页抽取文本,保留 === PAGE N === 标记。A 层允许讨论方法、实验和作者声明的结果,但每条结论必须回到具体页码。
B 层:公开摘要或项目页。 这一层理论上允许核对公开摘要与代码页,但当前恢复结果中没有「只有 B 而没有 A」的条目,因此报告没有用 B 层补齐缺失性能。
C 层:官方 roster、Topic、Session 与题名。 C 层适合回答「有多少、分在哪、题名关注什么」,不适合回答「怎么做、效果多少、是否可复现」。DFT 章节尤其依赖这一边界。
54 篇公开全文占总体清单 9.29%,而且不是随机样本。Track 层覆盖大致落在 2.70% 到 10.76% 之间;按报告主主题看,DV 是 5/22,前端 EDA 是 8/54,后端只有 5/127,DFT/Test 为 0/7。公开全文分布对不同主题的可见度并不均匀。〔CLM-COVERAGE-001〕〔CLM-COVERAGE-002〕
2.2 四主题分类不是官方 Track
官方 Track 适合会议组织,却不完全等于工程 flow。比如 AI1 里可能有 RTL fault localization,EDA1 里可能有 3D/2.5D 系统方法,EDA8 包含 manufacturability 与 reliability。为了回答用户关心的四条链,报告采用「官方 Topic 锚点+题名/Session 语义规则」的双层分类:EDA5 锚定前端,EDA2 锚定 DV,EDA9 锚定 DFT/Test,EDA1、EDA3、EDA4、EDA7、EDA8 锚定后端;跨 Track 的显式语义命中会增加标签但触发复核。
这套规则生成 21 篇多标签论文和 103 篇待复核项;另用更严格的 Agent、multi-agent、self-driving EDA、LLM-guided 等词命中 29 篇 Agentic EDA 候选。这里的「候选」只表示题名或 Session 显式承诺了 Agent 属性,不代表全文已经证明自治程度。〔CLM-TAXONOMY-002〕
2.3 数字为什么不能直接横比
论文摘要里常见「最高提升」「平均改善」「几倍加速」,但这些数字绑定了不同任务、baseline、benchmark、硬件、timeout 和成功定义。比如 Lyra 的端到端加速包含 FPGA 执行平台,MappingEvolve 的「性能提升」、面积降低与综合 score 是三个不同量,Quad-gradient 的结果是百分点差而非相对倍数。报告保留原单位和比较方向,不把它们塞进一张排行榜。〔CLM-DV-LYRA-002〕〔CLM-FE-AGENT-002〕〔CLM-BE-GATESIZE-002〕
更稳妥的阅读方法,是先问四个问题:指标测的是什么;分母和基线是谁;硬件与工具栈是否一致;失败样本、timeout 与不可行解怎么计入。没有这四项,数字越漂亮,越容易被错误搬运。
2.4 图像证据的处理
报告使用的论文原图全部来自已验证 PDF,只裁 Figure/Table 本体及必要图注,不截整页。每张图登记 paper ID、PDF SHA-256、页码、Figure label、crop box 与输出哈希。原创解释图只表达本报告的概念归纳,不放论文实验数值,并显式标注「原创解释图(基于本报告归纳)」。
· · ·
四主线公开全文可得率
四主线公开全文可得率 data
| 前端 EDA | 14.8% | 8 | 54 |
| DV | 22.7% | 5 | 22 |
| DFT/Test | 0% | 0 | 7 |
| 后端 | 3.9% | 5 | 127 |
3. 宏观版图:从 581 项清单看 DAC 2026
3.1 AI 是最大桶,但 EDA 仍是主骨架
按官方清单桶计数,Artificial Intelligence 158 篇,占总体约四分之一;Electronic Design Automation 139 篇,Design 126 篇;Security 64 篇,Systems 57 篇,LBR 37 篇。〔CLM-CORPUS-003〕
AI 已经不是 EDA Track 里零星的应用,它单独撑起了覆盖模型、算法、架构、系统与平台的大 Track。传统 EDA 也没因此缩掉,139 篇仍覆盖 verification、timing、power、synthesis、analog CAD、physical design、manufacturability 与 test。更贴近清单的说法是,AI 方法在往 EDA 对象里渗,EDA 约束也在反过来改造 AI 系统。〔CLM-CORPUS-003〕
一级 Topic 的密度也很有意思。AI2、AI4、AI5 各有 37 篇;EDA7 Physical Design and Verification 有 30 篇;EDA2 有 20 篇;EDA5 有 18 篇。高密度不代表技术成熟,但代表评审供给、作者投入与社区议题的汇聚。〔CLM-CORPUS-004〕
3.2 Session 标题已经把「工具化」写在脸上
与 Agent/LLM 直接相关的 Session 不只一个:Self-Driving EDA: Agents, Benchmarks, and Evolving Toolchains、Silicon Whisperers: When LLMs Learn to Speak RTL、Fast, Smart, and Agentic: Accelerated Verification with Fuzzing, RL, and LLMs、Foundations and Frontiers: Bridging Traditional EDA and Generative AI。这些 Session 名称透露出议题正在从单模型能力扩到 benchmark、toolchain、fuzzing、RL 与 flow integration。
但是,Session 命名是议程信号,不是成熟度证书。研究社区愿意讨论「self-driving」,不等于工具能在无监督条件下改动 signoff flow。报告后面会反复区分三种层次:模型生成候选、Agent 编排工具、系统对结果负责。
3.3 四主线覆盖:宽度与证据深度是两回事
全标签口径下,后端命中 131 篇、前端 EDA 66 篇、DV 28 篇、DFT/Test 7 篇。〔CLM-TAXONOMY-001〕
但全文深度正好不是这个顺序。后端主主题只有 5 篇公开全文,前端 8 篇,DV 5 篇,DFT 为零。〔CLM-COVERAGE-002〕
所以,文章篇幅不能反推会议权重。DV 的全文相对集中,工具反馈也清楚,可以深入到方法;后端在 roster 上最宽,却缺大量 EDA7 原文,宏观判断只能更多依赖 Topic 与题名;DFT 只能画严格的元数据雷达。证据深浅不一,本身就是这次调研必须交代的结果。
3.4 21 篇交叉标签在说什么
多标签不一定是分类器的问题,它往往反映真实的 flow 耦合:RTL 生成要接 verification,logic mapping 会改变 LEC 难度,physical optimization 同时影响 timing 与 power,manufacturability 与 yield 又把后端推到硅生命周期。规则记录了 21 篇多标签项,另有 103 篇语义补充或交叉项等待复核。〔CLM-TAXONOMY-002〕
对工程团队来说,交叉项比纯热词更值得跟踪。因为它们往往卡在团队边界:谁拥有数据,谁定义成功,谁能运行签核工具,谁来接受回归失败。Agentic EDA 最终能不能落地,也通常不是模型团队单方面决定的,而是接口与责任边界决定的。
· · ·
DAC 2026 按官方 Track 的论文分布
DAC 2026 按官方 Track 的论文分布 data
| Artificial Intelligence | 158 | 27.2% | 17 |
| Electronic Design Automation | 139 | 23.9% | 14 |
| Design | 126 | 21.7% | 13 |
| Security | 64 | 11% | 4 |
| Systems | 57 | 9.8% | 5 |
| Late Breaking Results | 37 | 6.4% | 1 |
论文数量最高的一级 Topic
论文数量最高的一级 Topic data
| AI2 · AI/ML Algorithms and Models | 37 | Artificial Intelligence | 6 |
| AI4 · AI/ML Architecture Design | 37 | Artificial Intelligence | 5 |
| AI5 · AI/ML System and Platform Design | 37 | Artificial Intelligence | 2 |
| LBR · Late Breaking Results | 37 | Late Breaking Results | 1 |
| DES2B · In-memory and Near-memory Computing Architectures, Applications and Systems | 31 | Design | 2 |
| DES1 · SoC, Heterogeneous, and Reconfigurable Architectures | 30 | Design | 3 |
| EDA7 · Physical Design and Verification | 30 | Electronic Design Automation | 0 |
| AI3 · AI/ML Application and Infrastructure | 28 | Artificial Intelligence | 2 |
| DES6 · Quantum Computing | 23 | Design | 7 |
| EDA2 · Design Verification and Validation | 20 | Electronic Design Automation | 5 |
| SEC2 · Hardware Security: Primitives, Architecture, Design & Test | 20 | Security | 1 |
| AI1 · AI/ML Frontiers for Hardware Design | 19 | Artificial Intelligence | 2 |
四条 EDA 技术主线的论文足迹
四条 EDA 技术主线的论文足迹 data
| 前端 EDA | 54 | 主主题 | 8 | 581 |
| DV | 22 | 主主题 | 5 | 581 |
| DFT/Test | 7 | 主主题 | 0 | 581 |
| 后端 | 127 | 主主题 | 5 | 581 |
| 前端 EDA | 66 | 全标签 | 9 | 581 |
| DV | 28 | 全标签 | 5 | 581 |
| DFT/Test | 7 | 全标签 | 0 | 581 |
| 后端 | 131 | 全标签 | 5 | 581 |
四主线全标签交叉矩阵
四主线全标签交叉矩阵 data
| 前端 EDA | 66 | 前端 EDA | 9 |
| 前端 EDA | 10 | DV | 1 |
| 前端 EDA | 0 | DFT/Test | 0 |
| 前端 EDA | 11 | 后端 | 0 |
| DV | 10 | 前端 EDA | 1 |
| DV | 28 | DV | 5 |
| DV | 1 | DFT/Test | 0 |
| DV | 1 | 后端 | 0 |
| DFT/Test | 0 | 前端 EDA | 0 |
| DFT/Test | 1 | DV | 0 |
| DFT/Test | 7 | DFT/Test | 0 |
| DFT/Test | 0 | 后端 | 0 |
| 后端 | 11 | 前端 EDA | 0 |
| 后端 | 1 | DV | 0 |
| 后端 | 0 | DFT/Test | 0 |
| 后端 | 131 | 后端 | 5 |
4. 前端 EDA:从「生成 RTL」走向「受约束地改变设计」
4.1 前端的核心矛盾:候选很多,可信候选很少
前端 EDA 可以从自然语言、C/C++、RTL、AIG 或 technology-independent network 出发,产出 RTL、netlist、mapping、pragma 组合、patch 或诊断位置。LLM 不缺候选,设计流程缺的是能同时过综合、等价、PPA 与 verification 的候选。
读 DAC 2026 的前端论文,生成能力和闭环能力最好分开看。语法、功能与多样性属于前者;工具能否执行、硬约束、回归、QoR、失败恢复和成本属于后者。公开全文里有个变化很清楚,不少工作把模型放在传统算法与验证器之间,而不是试图绕开它们。
4.2 SoberDSE:先选算法,再跑搜索
HLS DSE 的常见叙事是训练一个 predictor 或 RL policy,直接学习设计空间。SoberDSE换了一个问题定义:既然没有单个搜索算法在所有 benchmark 上都占优,那就先根据 benchmark 结构选择合适算法。框架从 benchmark 生成 feature graph,监督模型给出先验推荐,PPO 再与环境交互修正选择。〔CLM-FE-DSE-001〕
论文摘要报告,相对所选 heuristic DSE 的最高优势为 5.7 倍,相对 learning-based DSE 最高为 4.2 倍,小样本分类准确性平均提升 35.57%。这些值说明「algorithm selection」值得认真看,但它们属于论文自己的 benchmark 与指标,不是可跨论文搬运的统一加速比。〔CLM-FE-DSE-002〕
SoberDSE 没有端到端替掉搜索器。它承认传统搜索算法各有脾气,再让学习器做 meta-level routing。这个结构留了退路,推荐失效时还能回到已知算法;加入新算法时,也只需扩候选池和训练数据。风险并没有消失,只是变得更容易点名,训练集能否覆盖目标设计族,特征图对编译器版本是否稳定,推荐概率有没有校准。
4.3 NotSoTiny:没有可信 benchmark,模型进步可能只是记住答案
RTL 生成最容易出现的假进步,是 benchmark 太小、testbench 太浅,或者题目已经进入训练语料。NotSoTiny把这三个问题同时摆到台面上:规模与结构复杂度、验证深度、污染控制。它从 Tiny Tapeout 的实际设计出发,经过过滤、模块聚合、任务构造、时序去重和自验证,构造 contextual-module completion 任务。〔CLM-FE-BENCH-001〕
论文称自动生成超过 1000 个任务,并强调每个任务来自真实流片设计;同时把现有 RTL benchmark 的缺口概括为规模不足、verification 过浅和 contamination 控制不足。〔CLM-FE-BENCH-002〕
这里最值得行业借鉴的,不是再造一个公开排行榜,而是把 benchmark 当作持续运营资产:设计版本需要时间戳,训练与测试需要去重,golden 需要工具验证,testbench 覆盖要能解释,失败要区分 syntax、elaboration、simulation、equivalence 和 timeout。若这些层级被压成一个 pass@1,模型团队会不断优化看得见的分数,却未必缩短真实项目的 debug 回路。
4.4 Hierarchical Boundary Recovery:AI 之外,前端仍有硬核结构问题
综合会改变结构、消除中间信号、打平层次,使高层 component 与 gate-level netlist 的对应关系消失。Hierarchical Boundary Recovery不是生成代码,而是恢复这种跨抽象层对应:把 specification 与 implementation 转成 AIG,用 SAT sweeping 找等价节点对,扩张一个仍可对应的边界,再通过 logic grafting 恢复 component of interest。〔CLM-FE-BOUNDARY-001〕
这类工作提醒我们,前端自动化不只有「从文字到 RTL」。ECO、debug、cross-level learning、model checking、reverse engineering 都依赖可追踪的语义边界。Agent 如果只能修改代码,却不知道综合后哪些结构还对应、哪些约束被破坏,就很难对下游后果负责。
论文还使用 speculative reduction 应对 SAT sweeping 在 multiplier 等结构上的困难。这个设计体现了 EDA 里常见的工程现实:严格等价方法需要问题缩减或分阶段求解,而不是把所有复杂性塞给一个通用推理器。
4.5 MappingEvolve:Agent 开始改「算法本体」
MappingEvolve把 technology mapping 拆成受控 operator,让 Planner 选择演化目标与策略,Evolver 在限定代码区修改实现,Evaluator 运行编译、逻辑等价与 QoR 评估。它不是让 LLM 任意重写 mapper,而是把可修改面、目标函数与验证门显式化。〔CLM-FE-AGENT-001〕
论文报告,在其评测设置下相对 direct operator evolution 有 11.5 倍性能提升;在 EPFL benchmark 上,相对 ABC 面积降低 10.04%,相对 mockturtle 降低 7.93%。这些量指向不同比较对象,不能合成一个「总体提升」。〔CLM-FE-AGENT-002〕
MappingEvolve的工程含义比数字更重要。第一,Agent 的搜索对象从脚本参数进入算法逻辑;第二,修改仍被 bounded edit region 约束;第三,编译和 equivalence 是硬失败,QoR 是软排序;第四,演化轨迹、prompt 与中间 artifact 可以留下审计证据。它展示了 Agentic EDA 一个可复用的模板:开放创意空间,但把接受权交给工具。
4.6 Fault localization:让模型看更小、但更有语义的上下文
BluesFL针对项目级处理器 debug,把 HDL 按数据流组织成语义 block,再结合 instruction execution coverage 与信号值进行 fault localization。论文报告 Top-1 定位 24 个 bug,相对其对比 SOTA 的 7 个 bug提升 242.9%,平均单 bug 调用成本为 0.257 美元。〔CLM-FE-FAULTLOC-001〕
模型价格、上下文长度和调用策略一变,成本数字就会变。比较稳定的做法是别把整个项目塞进上下文,那通常又贵又吵。模型需要的是与问题有关的切片、执行覆盖和时序值。芯片里的「上下文工程」不是 prompt 小技巧,而是程序分析、覆盖分析与设计层次的组合。
4.7 前端主线的判断
前端 EDA 正在形成三种系统形态。
第一种是模型作为候选生成器:适合 RTL、patch、pragma 或算法修改,但必须外接编译和验证。第二种是学习器作为 meta-controller:例如选择 DSE 算法、决定搜索策略,保留传统求解器作为执行体。第三种是表示恢复与问题重构:通过 AIG、SAT sweeping、结构切片等方法恢复模型难以直接看到的工程语义。
短期最有希望落地的,不是完全自治生成 RTL,而是「有限修改面+强工具门+可回滚」的窄闭环。前端流程越接近可签核结果,模型的自由度越应收缩,证据链越应增强。〔CLM-AGENT-GUARDED-LOOP-001〕〔CLM-MATURITY-001〕
· · ·
前端 EDA 论文原图
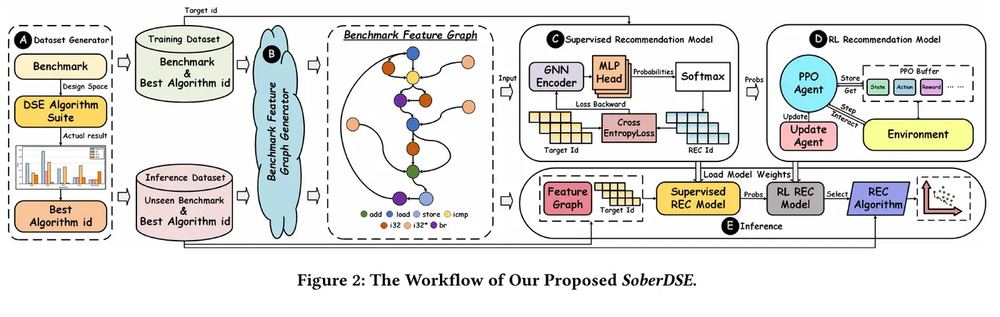
R-0015 · Figure 2 · PDF 第 4 页局部裁剪。SoberDSE: Sample-Efficient Design Space Exploration via Learning-Based Algorithm Selection
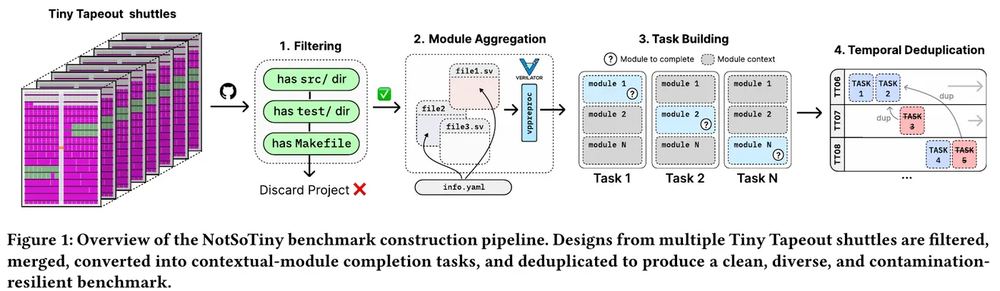
R-0170 · Figure 1 · PDF 第 3 页局部裁剪。NotSoTiny: A Large, Living Benchmark for RTL Code Generation
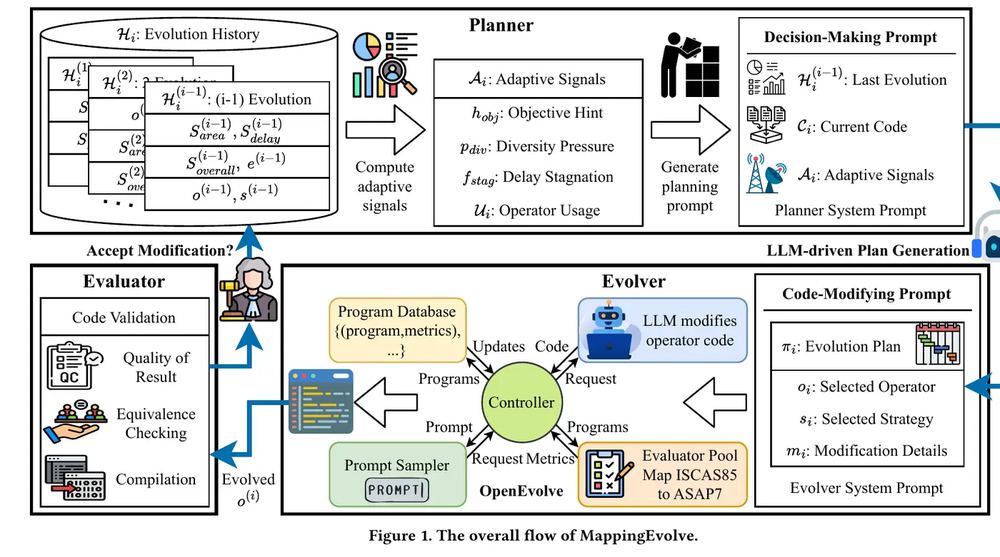
R-0336 · Figure 1 · PDF 第 3 页局部裁剪。MappingEvolve: LLM-Driven Code Evolution for Technology Mapping
5. 设计验证(DV):Agent 最容易被工具驯服的地方
5.1 为什么 DV 比开放式生成更适合 Agent
验证问题有一个天然优势:反馈可以执行。编译器给出 syntax/elaboration error,仿真器给出波形和失败 test,形式工具给出 counterexample 或 proof,coverage 工具给出尚未触达的状态空间。这些反馈都比「请模型反思一下」更可靠。
但可执行并不代表容易。DV 的成功定义通常是合取条件:testbench 要能跑、reference 要正确、stimulus 要有区分力、patch 不能破坏既有功能、assertion 要避免 vacuity、coverage 增长不能靠重复样本。只优化其中一个指标,反而可能制造更隐蔽的错误。
DAC 2026 的公开全文把 DV 的四个瓶颈照得很清楚:执行吞吐、stimulus 质量、patch/repair 的闭环可靠性、形式求解前的问题表示。它们分别对应 Lyra、Stitch/PRO-V-R1、LeGend 和 miter-aware LEC。
5.2 Lyra:生成模型负责语义,FPGA 负责吞吐
传统 processor fuzzing 常在软件仿真器中运行,随机 mutation 产生的指令序列又可能缺少 ISA 语义。Lyra把两类瓶颈拆开处理:在 FPGA SoC 上并行运行 DUT 与 reference model,做 differential checking 和 coverage collection;在 GPU/CPU 侧训练 ISA-aware 生成模型 LyraGen,产生更有结构的指令序列。〔CLM-DV-LYRA-001〕
论文摘要报告最高 1.27 倍 coverage,以及相对所选软件 fuzzer 的 107 倍到 3343 倍端到端加速。这里必须拆因:巨大加速同时来自 FPGA 执行、硬件 coverage instrumentation、差分 self-checking 和 stimulus 生成,不能说成「LLM 本身快了几千倍」。〔CLM-DV-LYRA-002〕
这套异构架构的工程价值,在于把「生成质量」和「执行吞吐」解耦。模型可以慢一些,只要每个 seed 更有价值;执行端可以极快,只要 reference、coverage 与 snapshot 机制可信。评估时也应分别报告 instruction validity、unique coverage gain、time-to-target、DUT/reference mismatch rate、模型推理占比和 FPGA 运行占比,而不是只有一条总加速曲线。
5.3 Stitch:patch 成功不是 assertion 变绿
Stitch面对的是 on-chip protocol implementation 的 assertion violation。它从 violation、counterexample、cone of influence 和 implementation 出发,让 LLM 生成 candidate patch;model checker 验证 assertion,testsuite 检查功能,既有 assertion 检查回归。失败反馈进入下一轮 context,而不是只把上一轮自然语言总结塞回模型。〔CLM-DV-STITCH-001〕
论文在 100 个 violation、11 个 implementation、5 种 protocol 的数据集上,报告初始实验 19%的 good patch,加入定位、violation-specific context 和迭代反馈后,5 轮达到 61%。〔CLM-DV-STITCH-002〕
这里的「good」定义值得保留:修复 violation 只是必要条件,testsuite 和既有 assertion 不能坏。很多自动修复系统会出现 overfit patch,目标测试通过,但其他功能被删掉、常量化或规避。Stitch把这种风险放进系统定义,而不是事后讨论,说明 verification gate 已经从「看一个绿灯」升级为多条件 contract。
5.4 PRO-V-R1:把 Agent 训练目标接到程序化反馈
PRO-V-R1由两层构成:上层是模块化 Agent 与工具组合,包括 testcase generator、functional reference generator、judge、code interpreter、testbench editor 和 simulation driver;下层是 training framework,使用 verification-specific structured reward 优化端到端策略。〔CLM-DV-PROV-001〕
论文报告 57.7%的 functional correctness 和 34.0%的 robust fault detection,对比其 base/agent baseline 的 25.7%和 21.8%;延迟研究还报告平均 91 秒对 805 秒,即 8.8 倍速度提升。〔CLM-DV-PROV-002〕
读这些数字时要注意两个层面。模型层面,训练数据和 reward 改变了候选质量;系统层面,程序化 tool、candidate sampling、majority vote、self-verification 与 edit tool 改变了成功率和成本。若没有 component-level ablation,不能把系统收益全部记到模型参数上。〔CLM-AGENT-MODEL-001〕
PRO-V-R1还揭示了验证 Agent 的一个关键设计:让模型生成 Python-based functional reference 或 testcase artifact,再由解释器和仿真器执行。这样做绕开了 LLM 对长位宽算术与逐周期状态跟踪的不稳定性。更一般地说,Agent 应把自己不擅长的精确计算交给程序,把自己擅长的结构分解、候选生成和策略选择留下。
5.5 LeGend:不是每个 clause 都值得重新建图
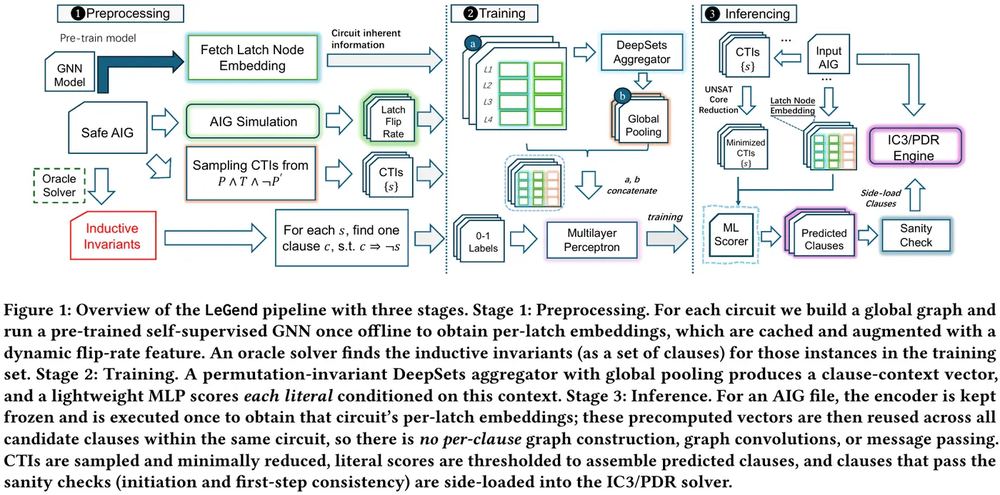
IC3/PDR 的效率高度依赖 inductive generalization。已有 ML 方法常对每个 candidate clause 重建并分析图,计算重、移植难。LeGend把全电路图的表征学习前移:先对每个 latch 计算并缓存 embedding,再用 permutation-invariant 轻量模型并行评分 clause,最后把通过 sanity check 的 lemma side-load 到 solver。〔CLM-DV-LEGEND-001〕
这个思路不是「用 GNN 替代 solver」,而是缓存求解器反复需要的结构信息。它把昂贵的图学习从 inner loop 搬到 offline/precompute 阶段,保留 IC3/PDR 负责证明。对 EDA 系统优化来说,这是比端到端替换更常见、也更稳妥的路线:识别重复计算,冻结可复用表示,把学习器放在候选排序或启发式位置。
论文摘要只声称在多组 benchmark 上加速两种 IC3/PDR engine,没有给出可直接搬运的统一倍数。因此本报告不为 LeGend制造一个「平均加速」数字。能确认的是架构和证据路径,而不是一个跨 solver 的宣传值。
5.6 Miter-Aware LUT Mapping:求解器慢,可能是问题表示得差
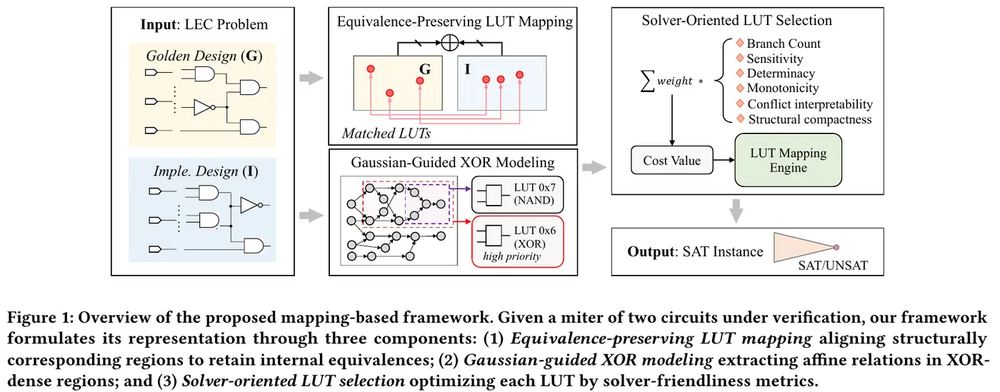
LEC 通常把 golden 与 implementation 接成 miter,再交给 SAT solver。若综合破坏结构对应、设计又含 XOR-dense arithmetic,flat miter 会丢失可合并的内部等价,SAT propagation 也难发挥。Miter-Aware LUT Mapping选择在求解前重构表示:equivalence-preserving mapping对齐结构,Gaussian-guided XOR modeling显式抽取 affine relation,solver-oriented LUT selection优化 solver-friendliness。〔CLM-DV-LEC-001〕
论文报告跨 SAT solver 最高 92.1%的降低,PAR2 对 baseline 平均改善 83.3%;消融中,miter-aware mapping 单独使运行时间降低 62.5%,Gaussian-guided XOR modeling 单独降低 36.8%。这些值有明确 benchmark 与 timeout 口径,不能当作所有 LEC case 的通用缩短比例。〔CLM-DV-LEC-002〕
这篇论文对 Agentic EDA 还有一层提醒:当工具失败时,不一定要让模型继续「想」;更有效的动作可能是改变 problem representation。形式验证里的 abstraction、decomposition、lemma、miter modeling,都是对可解性的结构性干预。把 solver 当黑盒并不断重试,通常比不上一次有知识的重写。
5.7 DV 主线的工程判断
DV 是当前最适合建立 Agent 安全边界的领域,但安全边界不是单个 reward。一个可用的验证 Agent 至少需要五类门:格式/编译门、执行门、功能门、覆盖/反例门、回归门。形式验证还需要 vacuity、assumption consistency 与 proof artifact;仿真需要 reference 可信度与 seed 去重;repair 需要 patch scope 和回滚。
短期落地可以按风险往上走。先做 triage、test generation、counterexample summarization、fault localization 这类建议型任务,再做带沙箱的 artifact 生成,把自动修改设计放在后面。权限每升一级,验证门和审计轨迹都得跟着加,不能只把更多没定义清楚的责任丢给模型。〔CLM-AGENT-GUARDED-LOOP-001〕〔CLM-REC-001〕
· · ·
DV 论文原图
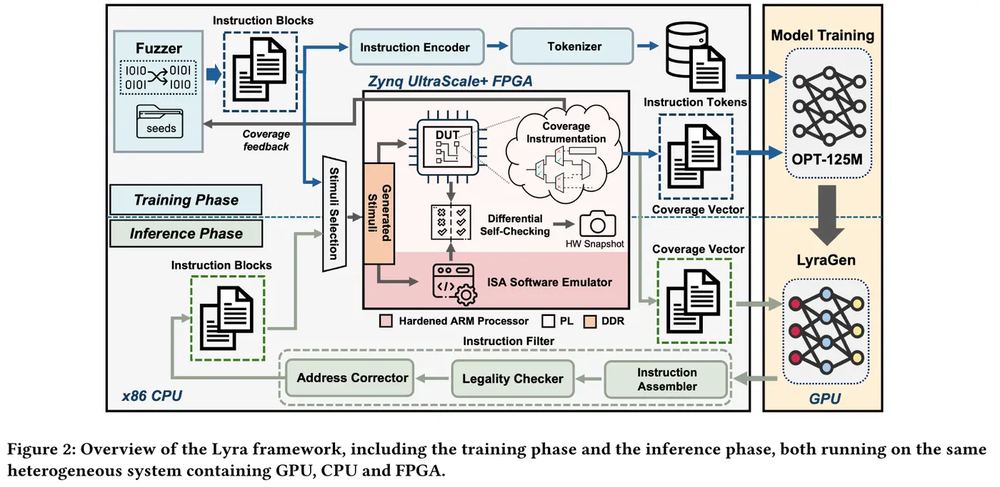
R-0143 · Figure 2 · PDF 第 3 页局部裁剪。Lyra: A Hardware-Accelerated RISC-V Verification Framework with Generative Model-Based Processor Fuzzing
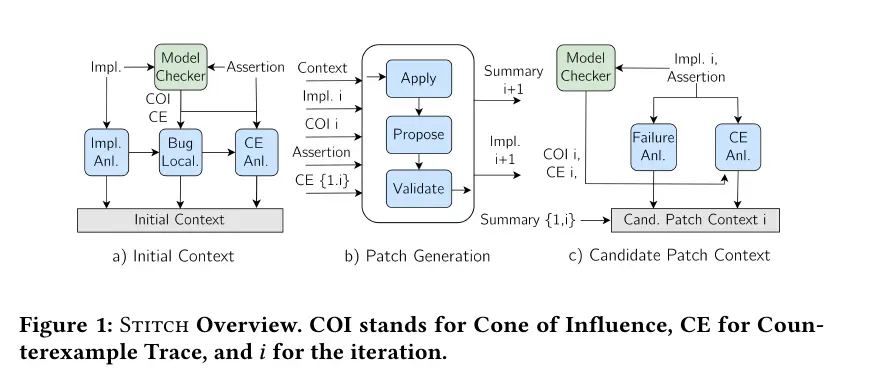
R-0147 · Figure 1 · PDF 第 3 页局部裁剪。Stitch: Assertion-Guided Patching of On-Chip Protocol Implementations using LLMs
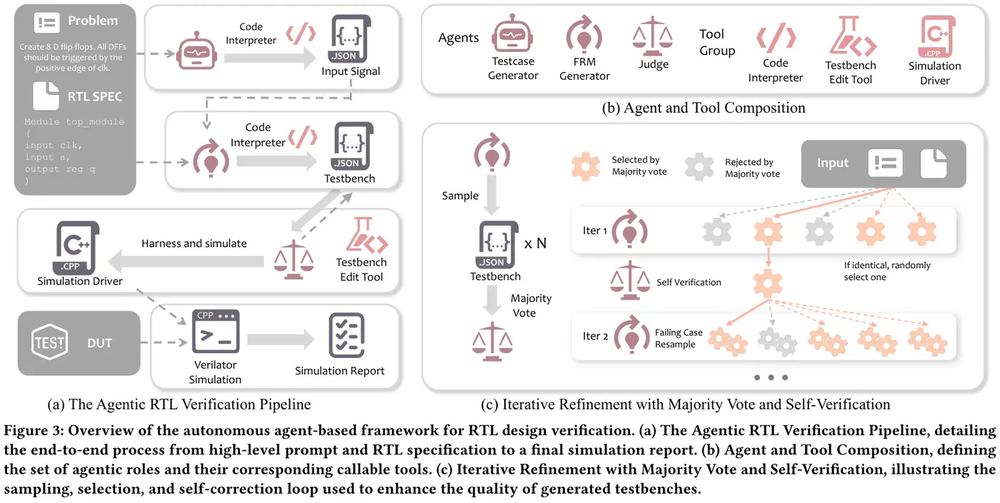
R-0391 · Figure 3 · PDF 第 3 页局部裁剪。PRO-V-R1: Reasoning Enhanced Programming Agent for RTL Verification
R-0394 · Figure 1 · PDF 第 4 页局部裁剪。LeGend: A Data-Driven Framework for Lemma Generation in Hardware Model Checking
R-0395 · Figure 1 · PDF 第 2 页局部裁剪。Miter-Aware LUT Mapping: Aligning Structure and Solvability for Efficient Logic Equivalence Checking
6. DFT、测试与硅生命周期:题名很清楚,全文证据为零
6.1 先把证据缺口摆出来
官方 EDA9 Session Leveraging AI for Silicon Health: Test, Yield & Fault Tolerance 收录 7 篇论文;当前恢复语料中,DFT/Test 主主题全文覆盖是 0/7。〔CLM-DFT-001〕〔CLM-COVERAGE-002〕
证据到了这里就得停。本章不能比较 fault coverage,不能评价 area/power overhead,也不能宣称某种 AI 方法优于 ATPG、LBIST 或传统 diagnosis。能做的,是按官方题名画出研究对象雷达,再列清 DFT 工程师拿到全文后该核查什么。
6.2 七个题名透露的对象分布
| Paper ID | 官方题名 | 只按题名可确认的对象 | |—|—|—| | R-0434 | VeRA+: Vector-Based Lightweight Compensation for Drift-Resilient RRAM In-Memory Computing | RRAM drift、轻量补偿、可靠性 | | R-0435 | Mask-Guided Diffusion with Process-Aware Metric Optimization for Long-Tailed Wafer Defect Analysis | wafer defect、长尾、process-aware metric | | R-0436 | AccShield: Operator-Aware Robust Scheduling for Fault-Tolerant AI Accelerators | fault-tolerant accelerator、scheduling | | R-0437 | ESCAPE: Elegant Scan Chain Activity Probability Establishment for Programmable Low-Power LBIST | scan chain activity、low-power LBIST | | R-0438 | Test Point Insertion with ATPG-Free Self-Supervised Learning | test-point insertion、ATPG-free、self-supervised learning | | R-0439 | FreqSEM: Frequency-Aware High-Precision Contour Extraction for Lithographic SEM Images | lithographic SEM、contour extraction | | R-0440 | SafeGen: LLM-Driven Assertion Generation and Fault Criticality Evaluation for Functional Safety | assertion generation、fault criticality、functional safety |
以上只证明 Session 与题名存在,不能据此推断具体网络结构、训练数据、测试模型或实验结果。〔CLM-DFT-001〕
6.3 从题名看,DFT 正在越过传统 scan/ATPG 边界
七个题名把「测试」展开成至少四层。
第一层是结构级 DFT:scan chain activity、LBIST、test-point insertion,仍是典型 DFT 对象,但 AI 被放在概率估计或插点决策上。
第二层是制造与缺陷数据:wafer defect、SEM contour,强调长尾与 process-aware 指标。这类任务的难点往往不是模型精度本身,而是 defect taxonomy、lot/wafer split、设备漂移和标签稀缺。
第三层是运行期与可靠性:RRAM drift、fault-tolerant scheduling,连接器件退化、架构容错与 silicon health。
第四层是functional safety:assertion generation 与 fault criticality,把 pre-silicon property 和故障重要性评估连接起来。
这四层说明 DFT/Test 已不再只对应制造测试那一段,而是向 design verification、reliability、yield learning 与 in-field lifecycle 延伸。这个结论是题名分布的结构性观察,不是对七篇方法有效性的评价。〔CLM-DFT-001〕
6.4 真正拿到全文后要查什么
拿到 R-0437 与 R-0438 的全文,先查 fault model、benchmark circuit、ATPG 配置、test coverage、pattern count、TPI 数量和 area/timing/power overhead。若只报告 proxy loss,却没有最终 coverage 与 overhead,工程意义很有限。〔CLM-DFT-001〕
对 R-0435 与 R-0439,重点查数据切分是否跨 wafer/lot/tool,长尾采样是否泄漏 test distribution,process-aware metric 是否与真实 inspection cost 对齐,是否报告 calibration 和 rare-defect recall。〔CLM-DFT-001〕
对 R-0434 与 R-0436,重点查 fault injection 的位置、持续时间和相关性模型,容错调度是否计入 performance/power 代价,drift 分布是否来自实测。〔CLM-DFT-001〕
对 R-0440,重点查 assertion 的语义正确性、vacuity、fault criticality 的 ground truth、ASIL/functional safety context,以及 LLM 生成 property 是否进入 formal proof,而不是只做语言相似度。〔CLM-DFT-001〕
6.5 DFT 章节的结论
DFT/Test 的议题正在被 AI 扩展,但本报告没有足够全文证据判断它是否比前端或 DV 更成熟。0/7 的公开全文覆盖不是「没有进展」,而是「当前证据管线无法验证」。严谨的结论必须允许空白存在。〔CLM-COVERAGE-002〕〔CLM-LIMIT-001〕
· · ·
EDA9 的 7 篇 DFT/Test 论文
当前公开全文覆盖 0/7;下表只承诺官方题名与元数据
EDA9 的 7 篇 DFT/Test 论文
| R-0434 | VeRA+: Vector-Based Lightweight Compensation for Drift-Resilient RRAM In-Memory Computing | EDA9 | C | pending |
| R-0435 | Mask-Guided Diffusion with Process-Aware Metric Optimization for Long-Tailed Wafer Defect Analysis | EDA9 | C | pending |
| R-0436 | AccShield: Operator-Aware Robust Scheduling for Fault-Tolerant AI Accelerators | EDA9 | C | pending |
| R-0437 | ESCAPE: Elegant Scan Chain Activity Probability Establishment for Programmable Low-Power LBIST | EDA9 | C | pending |
| R-0438 | Test Point Insertion with ATPG-Free Self-Supervised Learning | EDA9 | C | pending |
| R-0439 | FreqSEM: Frequency-Aware High-Precision Contour Extraction for Lithographic SEM Images | EDA9 | C | pending |
| R-0440 | SafeGen: LLM-Driven Assertion Generation and Fault Criticality Evaluation for Functional Safety | EDA9 | C | pending |
7. 后端物理实现:近似可以快,签核不能含糊
7.1 127 篇足迹与 5 篇全文之间的落差
报告的后端全标签口径命中 131 篇,主主题为 127 篇,是四主线里最宽的一条;但公开全文主主题只有 5 篇,coverage 仅 5/127。尤其 EDA7 Physical Design and Verification 有 30 篇,却没有一篇进入当前全文集合。〔CLM-TAXONOMY-001〕〔CLM-COVERAGE-002〕
本章没有资格声称全面覆盖 placement、routing、CTS、DRC、3D IC 与 signoff。手里的全文只够深入看三类代表,gate sizing 的 timing-power co-optimization、multi-corner yield estimation、wafer-on-wafer reticle/network co-design。它们回答的是学习方法或新算法怎样嵌进物理约束,不是怎样替代整条后端流程。
7.2 Quad-gradient gate sizing:回到合法 library move
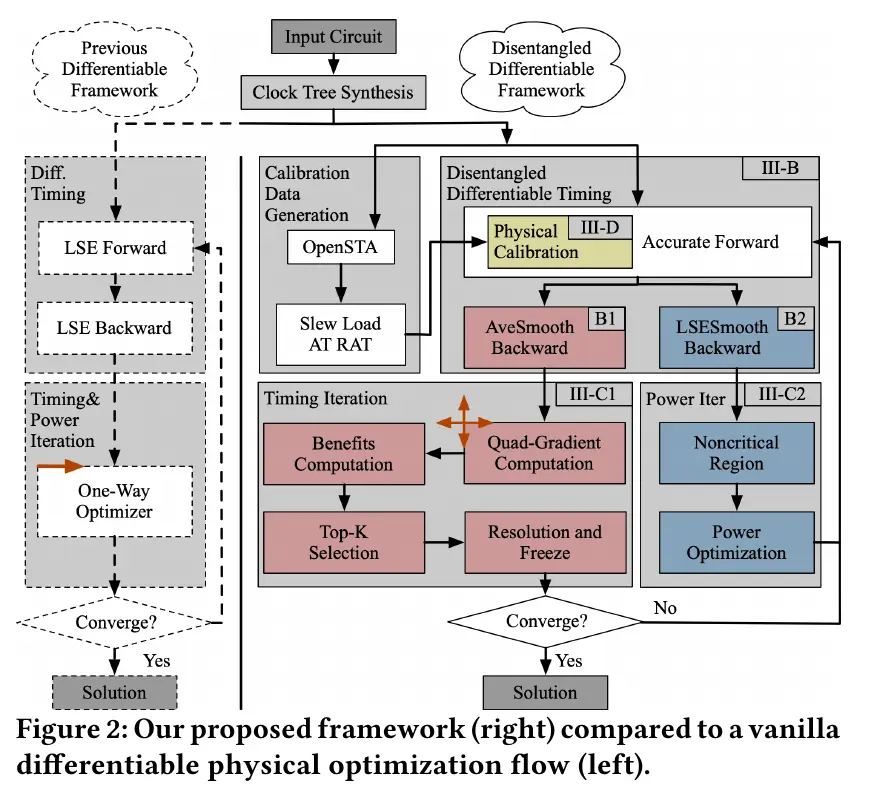
标准单元 gate sizing 同时面对离散 drive strength、Vth 选择、非线性 STA 和 timing-power trade-off。连续 relaxation 容易产生不可实现的梯度方向,黑盒 ML 又缺少可解释性与跨设计泛化。Quad-gradient framework直接在 drive strength×Vth 离散空间工作,把 upsize/downsize 与 timing/power 梯度分离,再用物理校准缩小 differentiable timing 与 nonlinear STA 的差距。〔CLM-BE-GATESIZE-001〕
论文在 ICCAD 2025 contest benchmark 上报告,相对第一名 flow 平均多 40.4 个百分点的 TNS reduction、total power change 好 16.2 个百分点。这里是百分点差,不是「提升40.4%」的相对比例。〔CLM-BE-GATESIZE-002〕
这项工作最实在的价值是离散合法性。许多 learning-based optimizer 先在连续空间找到漂亮解,再投影回合法 cell;偏偏这一步就可能破坏 timing 或 power。把 library move 直接写进优化变量,每个动作会更接近工具能执行的 ECO。代价也很明确,搜索空间更不光滑,梯度需要平滑、分解和 freeze 策略,论文才会单独处理 smoothing 与 oscillation。
7.3 YMCA:multi-corner 的瓶颈是调参,不只是仿真次数
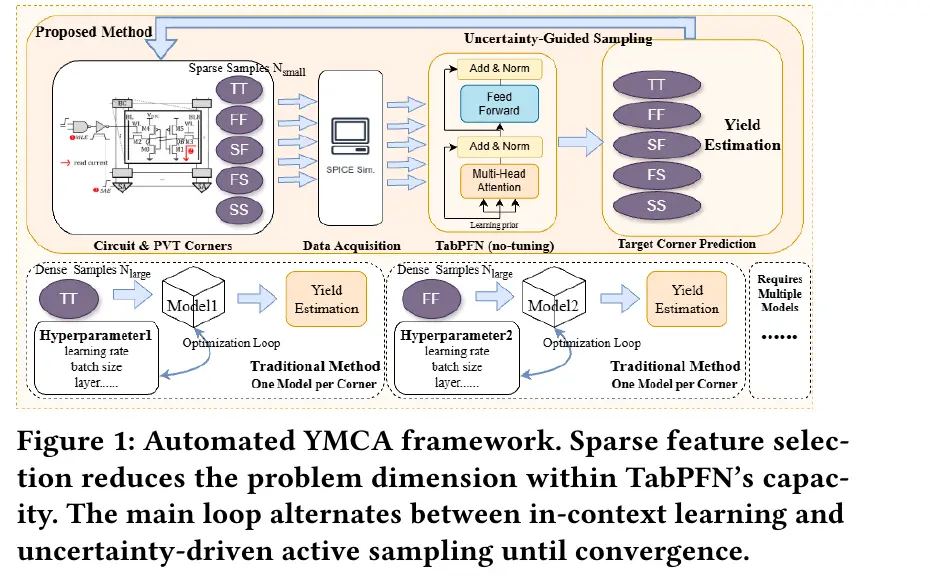
PVT corner 扩大后,yield estimation需要在多个 corner 上理解非线性 failure boundary。简单 importance sampling 自动但表达力受限,复杂 surrogate 准确却要反复调 kernel、architecture 与 hyperparameter。YMCA的主张是用 learned prior消除 per-circuit tuning:自动 feature selector 把 1152 维参数压缩到约 48 维,TabPFN 通过 in-context inference做 multi-corner预测,再用 uncertainty-guided sampling选择新增仿真点。〔CLM-BE-YIELD-001〕
论文报告 mean MRE 最低 0.11%,零 per-circuit tuning,总 validation cost 降低超过 10 倍。〔CLM-BE-YIELD-002〕
对工程团队而言,「zero tuning」需要再拆开:是否真的不需要设计级校准;feature selector 是否在新 circuit family 上稳定;TabPFN 的训练先验是否覆盖目标 failure surface;uncertainty 是否经过 calibration;稀有失效区的 recall 如何。若这些问题没有回答,zero tuning 可能只是把调参成本转移到 foundation prior 的训练与数据选择。
7.4 Wafer-on-wafer:placement 已经决定网络拓扑
当 reticle 通过 wafer-on-wafer hybrid bonding连接,物理 placement 不再只是几何问题,它直接决定哪些 reticle 能形成垂直连接、每个节点有多少邻居以及网络路径长度。相关论文提出 Aligned、Interleaved、Rotated、Contoured 四种 placement,把制造复杂度与通信拓扑放进同一个设计空间。〔CLM-BE-WAFER-001〕
论文相对 2D mesh-like baseline 报告最高 250%的 throughput improvement、最高 36%的 average packet latency reduction、最高 38%的 energy-per-byte reduction。三个峰值可能来自不同 placement 或 workload,不能拼成一个同时达到的 operating point。〔CLM-BE-WAFER-002〕
这类研究说明「后端」边界正在外扩:die 内 placement/routing 与 package/wafer topology、thermal、power delivery、router area 已经互相影响。传统按层级割裂的优化,可能错过跨层机会;但跨层 co-design 也更需要明确的 constraint ownership,否则上层性能目标很容易吞掉制造可行性。
7.5 后端主线的判断
后端采用学习方法时,最危险的不是 prediction error 本身,而是 error 在签核链中的放大:一点 timing 偏差可能改变 critical path,一点 IR/thermal 偏差可能误导 placement,一次不合法 cell move可能让后续 ECO 失效。生产可用的 surrogate 必须知道自己何时不可信,并把低置信区域交回精确工具。
后端 Agent 若只盯最终 PPA,很容易把约束吃掉。目标得分层,先保证 legality 与 signoff consistency,再优化 WNS/TNS/power/area,之后才算 runtime 和工具 license 成本。每个被接受的动作都要留下 before/after artifact 和回滚点。一个 benchmark 上的 QoR 提升,远不够证明它能替换生产 flow。〔CLM-MATURITY-001〕〔CLM-REC-001〕
· · ·
后端论文原图
R-0047 · Figure 2 · PDF 第 3 页局部裁剪。Disentangled Differentiable Timing-Power Co-Optimization with Quad-Gradient Gate sizing
R-0252 · Figure 1 · PDF 第 2 页局部裁剪。Breaking the Tuning Barrier: Zero-Hyperparameters Yield Multi-Corner Analysis Via Learned Priors
8. Agentic EDA:不要把「会调用工具」误写成「会负责」
8.1 模型、Agent、系统是三个对象
模型输出 token;Agent 维护状态、选择工具、组织候选与反馈;系统则负责权限、artifact、验证门、超时、预算、审计、回滚和人类接管。很多讨论把三者混在一起,于是一个模型 benchmark 的提升被包装成 flow automation,一个 tool call demo 又被包装成 autonomous design。
从公开全文看,MappingEvolve、PRO-V-R1 与 Stitch 的可信部分恰恰不是「对话更自然」,而是系统 contract 更具体。MappingEvolve限定可修改 operator,编译、equivalence、QoR 三层评价;PRO-V-R1把 testcase、reference、judge、editor、simulation driver拆成工具;Stitch用 model checker、testsuite、既有 assertion共同判定 patch。〔CLM-FE-AGENT-001〕〔CLM-DV-PROV-001〕〔CLM-DV-STITCH-001〕
把三类系统放在一起看,可以得到一个有证据边界的判断。相对成熟的 Agentic EDA 更像受约束的候选搜索器,加上可执行工具和硬验证门;它不是把 system prompt 写得更长的聊天机器人。〔CLM-AGENT-GUARDED-LOOP-001〕
8.2 一个可落地的闭环长什么样
闭环至少包含六步。
任务形式化。 把「优化一下」「修好它」改写成输入 artifact、允许动作、禁止动作、目标与守护约束。比如 technology mapping 可修改三个 operator,但必须编译且等价;protocol patch 可以改 RTL,但必须保持既有 assertion 和 testsuite。
候选生成。 模型或搜索器提出一个或多个动作。候选应是结构化 artifact,而不是只有解释文本。
工具执行。 编译器、仿真器、形式工具、STA、P&R、SPICE 或测试工具运行真实检查。工具返回的 stdout 只是部分信息,更重要的是 exit status、artifact、日志、counterexample、波形、报告和版本。
验证门。 先判断硬约束,再计算软目标。硬约束失败直接拒绝;软目标决定排序。把两者混成一个 reward,可能出现用巨大 QoR 换取一点 correctness penalty 的荒谬候选。
证据入库。 保存输入、动作、工具版本、命令、随机种子、输出哈希、失败分类与资源成本。证据库不是向量数据库的同义词,它是一份可重放的工程记录。
退回与接管。 失败要回到可诊断的阶段。连续失败、工具异常、预算超限、触及高风险文件时,应触发人类接管,而不是让 Agent 无上限地「自我反思」。〔CLM-REC-001〕
8.3 验证门的类型
前端常见的门包括 syntax、elaboration、synthesis、equivalence、lint、CDC/RDC、基本 PPA;DV 包括 testbench compile、simulation、coverage、assertion、vacuity、regression;DFT 包括 scan legality、ATPG、coverage、pattern count、X handling、power;后端包括 legality、DRC/LVS、STA、IR/EM、thermal、routing congestion、manufacturing constraint。
不同门的失败语义不同。编译失败通常可局部修复,equivalence 失败可能要求回滚,signoff 报告异常可能来自环境或 corner 配置。Agent 必须先分类失败来源,才能决定重试、换策略、缩小修改或交给人。
8.4 Reward 不是目标函数的替身
Agent 系统喜欢把所有东西压成 reward,但 EDA 里很多约束不能以软 penalty 表达。功能正确、逻辑等价、时序无违例、物理规则合法、safety property 成立,往往是硬门。只有在可行集内部,才讨论面积、功耗、运行时间和 license cost。
这也是 MappingEvolve 的编译/等价检查和 Stitch 的 testsuite/既有 assertion 值得强调的原因:它们把 correctness 从「高权重项」提升为「接受前提」。〔CLM-FE-AGENT-001〕〔CLM-DV-STITCH-001〕
8.5 Agent benchmark 应该测什么
单看最终 pass rate 不够。至少要同时报告:任务级成功率;首次通过率与重试次数;工具调用数;token、GPU、CPU、license 与墙钟成本;失败类型分布;回归失败率;人类接管率;轨迹可重放率;在新 IP、新 corner、新工具版本上的泛化;以及错误候选被硬门拦截的比例。
还要把 model-only、tool-only、single-agent、multi-agent、with/without verifier 做消融。否则,一个系统提升可能来自更强底模、更多 sampling、更宽预算或更宽松的 success definition,而不是 Agent architecture。模型能力与系统能力必须分开评估。〔CLM-AGENT-MODEL-001〕
8.6 Agentic EDA 目前处在哪
公开全文已经证明窄任务闭环可行:technology mapping operator evolution、RTL verification agent、protocol patch、FPGA-accelerated processor fuzzing。它们有明确 artifact 和可执行 evaluator。〔CLM-FE-AGENT-001〕〔CLM-DV-PROV-001〕〔CLM-DV-STITCH-001〕〔CLM-DV-LYRA-001〕
尚未证明的是跨团队、跨工具、跨版本的长期自治。论文通常在固定 benchmark、固定工具版本和有限预算中运行;生产项目则有私有 IP、脆弱脚本、license 排队、环境漂移、增量数据库、保密边界与责任追踪。把前者直接称为「self-driving chip design」,会抹掉最难的那一大段工程工作。
更准确的表述是:Agentic EDA 正从「模型外挂」走向「工具约束的窄域自治」,离「跨 flow 自治」仍缺工程平台、证据标准和治理机制。〔CLM-MATURITY-001〕
· · ·
带验证门的 Agentic EDA
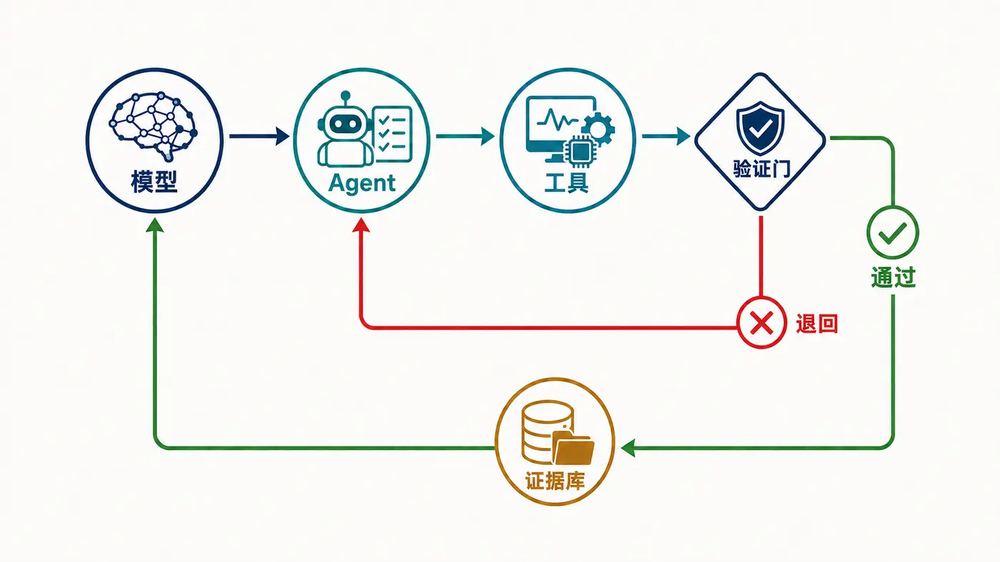
原创解释图(基于本报告归纳):带验证门的 Agentic EDA 闭环。。不含论文实验数据。
9. 工程成熟度:论文结果离生产替换还有几道门
9.1 五级成熟度阶梯
论文原型。 能在作者环境和选定 benchmark 上运行,有清晰 problem statement 与结果。这个级别证明「想法可能有效」。
可复现。 公开或可交付代码、数据、配置、模型、工具版本和随机种子;第三方能在合理误差内复现主要表格。这个级别证明「不是一次性演示」。
可集成。 接口稳定,能读写真实 artifact,兼容企业工具版本,能在 CI 或 batch farm 运行;错误有结构化返回,资源成本可控。这个级别证明「能进入现有 flow」。
可签核。 输出经过目标工具与 corner 验证,有明确 acceptance criteria、回归、回滚和审计。这个级别证明「结果可以被工程责任链接受」。
可部署。 有权限隔离、监控、SLA、数据治理、模型与 prompt 版本管理、长期漂移检测和人类接管。这个级别证明「系统能被持续运营」。〔CLM-MATURITY-001〕
9.2 论文里的「开源」不等于可复现
一个 URL 离复现还很远。benchmark 版本、preprocess、工具 license、timeout、seed、硬件、环境变量、训练 checkpoint 与评价脚本,少一个都可能跑不回原结果。EDA 还有两类常被藏住的依赖,commercial tool version 和 library/corner。源代码公开了,第三方仍可能起不来同一条 flow。
本报告的自动 signal scan 只能发现关键词和 URL,不能确认仓库是否完整、commit 是否对应论文、license 是否允许使用。因此不会把「54篇中多少篇出现 code 字样」当成成熟度统计。证据卡将 URL presence 与人工 approved claim 分开,避免把文本命中误写成可复现结论。〔CLM-COVERAGE-001〕
9.3 真实设计验证也要拆层
「real-world design」「industrial benchmark」「taped-out design」听起来都很强,但强度不同。使用真实 RTL 只说明输入更真实;用 commercial tool 说明接口更接近工业;在真实 PDK/library/corner 上签核更进一步;真正进入 tapeout 或 silicon measurement 又是更高一级。
NotSoTiny从真实流片的 Tiny Tapeout 设计构造任务,这是 benchmark 来源强度;它不等于 LLM 生成结果已经重新流片。〔CLM-FE-BENCH-002〕
Stitch报告 simulation 与真实硬件验证,这是 patch 验证强度;它仍不能自动外推到所有 protocol IP 和项目 coding style。〔CLM-DV-STITCH-002〕
YMCA处理 multi-corner yield,是物理建模强度;是否能进入特定公司的 signoff 仍取决于 circuit family、模型校准与数据治理。〔CLM-BE-YIELD-001〕〔CLM-BE-YIELD-002〕
9.4 失败案例比平均值更接近生产风险
平均 QoR 无法回答最坏情况。生产环境更关心:多少 case 编译失败;多少 case 超时;多少 case 违反 hard constraint;失败是否集中在特定设计族;模型是否知道自己不确定;回退路径是否可靠。
例如 miter-aware LEC 通过消融分解不同表示变换的贡献,这是理解失败边界的起点。〔CLM-DV-LEC-002〕
SoberDSE承认没有单一算法跨 benchmark 占优,因此选择算法而不是强行统一 policy,这种设计本身就是对 distribution shift 的回应。〔CLM-FE-DSE-001〕
MappingEvolve把 compile/equivalence failure定义为分层 penalty 与拒绝条件,比只报最终面积更容易审计。〔CLM-FE-AGENT-001〕
9.5 成熟度不是线性排行榜
有的论文方法新、代码开源,但工具链窄;有的方法使用 commercial flow,但数据无法公开;有的结果极强,却只覆盖一个 benchmark;有的结果普通,却提供完整 failure analysis。成熟度应是多维 profile,而不是一个总分。
建议至少分成六轴:正确性证据、数据与 benchmark、工具集成、成本与性能、跨设计泛化、治理与可运维。任何总分都应保留原始轴,否则组织会被一个「高分」掩盖硬伤。
· · ·
从论文原型到可部署能力
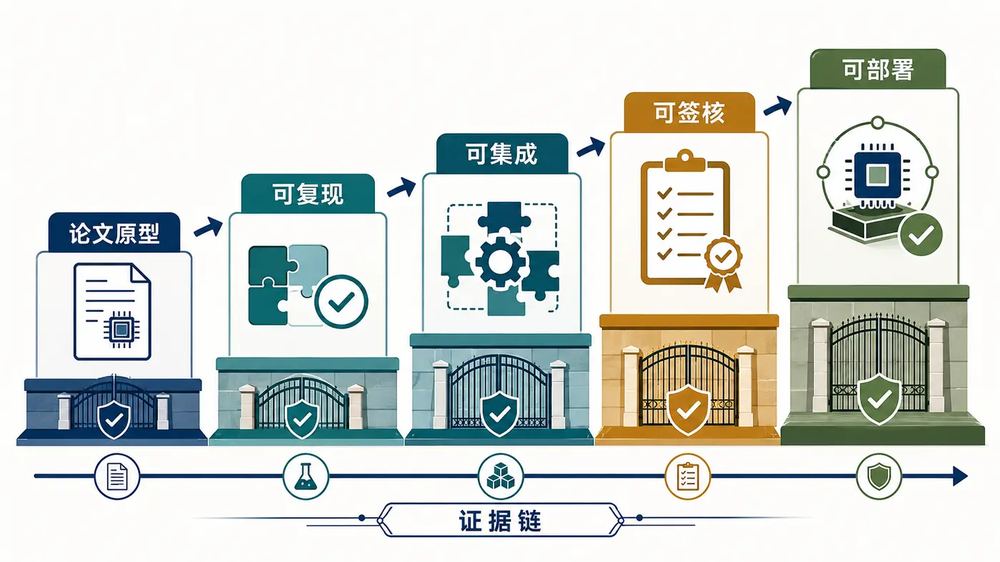
原创解释图(基于本报告归纳):从论文原型到可部署能力的工程成熟度阶梯。。不含论文实验数据。
10. 行动建议:研究团队、EDA 团队和管理者各做什么
10.1 对芯片公司:先找闭环,不要先买模型
优先选择有确定输入输出和现成 evaluator 的任务:log triage、failure clustering、test generation、counterexample summarization、fault localization、bounded script/constraint editing。先把工具调用、artifact 管理和验证门搭好,再替换或升级模型。
模型选型要做 shadow evaluation。让新模型在历史任务上生成候选,但不进入生产修改;记录成功、失败、成本和人工接管。只有当失败被硬门稳定拦截、成功能重放,才逐步开放自动执行权限。
企业评估 Agentic EDA 时,应分开测离线模型指标、工具链成功率、验证门通过率、回滚成本和人类接管率,并保存可重放轨迹。〔CLM-REC-001〕
10.2 对 EDA 平台团队:把工具变成可调用 contract
Agent 最怕「脚本能跑但接口不稳」。每个工具动作应有明确 schema:输入 artifact、版本、工作目录、corner、timeout、资源、输出文件、exit code、error taxonomy。不要让 Agent 解析无限变化的 console 文本来猜状态。
验证门要一等公民。compile、simulation、equivalence、STA、DRC、ATPG、coverage 等检查应支持机器可读结果,并区分 hard fail、soft degradation、environment fail。environment fail 不应被当成候选质量差,否则 Agent 会学到错误策略。
保留 immutable run record:代码/网表/约束 hash、工具版本、命令行、容器、license、随机种子、输出报告与候选 diff。证据链是治理基础,不是事后补日志。
10.3 对算法研究团队:报告条件,不只报告峰值
每个结果应同时给出 benchmark、split、baseline version、工具版本、硬件、timeout、失败计分与资源预算。若使用 up to,同时给 distribution、median、worst case 和失败数。若使用大模型 API,记录模型快照和价格日期。
对 Agent 系统,至少给 model-only、without tools、without verifier、without memory/feedback 的消融;对 multi-agent,再给 single-agent 等预算对比。否则无法判断复杂架构是否真的有价值。〔CLM-AGENT-MODEL-001〕
对后端 surrogate,报告 uncertainty calibration、out-of-distribution behavior 和精确工具回退;对 DV repair,报告 regression 与 vacuity;对 DFT learning,报告最终 coverage 和 overhead,不只报 proxy accuracy。
10.4 对管理者:把「自治」拆成权限等级
可以定义四级权限:只读分析;生成建议但不执行;沙箱执行并由人批准;低风险任务自动执行。每一级绑定工具白名单、资源预算、数据权限、验证门和审计要求。
不要用一个「Agent adoption rate」衡量进展。更有用的是:每类任务的人均节省时间、逃逸缺陷、回归率、工具成本、接管率、可重放率和覆盖的设计族。一个自动化率更高但回归更差的系统,可能是负资产。
10.5 90 天可执行路线
第一个月:证据与接口。 选一个窄任务,冻结历史数据,定义输入输出 schema、成功条件、失败 taxonomy 和 baseline。接通只读工具,建立 run record。
第二个月:沙箱闭环。 加入候选生成和硬验证门,做 shadow run。重点统计失败类型、重试、成本与人工接管,不追求自动执行比例。
第三个月:受控上线。 只开放低风险任务,设置预算、timeout、回滚与审批;用新项目和新版本做 OOD 验证。达到目标后再扩任务,不要先扩模型权限。
· · ·
11. 局限性与稳健性
11.1 最大局限:全文样本不是随机的
54 篇全文是非随机公开可得性样本,只占 581 项的 9.29%。不同 Track 的作者上传 arXiv、机构仓储和 accepted manuscript 的习惯不同;论文公开时间也不同。公开全文更可能集中在愿意预印本发布的机构与方向。〔CLM-COVERAGE-001〕〔CLM-LIMIT-001〕
所以,本文最多说「在当前54篇中观察到」,不能写成「DAC 2026 全部论文普遍如此」。DFT 的 0/7 与 EDA7 的零全文,会把叙述偏差进一步放大。〔CLM-COVERAGE-002〕
11.2 分类规则有边界
Topic 锚点稳定,但跨 Track 语义规则可能误收或漏收。比如 verification 可能出现在 physical verification,test 可能指软件测试,mapping 可能不是 technology mapping。报告保留 rule hit 和 review_required,不把自动分类当真值。21篇多标签和103篇待复核正是为了显式暴露边界。〔CLM-TAXONOMY-002〕
11.3 论文数字不可直接排名
不同论文的任务、baseline、benchmark、硬件、timeout 和指标不一致。Lyra的加速包含异构硬件,MappingEvolve同时报告演化效率与面积结果,Quad-gradient用百分点差,YMCA用 MRE 与 cost,Stitch用 good patch success。把这些数画成统一条形图会制造不存在的可比性。〔CLM-DV-LYRA-002〕〔CLM-FE-AGENT-002〕〔CLM-BE-GATESIZE-002〕〔CLM-BE-YIELD-002〕〔CLM-DV-STITCH-002〕
11.4 文本抽取与图片裁剪的限制
PDF 逐页文本使用 pdftotext -layout,双栏和图表可能造成句子交错。证据卡的候选片段先验证页码与存在性,只有人工 approved claim 能进入正文。图片使用 PDF point crop box,在 240 DPI 渲染后裁切;经过缩略总览和单图复核,但不同显示器仍可能影响小字可读性。
11.5 当前日期与版本
本报告基于 2026 年 7 月 22 日版官方 program 对应的清单和截至 2026 年 8 月 2 日可恢复的公开全文。后续作者可能更新 arXiv 版本、发布代码或修正实验。任何更新都应新增 source hash 和复核记录,不覆盖历史证据。
11.6 稳健结论与脆弱结论
相对稳健: 官方数量与 Topic/Session 分布;当前已验证 PDF 的文件完整性;已批准论文 claim 的页码;Agent 系统普遍使用工具与验证门的跨论文观察。〔CLM-CORPUS-001〕〔CLM-CORPUS-002〕〔CLM-AGENT-GUARDED-LOOP-001〕
中等稳健: 四主线语义分类、Agentic 候选数量、基于题名的研究对象聚类。它们依赖规则和人工复核范围。〔CLM-TAXONOMY-001〕〔CLM-TAXONOMY-002〕
脆弱: 用54篇公开全文估计全体成熟度;跨论文比较性能;根据题名推测 DFT 方法效果。报告明确拒绝做这些推断。〔CLM-LIMIT-001〕〔CLM-DFT-001〕
· · ·
12. 值得继续追的问题
12.1 前端 EDA
当 RTL 生成 benchmark开始使用真实、多模块、长期更新的设计后,模型排名会怎样变化?污染控制能否做到模型训练时间可验证,而不只是字符串去重?NotSoTiny一类 living benchmark如何避免测试集逐步泄漏?〔CLM-FE-BENCH-001〕〔CLM-FE-BENCH-002〕
LLM演化综合算法时,bounded edit region的边界由谁维护?当工具版本、library或目标架构改变,历史 evolution memory 是帮助还是误导?MappingEvolve是否能跨 mapper、跨工艺、跨 QoR 目标迁移?〔CLM-FE-AGENT-001〕
12.2 DV
生成式 fuzzer带来的 coverage增长,究竟来自更好的语义序列,还是更多执行吞吐?如何按等预算拆分两者?Lyra提供了架构,但还需要更细的 component attribution。〔CLM-DV-LYRA-001〕〔CLM-AGENT-MODEL-001〕
自动 patch如何证明没有 overfit?除了 testsuite 与既有 assertion,是否需要 mutation testing、formal equivalence、coverage delta 与人工语义审查?Stitch已经把 good patch定义得更严格,但距离生产 signoff 还有多远?〔CLM-DV-STITCH-001〕
形式验证的学习器应预测 clause、排序 candidate,还是重写 problem representation?LeGend与 miter-aware LEC代表两种不同插入点,它们能否组合?〔CLM-DV-LEGEND-001〕〔CLM-DV-LEC-001〕
12.3 DFT/Test
ATPG-free test-point insertion最终是否仍需 ATPG 做验证?若完全不用 ATPG,ground truth 与 coverage 怎样获得?R-0438 的全文将直接决定这个题名是「训练时不用」还是「流程里不用」。〔CLM-DFT-001〕
LLM assertion generation进入 functional safety 时,如何处理 requirement traceability、ASIL、vacuity、fault model和 certification evidence?R-0440 是否把自然语言生成真正接到了 proof 与 fault criticality,仍需全文核验。〔CLM-DFT-001〕
12.4 后端
Differentiable optimizer如何给出可信 uncertainty,并在梯度与精确 STA 不一致时自动回退?Quad-gradient的物理校准能否跨 library、跨 corner保持稳定?〔CLM-BE-GATESIZE-001〕
Foundation prior在 multi-corner yield 里能否识别超出训练先验的 failure surface?zero tuning 是否需要新的 OOD gate?〔CLM-BE-YIELD-001〕
Wafer-on-wafer placement与网络拓扑优化如何同时纳入 thermal、power delivery、yield和制造容差?峰值 throughput、latency与energy的 placement是否一致?〔CLM-BE-WAFER-001〕〔CLM-BE-WAFER-002〕
12.5 Agentic EDA
能否建立跨任务的 Agent audit format,统一记录输入 artifact、动作、工具、验证结果、成本和回滚?若没有共同格式,benchmark很难比较,企业也难治理。
Agent失败应该按模型错误、工具错误、环境错误、约束冲突、预算不足还是数据缺失分类?如果 failure taxonomy不统一,RL reward和运营指标都会被污染。
最关键的问题仍是责任:谁批准 Agent 修改 golden source、constraint或signoff setting;谁对逃逸错误负责;什么证据足以让人签字。技术上能执行,不等于组织上能接受。〔CLM-REC-001〕〔CLM-MATURITY-001〕
芯片是视角,AI 是目的地。
关注「芯片人-晒 AI 笔记」