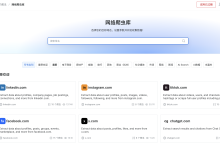
有个真实体验,以前我们写爬虫采集网页,都是通过Python requests去请求http获取html网页,然后用beautifulsoup解析字段,最终才能拿到想要的数据。 但我最近发现不少爬虫工具也CLI 智能体化了,我这几天用了Bright Data新出的爬虫CLI,几乎把Python爬虫能干的活都给干了,而且还能自动处理网页反爬限制,比如验证码、浏览器指纹、JS动态渲染、IP监测等。


我看了它们的Github readme,这个CLI不光可以一键采集任意网页,还能实现谷歌关键词搜索、AI智能查找排序,能提取40多个全球主流电商、社媒网站的结构化数据,比如亚马逊的商品信息、领英的职位信息等。


安装Birght data CLI非常的简单,通过npm安装,只需要打开命令行,输入以下代码: npm install -g @brightdata/cli 出现采集logo,即代表安装好了。 以下可以获取key https://get.brightdata.com/webscra 然后你就可以去采集各种数据,操作非常简单。