📝 实战数据:和前面 16 篇共用一套四表数据(员工表/订单表/用户表/任务表),文末给出完整 DROP+CREATE+INSERT,复制即可跑
🔗 系列目录:零基础学SQL:从入门到精通完整目录 📌 上篇回顾:篇16 自连接(一张表当两张表用) ⏱️ 阅读时长:约 10 分钟 🖼️ 本文含 3 张原理图(主表挂载 / 5 步流程 / 结果对比),发布时按文末"配图清单"上传
一、先搞懂:多表查询的本质是"定主表 + 往上面挂"
先看一个真实需求——老板要一张报表:
每个部门的员工数、订单总额、已付款订单数。
这个需求要跨两张表才能算出来:员工信息在员工表,订单信息在订单表。很多人一上来就写 FROM 员工表, 订单表 WHERE …,写完发现数字对不上,也不知道错在哪。
根本原因是没想清楚一件事:我这张报表的"一行"代表什么?
答案是"一行 = 一个部门"。一旦确定了这件事,思路立刻清晰:
- 主表 = 能唯一确定"一行"的那张表 → 部门信息来自员工表,所以员工表是主表
- 挂表 = 其余要的数据,一张一张往主表上 LEFT JOIN → 订单表挂上去
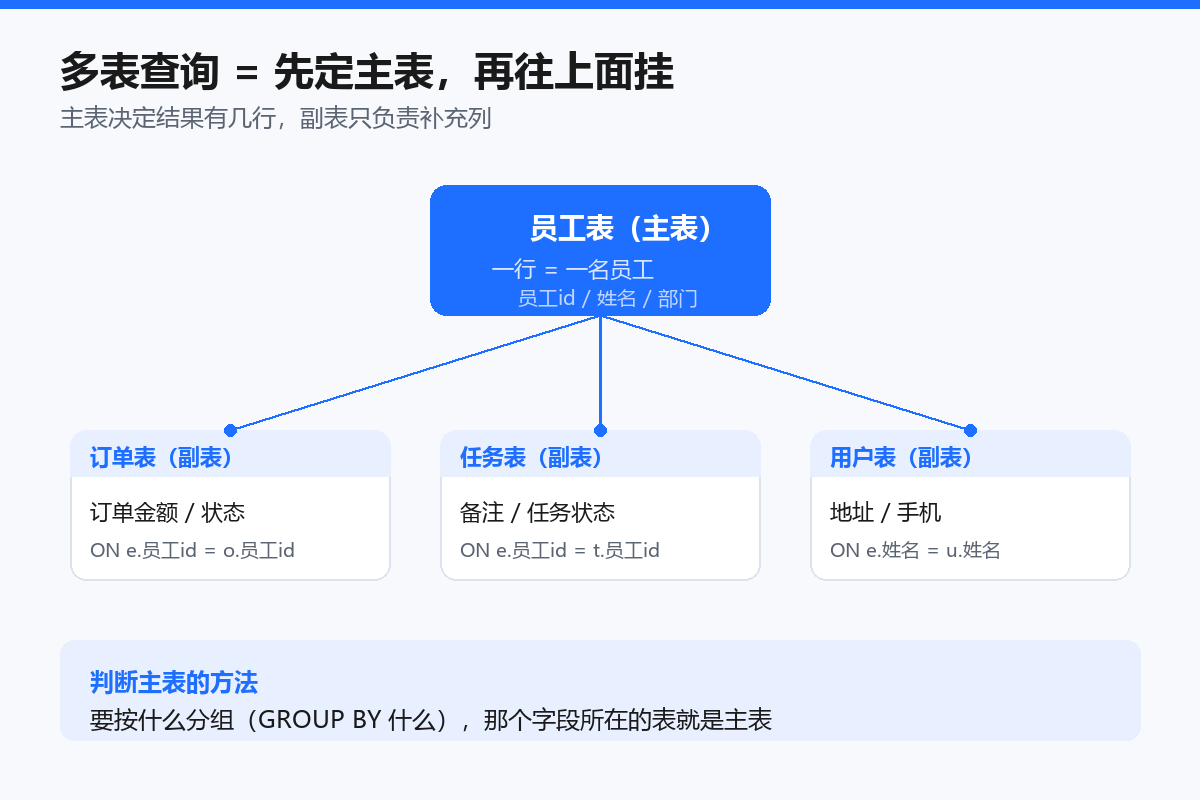
💡 上图:员工表是中间那张主表,订单表、任务表、用户表都通过关联字段"挂"到它身上。多表查询不是把表堆在一起,而是先立住主表,再一张张挂。
关键词记一个:多表查询 = 先定主表(决定行数),再挂副表(补充列)。
二、多表查询 5 步(任何需求都能套)
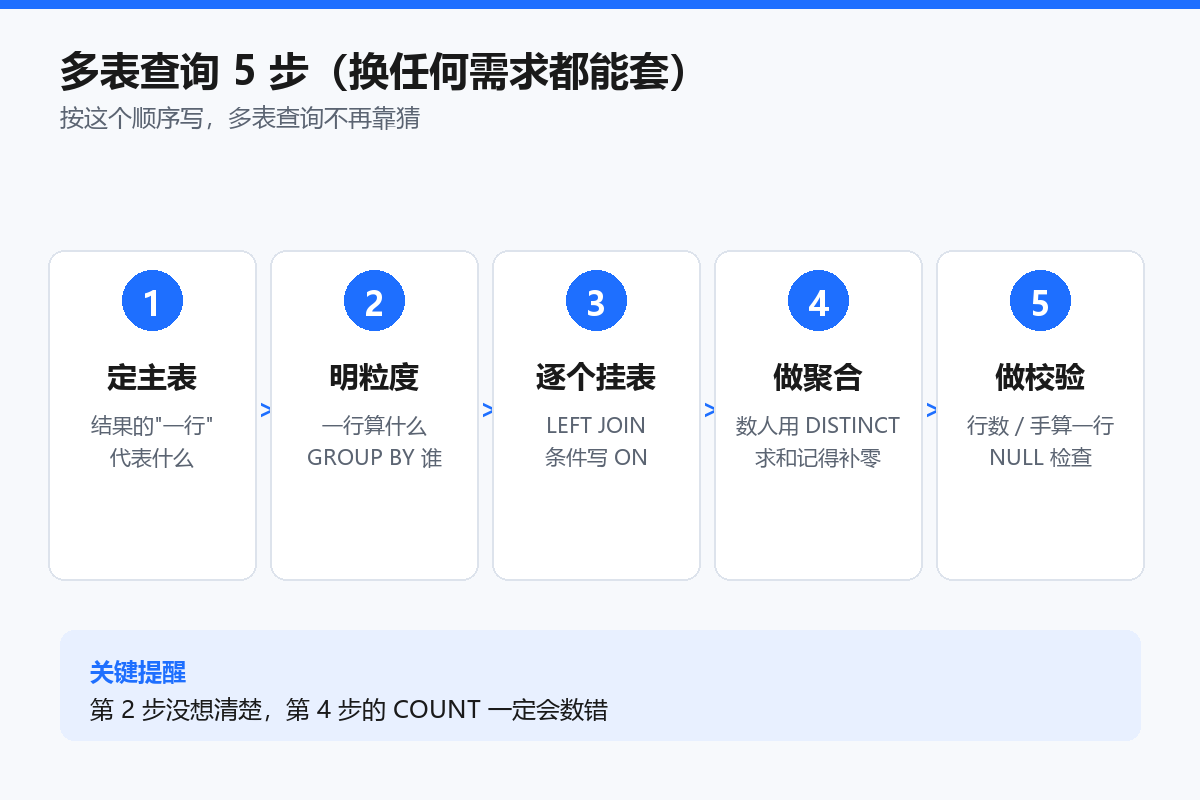
这套流程不只适用于本文的例子,换任何需求、换任何表都能套:
第 1 步:定主表 —— 结果的"一行"代表什么?
先回答这个问题,再动手写 SQL。
| 每个部门的订单情况 | 一个部门 | 员工表(部门在这里) |
| 每个员工的订单数 | 一个员工 | 员工表 |
| 每个订单的详情 | 一个订单 | 订单表 |
| 每个城市的用户数 | 一个城市 | 用户表 |
判断方法:要按什么分组(GROUP BY 什么),那个字段所在的表就是主表。
第 2 步:明确粒度 —— 一行到底算什么
“一行 = 一个部门” 意味着:技术部只出一行。但员工表里技术部有张三、李四两个人 —— JOIN 完之后技术部会变成多行,最后必须靠 GROUP BY 压回一行。
这一步不想清楚,第 4 步的 COUNT 一定会错(详见坑 1)。
第 3 步:逐个挂表 —— 用 LEFT JOIN
FROM 员工表 e
LEFT JOIN 订单表 o ON e.员工id = o.员工id
- 用 LEFT JOIN 而不是 INNER JOIN,是为了保留主表的全部行 —— 一个订单都没有的员工(赵六)也必须出现在报表里,只是订单相关列是 NULL
- 关联条件写在 ON 后面,筛选条件不要写在 WHERE(详见坑 2)
- 列名前面加表别名(e.员工id),多表同名列能直接避免歧义(详见坑 3)
第 4 步:聚合 —— 想清楚"数的是行还是人"
这是最容易出错的一步。JOIN 之后行数会变多,直接 COUNT(*) 数出来的是行数,不是人数。
正确写法:
SELECT
e.部门,
COUNT(DISTINCT e.员工id) AS 员工数,
COALESCE(SUM(o.订单金额), 0) AS 订单总额,
SUM(CASE WHEN o.状态 = '已付款' THEN 1 ELSE 0 END) AS 已付款订单数
FROM 员工表 e
LEFT JOIN 订单表 o ON e.员工id = o.员工id
GROUP BY e.部门;
| 技术部 | 2 | 7000 | 2 |
| 销售部 | 2 | 4000 | 1 |
三个细节:
- COUNT(DISTINCT e.员工id) —— 去重后才是真正的"人数"
- COALESCE(…, 0) —— 没订单的部门会显示 NULL,用 COALESCE 转成 0,报表更好看
- SUM(CASE WHEN …) —— 篇15 讲的 CASE WHEN 用在这里做条件计数,非常实用
第 5 步:校验 —— 三个自检动作
写完别急着交,花 30 秒做这三件事:
三、实战:一个需求串起 4 张表
把需求升级成真正的报表:
每个员工的姓名、部门、所在城市、订单数、订单总额、任务数。
这次要用到全部 4 张表:员工表(姓名部门)、订单表(订单)、任务表(任务)、用户表(城市)。
先看看直接写会出什么问题
— 看起来没问题,实际有坑
SELECT e.姓名,
COUNT(o.订单id) AS 订单数,
COUNT(t.任务id) AS 任务数
FROM 员工表 e
LEFT JOIN 订单表 o ON e.员工id = o.员工id
LEFT JOIN 任务表 t ON e.员工id = t.员工id
GROUP BY e.姓名;
| 张三 | 2 | 2 ❌ |
| 李四 | 1 | 1 |
| 王五 | 1 | 1 |
| 赵六 | 0 | 1 |
张三只有 1 个任务(任务1),为什么数出来 2? 这就是坑 4,后面详解。
正确写法:先把副表各自聚合好,再挂上去
SELECT
e.姓名,
e.部门,
u.地址,
COALESCE(o.订单数, 0) AS 订单数,
COALESCE(o.订单总额, 0) AS 订单总额,
COALESCE(t.任务数, 0) AS 任务数
FROM 员工表 e
LEFT JOIN (SELECT 员工id, COUNT(*) AS 订单数, SUM(订单金额) AS 订单总额
FROM 订单表 GROUP BY 员工id) o ON e.员工id = o.员工id
LEFT JOIN (SELECT 员工id, COUNT(*) AS 任务数
FROM 任务表 GROUP BY 员工id) t ON e.员工id = t.员工id
LEFT JOIN 用户表 u ON e.姓名 = u.姓名
ORDER BY e.员工id;
| 张三 | 技术部 | 邯郸市 | 2 | 5500 | 1 |
| 李四 | 技术部 | 北京市 | 1 | 1500 | 1 |
| 王五 | 销售部 | 邯郸市 | 1 | 4000 | 1 |
| 赵六 | 销售部 | NULL | 0 | 0 | 1 |
注意最后一行:赵六的地址是 NULL —— 因为用户表里只有张三、李四、王五三个人。这是 LEFT JOIN 的正常表现:主表行一定保留,副表没匹配上就填 NULL。
💡 实际项目里员工表和用户表应该用 用户id 关联,而不是姓名(重名就串了)。这里为了演示"4 张表怎么用同一套示例数据串起来",才用姓名关联,你自己的项目千万别这么写。
四、4 个坑(2 个报错 + 2 个不报错但结果错)
坑 1:COUNT 数出来是"行数"不是"人数"(不报错,但结果错)
刚 JOIN 完,员工表 ⊕ 订单表长这样(5 行,不是 4 行):
| 张三 | 技术部 | 101 | 3000 | 已付款 |
| 张三 | 技术部 | 102 | 2500 | 已付款 |
| 李四 | 技术部 | 104 | 1500 | 待付款 |
| 王五 | 销售部 | 103 | 4000 | 已付款 |
| 赵六 | 销售部 | NULL | NULL | NULL |
这时候直接数:
SELECT e.部门, COUNT(e.员工id) AS 员工数, SUM(o.订单金额) AS 订单总额
FROM 员工表 e LEFT JOIN 订单表 o ON e.员工id = o.员工id
GROUP BY e.部门;
| 技术部 | 3 ❌ | 7000 |
| 销售部 | 2 ✅ | 4000 |
技术部明明只有 2 个人,数出来 3 —— 因为张三有 2 个订单,占了 2 行。
最阴险的地方在于:销售部恰好数对了。这种"有的对有的错"最难排查,你会以为自己写法没问题,直到有人质疑"这个部门人数怎么比花名册多"。
修法:数人用 COUNT(DISTINCT e.员工id)。
坑 2:LEFT JOIN 写了,人还是消失了(不报错,但结果少行)
想查"所有人 + 他们已付款的订单",很多人这么写:
— 错误写法
SELECT e.姓名, o.订单id, o.订单金额
FROM 员工表 e LEFT JOIN 订单表 o ON e.员工id = o.员工id
WHERE o.状态 = '已付款';
结果只有 3 行:
| 张三 | 101 | 3000 |
| 张三 | 102 | 2500 |
| 王五 | 103 | 4000 |
李四和赵六不见了。原因:LEFT JOIN 给他们补的 o.状态 是 NULL,而 NULL = '已付款' 的结果是"未知",直接被 WHERE 过滤掉 —— LEFT JOIN 被你写成了 INNER JOIN。 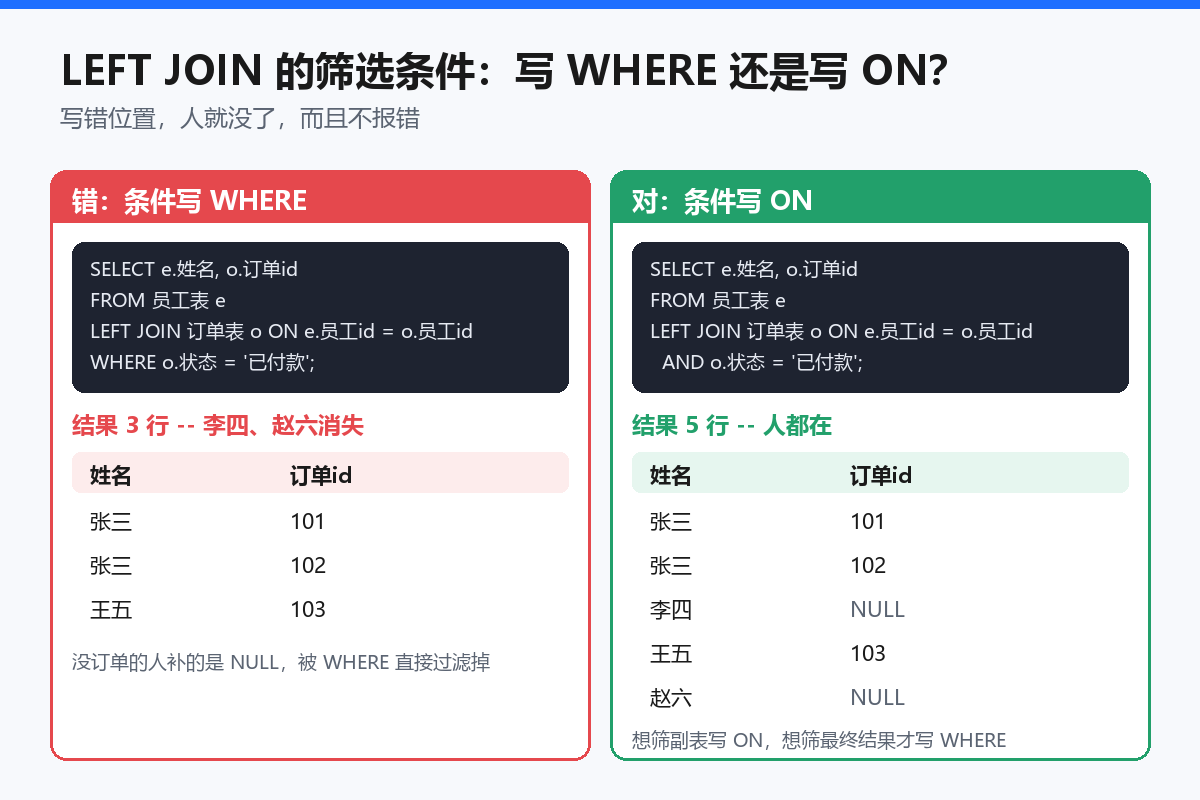
修法:把筛选条件写进 ON,不要写进 WHERE:
— 正确写法
SELECT e.姓名, o.订单id, o.订单金额
FROM 员工表 e LEFT JOIN 订单表 o ON e.员工id = o.员工id AND o.状态 = '已付款';
结果 5 行,李四、赵六回来了(订单列是 NULL):
| 张三 | 101 | 3000 |
| 张三 | 102 | 2500 |
| 李四 | NULL | NULL |
| 王五 | 103 | 4000 |
| 赵六 | NULL | NULL |
一句话记忆:想筛副表 → 条件写 ON;想筛最终结果 → 条件写 WHERE。
坑 3:多表有同名列,SELECT 直接报错(MySQL 1052)
员工表和订单表都有 员工id 这一列,不写别名就会报错:
SELECT 员工id FROM 员工表 e JOIN 订单表 o ON e.员工id = o.员工id;
ERROR 1052 (23000): Column '员工id' in field list is ambiguous
修法:所有列名前面都加表别名(e.员工id、o.订单id)。
建议养成习惯:只要出现 2 张及以上表,每一列都加别名前缀。多打几个字符,省掉一堆 1052 报错。
坑 4:两张"一对多"表直接 JOIN,数字翻倍(不报错,但结果错)
回到第三节那个例子:张三只做了 1 个任务,却数出 2 个。
原因是行数相乘:张三有 2 个订单、1 个任务,JOIN 之后是 2 × 1 = 2 行,COUNT(t.任务id) 把同 1 个任务数了 2 遍。如果他有 3 个订单 2 个任务,就会变成 6 行,任务数被数成 6 —— 数据越干净越不容易发现,数据一多就离谱。
两种修法,按场景选:
— 修法 A(简单):加 DISTINCT,适合只数一种东西
COUNT(DISTINCT t.任务id) AS 任务数
— 修法 B(推荐):先把副表各自聚合好再 JOIN,适合要同时算多种指标
LEFT JOIN (SELECT 员工id, COUNT(*) AS 任务数 FROM 任务表 GROUP BY 员工id) t
ON e.员工id = t.员工id
修法 B 也叫预聚合,它还有个额外好处:JOIN 之前行数就被压到最小,查询快得多。数据量上万行以后,这个差别非常明显。
五、多表查询万能流程模板(换需求直接套,建议收藏)
SELECT
主表别名.分组字段,
COUNT(DISTINCT 主表别名.主键) AS 数量, — 数"多少个",用 DISTINCT 防翻倍
COALESCE(SUM(副表别名.金额字段), 0) AS 总额, — 没匹配上显示 0,不显示 NULL
SUM(CASE WHEN 副表别名.状态 = '目标值' THEN 1 ELSE 0 END) AS 目标数量
FROM 主表 主表别名
LEFT JOIN (
SELECT 关联字段, COUNT(*) AS 副表数量
FROM 副表 GROUP BY 关联字段 — 一对多时先预聚合,防行数膨胀
) 副表别名 ON 主表别名.关联字段 = 副表别名.关联字段
GROUP BY 主表别名.分组字段
ORDER BY 总额 DESC;
套用时的 4 个填空位:
| 主表 | 结果的"一行"代表什么,那个字段在哪张表 |
| 分组字段 | 按什么汇总(部门 / 员工 / 城市 / 日期) |
| 副表 | 要补充的数据在哪张表,一对多就先在子查询里 GROUP BY |
| 关联字段 | 两张表靠哪一列对上(通常是 id) |
写完之后按第 5 步的三件事自检:行数对不对、挑一行手算、有没有该出现却消失的行。
六、课后练习(先自己写,参考答案见文末)
七、参考答案
练习 1:
SELECT e.部门,
COALESCE(SUM(CASE WHEN o.状态 = '已付款' THEN o.订单金额 ELSE 0 END), 0) AS 已付款总额
FROM 员工表 e LEFT JOIN 订单表 o ON e.员工id = o.员工id
GROUP BY e.部门;
| 技术部 | 5500 |
| 销售部 | 4000 |
技术部是 5500 —— 张三的 3000 + 2500,李四那单是"待付款",不计入。
练习 2:
SELECT e.姓名, COUNT(o.订单id) AS 订单数
FROM 员工表 e INNER JOIN 订单表 o ON e.员工id = o.员工id
GROUP BY e.姓名;
| 张三 | 2 |
| 李四 | 1 |
| 王五 | 1 |
这里用 INNER JOIN(只要下过单的人),所以赵六不会出现 —— 这正是 INNER JOIN 的用途。
练习 3:
SELECT e.部门, COALESCE(SUM(t.任务数), 0) AS 任务数
FROM 员工表 e
LEFT JOIN (SELECT 员工id, COUNT(*) AS 任务数 FROM 任务表 GROUP BY 员工id) t
ON e.员工id = t.员工id
GROUP BY e.部门;
| 技术部 | 2 |
| 销售部 | 2 |
每个员工各有 1 个任务,两个部门各 2 人,所以都是 2。如果直接 JOIN 不预聚合,任务数不会错(因为每人只有 1 个任务),但数据量一大就会翻车 —— 养成预聚合的习惯更稳。
八、下篇预告
篇19:窗口函数进阶(PARTITION BY 与 ORDER BY 深入) —— 篇18 讲了 ROW_NUMBER / RANK / DENSE_RANK 的基本用法,篇19 会把"分组内排序"这件事彻底讲透:每组取前 3 名、组内累计排名、去重取最新一条,都是面试和实战的高频题。
说明:篇18(窗口函数实战)已在系列化之前发布,建议先按目录顺序学完篇01-17,再看篇18、篇19。
附:本文用到的测试数据(复制即可运行,可重复执行)
— 员工表(沿用篇16,含上级id 列)
DROP TABLE IF EXISTS 员工表;
CREATE TABLE 员工表 (
员工id INT PRIMARY KEY,
姓名 VARCHAR(20),
部门 VARCHAR(20),
工资 DECIMAL(10,2),
邮箱 VARCHAR(50),
手机 VARCHAR(20),
入职日期 DATE,
上级id INT
);
INSERT INTO 员工表 VALUES
(1,'张三','技术部',9000,'zhangsan@yh.com','13800000001','2019-03-01',NULL),
(2,'李四','技术部',9000,'lisi@yh.com', '13800000002','2020-07-15',1),
(3,'王五','销售部',9200,'wangwu@yh.com', '13800000003','2018-01-10',NULL),
(4,'赵六','销售部',9200,'zhaoliu@yh.com', '13800000004','2021-05-20',3);
— 订单表
DROP TABLE IF EXISTS 订单表;
CREATE TABLE 订单表 (
订单id INT PRIMARY KEY,
员工id INT,
订单金额 DECIMAL(10,2),
下单时间 DATETIME,
付款时间 DATETIME,
状态 VARCHAR(20)
);
INSERT INTO 订单表 VALUES
(101, 1, 3000, '2026-09-01 10:00:00', '2026-09-01 10:30:00', '已付款'),
(102, 1, 2500, '2026-09-02 11:00:00', '2026-09-02 11:20:00', '已付款'),
(103, 3, 4000, '2026-09-03 14:00:00', '2026-09-03 14:30:00', '已付款'),
(104, 2, 1500, '2026-09-04 09:00:00', NULL, '待付款');
— 用户表
DROP TABLE IF EXISTS 用户表;
CREATE TABLE 用户表 (
用户id INT PRIMARY KEY,
姓名 VARCHAR(20),
手机 VARCHAR(20),
邮箱 VARCHAR(50),
地址 VARCHAR(100)
);
INSERT INTO 用户表 VALUES
(1,'张三','13900000001','zhangsan@yh.com','邯郸市'),
(2,'李四','13900000002','lisi@yh.com', '北京市'),
(3,'王五','13900000003','wangwu@yh.com', '邯郸市');
— 任务表
DROP TABLE IF EXISTS 任务表;
CREATE TABLE 任务表 (
任务id INT PRIMARY KEY,
员工id INT,
备注 VARCHAR(100),
状态 VARCHAR(20)
);
INSERT INTO 任务表 VALUES
(1, 1, '完成需求评审', '已完成'),
(2, 2, NULL, '进行中'),
(3, 3, '修复线上bug', '已完成'),
(4, 4, NULL, '待分配');