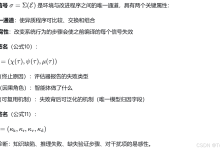
《HRM-Text》的核心贡献是挑战当前大语言模型依赖海量数据和计算的预训练范式,提出并验证了一种极其高效的替代方案。以下是其主要研究内容的全面总结:
一、研究问题与动机
当前LLM预训练存在两大问题:
资源门槛极高:需要海量计算(数千GPU)和数万亿token,将学术机构和小型实验室排除在外
效率低下:大量计算被浪费在预测与任务无关的提示文本上,而非真正需要的响应生成
生物启发:人类大脑通过多时间尺度处理(如额顶环的功能组织)实现样本高效学习。
二、核心创新
2.1 架构创新:分层递归模型(HRM)
用双时间尺度递归替代标准Transformer:
-
慢速H模块(高层):维持稳定的语义上下文,跨周期演进
-
快速L模块(低层):执行局部迭代精炼
-
处理流程:每个高层周期包含3次L更新 + 1次H更新
2.2 稳定性技术
| MagicNorm | 结合PreNorm的梯度优势和PostNorm的前向稳定性,解决递归模型梯度不稳定问题 |
| 渐进式深度信用分配 | 从K=2逐渐增加到K=5,先短程后长程,类似课程学习 |
2.3 训练目标创新
-
放弃原始文本预训练:不预测所有token
-
任务完成目标:仅对响应计算损失 -log P(x_a | x_q)
-
PrefixLM掩码:指令段双向注意力,响应段因果注意力
三、实验设置
| 模型规模 | 1B参数 |
| 训练token | 400亿唯一token(约是基线的1/100~1/900) |
| 训练成本 | 约1,500美元(16块H100,1.9天) |
| 训练数据 | 仅开源指令-响应对,无原始文本预训练 |
四、主要结果
4.1 性能表现
| MMLU | 60.7% |
| ARC-C | 81.9% |
| HellaSwag | 63.4% |
| WinoGrande | 72.4% |
| BoolQ | 86.2% |
| DROP | 82.2% |
| GSM8K | 84.5% |
| MATH | 56.2% |
4.2 效率对比
-
计算量:比Llama、Qwen、Gemma等基线少96-432倍
-
数据量:少100-900倍
-
性能:与2-7B参数的开源模型竞争
4.3 关键发现
递归优于循环:HRM > Looped Transformer > RINS > 标准Transformer
任务完成目标有效:从P(x)改为P(x_a|x_q)显著提升性能
PrefixLM优于因果掩码:注意力熵更高,利用提示更充分
有效深度更大:HRM的深层比Transformer做出更大贡献
五、稳定性分析
论文深入研究了递归深度模型的梯度稳定性问题:
-
完整BPTT的问题:产生罕见的、大幅度的梯度尖峰(乘法放大效应)
-
截断BPTT的优势:避免重尾分布,训练更稳定
-
H循环深度是梯度不稳定的主要贡献者
-
HRM在保持强梯度信号的同时,尾部-中位数比率更低(更稳定)
六、讨论与未来方向
| 知识与推理解耦 | 紧凑递归模型专注推理,外部知识库提供事实 |
| 自适应计算时间 | 简单问题提前终止,节省推理计算 |
| 自动引导 | 插值/外推不同深度logits,无额外开销改善性能 |
| PrefixLM工程化 | 可在vLLM等框架运行,需处理KV缓存 |
七、核心贡献总结
存在性证明:证明不依赖海量数据和计算也能训练出有竞争力的LLM
协同设计:架构(HRM)+ 目标(任务完成)+ 稳定化(MagicNorm)三者缺一不可
民主化:将预训练门槛从数百万美元降至约1,500美元
开源精神:模型权重和训练方法公开,邀请社区参与
八、局限性
-
扩展实验仅到1B参数(Transformer到3B)
-
事实知识覆盖仍弱于更大模型(MMLU 60.7% vs 65%+)
-
推理时计算量高于单次Transformer(但ACT可缓解)
HRM-Text通过分层递归架构与任务完成目标的协同设计,在1500美元、400亿token的极低预算下,训练出性能媲美2-7B开源模型的1B参数LLM,证明高效预训练是可行的,并将基础模型研究民主化。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:

项目地址在这里,如下所示:

预训练模型发布地址在这里,如下所示:

摘要
当前大型语言模型的预训练范式依赖于海量计算资源和互联网规模的原始文本,这为基础研究设置了巨大障碍。相比之下,生物系统通过多时间尺度处理(如额顶环的功能组织)展示了高度样本高效的学习能力。受此启发,我们提出了HRM-Text,用分层递归模型替代标准Transformer,将计算解耦为慢演进的策略层和快演进执行层。为了在语言建模中稳定这种深度递归,我们引入了MagicNorm和渐进式深度信用分配。此外,我们不采用标准的原始文本预训练,而是纯粹在指令-响应对上进行训练,使用任务完成目标和PrefixLM掩码。作为高效预训练的经验性存在证明,一个从零开始训练、仅使用400亿唯一token和约1500美元预算的1B参数HRM-Text模型,在MMLU上达到60.7%,在ARC-C上达到81.9%,在DROP上达到82.2%,在GSM8K上达到84.5%,在MATH上达到56.2%。尽管使用的训练token比标准基线少约100-900倍,估算计算量少96-432倍,HRM-Text仍能与2-7B参数的开源模型竞争。这些结果表明,协同设计架构与目标可以显著降低计算-性能比,使从零开始的预训练对更广泛的研究社区变得可行。

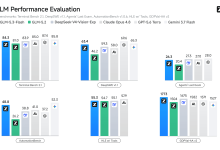
图1:预训练效率。 HRM-Text 1B在16块GPU上训练1.9天,性能与显著更大的2-7B基础模型竞争,同时使用最多432倍更少的计算量和900倍更少的训练token。
1 引言
大型语言模型的显著成功目前由一种单一配方驱动:从互联网规模原始文本开始进行广泛无监督预训练的大规模多阶段流水线。虽然这种方法确实有效,但这种蛮力扩展范式在数据受限的体制中效率极低。大量计算被花费在预测类似提示或与任务无关的文本上,仅仅是为了构建泛化表征[1,2,3]。因此,这种极端的计算障碍基本上将更广泛的研究社区锁在了基础预训练探索之外。普遍假设是,没有庞大的计算集群和数万亿token,探索新架构或从零开始训练是徒劳的。
这种蛮力的数据渴望与人类智能形成鲜明对比,人类仅需几个例子就能掌握规则并进行启发式引导搜索。在我们之前的工作中,我们提出了分层递归模型(HRM),这是一种受生物额顶环功能组织启发的双时间尺度架构[4]。通过将推理解耦为慢演进的策略层和快演进的执行层,HRM提供了结构性的归纳偏置,有助于避免局部停滞,并成功指导了组合任务上的符号搜索。
然而,将递归架构扩展到开放式的语言建模复杂性会引入严重的梯度不稳定风险[5,6,7,8]。仅有结构先验是不够的;要在开放域实现有竞争力的性能,需要整体性的协同设计。在本文中,我们证明架构和训练方法再次变得极其重要。我们探索两个主要的、协同的方向来实现这种样本高效引擎:
架构探索: 为了实现深度计算而不导致参数数量成比例增长,我们基于HRM的模块化、多时间尺度递归。快速L模块执行局部迭代精炼,而慢速H模块在多个周期中维持稳定的语义上下文[4]。为了使这种深度递归在数学上对语言任务可行,我们引入了MagicNorm和渐进式深度信用分配等稳定化技术,这些技术在保持反向优化稳定性的同时限制了前向激活方差[9,10,11]。
目标探索: 我们挑战在原始文本上进行自回归预训练的教条。由于模型在推理时主要用于条件生成,我们直接在指令-响应对上从零开始预训练HRM-Text[12,13,14]。我们优化任务完成目标,仅对响应计算负对数似然损失:-log P(x_a | x_q)[15,16,13]。我们将其与PrefixLM注意力掩码配对,该掩码允许对指令token进行完全双向(类似编码器)注意力,同时对响应保留标准因果生成[17,18,16,3]。
当这两个方向结合时,结果是一个反当前扩展教条的经验性存在证明。HRM-Text在仅400亿唯一token的低预算下从零开始训练,在大多数基准测试中表现出与当代开源模型(如Llama、Qwen、Gemma、OLMo、Ouro和Huginn[19,20,21,22,23,24])相当的性能。引人注目的是,它使用比这些基线约100-900倍更少的训练token和96-432倍更少的估算训练计算量就达到了这一性能水平,如图1和表4所示。
我们不将HRM-Text作为最终或最优的语言模型,而是作为证明特定结构先验和针对性训练目标可以根本改变计算-性能比的证据。由于入门价格大大降低,这种方法使基础AI研究民主化。从零开始的预训练再次变得可行——我们邀请社区加入我们,一起探索智能架构和聚焦目标能走多远。
2 方法

图2:HRM-Text架构。(a) 包含L和H模块的双时间尺度递归设计。(b) L/H模块内部结构,采用MagicNorm——PreNorm块后接最终归一化。(c) Sigmoid门控多头自注意力。(d) PrefixLM掩码,实现对指令的双向注意力。
HRM-Text建立在改进的HRM架构之上,采用双时间尺度递归[4]。前向传播由从输入token嵌入派生的高层状态z_H^0以及固定的低层状态z_L^0初始化。核心处理序列由两个高层周期组成。每个周期执行三次快速的L模块更新,然后是一次慢速的H模块更新。通过对最终H模块状态的输出应用线性头来生成token logits。我们采用渐进式深度信用分配策略:梯度最初仅通过最后两个递归步骤反向传播,随着训练进行逐步扩展到最后五个步骤。
在内部,H和L递归模块都使用MagicNorm构建。此外,我们使用无参数的RMSNorm(省略可学习的γ参数)[25]、SwiGLU激活函数[26]、旋转位置编码(RoPE)[27]和sigmoid门控自注意力机制[28]。
与在原始文本上进行标准自回归预训练不同,我们优化任务完成目标。模型直接在指令-响应对(x_q, x_a)上从零开始预训练,使用仅在响应上计算的负对数似然损失 -log P(x_a | x_q)。该目标自然地与PrefixLM注意力掩码配对,实现对指令token的完全双向注意力。
在接下来的章节中,我们详细阐述实现HRM-Text极端效率的具体机制。第2.1节深入介绍我们新颖的稳定化技术,而第2.2节探讨任务完成预训练目标和PrefixLM掩码策略。
2.1 通过递归扩展到语言
2.1.1 通过MagicNorm实现稳定化
尽管原始的HRM在符号任务上表现出强劲的性能,但将递归架构扩展到语言建模会引入严重的梯度不稳定风险。Transformer设计已经涉及归一化层放置的权衡[9,10];递归放大了这种权衡,因为相同的变换会在多个步骤中重复应用。
PostNorm[29]将归一化放在残差分支外部: h_l = Norm(h_{l-1} + Sublayer(h_{l-1})) 这有效地限制了激活方差并可以提高表达能力,但它破坏了干净的身份路径,并可能导致深度网络中的梯度消失[10]。
PreNorm将归一化放在残差分支内部: h_l = h_{l-1} + Sublayer(Norm(h_{l-1})) 这保持了直接的身份路径h_L = h_0 + Σ Sublayer(·),允许梯度更直接地流向早期层。然而,未归一化的残差累积会导致隐藏状态方差随深度增长,可能导致表征崩溃或相对于PostNorm性能下降。
MagicNorm: 为了解决递归模型中的这种权衡,我们引入了MagicNorm,它利用了由截断时间反向传播引起的前向和后向计算视野的不对称性。
设N表示总的递归前向步数,K表示截断的后向视野,其中K << N。在MagicNorm中,每个递归模块由L个内部PreNorm块组成,但在其出口处用一个最终归一化层封顶: z_n = Norm(z_{n-1} + Σ Sublayer_l(Norm(·)))
在前向传播过程中,递归状态z经历N次模块级归一化操作。由于这些归一化直接位于主递归路径上,它们在每个递归步骤结束时限制激活方差。这防止了纯PreNorm的无界方差增长,并为递归核心提供了类似PostNorm的前向稳定性。
相反,在反向传播过程中,截断的梯度视野意味着误差信号仅通过模块级归一化K次。在同一视野内,梯度还流经L个内部PreNorm身份连接。由于K相对于总递归深度N较小,MagicNorm在优化过程中表现得更像稳定的PreNorm架构。
2.1.2 渐进式深度信用分配
原始的HRM使用固定的1步梯度策略,仅通过最后两个递归步骤(最后一个H和最后一个L)反向传播。我们将这种方法扩展到渐进式深度信用分配。该调度受时间课程原则的启发:早期优化被限制在较短的信用分配路径上,只有在模型达到更稳定状态后才引入更长的路径。这一设计也与生物时间学习理论一致,其中局部痕迹可以支持延迟的信用分配[30],奖励预测信号可以从接近奖励的事件转移到早期线索[31],以及发展性课程可以通过先让学习者接触短程结构再接触长程依赖来改善序列学习[32]。
具体操作上,我们动态调整后向梯度视野K。在早期预训练中,我们仅通过最后两个递归步骤计算梯度(K=2),然后线性增加到最终值K=5。
2.2 任务完成目标与PrefixLM
训练基础模型的主流范式依赖于资源密集的多阶段流水线。从T5到现代大型语言模型[16],训练通常从广泛的无监督预训练开始,然后是更高质量的中期训练。
在预训练阶段,模型在互联网规模的原始语料库上训练以学习通用语言表征。在中期训练(或退火)阶段,模型在高品质文本(通常是指令类数据)上进行精炼。在这两个阶段中,模型优化所有token上的NLL目标 -log P(x)。
虽然有效,但这种方法在数据和资源有限的体制中效率低下。广泛的原始文本预训练消耗了大部分计算和数据,大部分token级损失被花费在预测类似提示或与任务无关的文本上。然而在推理时,模型主要应用于条件生成:给定查询或指令,它们必须产生适当的响应。
为了提高样本效率,HRM-Text省略了广泛的原始文本预训练,直接从零开始在指令-响应对上进行训练。给定一个包含指令和响应的例子x = (x_q, x_a),我们优化以指令为条件的响应的NLL: -log P(x_a | x_q)
通过不预测指令token,模型将其参数更新集中在生成准确响应上。图3-(a)展示了这种效果。尽管使用和不使用任务完成目标的总损失相当,但与响应组件相关的误差显著更低。
此外,这种单阶段条件目标自然地与PrefixLM注意力掩码[16]对齐。由于模型从不需要自回归地预测指令x_q,我们移除了指令段上的因果掩码:所有指令token双向地相互关注,同时在响应序列上保持标准因果掩码。这给了HRM-Text一种在解码器风格实现内部的编码器-解码器式分离。指令段首先作为一个完全可见的上下文被集成,类似于编码器侧表征,而响应段自回归生成,类似于解码器。
图3(b)显示PrefixLM导致更高的注意力softmax熵,表明注意力分布在更多样化的token集合上。图3(c)显示因果注意力更具局部性,而PrefixLM注意力更具全局性和多样性。总之,响应专用条件损失和PrefixLM注意力共同提高了数据和计算受限体制下的样本效率。

图3:任务完成和PrefixLM改善响应建模。(a) 与完全因果语言建模P(x)相比,响应专用训练P(x_a|x_q)降低了响应token的NLL。PrefixLM进一步改善了响应损失。(b) PrefixLM相对于因果掩码增加了层间注意力熵,表明对提示的利用更广泛。(c) 注意力图展示了质差:因果注意力保持局部和三角形,而PrefixLM实现了提示中的全局双向交互。
3 结果
由于本文的核心问题是:在小的预训练预算下从随机初始化训练的模型能否达到有意义的大语言模型性能水平?我们将此问题作为小预算设计探索来探讨:首先,架构选择能否改善固定训练计算的使用;其次,目标和输入结构能否提高每个训练示例的产出。最后,我们将HRM-Text与当代完全开源和开放权重的模型进行比较,以量化其相对于当前预训练实践的效率,并分析递归架构是否增加了有效深度。所有模型的训练细节见第4节。
在这些实验中,HRM-Text使用第4.1节描述的任务格式混合数据从零开始训练,仅使用400亿唯一token。我们报告来自单个HRM-Text检查点的所有性能。
3.1 匹配训练计算下的架构效率
探索的第一部分询问架构设计能在多大程度上改善固定训练预算的使用。我们通过在匹配的训练计算下比较标准Transformer、更大匹配FLOPs的Transformer、Looped Transformer[33]、RINS[34]和HRM来测试这一点。
表1:训练FLOPs匹配下递归架构与Transformer模型的比较。 粗体表示每列最高分,下划线表示第二高分。

表1比较了训练FLOPs匹配的递归架构(包括HRM、looped Transformer和RINS)与标准Transformer。对于递归模型,递归列中的值表示每次前向传播的总计算量,表示为如果不存在递归所需计算的倍数。例如,H2L3表示2个外部H周期,每个外部周期内部有3个L步骤,总共2 × (3 + 1) = 8个H/L模块步骤。由于每个H或L模块包含完整HRM递归核心非嵌入参数的一半,这对应于表中的4次递归。对于标准Transformer模型,该值为1。
Looped Transformer和RINS通常优于相同规模的Transformer模型,表明递归或循环计算是一种有效的架构方向。然而,当与匹配训练FLOPs预算的更大Transformer相比时,它们的优势不太一致。HRM是这种架构设计空间中的一个强实例,并且相对于所列基线(包括更大的深度Transformer)表现良好。
在递归设计中,我们进一步将HRM与TRM进行比较,以区分分层双时间尺度递归与共享参数的双时间尺度递归变体。
表2:与TRM的性能和稳定性比较。 HRM在所有规模上保持稳定的训练动态,而TRM在1B参数规模上遭受严重的不稳定性。此外,在0.6B规模上,HRM在大多数基准测试上达到有竞争力的性能,同时需要的计算量比TRM少2倍。

TRM是一种HRM变体,共享H和L模块参数,在较小规模上针对符号推理问题取得了强劲结果。表2比较了HRM和TRM。由于TRM在H-L模块间共享参数,有两种方法可以大致匹配FLOPs:保持总参数数量固定并减少递归次数,或保持递归结构固定并减少参数数量。在第一种设置中,TRM训练不太稳定,可能是由于递归减少削弱了预期的迭代计算。在第二种设置中,额外的递归稳定了训练并提高了性能,但模型仍然落后于FLOPs匹配的HRM。HRM在此比较中实现了大致相当或更强的性能,同时使用的FLOPs明显少于TRM。
这些结果支持了小预算设计探索的第一部分:递归和循环架构可以改善固定训练计算下的基准测试产出,而HRM是这个更广泛架构设计空间中的一个有效点。
3.2 任务完成目标与PrefixLM的产出
探索的第二部分询问训练目标和输入结构能否提高每个训练示例的产出。我们通过一个增量消融实验来测试,从使用因果注意力的完整问答对训练的标准Transformer开始,然后添加任务完成目标、PrefixLM注意力,最后是HRM架构。所有实验都是FLOPs匹配的。
如表3所示,任务完成目标、PrefixLM训练和HRM架构各自对整体性能有显著贡献。引入任务完成目标在所有基准测试上建立了初步增益,而PrefixLM训练相对于标准因果掩码进一步增强了这些结果。最终,从标准Transformer过渡到HRM架构带来了全面、持续的性能提升。
表3:不同架构和目标下的性能比较

3.3 与当代开源模型的比较
在探索了小预算设置下的架构、目标和输入结构后,我们将得到的HRM-Text检查点与使用显著更大预算训练的当代完全开源和开放权重模型进行比较。
图1和表4将HRM-Text 1B与当代完全开源和开放权重模型(包括Llama、Qwen、Gemma、OLMo以及递归模型Huginn和Ouro)进行比较。HRM-Text在大多数基准测试中在这些模型中实现了强劲的性能,同时尽管参数量更小且预训练预算仅为400亿唯一token,在MMLU上仍保持竞争力。这种模式与HRM-Text的角色一致:递归深度和任务完成预训练改善了推理和任务执行,而广泛事实知识覆盖仍然对模型规模和数据广度更敏感。HRM-Text以比所比较的开源基线少96-432倍的估算训练计算量和约100-900倍的训练token数达到了这一性能范围。这一比较支持了本文的核心问题,表明一个小型的、面向任务完成的预训练运行可以进入用远更大token和计算预算训练的开源模型的性能范围。
表4:HRM-Text 1B与当代完全开源或开放权重模型的评估结果

我们报告的扩展实验延伸到Transformer的3B参数和HRM-Text的1B参数。在此范围内,结果表明使用有限数据量训练的模型可以保持与使用更大数据集(高达36T token)的当代工业规模预训练工作的竞争力。在更大模型规模上展示类似的效率增益仍属于未来工作的范畴。
3.4 有效深度分析
我们假设HRM的有效性源于其递归性,增加了有用的内部计算量。我们通过检查HRM是否表现出比标准和循环Transformer基线更大的有效深度来测试这一假设。
图4从两个角度展示了有效深度:(a)相邻递归块之间差异的范数,以及(b)块级表征的余弦相似度。这两个指标都表明,HRM在深度上比标准Transformer和其他循环模型保持了更活跃的表征变化。

图4:有效深度分析。(a) HRM的每一层相对于其前一层都显示出显著变化,表明HRM的深层仍在为隐藏状态做出有意义的贡献。(b) HRM的块级表征余弦相似度更小,而其他模型变体更容易受到常见层表征过平滑问题的影响,类似于标准Transformer。
遵循Hu等人[36]的方法,我们还使用logit透镜分析来评估模型的输出分布多早开始稳定。我们使用模型的输出投影头解码来自不同层的隐藏状态,然后计算每个探测预测与最终模型分布之间的KL散度。如图5所示,标准Transformer和循环Transformer都在相对较早的层收敛到稳定的输出分布,表明它们的深层做出的增量贡献较小。相比之下,HRM在深层保持更大的KL值,表明有效深度更大。

图5:每层logit透镜KL。HRM在深层显示出最大的logit透镜KL,而标准和循环Transformer都在浅层收敛到稳定分布。
4 训练细节
4.1 数据集
我们仅在开源数据集上训练HRM-Text,包括通用指令、重写知识、数学和符号任务、教科书练习以及网络提取问题。初始语料库包含约1765亿token,涵盖约5.937亿个文档。从中,我们采样400亿唯一token用于总训练时长600亿token,重复由下面描述的分层采样调度控制。表5总结了数据集组成。
表5:用于HRM-Text训练的数据集,按类型分组。
| 通用指令 | FLAN14, Tasksource37, NoRobots38 | 138.7B | 379.9M | direct / cot |
| 重写维基百科知识 | SYNTH39 | 21.7B | 60.8M | synth, direct / cot |
| 数学与推理 | Platypus40, Principia41, OpenMathInstruct42, NuminaMath43, OmniMATH44 | 6.8B | 25.7M | synth / synth, cot |
| 符号推理 | DMMath45, AMPS46, Sudoku-Extreme | 6.2B | 120.7M | direct |
| 推理(思考token已移除) | AceReason47, OpenThoughts248 | 2.4B | 3.6M | synth, cot |
| 教科书练习 | TextbookReasoning49 | 358.1M | 1.2M | synth, cot |
| 提取的网络指令 | NaturalReasoning50, WebInstruct-verified51, AMPS-khan46 | 375.1M | 1.8M | noisy / direct / cot |
为了在推理时控制响应属性,我们根据目标响应风格在指令前添加特定条件标签。我们使用四种主要条件:direct(仅答案)、cot(思维链)、synth(合成答案风格)和noisy(带有不均匀格式的网络爬虫文本)。如表5的"条件"列所述,这种方法利用条件训练[52,53],使得在生成时能够显式选择模型的输出格式。
为了将训练信号集中在最终任务完成上,我们在训练前移除所有被<think>…</think>标签包围的文本。
表6:用于构建训练混合数据的分层采样限制。
| FLAN | 5k 文档/任务 |
| Tasksource | 10k 文档/任务 |
| SYNTH | 10M 文档 |
| AceReason | 2M 文档 |
| OpenThoughts2 | 500k 文档 |
| DM Math | 100k 文档/任务 |
| Sudoku | 1M 文档 |
| 小数据集(≤50k文档) | 原始大小的10倍 |
| 其他数据集 | 原始大小 |
这消除了主要由带可验证奖励的强化学习训练产生的显式长思维链痕迹[54],与HRM-Text依赖其内部分层计算而非显式推理步骤的目标一致。
我们采用SeqIO风格的分层采样[55],将每个数据集或任务视为独立的分层,而不是从池化语料库中均匀采样。为了确保平衡的训练混合并防止大数据集的过度表征,我们对每个任务或每个数据集的文档数设置上限,同时对较小数据集进行上采样。具体的采样限制和乘数详见表6。
4.2 数据集污染
虽然我们的预训练数据来自广泛使用的公共来源,且许多来源执行了去污措施,但考虑到预训练的规模,残留污染可能仍然存在。为了严格评估我们模型的基准测试性能是否因暴露于测试示例而人为获益,我们采用了改编自Llama系列的统计测试[56]。
我们对所有评估基准的问题进行token化(不包括少样本示例),并识别与完全token化的预训练语料库的n-gram匹配。样本的污染百分比定义为参与这些匹配n-gram的token所占比例。
为了确定污染是否会夸大性能,我们根据污染百分比将评估数据划分为四个重叠子集:"Clean"(<20%)、"Not Clean"(≥20%)、"Not Dirty"(<80%)和"Dirty"(≥80%)。要使污染被认为具有显著影响,"clean"样本的表现必须明显差于平均水平,而"dirty"样本的表现必须明显更好。对于大小为k的每个子集,我们计算经验平均性能X̄和检验统计量Z_k = (X̄ – μ_k)/σ_k,其中μ_k和σ_k是大小为k的采样分布的均值和标准差。仅当|Z_k| > 2跨越所有四个子集时,我们才认为数据集污染提供了统计上显著的性能提升。
表7:HRM-Text 1B的DROP数据集污染分析结果。
| DROP (n=13) | Clean | 0.0 | 5904 | 81.18 | 82.3 | -2.53 |
| Not Clean | 90.5 | 3632 | 84.28 | 82.3 | 3.23 | |
| Not Dirty | 6.1 | 6576 | 80.88 | 82.3 | -3.25 | |
| Dirty | 97.5 | 2960 | 85.58 | 82.3 | 4.85 |
我们使用n=13和n=20对HRM-Text 0.6B和1B应用此测试,涵盖表4中显示的所有基准。HRM-Text 0.6B在两种设置下均未表现出显著污染。HRM-Text 1B在DROP基准上对n=13表现出统计显著性(如表7所示),但对n=20则没有。尽管如此,HRM-Text 1B在DROP的严格干净子集(平均污染0%,5904个样本)上仍达到81.1的分数,表明尽管污染可能带来边际潜在收益,但模型仍具有强大的基线泛化能力。
总体而言,这些分析表明HRM-Text的基准测试性能不太可能由先前暴露于测试示例而人为驱动。
4.3 架构与优化细节
HRM-Text 1B在两个8xH100节点上预训练了46小时,成本约为1472美元(假设每个H100小时2美元)。我们在下面总结模型、优化和基础设施设置。
分词器。 我们采用字节对编码分词器,词汇表大小为65,536,使用tokenizers库训练。
模型配置。 每个模块是由16层组成的Transformer,隐藏大小为1536,头大小为128。我们使用上下文大小4096和θ=10,000的RoPE位置编码。RMSNorm的ε参数设为10^{-6}。所有模型以bfloat16精度训练,所有模型权重使用LeCun normal初始化。
优化。 我们使用Adam-atan2优化器[57],β1=0.9,β2=0.95,权重衰减0.1。学习率在2000步内线性预热,然后保持在2.2×10^{-4}。不使用梯度裁剪。批量大小为196,608个token。我们不应用标准学习率衰减,而是以衰减率0.9999维护模型权重的指数移动平均。我们的最终评估和公开发布的模型权重都使用此EMA检查点。
基础设施。 并行化框架基于PyTorch FSDP2[58]。所有模型在单次连续运行中训练。我们不使用中间检查点、崩溃恢复或跳过损失尖峰。
5 讨论
5.1 走向知识与推理的解耦
我们的结果表明了一个部分解耦事实覆盖与推理计算的方向。HRM-Text仅使用400亿唯一token训练,且明确的知识导向源只占任务格式混合数据的一小部分。尽管如此,模型在MATH和GSM8K等推理密集型基准上实现了强劲的性能,同时在MMLU等更广泛的知识基准上保持了非平凡的性能。这种模式表明,紧凑的递归模型可以学习有用的任务执行和推理行为,而无需通常与万亿token预训练相关联的广泛事实记忆。
这一观察激发了未来将紧凑推理核心与事实存储分离的系统。在这样的系统中,像HRM-Text这样的递归模型可以专注于计算、规划和任务执行,而事实广度由精选语料库、检索增强存储或学习到的记忆模块提供。最近的如Engram等条件记忆方法指向了相关方向:不是强制Transformer骨干通过密集计算模拟静态模式查找,而是引入可扩展的记忆查找作为互补的稀疏轴,释放神经计算用于全局上下文整合和推理[59]。HRM-Text尚未实现检索或条件记忆,但其结果表明将小型递归推理模型与外部或学习到的知识存储相结合是未来工作的一个有前景的方向。
5.2 自适应计算时间
Wang等人[4]为HRM配备了一个自适应计算模块,允许更简单的问题提前终止,在保持接近最优性能的同时减少计算量。我们在HRM-Text中没有使用这个组件,以保持设计和训练过程更简单,但它仍然是提高性能和计算效率的一个有前景的方向。当前的递归调度提供了额外的有效序列深度,但相对于单次通过Transformer也增加了推理时间计算。ACT将允许简单提示或token在较少的递归周期后停止,同时为更困难的情况保留完整的递归预算,可能恢复推理开销的很大一部分。因此,我们认为ACT是HRM-Text递归深度设计的自然补充:HRM在需要推理时提供深度,而ACT可以使这种深度变为条件性的而非固定的。
5.3 PrefixLM与推理框架
PrefixLM可以在vLLM等标准文本生成推理框架内运行,而无需根本不同的服务栈。主要要求是在性能分析期间自定义注意力掩码处理,以便指令token可以双向关注,而响应token保持自回归。
在多轮对话中使用PrefixLM风格的注意力模式还需要仔细的KV缓存逻辑:用户token需要在每个用户段内完全注意力,而助手token必须保持因果生成。这是一个工程约束而非概念限制,但在生产推理系统中应明确解决。
6 结论
我们提出了HRM-Text作为高效预训练可实现的经验性存在证明。受生物多时间尺度处理的启发,我们协同设计了分层递归架构与针对性的任务完成目标。这证明了至少存在一个模型家族能够在不依赖主导当前范式的大规模计算和互联网规模原始文本的情况下达到有竞争力的性能。
通过大幅降低计算-性能比,这项工作为未来研究开辟了重要潜力。基础预训练不再被锁在资源丰富的机构内部;它对小型实验室、学术团体甚至个人来说在计算上变得可行。我们希望这种民主化能够赋能更广泛的社区,积极地从零开始探索、训练和创新新架构。
7 相关工作
关于递归神经网络和语言建模的文献非常广泛。在本节中,我们讨论最相关的论文。
7.1 扩展定律与高效预训练
语言模型的发展由扩展定律和计算最优训练驱动,共同规定同时增加参数、数据和计算[1,2]。这支撑了主导配方:在大型语料库上训练的大型解码器专用Transformer,并通过中期和后训练进行精炼[60,61,62,63]。虽然这种扩展范式产生了强大的模型,但它将预训练集中在计算资源丰富的组织中,加剧了日益扩大的计算鸿沟[64,65]。HRM-Text反而探索改进的架构、目标和数据整理是否能改变成本-性能前沿,通过提高每个token和每个FLOP的效率来补充扩展定律。
7.2 条件序列建模与PrefixLM
条件答案P_θ(x_a|x_q)与完整文本流P_θ(x)建模之间的区别早于现代LLM。早期的序列到序列模型和编码器-解码器Transformer明确地对以输入为条件的输出进行建模[15,66,67,29]。T5[16]后来将NLP任务统一为文本到文本生成,强化了这种条件框架。在语言模型的指令调优阶段,NLP数据集被转换为指令-响应对,并且通常应用掩码使得损失仅在响应token上计算[12,13]。像FLAN这样的扩展方法表明,这种任务格式化改善了泛化能力[14,68]。
解码器专用模型将提示和响应连接成一个因果流并预测所有token。虽然可扩展,但这效率低下:提示在推理时已知,但训练仍然对重构提示分配损失。
PrefixLM风格的目标桥接了解码器专用模型和条件生成:前缀token双向关注,而输出保持因果[17,18,16,3]。HRM-Text直接建立在此脉络上,使条件建模成为主要的预训练目标,使用响应专用损失和PrefixLM掩码来结合编码器-解码器行为与解码器专用简洁性。
7.3 潜在计算与递归语言模型
一系列工作试图通过增加内部计算而非仅仅扩展参数或输出token来提高模型能力。Universal Transformer将递归深度引入自注意力[33],后来的递归或块递归Transformer变体在步骤或层间重用参数[7,6,69]。这些方法呼应了经典的递归网络思想,但继承了长程信用分配不稳定的挑战[5,8]。
最近的潜在推理方法在输出答案之前在内部精炼隐藏状态[70,71]。递归深度语言模型如Huginn和循环语言模型如Ouro[72]将这一思想扩展到语言建模和测试时计算[24,72]。同时,CCDD[73]建立了循环Transformer与具有潜在推理优势的连续扩散语言模型之间的联系。这些工作表明潜在递归是纯token级推理的一个有前景的替代方案,但许多仍然依赖于大的token预算、阶段式训练或广泛的测试时递归。
HRM-Text建立在分层推理模型的基础上,该模型使用双时间尺度递归设计进行符号推理[4]。与先前工作一样,它强调更丰富的内部计算,但不同之处在于它在小的token预算下从零开始训练,并使用分层双时间尺度架构。相关工作如TRM探索了更小的递归模型[35],表明层次结构、时间分离和递归可以实现有用的序列计算,但由于更大的状态和更广泛的数据,将其应用于语言仍然具有挑战性。
7.4 稳定的递归优化
稳定性是递归深度语言模型的关键挑战。在Transformer中,归一化放置权衡了前向稳定性和梯度流:PostNorm稳定激活但在深度上更难优化,而PreNorm改善梯度但冒残差增长和表达能力下降的风险[9,10]。递归加剧了这个问题,因为重复的变换在反向传播过程中创建了雅可比类算子的长乘积。先前的工作表明精确的长视野信用分配通常是不切实际的[5,11],对随机矩阵乘积和神经梯度的研究表明深度乘法路径导致重尾、对数正态般的变异性[74,75,76]。
HRM-Text使用架构特定技术解决这些稳定性问题:MagicNorm和深度信用分配的渐进式预热。这些设计选择将HRM-Text与通用的循环Transformer区分开来,并且对于使递归深度在语言模型规模上保持稳定至关重要。
附录
A FLOPs估算
对于稠密模型,我们使用标准训练FLOPs估算F = 6ND。
对于递归模型,我们分别计算前向和后向递归展开。前向计算计为2ND,后向计算计为4ND,然后将这些项按每次传递中包含的递归步骤数进行缩放。
B 评估细节
表8:共享评估配置
| 最大评估上下文 | 3072 token |
| 解码温度 | 0 |
| 系统提示 | 无 |
| 提示内容 | 仅原始问题 |
| 基线分数 | 可用时来自原始论文;否则从开放权重重新运行 |
评估提示包含原始基准问题,以及当基准协议要求时,相应的少样本示例。仅对少样本评估添加少样本示例。我们不添加额外的系统提示。除非另有说明,解码是确定性的,温度为零,最大上下文长度为3072 token。
基线分数在可用时取自原始论文(在可比设置下)。当论文报告的分数不可用时,我们直接评估相应的开放权重模型。所有少样本评估都使用与HRM-Text相同的配置运行,并使用vLLM推理引擎。思维链评估使用lm_eval_harness运行。
C 递归深度模型中的稳定优化
C.1 HRM中深度BPTT下的梯度稳定性
时间反向传播是训练递归计算图的规范机制,然而大量先前工作已经确定通过完全展开传播梯度通常是不必要的,并且可能对优化有害。另一方面,截断后向视野可以通过用行为更稳定的随机估计器来换取精确的长程信用分配,从而改善实际收敛。这种偏差-稳定性权衡已在递归文献中被形式化和利用,激发了原则性的截断方案以及对何时以及为何截断改善训练动态的分析[11]。相比之下,对于HRM或其他现代循环架构,类似的诊断仍未充分发展,其中重复应用共享块引入了隐式递归,有效后向深度由反向传播的循环迭代次数控制。

图6:(a) 完整BPTT相对于截断设置表现出罕见但显著更大的梯度幅度尖峰,表明更长的后向视野引入了间歇性的高幅度梯度事件。(b) 值在诊断检查点内归一化,以隔离后向深度对全局训练时漂移的影响。更深的H循环增加了对数幅度离散度。
我们假设在循环架构中深度BPTT下观察到的不稳定性是梯度通过重复迭代传播的内在乘法结构的结果。具体来说,梯度通过循环步骤间的雅可比类算子的乘积反向传播,关于许多随机矩阵乘积的理论预测,此类乘积范数的对数近似高斯分布,意味着梯度幅度的对数正态样变异性,并且随着后向深度增加,典型值与极值之间的分离增大[74]。补充这一理论视角,经验证据表明神经梯度幅度通常接近对数正态,与将质量集中在小幅度附近同时产生相对重尾的乘法机制一致[75,76]。
为了检验这些假设,我们在HRM中进行了一项针对性的梯度动态研究,系统性地增加后向H和L循环次数,同时保持前向计算固定。我们首先使用平均绝对梯度幅度量化不稳定性,并在图6a中显示,将后向视野扩展到完整BPTT会在训练过程中产生显著更多的间歇性高幅度梯度事件。然后我们在图6b中使用互补的离散度度量来表征分布异质性,报告对数幅度离散度,定义为Std(log(|g|+ε))。这一度量支持了更深的向后循环增加了梯度幅度中乘法异质性的观点。值得注意的是,对数幅度离散度的增加主要由H循环深度驱动,而非L循环深度。因此,我们将H维度解释为这些实验中梯度幅度扩散的主要贡献者。
最后,我们检查观察到的梯度尖峰是否与乘法放大机制一致。图7a显示雅可比增长随后向深度增加,表明通过递归计算的更深反向传播会更强地放大某些方向。图7b提供了在相同诊断检查点下用于训练的截断设置与完整BPTT参考之间的配对比较。配对散点显示完整BPTT通常与截断相当,但偶尔产生更大的梯度幅度,这与假设一致:完整后向展开主要通过罕见的、高幅度尾部事件损害优化,而非通过梯度尺度的均匀增加。

图7:乘法梯度不稳定的机制证据。左图:雅可比增长随更深的向后循环而增加,与通过循环雅可比乘积的更强放大一致。右图:配对的完整vs截断梯度幅度显示,在相同的诊断检查点,完整BPTT产生罕见的、不成比例的大梯度事件。
我们实验中使用的截断设置是在训练期间保持稳定的最接近完整BPTT的设置,如图6a和图7所示。
C.2 不同递归架构的梯度稳定性
我们进一步通过梯度稳定性的视角比较HRM与RIN和Universal Transformer。由于这三种架构都在深度或递归上重复使用计算,稳定的梯度动态是架构能否有效训练的重要组成部分,而不仅仅是其是否具有足够的表达能力。因此,我们在多次运行中评估两个互补的统计量:中位绝对梯度幅度和尾部与中位数的比率。
图8a显示,随着优化进行,HRM和Universal Transformer保持了更强的训练信号:它们的中位绝对梯度幅度在整个训练过程中保持高于RIN。同时,图8b显示,这种信号并非来自越来越不稳定或罕见的极端更新。相反,HRM和Universal Transformer在整个训练过程中表现出更低的尾部-中位数比率,表明梯度分布变得更加均匀、重尾程度更低、更少被罕见的较大更新主导。

图8:RIN、HRM和Universal Transformer之间的梯度稳定性比较。HRM保持强梯度信号,同时在整个训练过程中表现出越来越均匀的梯度动态,其稳定性比RIN更接近Universal Transformer。
这将HRM置于保留有用梯度信号同时避免与重尾梯度动态相关的不稳定的有利状态。结合主要结果,这表明HRM在提供更好下游性能的同时,保持了更强递归深度基线的训练稳定性。
D 推理时分析
在推理时,我们启用了专门为HRM设计的自动引导[77]机制,该机制通过插值或外推来自不同递归深度的logits来引导自身。虽然有类似的动机,但自动引导比无分类器引导[78]更高效:它在解码时不产生计算开销,因为来自浅层循环的隐藏表示已经可用。
具体来说,假设我们有最终隐藏状态h和来自较早递归循环的另一个隐藏状态h',两者都由LM头解码。具有引导尺度w的自动引导计算为: logits_w = (1+w)·logits(h) – w·logits(h')
w=0恢复标准最终预测;w>0对应于最终层和较浅层之间的外推,将较浅层预测视为负方向;w<0对应于插值,模型平衡来自浅层和深层递归状态的预测。
表9:推理时自动引导。 我们报告标准推理的基础性能,以及最佳性能及相应的引导尺度w∈{-0.5, -0.1, 0, 0.1, 0.5}。
| HRM 1B | 无 | 61.89 | 80.80 | 62.18 | 73.01 | 88.17 |
| HRM 1B | 有 | 62.12 | 80.80 | 62.31 | 73.17 | 88.29 |
表9报告了HRM使用和不使用自动引导的性能,引导尺度在w∈{-0.5, -0.1, 0, 0.1, 0.5}中搜索。我们使用具有两个高层循环的HRM模型,并插值或外推来自这两个H模块的logits。由于中间隐藏状态已经可用,自动引导不引入额外计算。它在测试时略微改善了性能,最佳引导尺度在不同基准间有所不同,表明不同任务可能受益于不同的有效递归深度。
自动引导也与自适应计算时间和测试时缩放密切相关。当插值(w<0)产生更好结果时,任务可能不需要完整的递归深度,表明提前停止可以提高效率。相反,当外推(w>0)表现更好时,任务可能受益于更深的递归计算,可能成为自适应测试时缩放的候选。因此,表9中的结果表明HRM推理可以支持递归深度的自适应控制,在测试时平衡效率和性能。