今天分享的论文是《LLM4Vuln: A Uniffed Evaluation Framework for Decoupling and Enhancing LLMs’ Vulnerability Reasoning》
原文链接:https://arxiv.org/abs/2401.16185
开源代码:https://anonymous.4open.science/r/LLM4Vuln/
这是一篇关于对于纯粹LLM漏洞挖掘能力的评估,以及LLM加入不同模块能力后漏洞挖掘能力的评估,还是蛮有意思的。
大型语言模型(LLM)在各类任务中展现出显著潜力,包括那些需要人类级智能的任务(如漏洞检测)。然而,目前利用LLM进行漏洞检测的相关研究仍处于初步阶段,因为这些研究尚未深入了解目标LLM的漏洞推理能力究竟源于模型本身,还是源于知识检索和工具支持等外部辅助手段。
本文旨在将LLM的漏洞推理能力与其他能力(如漏洞知识采纳、上下文信息检索和高级提示策略)解耦。本文提出了LLM4Vuln——一种统一评估框架,该框架能够分离并评估LLM的漏洞推理能力,并检验其与其他增强手段结合后的性能提升效果。
为支撑这一评估,本文构建了UniVul基准数据集:这是首个涵盖三种代表性编程语言(Solidity、Java、C/C++)、提供可检索知识和可补充上下文代码的基准数据集。借助LLM4Vuln框架和UniVul基准数据集,本文在3528个受控场景中,对6个代表性LLM(GPT-4.1、Phi3、Llama-3、o4-mini、DeepSeek-R1、QwQ-32B)进行了测试,测试对象包括147个真实漏洞案例和147个无漏洞案例。研究发现,知识增强、上下文补充和提示策略对模型性能的影响存在显著差异;此外,本文在四个试点漏洞赏金项目中发现了14个零日漏洞,共获得3576美元赏金。
在快速发展的计算机安全领域,大型语言模型(LLM)极大地改变了本文应对复杂挑战的方式。凭借大规模预训练和强大的指令遵循能力,这些模型在理解和解析人类语言与编程语言语义方面表现出色。这催生了基于LLM的漏洞检测技术,相比传统基于程序分析的技术(如[1]、[2]、[3]、[4]、[5]、[6]、[7]、[8])和基于神经网络的检测器(如[9]、[10]、[11]、[12]、[13]、[14]),该技术具有更高的智能性和灵活性。
在这一新兴范式下(受2022年11月30日ChatGPT [15]、[16]、[17]成功发布的推动),相关研究主要聚焦于两个维度:
– 第一个维度是针对不同安全问题设计特定的基于LLM的检测器。例如,研究者开发了用于各类漏洞模糊测试的工具(TitanFuzz [18]、FuzzGPT [19]、Fuzz4All [20]、ChatAFL [21])、用于智能合约漏洞检测的工具(GPTScan [22]、GPTLens [23]),以及用于LLM增强型程序与二进制分析的工具(LLift [24]、LATTE [25])。
– 第二个维度是对LLM的漏洞检测能力进行基准测试或评估。该维度研究不同模型、配置和指令如何影响检测结果,核心目标是回答“在基于LLM的漏洞检测领域,本文已取得多大进展?”这一问题。值得注意的是,Thapa等人[26]率先开展了相关研究,他们将基于Transformer的语言模型与基于RNN的模型在软件漏洞检测任务上进行了基准对比。随着ChatGPT和GPT-4的发布,更多聚焦LLM的基准测试研究相继涌现,涵盖智能合约漏洞检测[27]、[28]、传统C/C++/Java漏洞检测[29]、[30]、[31]、[32]、[33]以及漏洞修复[34]、[35]等方向。
本文的研究属于第二个维度,但与聚焦单个LLM实例及其配置性能的研究不同,本文深入探究该范式本身,思考其存在的缺失或可改进之处。为此,本文首先将基于LLM的漏洞检测范式抽象并概括为图1所示的架构。现有基于LLM的漏洞检测通常会输入一段目标代码(TC),并通过特定提示策略(如角色扮演[23]、思维链/CoT [36])让LLM判断该代码是否存在漏洞。然而,该范式往往忽视了与目标代码相关的额外信息——例如,目标代码中涉及的函数和变量的上下文信息,而这些信息可由LLM通过调用工具获取。
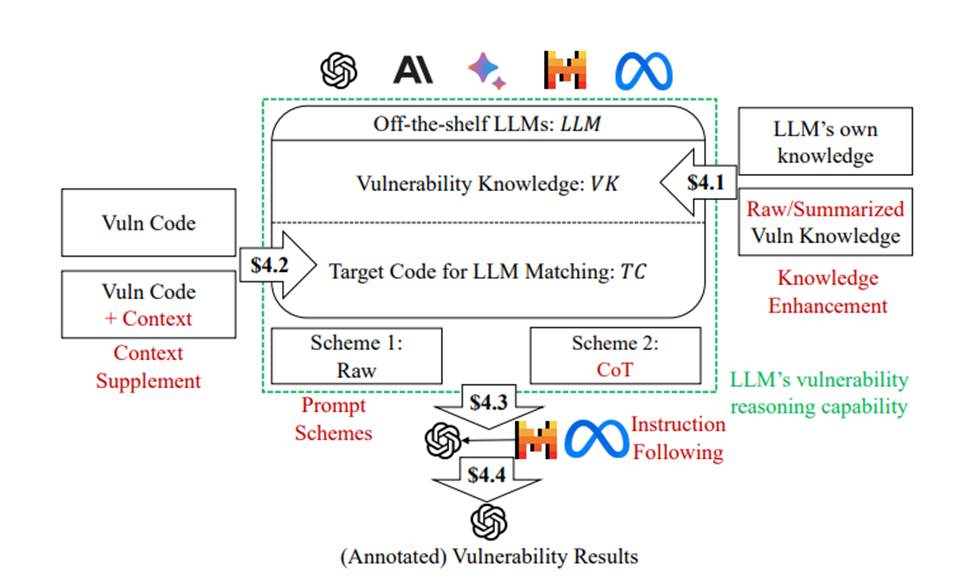
图1 基于LLM的漏洞检测范式与LLM4Vuln框架示意图
更重要的是,LLM的预训练数据存在知识截止日期,这使得LLM难以适应最新的漏洞知识。换言之,将相关漏洞知识(VK)融入检测范式至关重要。此外,开源LLM的指令遵循能力通常弱于OpenAI系列模型,原因是后者通过大量基于人类反馈的强化学习(RLHF)[37]进行了对齐优化,而这种能力差异可能间接影响LLM在自动评估中的推理结果。综上可见,LLM的漏洞推理能力会受到模型本身及配置之外的多种因素影响。
基于这一认知,本文不再将基于LLM的漏洞检测视为一个整体进行评估,而是首次将LLM的漏洞推理能力与其其他能力解耦,并评估当LLM结合其他能力增强手段时,其漏洞推理能力可获得多大提升。至于在不同配置(如不同温度参数)下对模型本身进行基准测试和调优,本文将其归为另一类相关研究——这类研究聚焦于如何预训练面向漏洞或安全领域的专用LLM [38]、[39]、[40]、[41]、[42]、[43]、[44]、[45]、[46]、[47]、[48],已超出单纯语言模型的范畴。
为实现上述研究目标,本文提出了LLM4Vuln——一种用于解耦和增强LLM漏洞推理能力的统一评估框架。如图1所示,LLM4Vuln首先考虑当前最先进LLM主动调用工具以获取目标代码额外信息的能力,例如专有OpenAI模型[49]中的函数调用功能,以及经微调的开源模型[50]、[51]中的同类功能。除了通过LLM调用工具为目标代码补充额外信息外,LLM4Vuln还通过构建可搜索的漏洞知识向量数据库,对LLM的漏洞知识(VK)进行解耦和增强——这一思路类似于自然语言处理(NLP)领域中用于知识增强的检索增强生成(RAG)[52]技术。此外,LLM4Vuln还融入了典型的提示工程增强手段(通过探索不同提示策略实现),并利用性能最强的GPT-4.1模型,对指令遵循能力较弱的模型所输出的原始非结构化结果进行优化。
本文将LLM4Vuln框架应用于UniVul基准数据集,对294段代码在3528个场景中进行了测试(场景组合包括:3种知识增强方式(含1种仅使用LLM预训练知识的方式)、2种上下文补充选项(补充/不补充上下文)、2种提示策略(原始提示/思维链提示)),并采用6个代表性LLM(含3个传统基础模型:GPT-4.1、Phi-3、Llama-3;3个深度推理模型:o4-mini、DeepSeek-R1、QwQ-32B)。研究得出以下四项关键发现(详见第6节):
1. 知识增强的影响
漏洞知识增强的效果具有异质性:对于传统基础模型,知识增强能显著提升其在Solidity(一种富含业务逻辑漏洞的语言)中的性能,F1分数平均接近翻倍;但在Java和C/C++中,知识增强的收益有限,甚至会产生负面影响——这可能是因为LLM在预训练阶段已充分学习了这两种语言中类似CWE的漏洞模式。令人意外的是,深度推理模型从外部知识中获益更少,这表明它们可能在内部更稳健地建模了漏洞语义。
2. 上下文补充的影响
提供局部程序上下文的改进效果不一致:传统基础模型在补充上下文时往往能达到更高的峰值F1分数,而深度推理模型在无上下文时性能通常更优。结果表明,上下文虽偶尔有帮助,但如果与漏洞关联性不强,反而可能干扰LLM的推理。
3. 提示策略的影响
思维链(CoT)提示能提升两类模型的精确率并减少假阳性,但对召回率的影响因任务而异:深度推理模型在CoT提示下表现更稳定,而传统基础模型的性能波动更大。对于传统基础模型而言,CoT在多步分析任务中填补推理空白的作用尤为显著。
4. 模型类型的差异
传统基础模型与深度推理模型在漏洞推理方式上存在根本性差异:前者从外部增强手段中获益更多,而后者则展现出更强的“开箱即用”推理能力。
为验证LLM4Vuln评估结果的实际应用价值,本文开展了一项试点研究(第6.4节),将其应用于四个基于Solidity的漏洞赏金项目。仅使用LLM4Vuln识别出的最优配置,本文共提交了29个问题报告,其中14个被确认是真实漏洞,并获得3576美元赏金。这一结果验证了LLM4Vuln在发现零日漏洞方面的实际效用。
本文主要贡献:
1. 提出LLM4Vuln框架:该框架首次将LLM的漏洞推理能力与知识检索、上下文感知、提示设计等能力解耦,支持在这些维度上进行结构化评估。
2. 构建UniVul基准数据集:这是首个涵盖三种代表性编程语言、提供可检索知识和可补充上下文代码的基准数据集。
3. 开展大规模实验:在3528个场景中进行实验,深入分析知识、上下文和提示设计对不同类型LLM的影响。
4. 验证实际应用价值:在真实漏洞赏金场景中验证LLM4Vuln的有效性,发现14个新漏洞,产生可衡量的安全效益和经济效益。
在本节中,本文对基于LLM的漏洞检测所涉及的问题空间进行形式化定义,为统一评估框架LLM4Vuln的设计提供指导。该形式化定义源于对LLM漏洞检测范式的结构化抽象(参见第1节图1),涵盖了多个关键组件之间的交互关系。
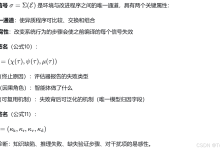
设\\( c \\)代表大型语言模型(LLM),\\( T \\)代表待分析潜在漏洞的目标代码(TC)。漏洞检测任务的核心是判断\\( T \\)是否存在漏洞,并识别漏洞类型及成因。然而,LLM完成该任务的能力并非仅依赖其预训练推理能力,其性能还会受到多个可通过外部手段增强的因素影响:
– 漏洞知识(\\( K \\)):通过漏洞知识库相似性检索获取的补充知识,包含相似漏洞案例,用于辅助LLM进行上下文学习。
– 代码上下文(\\( C \\)):目标代码\\( T \\)周边的额外代码信息(如调用者函数或关联函数),部分漏洞的识别需依赖这些信息才能完成;即使漏洞触发逻辑完全包含在给定代码段内,上下文也有助于LLM更好地理解函数语义。
– 提示模式(\\( P \\)):用于引导LLM进行推理的指令或交互模式,例如零样本提示(zero-shot)、思维链提示(CoT)或角色扮演提示(role-playing)。
– 指令遵循能力(\\( I \\)):LLM遵循输出格式要求的能力,这是确保输出结果结构化、可用于自动评估的关键。
形式上,检测任务的输出\\( R \\)可视为一个函数(表达式略)。但在实际应用中,上述组件往往相互交织,难以分离出LLM自身固有推理能力的贡献。为此,本文的核心目标是将LLM的漏洞推理能力与辅助组件\\( K \\)、\\( C \\)、\\( P \\)、\\( I \\)解耦,进而回答一个根本性问题:LLM的漏洞推理能力在多大程度上源于模型本身,又在多大程度上可通过外部辅助手段增强?
因此,问题最终转化为设计一个满足以下要求的评估框架\\( F \\):
1. 测量LLM独立运行时的基线性能,即仅依赖模型自身能力的检测结果\\( f_{L}(T) \\);
2. 系统性地为LLM叠加\\( K \\)、\\( C \\)、\\( P \\)、\\( I \\)中的一种或多种增强手段;
3. 量化每种增强手段的边际效用,即叠加增强后的性能\\( f_{L}(T, \\cdot) \\)相对基线性能的提升(或下降)幅度;
4. 支持在多种LLM和多种编程语言上开展受控实验。
该形式化问题定义为第4节LLM4Vuln框架的模块化设计提供了依据——框架中各组件均采用“即插即用”模式,支持受控评估和组件级增强。此外,为支撑不同LLM的全面实证分析,本文在第5节构建了标准化基准数据集UniVul。
如图2所示,LLM4Vuln包含四类可插拔组件,用于评估和增强LLM的漏洞推理能力,分别是知识检索(第4.1节)、上下文补充(第4.2节)、提示策略(第4.3节)和指令遵循(第4.3节)。所有组件均实现高度解耦,可轻松替换为其他实现方案;且每个组件仅需一种实现即可确保框架正常运行。最后,仅为基准测试目的,本文在第4.4节设计了一个基于LLM的结果标注组件。
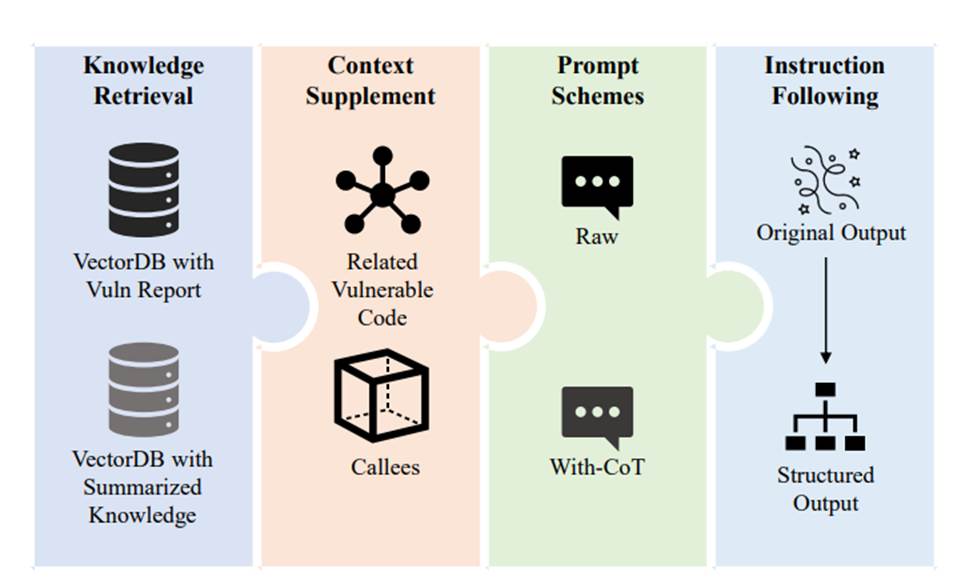
图2 LLM4Vuln用于评估和增强LLM固有漏洞推理能力的四个可插拔组件示意图。核心模块包括知识检索、上下文补充、提示策略、指令遵循,输入为原始输出,输出为带思维链(CoT)的结构化结果。
4.1 漏洞知识检索
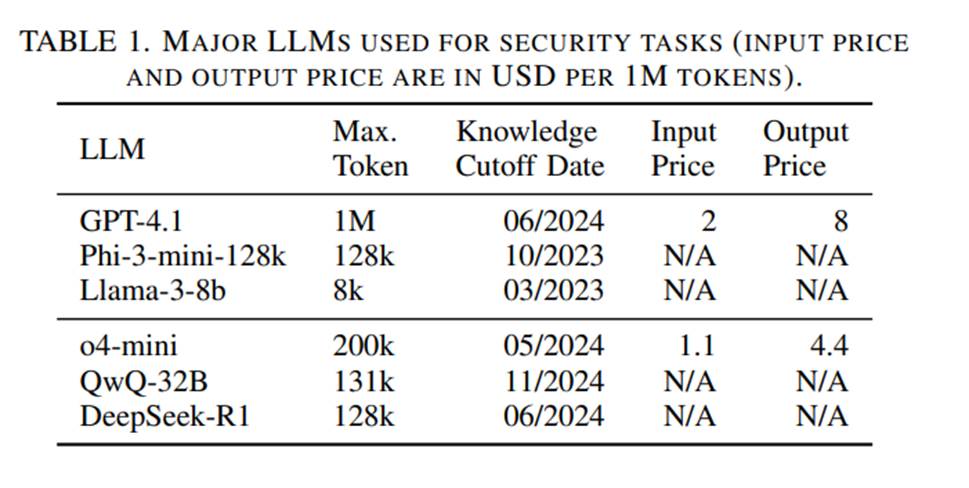
尽管LLM在训练过程中已融入大量代码漏洞数据,但如第1节表1所示,其预训练数据存在明确的知识截止日期。这导致LLM无法获取最新漏洞知识,而该问题在检测动态演变的逻辑漏洞(如智能合约漏洞)时尤为关键。为解决这一问题,LLM4Vuln提出两种漏洞知识检索方法以增强LLM的漏洞知识储备,具体如图3所示。
两种漏洞知识检索方式
第一种检索方式(如图3左侧所示):本文收集原始漏洞报告及其对应的漏洞代码,计算这些报告和代码的嵌入向量(embeddings),构建一个同时包含代码嵌入向量和关联漏洞报告的向量数据库。当输入目标代码段\\( TC \\)时,可直接通过该向量数据库检索最相似的代码段——由于代码段可能包含代码和注释,其中注释可与漏洞报告匹配,代码可与报告中提及的代码对应。检索完成后,本文仅提取漏洞报告的文本内容(排除代码部分),将其作为“原始漏洞知识”用于后续分析。
第二种检索方式:本文首先使用GPT-4.1对漏洞报告进行总结,总结内容需包含漏洞代码的功能描述和漏洞根本原因,并用若干关键句子概括。用于总结代码功能和漏洞核心成因的提示模板详见附录A,总结后知识的示例可在开源仓库[61]中获取。
如图3右侧所示,在完成历史漏洞报告的功能和知识总结后,本文仅计算“功能描述部分”的嵌入向量,构建一个仅包含功能嵌入向量的向量数据库。当输入目标代码段\\( TC \\)时,先通过GPT-4.1总结其功能,再利用该功能描述检索向量数据库中相似的功能条目;通过匹配到的功能条目,可直接获取对应的漏洞知识,将其作为“总结后漏洞知识”用于后续分析。
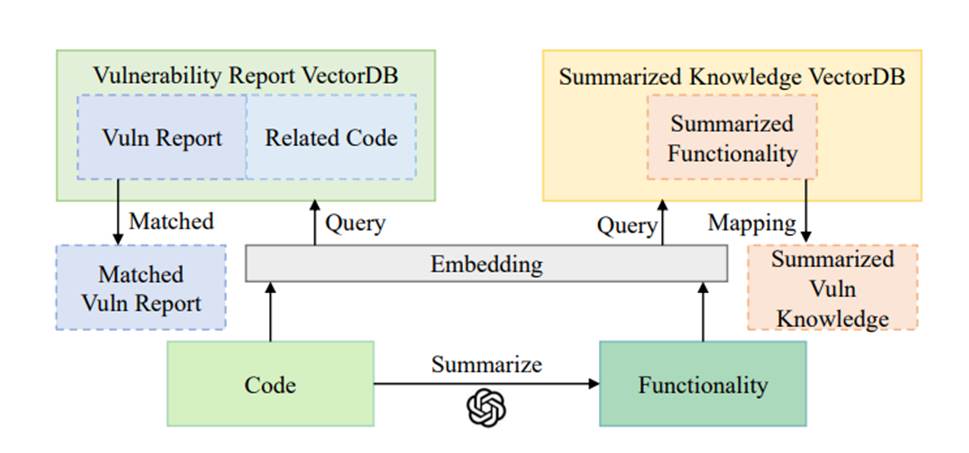
图3两种漏洞知识检索方式示意图,左侧为“原始漏洞报告向量数据库”检索流程,右侧为“总结后知识向量数据库”检索流程。
借助该向量数据库,本文可向LLM提供“token级”的知识相似性匹配结果,帮助其更好地理解漏洞;同时,该方法还可轻松扩展以融入其他自然语言形式的知识——例如,可利用基于图的相似性匹配算法,将代码段的控制流或数据流与知识进行匹配。
4.2 代码上下文补充
如第4.1节图2所示,LLM可基于目标代码\\( TC \\)的给定代码上下文检测漏洞。有时,漏洞的触发逻辑可能隐藏在多个函数中,或需额外上下文才能识别;即使触发逻辑完全包含在给定代码段内,上下文也能帮助LLM更好地理解函数语义。
本文提供两种上下文补充类型:
1. 从漏洞样本的漏洞报告中提取的相关漏洞代码(例如从Code4rena平台和GitHub问题中提取的函数);
2. 所有样本的函数调用关系(用于帮助理解代码间依赖)。
上下文补充操作在将代码输入LLM前完成。仅为基准测试公平性考虑,本文采用静态分析工具确保所有模型的给定代码使用相同上下文,以实现公平对比。
在实际的基于LLM的漏洞检测场景中,LLM可利用函数调用机制[49]、[59]主动检索额外上下文信息。例如,本文可定义一系列函数调用API(如`getFunctionDefinition`(获取函数定义)、`getClassInheritance`(获取类继承关系)、`getVariableDefinition`(获取变量定义)),并附带每个函数的使用说明,辅助LLM在需要时主动调用函数获取信息。不过,更复杂的上下文(如控制流和数据流信息)仍需依赖静态分析工具提供。
4.3 提示策略与指令遵循
本节将详细介绍提示策略的增强方案及指令遵循能力的优化方法。
提示策略
如第4.1节所述,提供给LLM的知识分为两类:原始漏洞报告和总结后漏洞知识;此外,LLM自身在训练过程中已积累漏洞知识。基于此,本文设计了三种提示策略,分别对应三种知识使用方式:仅使用LLM自身知识、使用原始知识、使用总结后知识。如图4所示,这些知识可与不同的思维链(CoT)指令组合,形成两种具体提示方案:
– 方案1:原始提示(Raw)
直接要求LLM生成检测结果,不附加特定推理指令。LLM可使用第4.2节提及的API检索相关代码段;对于开源模型,该方案不包含“调用API检索”的提示语句。
– 方案2:思维链提示(CoT)
要求LLM在生成结果前遵循思维链指令:首先总结给定代码段实现的功能,然后分析可能导致漏洞的错误,最后判断是否存在漏洞。
改进的指令遵循能力
由于LLM的输出均为自然语言,具有非结构化特征,需通过总结和标注转化为最终评估结果。已有研究证实LLM可作为有效的评估器[62]、[63],因此本文采用GPT-4.1对LLM的输出进行自动标注。具体而言,本文通过函数调用API将非结构化回答转化为结构化结果:LLM4Vuln会根据不同提示策略和不同LLM的输出,生成包含两部分核心内容的结构化结果——LLM对“代码是否存在漏洞”的判断,以及判断漏洞存在或不存在的依据。该过程使用的具体提示模板详见附录A,通过此步骤可实现对所有LLM输出的自动标注。
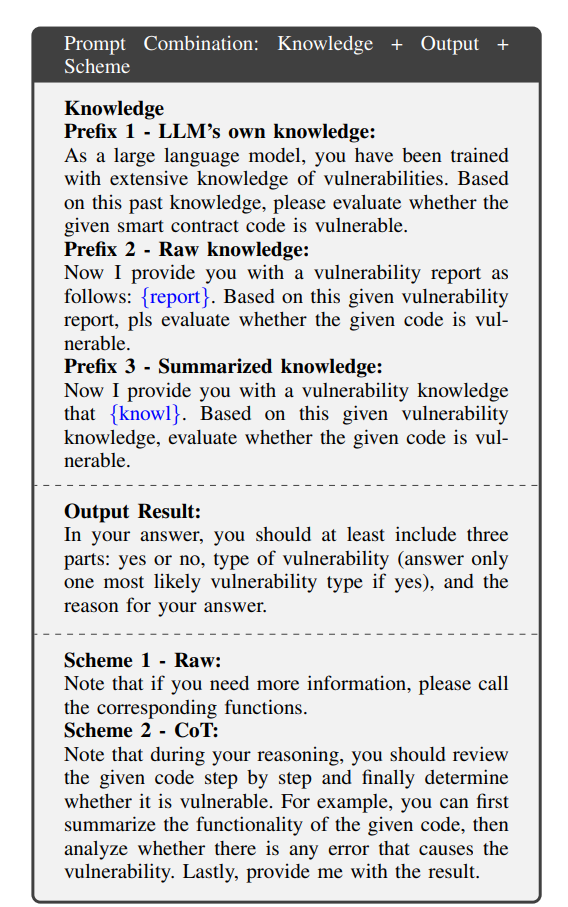
图4 两种提示方案与三种知识前缀的组合示意图,共形成六种详细提示,知识前缀包括“LLM自身知识”“原始知识”“总结后知识”,提示方案包括“原始提示”“思维链提示”,此处省略图表。
提示组合:知识前缀 + 输出方案
– 知识前缀1:LLM自身知识
“作为大型语言模型,你已通过训练掌握大量漏洞知识。请基于这些已有知识,评估给定智能合约代码是否存在漏洞。”
– 知识前缀2:原始知识*
“现向你提供如下漏洞报告:{报告内容}。请基于该漏洞报告,评估给定代码是否存在漏洞。”
– 知识前缀3:总结后知识
“现向你提供如下漏洞知识:{知识内容}。请基于该漏洞知识,评估给定代码是否存在漏洞。”
输出结果要求
“你的回答需至少包含三部分内容:是否存在漏洞(是/否)、漏洞类型(若存在漏洞,仅需回答最可能的一种类型)、判断依据。”
具体提示方案
– 方案1:原始提示
“注:若需更多信息,请调用对应函数。”
– 方案2:思维链提示
“注:推理过程中,需逐步审查给定代码,最终判断是否存在漏洞。例如,可先总结给定代码的功能,再分析是否存在导致漏洞的错误,最后给出结果。”
#4.4 基于LLM的结果标注与分析
前文介绍的组件均用于增强LLM的漏洞推理能力,但还需一个组件来实现LLM漏洞推理结果的自动评估。为此,本文在LLM4Vuln中设计了基于LLM的结果标注功能——该功能用于在各LLM生成原始输出后,获取最终的评估结果。
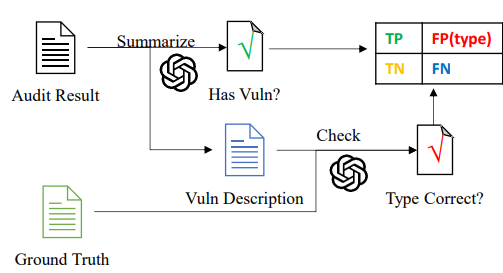
图5 GPT-4.1自动标注流程示意图,核心流程包括:接收LLM原始“是否存在漏洞”输出→检查漏洞类型是否匹配→标注审计结果(TP/TN/FP/FN/FPₜ)→与真值(Ground Truth)对比。
基于各LLM输出的原始“是/否”判断,以及GPT-4.1标注的“漏洞类型是否匹配”结果,LLM4Vuln会自动生成以下标注结果,涵盖真阳性、真阴性、假阴性、假阳性及假阳性类型:
– TP(真阳性):LLM正确识别出漏洞,且漏洞类型判断正确。
– TN(真阴性):LLM正确判断代码无漏洞。
– FN(假阴性):LLM将存在漏洞的代码错误判断为无漏洞。
– FP(假阳性):LLM将无漏洞的代码错误判断为存在漏洞。
– FPₜ(假阳性类型):LLM正确判断代码存在漏洞,但漏洞类型判断错误。
由于FPₜ既包含“报告不存在漏洞”的假阳性情况,也包含“未报告存在漏洞”的假阴性情况,本文按以下公式计算LLM漏洞检测结果的精确率(Precision)和召回率(Recall):
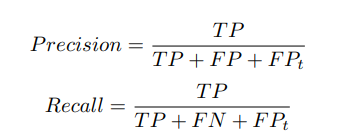
为验证LLM自动标注结果的准确性,本文从每种编程语言的样本中随机抽取100个案例进行人工核查:在“代码是否存在漏洞”的二分类标注结果中,GPT-4.1在三种编程语言上的准确率均达到100%;在“检测到的漏洞类型是否与真值一致”的标注结果中,GPT-4.1在Solidity上的准确率为81%,在Java上为98%,在C/C++上为97%。
为使LLM4Vuln能在受控条件下系统性评估LLM的漏洞推理能力,需构建一个适配的基准数据集。尽管近年来已有多个专为LLM漏洞检测评估设计的数据集(如PrimeVul [32]、MegaVul [64]),但这些数据集与本框架无法直接兼容——它们普遍缺少两个关键组件:(1)可用于上下文学习的显性漏洞知识;(2)可辅助LLM理解的代码周边上下文。为解决这些不足,本文提出UniVul基准数据集:这是首个同时具备“知识可检索性”和“上下文可补充性”的基准数据集。
5.1 目标编程语言
UniVul选取三类编程语言评估LLM的漏洞推理能力:传统编程语言(C/C++、Java)与智能合约编程语言(Solidity)。该选择可覆盖广泛的漏洞类型——从底层内存错误、类型错误到高层逻辑漏洞。其中,Java和C/C++的常见漏洞多与语言级特性相关(如不安全的内存操作、输入处理不当、不安全反序列化);而Solidity编写的智能合约[65]则更易出现业务逻辑漏洞[22]、[66]——这类漏洞在多数LLM的预训练语料中占比极低[67],原因是去中心化应用(DeFi)属于新兴领域,具有较强的领域特异性。
5.2 知识合成原则
为评估外部知识对LLM推理能力的增强效果,UniVul的设计核心是融入“源于历史漏洞的可检索知识”。知识必须来自历史漏洞,原因是本文需模拟真实检测场景——不能使用待测试代码段自身的漏洞知识来测试该代码。基于此,本文为每种编程语言构建了两个独立数据集:(1)“知识集”:用于构建可检索的漏洞知识数据库;(2)“测试集”:用于评估不同配置下LLM的性能。
每种语言均选择最能反映真实开发者资源的知识来源:对于Solidity,本文可利用各类漏洞审计报告;对于缺乏结构化审计报告的Java和C/C++,则主要依赖“常见弱点枚举(CWE)分类体系”和“常见漏洞与暴露(CVE)数据库”来合成结构化知识。
5.3 详细收集与合成过程
表2总结了Solidity、Java、C/C++三类语言的数据集构成。
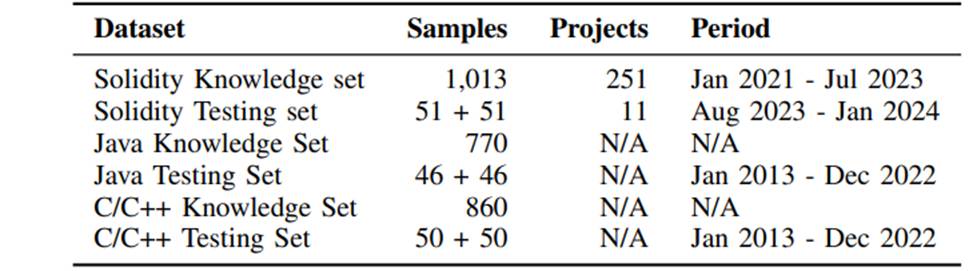
表2:UniVul基准数据集统计信息
Solidity数据集构建
从Code4rena漏洞赏金平台[68]收集高风险漏洞,具体提取了2021年1月至2023年7月期间GitHub Issues中的1013个漏洞[69]——这些漏洞及对应的报告构成“知识集”。“测试集”则包含51个有漏洞代码段和51个无漏洞代码段,均来自2023年7月后完成审计的项目;无漏洞代码段从同一项目中随机抽取,代码长度和复杂度与有漏洞代码段保持一致。
Java与C/C++数据集构建
依赖CWE和CVE数据库:从CWE中提取77个Java相关弱点类别[70]和86个C/C++相关弱点类别[71]。由于CWE仅提供高层描述,缺乏与代码对齐的知识,本文额外进行了知识合成:对每个CWE类别,通过GPT-4.1生成10个代表性代码示例,并基于这些示例生成“审计风格”的漏洞报告——最终形成Java的770条知识条目和C/C++的860条知识条目。
为使Java/C/C++数据集与Solidity数据集对齐,本文从CVE和BigVul [72]数据集中筛选出46个Java漏洞和50个C/C++漏洞,每个漏洞均搭配其补丁版本或无漏洞版本,构成两类语言的“测试集”。
5.4 知识检索实现
知识合成完成后,本文使用FAISS [73]构建向量数据库,并设置“Top-K=3”——即每个查询检索3条最相关的知识。在FAISS中,查询内容先被转化为嵌入向量,再与数据库中所有向量计算点积,点积值最高的前K个向量即为检索结果。此外,“无知识增强”的测试场景会重复执行3次,与“有知识增强”场景的执行次数保持一致。
综上,尽管三类语言的测试集仅包含147个有漏洞案例和147个无漏洞案例,但通过“7种知识检索方式(每种检索类型返回Top-3结果)+2种提示策略+2种上下文设置”的组合,最终形成3528个(294×3×2×2)评估场景,每个模型需完成8232个(294×7×2×2)测试用例。
5.5 减少数据泄露
为确保评估的完整性和公平性,本文采取多项措施减少预训练语料的数据泄露风险:所有测试数据均在语义保持不变的前提下进行系统性改写,以避免与公开数据源的词汇重叠——具体而言,通过GPT-4.1重命名所有函数名、变量名和注释,但严格保留原始程序语义;核心代码语句未做修改,以确保漏洞行为不变。
此外,三类语言的测试集中均存在“早于当前LLM知识截止日期”的案例(例如QwQ-32B的训练数据截止到2024年11月)。为降低这类案例的记忆效应,所有测试样本均经过上述改写处理。本文在附录B中保留了Solidity数据集“未脱敏版本”的评估结果以供对比,而第6节展示的所有数据均为“脱敏版本”结果。通过这种方式,UniVul在减少基于LLM的漏洞检测数据泄露方面设立了新标准,优于以往研究[29]、[30]、[31]、[32]。
6. 评估
将LLM4Vuln框架应用于UniVul基准数据集后,本文得以解耦LLM的“固有漏洞推理能力”与“外部可增强因素”,并评估前者在结合“知识增强”“上下文补充”“提示策略”等增强手段后的性能提升效果。需说明的是,本研究的核心目标是为不同LLM的“固有漏洞推理能力”提供自动化、标准化的公平评估(无论模型强弱),而非研发新的基于LLM的漏洞检测工具以追求高检测指标。基于这一原则,本节将开展一系列实验并解读结果。
6.1 评估的LLM及其配置
本文选取2025年评估时可获取的主流专有模型与开源模型进行基准测试。具体而言,从表1列出的LLM中:
– 传统基础模型:选择GPT-4.1(当前最先进的专有模型)、Phi-3-mini-128k(开源模型)、Llama-3-8B(开源模型);
– 深度推理模型:选择o4-mini(当前最先进的专有模型)、QwQ-32B(开源模型)、DeepSeek-R1(开源模型)。
这些LLM在AI领域应用广泛,其背景信息已在第2节介绍。
模型访问与参数设置
– 通过OpenAI API [49]调用GPT-4.1和o4-mini;通过Replicate API [74]调用所有开源模型。
– 除“温度(temperature)”参数外,其余配置均采用模型提供商的默认值:为确保结果可复现,所有模型的温度参数设为0(o4-mini不支持温度设置,除外)。
– 随机种子(seed)固定,由基于时间的随机生成器生成,相关代码将包含在研究成果(artifact)中以供复现。
6.2 评估指标
评估指标严格遵循第4.4节的定义,计算真阳性(TP)、真阴性(TN)、假阳性(FP)、假阴性(FN)和假阳性类型(FPₜ):
– TP和TN值越大(即正确判断的案例越多),表明性能越好;
– FP和FN值越大(即错误判断的案例越多),表明性能越差;
– FPₜ属于边界情况,指LLM检测到真实漏洞但误判其根本原因的情况。
6.3 整体结果
表3、表4、表5分别展示了LLM在Solidity、Java、C/C++三类语言中,不同“知识增强+上下文”组合下的漏洞分析结果³。其中,“Nk”表示无额外知识,“Ok”表示使用原始报告知识,“Sk”表示使用总结后知识,“C”表示补充上下文,“N”表示不补充上下文。需注意的是,这些结果均在“原始提示策略”下获得;思维链(CoT)提示的效果将在第6.3节重点评估。基于这些结果,本文将在第6.1节和第6.2节进行相关性分析,并解答对应的研究问题(RQ);最后,在第6.4节开展试点研究,验证LLM4Vuln的评估结果在漏洞赏金项目中发现零日漏洞的实用性。
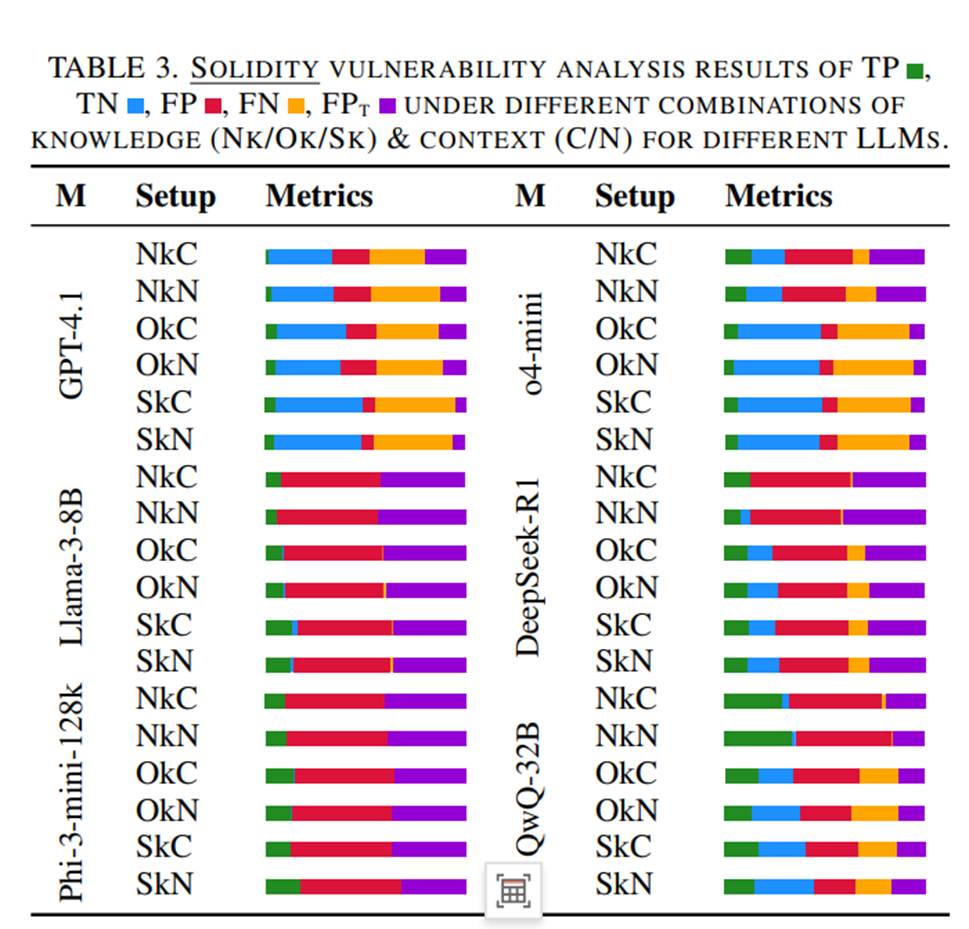
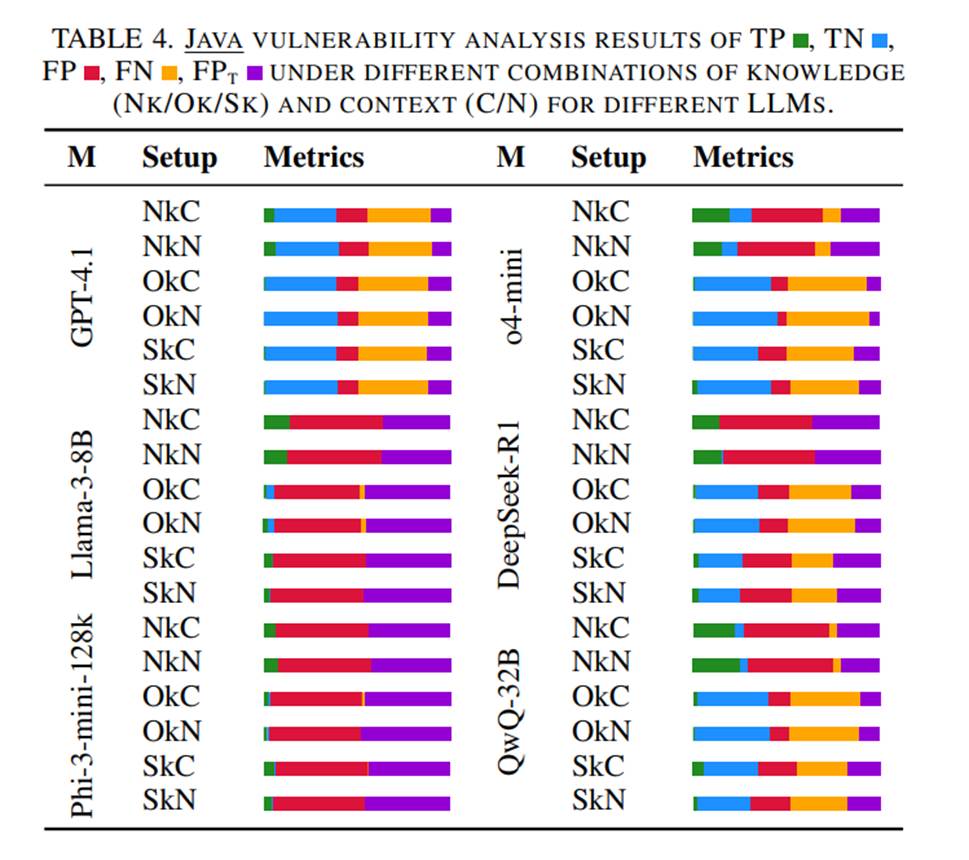
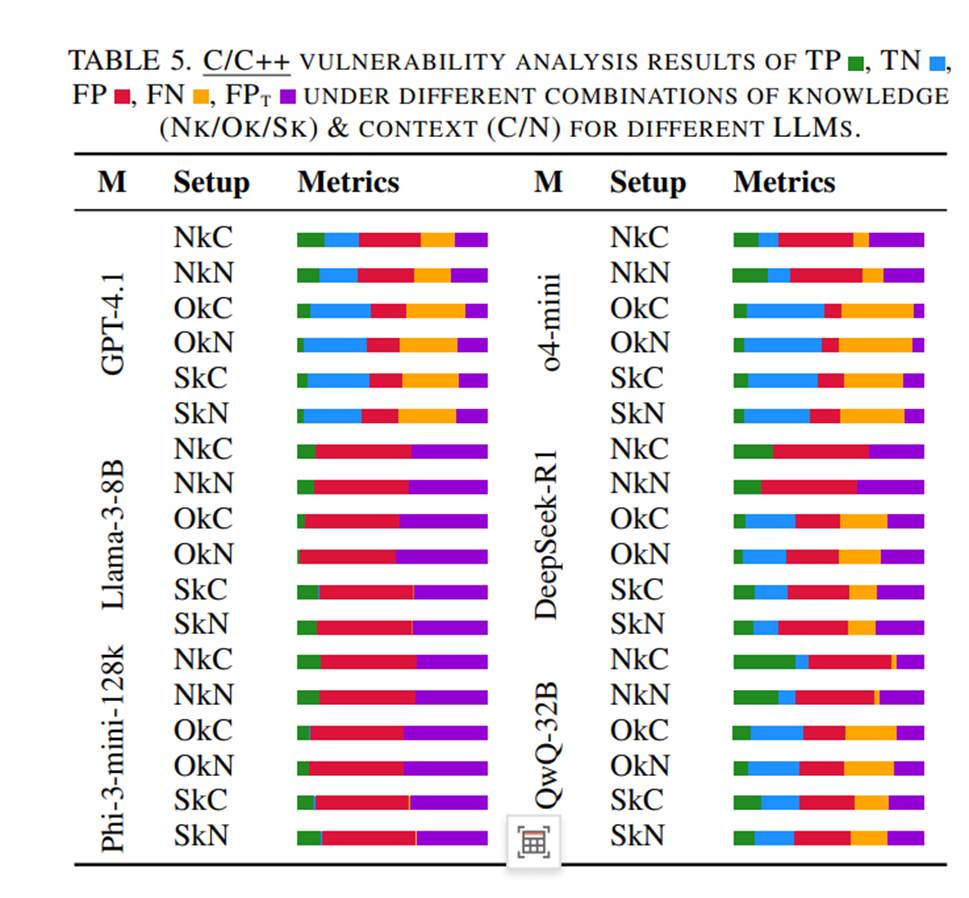
表3、表4、表5分别为不同LLM在Solidity、Java、C/C++中,不同“知识+上下文”组合下的TP、TN、FP、FN、FPₜ结果表,表格结构为“模型(M)-配置(Setup)-指标(Metrics)”。
发现1:知识增强对LLM固有漏洞推理能力的影响(含三个子发现)
(a)对于传统基础模型:处理Solidity等“基于逻辑漏洞的语言”时,总结后知识能显著提升漏洞推理能力;而处理Java、C/C++等传统语言时,更适合依赖LLM自身的内置知识。
(b)对于深度推理模型:知识增强在不同编程语言中的影响趋势一致——令人意外的是,其常导致精确率、召回率和F1分数下降。
(c)在所有语言中,补充外部知识都会增加“阴性案例”数量,表明当前LLM更倾向于推理“漏洞存在的必要条件”,而非聚焦提示中的特定漏洞描述。
发现2:上下文补充对LLM漏洞推理能力的影响
上下文补充对LLM的精确率、召回率和F1分数仅能带来轻微且不一致的提升。传统基础模型在补充上下文时,往往能达到最高F1分数;而深度推理模型则在不补充上下文时表现最佳——这表明深度推理模型的推理过程可能已充分利用代码内部语义,无需额外上下文辅助。
发现3:提示策略对LLM漏洞推理能力的影响
尽管CoT提示策略无法一致提升召回率或TP案例数量,但在多数模型和语言中,它能有效减少假阳性、增加真阴性——这使得CoT成为提升漏洞检测“预测可靠性”的有益提示策略。
7. 讨论与未来工作
7.1 经验总结
知识增强
研究表明,知识增强的作用重要但在不同语言和模型类型中表现不均:
– 对传统基础模型:处理Solidity等“逻辑导向语言”时,知识增强能显著提升漏洞推理能力;但对C/C++和Java,反而可能导致性能下降。这表明需要更精准的知识检索机制——匹配偏差的知识会误导模型推理。未来研究应探索更复杂的“语义保留检索方法”(如基于图的表示、符号特征提取),以提升知识相关性并减少噪声。
– 对深度推理模型:补充外部知识时,性能在所有语言中均一致下降——这表明这类模型的内置知识可能已足够支持漏洞检测,无需额外知识辅助。
上下文补充
补充代码周边上下文能轻微提升性能,但会导致任务和模型间的性能波动。不相关或过量的上下文可能分散模型注意力,甚至引发假阳性。因此,上下文补充需谨慎应用,最好结合“过滤策略”或“模型特定上下文窗口”,在“信息量”和“简洁性”之间取得平衡。
提示策略选择
思维链(CoT)提示能带来中度收益,尤其在减少假阳性、提升真阴性方面,但效果并不均衡。设计有效的CoT提示需满足“将任务分解为可解释的推理步骤,同时避免给模型造成负担”;此外,CoT还可与知识补充等其他增强手段协同——合理组合可能进一步提升性能。未来研究应探索“自动提示调优”或“检索增强型CoT流程”,以充分发挥该策略的价值。
模型选择
本研究未采用“开源模型vs专有模型”的传统分类,而是将模型分为“传统基础模型”和“深度推理模型”:
– 深度推理模型:内置能力强,但在引入噪声外部知识时性能可能受损;
– 传统基础模型:从精心筛选的知识中获益更多。
因此,LLM的选择应同时考虑“待审计语言”和“模型对外部增强的敏感性”,优先关注“基线漏洞推理能力”,而非模型流行度。
7.2 更精准的知识检索
为确保公平性,UniVul基准数据集在所有案例中使用固定知识供给。本文通过人工验证检索结果,发现其在实际应用中仍有改进空间:
– Solidity:100个抽样阳性案例中,68个案例的检索知识与真值对齐——这表明检索质量尚可,也部分解释了为何精确率和召回率能提升;但“需底层推理的漏洞”(如整数溢出)在数据集中代表性不足。
– Java:100个抽样案例中仅36个检索到相关知识,且知识多局限于XSS(跨站脚本)和SQL注入——SSRF(服务器端请求伪造)、CSRF(跨站请求伪造)等漏洞因“功能对应性弱”,极少被匹配。这反映出“静态描述难以捕捉过程性或上下文相关漏洞类型”的问题。
尽管精确匹配存在难度,但研究问题4(RQ4)已证实“部分相似性仍能对模型预测产生积极影响”。因此,未来研究应探索“基于行为或功能级相似性”的检索策略,而非仅依赖表面模式匹配。
7.3 覆盖更多编程语言
当前UniVul基准数据集聚焦三种代表性语言:Solidity(逻辑密集型智能合约语言)、Java和C/C++(通用过程式语言)。但LLM4Vuln框架在设计上具有“语言无关性”,理论上可扩展至其他语言(如Python、Rust、JavaScript)。
要实现这一扩展,研究者需为目标语言构建“定制化漏洞知识库”,并实现配套工具(如抽象语法树(AST)解析、调用图构建、符号执行)。由于不同语言的语义存在差异,“工具调用模块”需相应适配。LLM4Vuln的模块化设计支持此类扩展,为未来研究覆盖更广泛的语言生态系统奠定基础。
相关工作
基于LLM的漏洞检测
漏洞检测长期以来都是软件安全领域的核心挑战。传统方法通常依赖静态规则或基于模糊测试的检测技术,这类方法在检测新型或复杂漏洞时往往存在局限。近年来,面向代码的大型语言模型[26]、[81]取得显著进展,推动了“利用LLM进行漏洞检测”的相关研究。
已有多项研究提出了基于LLM的漏洞检测器:Thapa等人[26]在标准漏洞数据集上评估了LLM的有效性;Alqarni等人[82]通过微调LLM实现漏洞分类;Tang等人[83]结合图表示与LLM实现函数级漏洞检测;Hu等人[23]利用LLM角色扮演技术分析智能合约。
另有研究者将LLM与模糊测试相结合以增强检测能力:Deng等人[18]提出TitanFuzz,用于对深度学习库进行模糊测试;FuzzGPT[19]利用LLM生成边缘案例程序以模糊测试深度学习库;Meng等人[21]开发ChatAFL,用于网络协议的模糊测试;Fuzz4All[20]则将该思路扩展到更广泛的领域。
此外,还有研究将LLM与静态分析结合:Sun等人[22]将GPT与符号执行结合,用于智能合约漏洞检测;Li等人[24]将LLM集成到传统分析流程中,增强静态分析的漏洞检测能力。然而,这些研究的核心聚焦于“漏洞检测本身”,而非“评估LLM在安全相关判断中的推理能力”。与之不同,LLM4Vuln提供了一个系统化框架,用于基准测试和分析LLM基于漏洞评估的推理过程。
LLM漏洞检测能力的基准测试
另一类相关研究聚焦于“在基准数据集上评估LLM的漏洞检测能力”,探索不同模型、配置和指令对检测结果的影响。例如,Chen等人[28]在Solidity漏洞检测任务中测试了LLM的性能;David等人[27]在真实去中心化金融(DeFi)智能合约上评估了LLM的表现;Khare等人[30]在Java和C/C++漏洞检测任务中对LLM进行了基准测试;Gao等人[29]、Ullah等人[31]、Ding等人[32]则构建了跨编程语言的数据集,用于评估不同检测方法的效果;Lin等人[33]则研究了量化、上下文长度等配置对LLM漏洞检测能力的影响。此外,还有研究关注LLM在漏洞修复相关任务中的表现[34]、[35]。
与上述研究不同,本文并非仅关注“原始性能指标”,而是将LLM的推理能力与“知识、上下文、提示设计”等外部增强手段解耦。UniVul作为首个具备“知识可检索性”和“上下文可补充性”的基准数据集,也为这类模块化评估提供了支撑。
面向安全领域的LLM
目前已有越来越多研究聚焦于“开发安全专用LLM”:Lacomis等人[39]和Pal等人[40]构建了用于“恢复二进制代码中变量名”的模型;Pei等人[47]提出了适用于安全任务的“代码语义Transformer模型”;Chen等人[38]改进了反编译技术,以支持下游安全分析;Ding等人[42]引入了“执行感知预训练”方法;Gai等人[45]和Guthula等人[46]则分别聚焦于区块链和网络流量领域的安全任务;Jiang等人[44]和Li等人[41]开发了用于二进制分析的LLM;Wang等人[48]提出SmartInv,用于智能合约的不变式推理。
本文的研究与上述工作形成互补:本文无需对LLM进行“任务特定的再训练或模型定制”,而是评估主流LLM在漏洞分析中的推理能力,为安全领域的LLM选择和应用提供参考。
做个总结
本文提出了LLM4Vuln——一个用于解耦和增强LLM固有漏洞推理能力的统一模块化评估框架。为实现公平、可扩展且可复现的评估,本文构建了UniVul基准数据集:这是首个涵盖三种代表性编程语言(Solidity、Java、C/C++)、提供可检索知识和可补充上下文代码的基准数据集。
将LLM4Vuln应用于“294个有漏洞/无漏洞案例”和“3528个场景”后,本文开展了全面研究,分析了“知识增强”“上下文补充”“提示策略”三种增强手段对LLM性能的影响。研究结果揭示了不同类型LLM(传统基础模型与深度推理模型)在漏洞推理中的核心差异,为“如何通过外部增强手段提升LLM漏洞检测能力”提供了实证依据。此外,在真实漏洞赏金项目中的应用也验证了LLM4Vuln的实际价值——成功发现14个零日漏洞,获得3576美元赏金。
LLM4Vuln框架和UniVul基准数据集不仅为LLM的漏洞推理能力评估提供了标准化工具,也为未来“提升LLM辅助安全分析的可靠性”奠定了基础。