AI 辅助数据提取工程化:让自然语言变成可复用的 SQL 模板
一、当"帮我跑个数"变成团队的日常阻塞
数据团队最常见的场景是:业务方丢过来一句话——"帮我看下上个月各渠道的新用户留存"。分析师打开 IDE,回忆表名、确认字段口径、写好 SQL、跑数、截图,一来一回半小时。一天被这类"翻译型取数"打断五六次,真正需要深度分析的工作只能加班做。
更麻烦的是,同样的需求过两周又会来,口径可能还略有不同。手工维护的 SQL 模板库越来越臃肿、越来越难检索,"这需求之前好像写过"成了团队最无力的口头禅。
AI 辅助数据提取的工程化方向,不是为了炫技,而是要解决一个很朴素的问题:把口语化的取数需求,稳定地转换成可执行、可复用、可审计的 SQL 模板。这条路走通了,分析师的精力可以从"翻译需求"转向"发现洞察"。
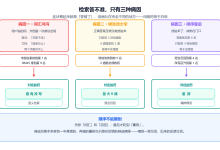
flowchart LR
A[业务方自然语言需求] –> B{需求分类与意图识别}
B –>|高频模板匹配| C[SQL模板检索]
B –>|新需求| D[LLM SQL生成]
C –> E[参数绑定与口径校验]
D –> E
E –> F{执行结果校验}
F –>|通过| G[返回数据与口径说明]
F –>|不通过| H[口径修正反馈]
H –> D
G –> I[模板沉淀到可复用库]
二、自然语言到 SQL 模板的三层映射:别让模型直接操作生产库
工程上最激进也最危险的做法是:把自然语言直接喂给 LLM,生成的 SQL 直接在生产库上执行。这等于让一个没有权限边界的"实习生"直接操作核心数据。
正解是建立三层映射:
第一层:领域词表映射。把"新用户"映射到 user_type = 'new'、把"上个月"映射到 DATE_TRUNC('month', CURRENT_DATE – INTERVAL '1 month')。这一层不靠模型凭空想象,而是靠团队维护的受控词表。每个业务术语都有且只有一个确定的口径表达式。
第二层:模板骨架匹配。不是让模型每次自由发挥写完整 SQL,而是先检索模板库中结构最接近的 SQL 骨架(如"按渠道分组计算新用户留存"的标准模板),模型只负责填充参数和做小幅适配。这样生成的 SQL 稳定性远高于全自由生成。
第三层:口径校验与反馈闭环。生成的 SQL 在执行前必须通过规则校验——聚合粒度对不对、JOIN 条件是否完整、WHERE 过滤是否覆盖了必要的分区字段。执行后还要对比历史数据波动范围,异常波动触发人工确认。
三、模板库的工程化设计:不只是存一段 SQL 文本
一个合格的 SQL 模板至少需要包含以下结构化信息:
模板ID: cohort_retention_by_channel_001
模板名称: 按渠道分组的新用户次月留存
适用场景: 渠道投放效果分析
SQL骨架:
SELECT channel,
COUNT(DISTINCT user_id) AS new_users,
COUNT(DISTINCT CASE WHEN retention_flag = 1 THEN user_id END) AS retained_users,
ROUND(retained_users * 100.0 / new_users, 2) AS retention_rate
FROM dws_user_behavior_di
WHERE dt BETWEEN {start_date} AND {end_date}
AND user_type = 'new'
GROUP BY channel
参数说明:
– start_date: 观察期起始日期, 格式YYYY-MM-DD
– end_date: 观察期结束日期, 格式YYYY-MM-DD
口径定义:
– 新用户: user_type = 'new' AND first_order_date BETWEEN {start_date} AND {end_date}
– 留存: 注册后30天内至少有一次活跃行为
依赖表: dws_user_behavior_di
更新频率: 每日T+1
负责人: 数据团队
当 LLM 接收到"看下七月各渠道新用户次月留存"时,系统先做语义匹配锁定模板 cohort_retention_by_channel_001,然后提取参数 start_date = '2026-07-01'、end_date = '2026-07-31',填入骨架生成最终 SQL。模型的角色从"从零写 SQL"降级为"分类 + 参数提取",可靠性大幅提升。
这种做法还有一个额外好处:模板的变更可追踪。当指标口径调整时(比如留存定义从 30 天改成 7 天),只需更新模板的口径定义字段,所有基于该模板的历史查询记录都能回溯到变更时刻。
四、边界分析:什么时候不该让 AI 帮你写 SQL
这套方案不是银弹。
首先,模板覆盖范围决定上限。模板库的建设需要持续投入,初期覆盖率可能只有 60-70%。对于模板库未覆盖的复杂需求,回退到人工编写仍然是更安全的选择。不能为了追求 AI 化率而强行匹配不合适的模板。
其次,口径的歧义性是天然的天花板。同一个"新用户"在不同业务场景下可能有不同定义——是"首次注册"还是"首次下单"?是"当天"还是"当周"?模型无法替代业务人员做这个决策。模板的参数化虽然提高了灵活性,但参数本身的选择是否合理,仍然需要人的判断。
最后,性能问题不能忽视。模板生成的 SQL 在参数填充后可能产生糟糕的执行计划,比如日期范围过大导致全表扫描,或者参数化后的 JOIN 条件变得低效。系统需要在执行前引入执行计划预估,对预估耗时超过阈值的查询进行拦截和重写提示。
适合用 AI 辅助的场景:高频、口径稳定、参数化程度高的取数需求(如日报、周报的固定指标);业务方自查的数据探索(配合只读副本和数据脱敏)。
不适合的场景:一次性深度分析(SQL 结构本身就是分析过程的一部分);涉及多步骤数据处理的复杂 ETL;需要跨系统数据融合的查询(模型不理解外部数据源的语义)。
五、总结
AI 辅助数据提取的工程化落地点可以总结为三步:
这条路不是要替代数据分析师,而是把分析师从"人工翻译机"的角色中解放出来。模板库的建设本身也是团队知识沉淀的过程——当你能把团队 80% 的临时取数需求都映射到结构化模板时,团队的数据交付效率会发生质变。