承接上一篇,把「检索」这个黑箱彻底拆开——六种策略实测对比,把「搜得到」变成「答得对」
目录
一、先回答上一篇留下的那个问题
二、检索答不准,只有三种病因
三、病因一:词汇鸿沟——用户说的词,文档里没有
四、病因二:候选池太窄——答案压根没被捞进来
五、病因三:排序靠后——捞进来了,却排在门口
六、BM25:被低估二十年的老将
七、混合检索与 RRF:把两个不可比的分数合起来
八、完整实验:六种策略,八个提问
九、真实案例:工业界是怎么做的
十、天花板:有些问题一次检索结构上就解决不了
十一、参数速查表
十二、按顺序动手:一份可执行的优化清单
数据时效声明
参考资料
上一篇《80 行 Python 手搓 RAG》里,我们把整条链路从零搭了一遍:切块、向量、检索、拼提示词,八十行代码跑通了一个最小可用的 RAG。
那篇结尾留了一个悬念没展开:RAG 的答案质量,上限由检索决定。 检索没把对的资料捞出来,后面的大模型再聪明也只能靠猜——而且它会猜得理直气壮。
这篇就来拆这个黑箱。我们会一起看清三件事:
整个实验是纯 Python 标准库写的,不联网、不需要 API Key,跑一遍不到一秒。文中每一个数字,你都能自己跑出来。
一、先回答上一篇留下的那个问题
上一篇里有个例子让人印象深刻:用户问「住酒店一晚上最多能报多少钱」,纯字面匹配把正确答案——差旅住宿标准——判成了 0 分,反而把「年假规则」排到了第一名。原因很朴素:两句话里都有「最多」两个字。
当时我们说,加一层语义归一化就能解决。但很多人试了之后会发现:问题没有消失,只是换了一副面孔。
换成了什么面孔?看这三个真实口吻的提问:
|
用户是这么问的 |
知识库里是这么写的 |
关键词能对上吗 |
|
我能不能偶尔不去公司, 在家干活 ? |
员工每周可申请不超过 2 天的 居家办公 |
一个字都对不上 |
|
电脑 开不了机,我该找谁? |
设备 无法正常使用时,先在 IT 服务台提交工单 |
对不上 |
|
给客户的报价单能不能直接 微信 发过去? |
不得通过个人邮箱或 社交软件 传递 |
对不上 |
三句话,三个「对不上」。而知识库里的表述本身没有任何问题——是提问的人和写文档的人,用的不是同一套词。
|
一句话记住:检索系统面对的从来不是「问题难不难」,而是「问的人和写的人,词对不对得上」。这是所有检索优化的起点。 |
所以接下来我们不谈玄的,直接做实验:搭一个 48 条的企业制度知识库,用 8 个真实口吻的提问去测,看每种策略到底能排到第几名。
二、检索答不准,只有三种病因
在动手之前,先把「答不准」这件事拆开。听起来都是「答错了」,但病灶在三处完全不同的地方——用错药等于白做。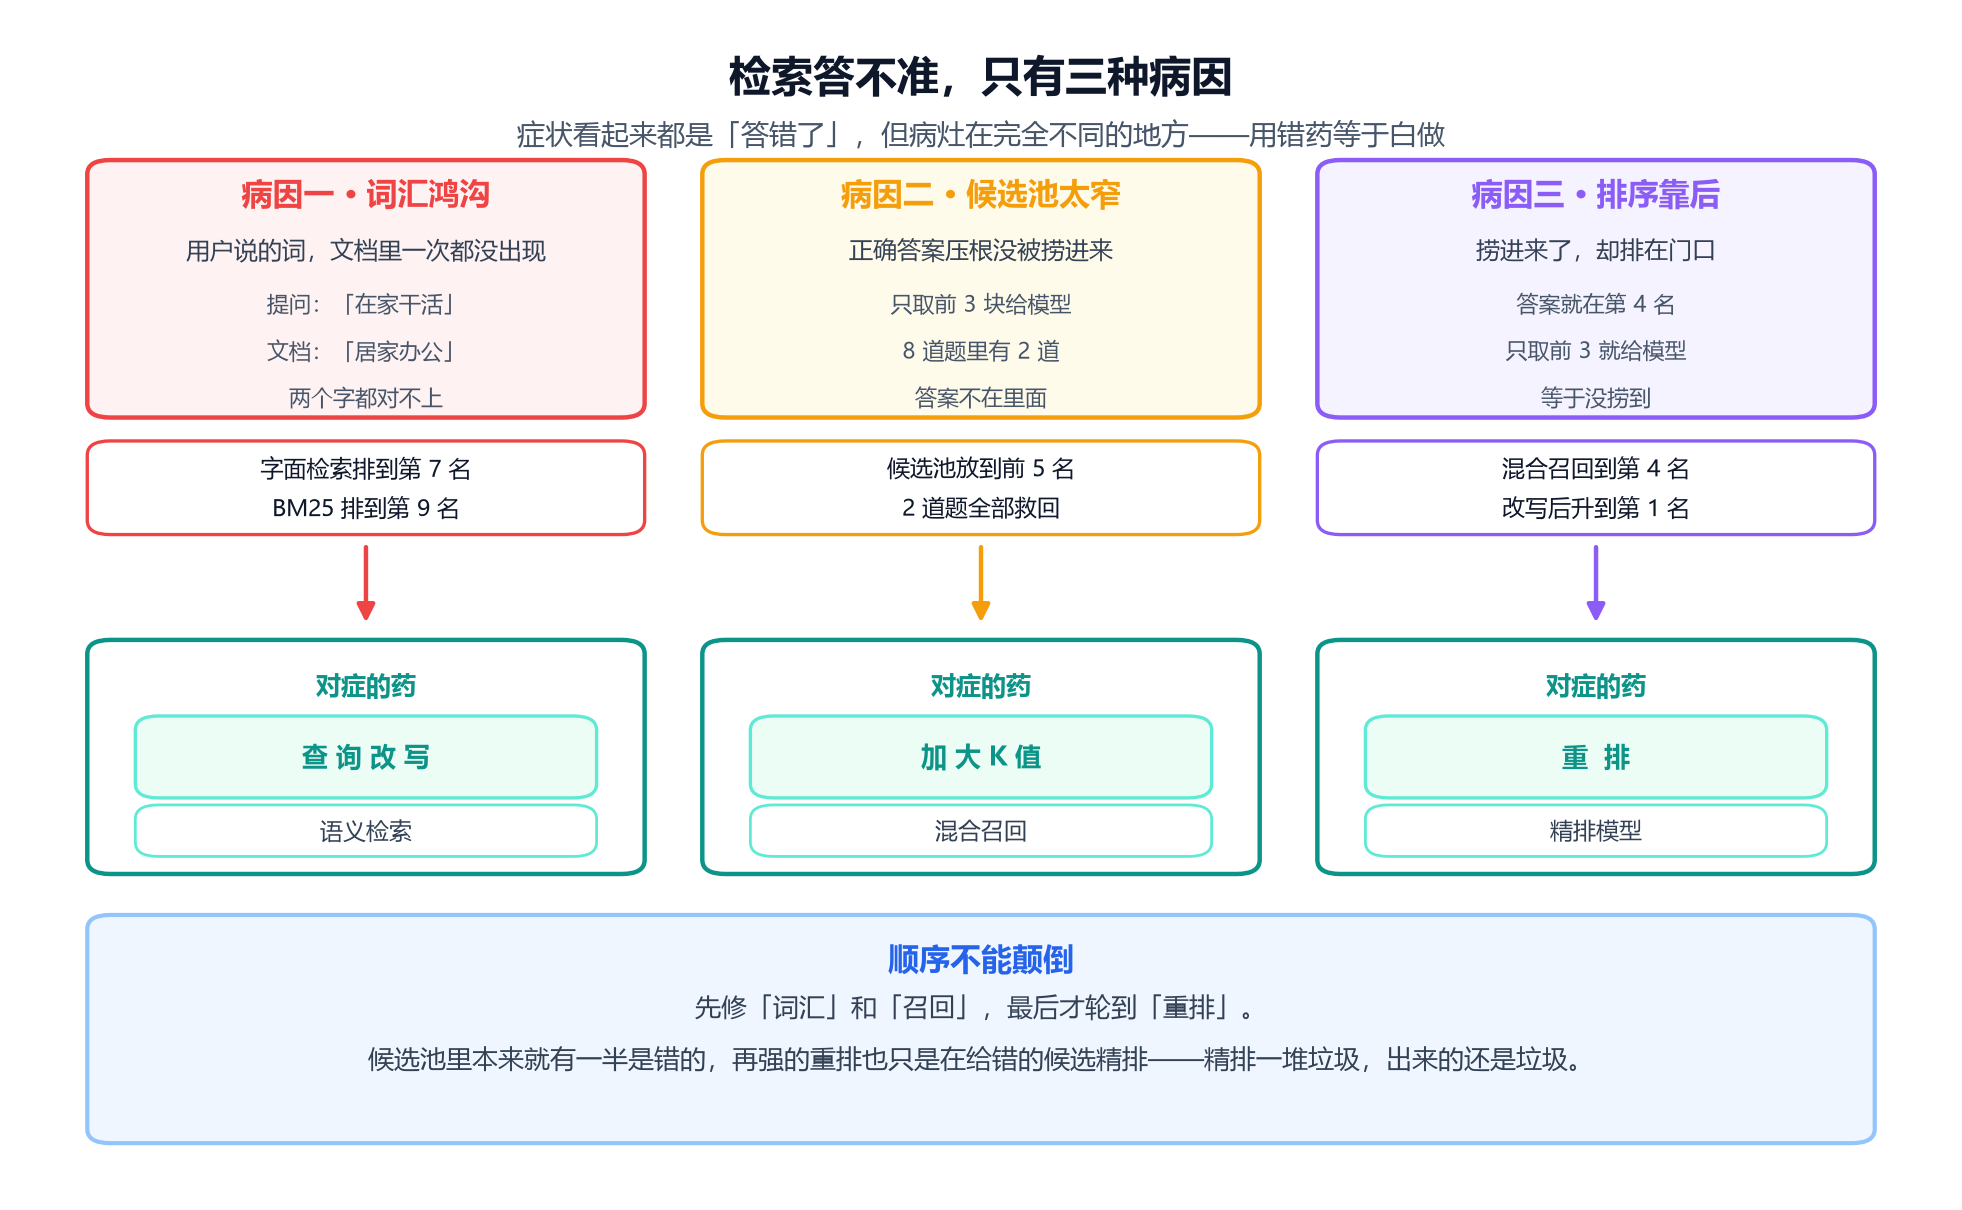 检索失败的三种病因
- 病因一 · 词汇鸿沟:用户说的词,文档里一次都没出现。症状是字面检索排到很后面。
- 病因二 · 候选池太窄:正确答案压根没被捞进候选池。症状是「前 3 名里根本没有它」。
- 病因三 · 排序靠后:捞进来了,但排在门口。症状是「它在第 4 名,而你只取了前 3 个」。
这三种病因对应三种完全不同的修法,而且有严格的先后顺序:
|
踩坑预警:候选池里本来就有一半是错的,再强的重排也只是在给错的候选精排——精排一堆垃圾,出来的还是垃圾。先修召回,最后修排序。 |
下面我们按顺序,一种一种治。
三、病因一:词汇鸿沟——用户说的词,文档里没有
这是最常见、也最容易被误诊的一种。很多人以为「检索不准」是算法不行,其实只是词没对上。
先看一个具体的失败现场。
亲眼看看它是怎么错的
我们的知识库里有这么一条(编号 D11):
|
文档内容 |
|
远程办公政策:员工每周可申请不超过2天的居家办公,需提前一天在系统报备,并保证在线响应。核心会议日不适用。 |
用户的问题是:
|
运行结果 |
|
我能不能偶尔不去公司,在家干活? |
用最朴素的关键词共现去检索,第一名是谁?不是 D11。D11 掉到了第 7 名。排在它前面的是「员工家属医疗保险」「法定节假日安排」「网络安全规范」——只因为这些文档里恰好出现了「家」「公」「司」这几个字。
换成工业级的 BM25,情况更糟:D11 掉到第 9 名。
这就是词汇鸿沟的杀伤力。而它之所以难治,是因为你以为你在修算法,其实你要修的是「词」。
三个解法,从便宜到贵
|
解法 |
怎么做的 |
成本 |
适合什么场景 |
|
同义词扩展 |
维护一张「口语词 → 书面词」对照表,检索前把查询改写一遍 |
极低,纯规则 |
领域固定、术语可控,比如内部制度问答 |
|
查询改写( LLM ) |
让大模型把用户的口语问题重写成书面术语 |
每次多一次模型调用 |
通用场景,效果最好,也最贵 |
|
语义检索 |
不碰词,直接用向量比「意思像不像」 |
需要 embedding 模型和向量库 |
面向大众用户、提问方式完全不可预测 |
第三条路(语义检索)上一篇已经详细讲过了,这里重点看第一条和第二条——查询改写。它常常是性价比最高的那一刀。
代码:把口语改写成术语
查询改写的核心就是一张映射表。真实项目里这张表可以手工维护,也可以让大模型生成,原理完全一样:
|
Python |
|
# 通用词典式替换:只做「口语词 → 书面词」的等价映射, # 不知道答案长什么样,也不向查询里塞答案术语。 REWRITE = { "在家干活": "远程办公", "不去公司": "远程办公", "在家": "远程办公", "开不了机": "设备故障", "电脑": "设备", "坏了": "故障", "住酒店": "住宿", "一晚上": "每晚", "多少钱": "费用标准", "长假": "年假", "休个长假": "年假", "休假": "假期", "来回路上的钱": "交通费", "路上": "交通", "出差的钱": "差旅费用", "微信": "社交软件", "发过去": "传递", "新人": "新员工", "手续": "办理事项", } def expand_query(query): """把口语问法改写成知识库里更可能使用的书面词。""" hits = [v for k, v in REWRITE.items() if k in query] return query + " " + " ".join(hits) if hits else query |
就这么简单。加上这一步之后,「在家干活」那道题从第 7 名一步升到第 1 名。
这里有个细节值得说清楚:改写用的是「追加」而不是「替换」(query + " " + hits)。为什么?因为改写表不可能百分百准确——万一某个词改错了,原始查询还在,不至于把用户的原意彻底丢掉。这是工程上留的安全余量。
顺便认识一下 HyDE
除了词典式改写,还有一个更聪明的思路叫 HyDE(Hypothetical Document Embeddings,Gao 等人,arXiv:2212.10496,2022 年 12 月)。
它的做法有点反直觉:不拿用户的问题去找文档,而是先让大模型编一个「假设的答案」,再拿这个假设答案去找文档。
为什么这样更好?论文里有一句话点破了关键:一段真正的答案文档,和「另一个答案」的相似度,比它和「一个问题」的相似度更高。 问题的句式是疑问,答案的句式是陈述,两者在向量空间里本来就有距离。先编一个答案,就等于把问题翻译成了答案的「语言」,再去比对就准得多。
论文的原话是,生成的假设文档「抓住了相关性的模式,但它是不真实的,可能包含错误的细节」——不过没关系,编码器的稠密瓶颈会把错误细节过滤掉,只留下「这个话题长什么样」的形状。
这里有个细节值得单独说:HyDE 解决的是一个隐藏问题——问题和答案的「文体差异」。这一点在中文场景里尤其明显——「报销多少钱」和「住宿费按城市分级」不仅词不同,句式也完全不同。
四、病因二:候选池太窄——答案压根没被捞进来
治好了词汇鸿沟,下一个坑在等着:捞是捞到了,但没捞够。
K 设多少才合适
几乎每个 RAG 系统都有个参数叫「K」或者「top_k」——每次检索取前几块。很多人的默认值是 3,理由是「给模型塞太多它会分心」。
这个理由没错,但不能用在召回阶段。我们用实验数据说话。同一个混合召回策略,只改候选池深度:
|
候选池深度 |
正确答案召回率 |
还漏着哪些题 |
|
top 1 |
6/8 |
Q1 、 Q6 |
|
top 2 |
6/8 |
Q1 、 Q6 |
|
top 3 |
6/8 |
Q1、Q6 |
|
top 5 |
8/8 |
— |
|
top 10 |
8/8 |
— |
|
top 48 (全库) |
8/8 |
— |
看这张表:候选池从 3 放到 5,8 道题里多救回 2 道——25% 的问题从「答不上」变成「答得上」。这个提升幅度,比换任何模型都大。
同时注意最后一行:把池子一路放到 48 也不会更好了。 因为正确答案早就在里面了,剩下的问题不是「有没有捞到」,而是「排在第几名」。
所以结论是:池子要宽(保召回率),进模型的要窄(保精度)。 这两件事必须分开做——这就是下一节「重排」存在的全部意义。
那为什么不能直接把宽候选池塞给模型?两个原因:
所以「召回想办法多给,注入想办法少给」这个矛盾,需要第三个人来调解。
五、病因三:排序靠后——捞进来了,却排在门口
现在到了重排(rerank)的主场。这是过去两年 RAG 优化里性价比最高的改动,也是最容易被误解的一环。
两种编码器:一个快而粗,一个慢而准
要理解重排,先要理解两种模型的根本差别。
|
|
双编码器( bi-encoder ) |
交叉编码器( cross-encoder ) |
|
怎么算分 |
查询和文档 分别 编码成向量,再算余弦 |
把「查询 + 文档」 拼在一起 送进模型,直接输出一个分数 |
|
速度 |
极快。文档向量离线算好,查询时只算一次 |
慢。每对「查询 – 文档」都要跑一次完整前向 |
|
能不能预计算 |
能(这是它能撑起百万级检索的原因) |
不能 |
|
精度 |
一般。两个文本从头到尾没「见过面」 |
高。每个查询词都能和每个文档词互相注意 |
|
典型耗时 |
毫秒级 |
单对 5~50 毫秒, 100 条候选约 50~200 毫秒 |
关键差别在「有没有见过面」。
双编码器必须把一篇文档压成一个向量,而这个向量要能应付未来所有可能的提问。这种「一对一压缩」必然会丢掉细节——尤其是否定、条件、修饰语这些最要命的部分。「退款 14 天内到账」和「退款 14 天后才到账」,在向量空间里可能挨得非常近。
交叉编码器不存在这个问题,因为它一次只看一对:查询里的每个词都能去「看」文档里的每个词。所以它能分辨「要不要」「能不能」「除了」。
代价是它慢到不可能做第一遍检索。 一百万条文档,就算每对只花 5 毫秒,也要跑 83 分钟。所以工业界的做法是级联:
|
运行结果 |
|
查询 ↓ 【第一段】宽召回:BM25 + 向量混合,从全库捞出 top 50~100 ↓ 【第二段】窄精排:交叉编码器逐对细看,选出 top 3~5 ↓ 大模型 |
第一段负责「别漏」,第二段负责「排准」。贵的模型只处理一百对,成本就控制住了。
行业数据怎么说
这不是厂商的营销话术,学界和工业界的数据是一致的。
BEIR 基准(Thakur 等人,arXiv:2104.08663,NeurIPS 2021)测了 17 个数据集、10 个检索系统,结论是:BM25 是一个稳健的基线,而重排类和后期交互类模型在零样本评测中平均表现最好——代价是算力开销高。反过来,稠密和稀疏检索虽然更省算力,但泛化能力常常落后。
在 BEIR 的平均 NDCG@10 上,各方案的差距是这样堆起来的:
|
方案 |
BEIR 平均 NDCG@10 |
|
只用 BM25 |
41.7 |
|
双编码器( BGE-base ) |
51.0 |
|
双编码器 + 交叉编码器重排 |
56.5 |
加一层重排带来约 5~7 个 NDCG 点的提升,是整个 RAG 链路里单步收益最大的一改。(这张表的数字来自第三方整理的评测汇总,量级可参考,具体数值请以各模型官方评测为准。)
厂商自己的数据也能对上:Cohere 公布 Rerank 3.5 在金融服务类数据集上,相比混合检索提升 23.4%,相比纯 BM25 提升 30.8%;Voyage AI 公布 rerank-2 在 OpenAI text-embedding-3-large 的基础上,93 个检索数据集平均提升 13.89%。这些是厂商自评数据,口径由厂商定义,看的时候要带着这个前提。
代码:一个可跑的模拟重排
真实的重排需要加载一个交叉编码器模型。为了让你不装任何依赖就能看到它怎么工作,这里用一个手写的打分函数来模拟它的行为——它同样让「查询和文档互相看见」:
|
Python |
|
def rerank(query, candidates, top_k=5): """模拟交叉编码器:让查询和文档「互相看见」。 四项特征加权: sem 语义接近度(这是交叉编码器的主项) cover 查询实词覆盖率 tight 命中词在文档里的集中程度(挨得近,说明在说同一件事) prior 第一阶段名次的先验(真实系统会把一阶段分数当特征喂给重排) """ qv = embed(query) q_terms = [t for t in set(content_tokens(query)) if len(t) >= 2] n = max(1, len(candidates)) out = [] for i, did in enumerate(candidates): prior = 1.0 – i / n body = DOC_BODY[did] sem = cosine(qv, embed(body)) pos = [body.find(t) for t in q_terms if t in body] cover = len(pos) / len(q_terms) if q_terms else 0.0 tight = 1.0 / (1.0 + (max(pos) – min(pos)) / 50.0) if len(pos) > 1 else 0.3 out.append((0.45 * sem + 0.20 * cover + 0.10 * tight + 0.25 * prior, did)) out.sort(key=lambda x: (-x[0], x[1])) return [d for _, d in out][:top_k] |
那个 tight(命中词的集中程度)值得多看一眼。它算的是查询里的词在文档中出现的位置跨度——跨度越小,说明这些词挤在一起,多半是在讲同一件事。这是交叉编码器能做、而 BM25 做不到的事情:BM25 是逐词独立求和的,它对「词和词之间的关系」一无所知。
|
踩坑预警:重排不是免费的。它给每次查询增加 100~200 毫秒延迟,也增加一次模型调用或一次 GPU 前向。而且有一类场景重排会帮倒忙——精确查找。如果用户问的是一个订单号、错误码,BM25 已经把正确答案放在第 1 名了,一个在自然语言相关性上训练过的重排模型,反而可能把那个精确命中降下去,换上一段「读起来更像答案」的文字。 |
六、BM25:被低估二十年的老将
讲了半天向量和重排,该给这位老将正名了。语义检索不是万能的,它的盲区恰好是 BM25 的主场。
公式拆开看,每一项都有生活含义
Okapi BM25 的公式来自 Robertson 和 Zaragoza 的《The Probabilistic Relevance Framework: BM25 and Beyond》(2009):
|
运行结果 |
|
f(qᵢ, D) · (k1 + 1) BM25(D, Q) = Σ IDF(qᵢ) · ────────────────────────────────────── f(qᵢ, D) + k1 · (1 − b + b · |D| / avgdl) |
看着吓人,拆开其实只有三件事:
|
符号 |
含义 |
生活化的解释 |
|
f(qᵢ, D) |
词在文档里出现了几次 |
出现得多,说明相关 —— 但 不是越多越相关 |
|
IDF(qᵢ) |
这个词在全库有多罕见 |
「年假」比「公司」值钱得多,因为「公司」满篇都是 |
|
k1 · (1 − b + b · 文档长度/平均长度) |
文档长度归一 |
长文档不能因为字多就占便宜 |
它比 TF-IDF 高明的地方在「饱和」:一个词出现 2 次,得分不是出现 1 次的 2 倍。因为一旦确认了这篇文档在讲这个话题,再重复几次就不提供新信息了。
用具体数字感受一下(k1=1.2,长度因子为 1):
- 词频 1 次 → 贡献 0.4590
- 词频 2 次 → 贡献 0.6357
翻倍只换来 1.386 倍,不是 2 倍。 这就是 BM25 的招牌特性,也是「堆关键词刷排名」在 BM25 下失效的原因。
k1 和 b 在调什么
两个参数各有明确的物理意义,而且默认值是三十年评测淘出来的,别乱动:
|
参数 |
默认值 |
作用 |
调大意味着 |
|
k1 |
1.2 |
词频饱和速度 |
更晚饱和,更看重重复次数 |
|
b |
0.75 |
长度归一强度 |
更严厉地惩罚长文档 |
Lucene 从 6.0 起就把默认打分算法从 TF-IDF 换成了 BM25——这意味着 Elasticsearch、OpenSearch 默认都在用 BM25,你只是没注意。
代码:手写一个 BM25
|
Python |
|
class BM25: """Okapi BM25(Robertson & Zaragoza, 2009)。 k1 控制词频饱和(同一个词出现越多,边际收益越低); b 控制长度归一(长文档不会仅凭字多而占优)。""" def __init__(self, docs, k1=1.2, b=0.75): self.k1, self.b = k1, b self.tf = {d: Counter(content_tokens(t + " " + b)) for d, t, b in docs} self.lens = {d: sum(c.values()) for d, c in self.tf.items()} self.avgdl = sum(self.lens.values()) / len(self.lens) self.N = len(docs) self.df = Counter() for c in self.tf.values(): self.df.update(c.keys()) def idf(self, term): n = self.df.get(term, 0) return math.log(1 + (self.N – n + 0.5) / (n + 0.5)) # Lucene 变体,恒非负 def score(self, query, did): s = 0.0 for term in content_tokens(query): f = self.tf[did].get(term, 0) if not f: continue norm = self.k1 * (1 – self.b + self.b * self.lens[did] / self.avgdl) s += self.idf(term) * f * (self.k1 + 1) / (f + norm) return s |
idf 那个公式用了一个细节:Lucene 变体是 log(1 + …),保证了 IDF 恒为非负。 经典 Robertson-Spärck-Jones 版本的 IDF 对超过半数文档都出现的词会算出负数,那会让得分变得莫名其妙。
BM25 的盲区在哪
BM25 的强项是逐字匹配:编号、型号、人名、错误码、专业缩写。这些恰恰是语义向量最差的地方——因为「NB-8841」这种字符串,在语义空间里没有任何邻居。
它的盲区也同样明确:它完全不理解同义和改写。用户说「在家干活」,文档写「居家办公」,对 BM25 来说这是两个毫不相关的词。
这两种盲区恰好互补。 这就是下一节要讲的事。
七、混合检索与 RRF:把两个不可比的分数合起来
既然两路检索各有所长,那就一起上。但一起上会遇到一个很实际的问题:分数不可比。
为什么不能直接相加
Azure AI Search 官方文档把这个问题的量纲差异列得很清楚:
|
搜索方法 |
打分算法 |
分数范围 |
|
全文搜索(关键词) |
BM25 |
没有上限 |
|
向量搜索 |
HNSW + 余弦 |
0.333 ~ 1.00 |
|
混合搜索 |
RRF |
上限由参与融合的查询数决定,每个查询最大贡献约 1/k |
|
语义排序 |
语义排序模型 |
0.00 ~ 4.00 |
BM25 给出 18.3,余弦给出 0.72,语义排序给出 2.6——这三个数字放在一起毫无意义。你没法把它们相加,也没法加权平均:谁的数值大,谁就自动占上风,而这和它准不准毫无关系。
RRF 只用名次
解法来自一篇只有两页的论文:Cormack、Clarke 和 Buettcher 的《Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods》(SIGIR 2009,第 758–759 页)。
它的核心洞察只有一句话:把所有分数都扔掉,只保留名次。
|
运行结果 |
|
RRF(d) = Σ ─────── r ∈ R k + r(d) |
其中 r(d) 是文档 d 在某一路结果里的名次,k 是常数(论文推荐 60)。
为什么名次能跨系统比较? 因为「第 3 名」在 BM25 里和在向量检索里,含义是一样的。分数是各家的方言,名次是通用语。
k=60 是怎么来的
这个常数不是拍脑袋定的。看它的实际作用:
|
名次 |
k=0 时的贡献 |
k=60 时的贡献 |
|
第 1 名 |
1.000 |
0.0164 |
|
第 2 名 |
0.500 |
0.0161 |
|
第 10 名 |
0.100 |
0.0143 |
|
第 100 名 |
0.010 |
0.0063 |
k=0 时,第 1 名和第 2 名差 0.5,一个「某一路的独苗第一」几乎能碾压一切。加上 k=60 之后,第 1 名和第 2 名的差距被抹平到 0.0003——单路的第一名不再有那么大的话语权,而「多路都认可」的文档开始占优。
论文里的原话是:常数 k「减轻了异常系统的高排名带来的影响」。作者做了试验,发现 k 在 20 到 100 之间时,MAP 指标几乎不动——这个算法对唯一的超参数非常不敏感,这是它能在工程上广泛落地的原因之一。
代码:七行实现 RRF
|
Python |
|
def rrf(rank_lists, k=60): """Reciprocal Rank Fusion(Cormack et al., SIGIR 2009)。 只吃名次、不吃分数,因此绕开了「BM25 分与余弦分不可比」这个死结。""" fused = defaultdict(float) for lst in rank_lists: for rank, did in enumerate(lst, start=1): fused[did] += 1.0 / (k + rank) return [d for d, _ in sorted(fused.items(), key=lambda x: (-x[1], x[0]))] |
就这么短。Azure AI Search 官方把它称为「a score-free method」——一种不依赖分数的融合方法,并且指出它「轻量、几乎不增加延迟,因此很适合作为更昂贵的模型重排之前的第一道重排」。
两路各擅长什么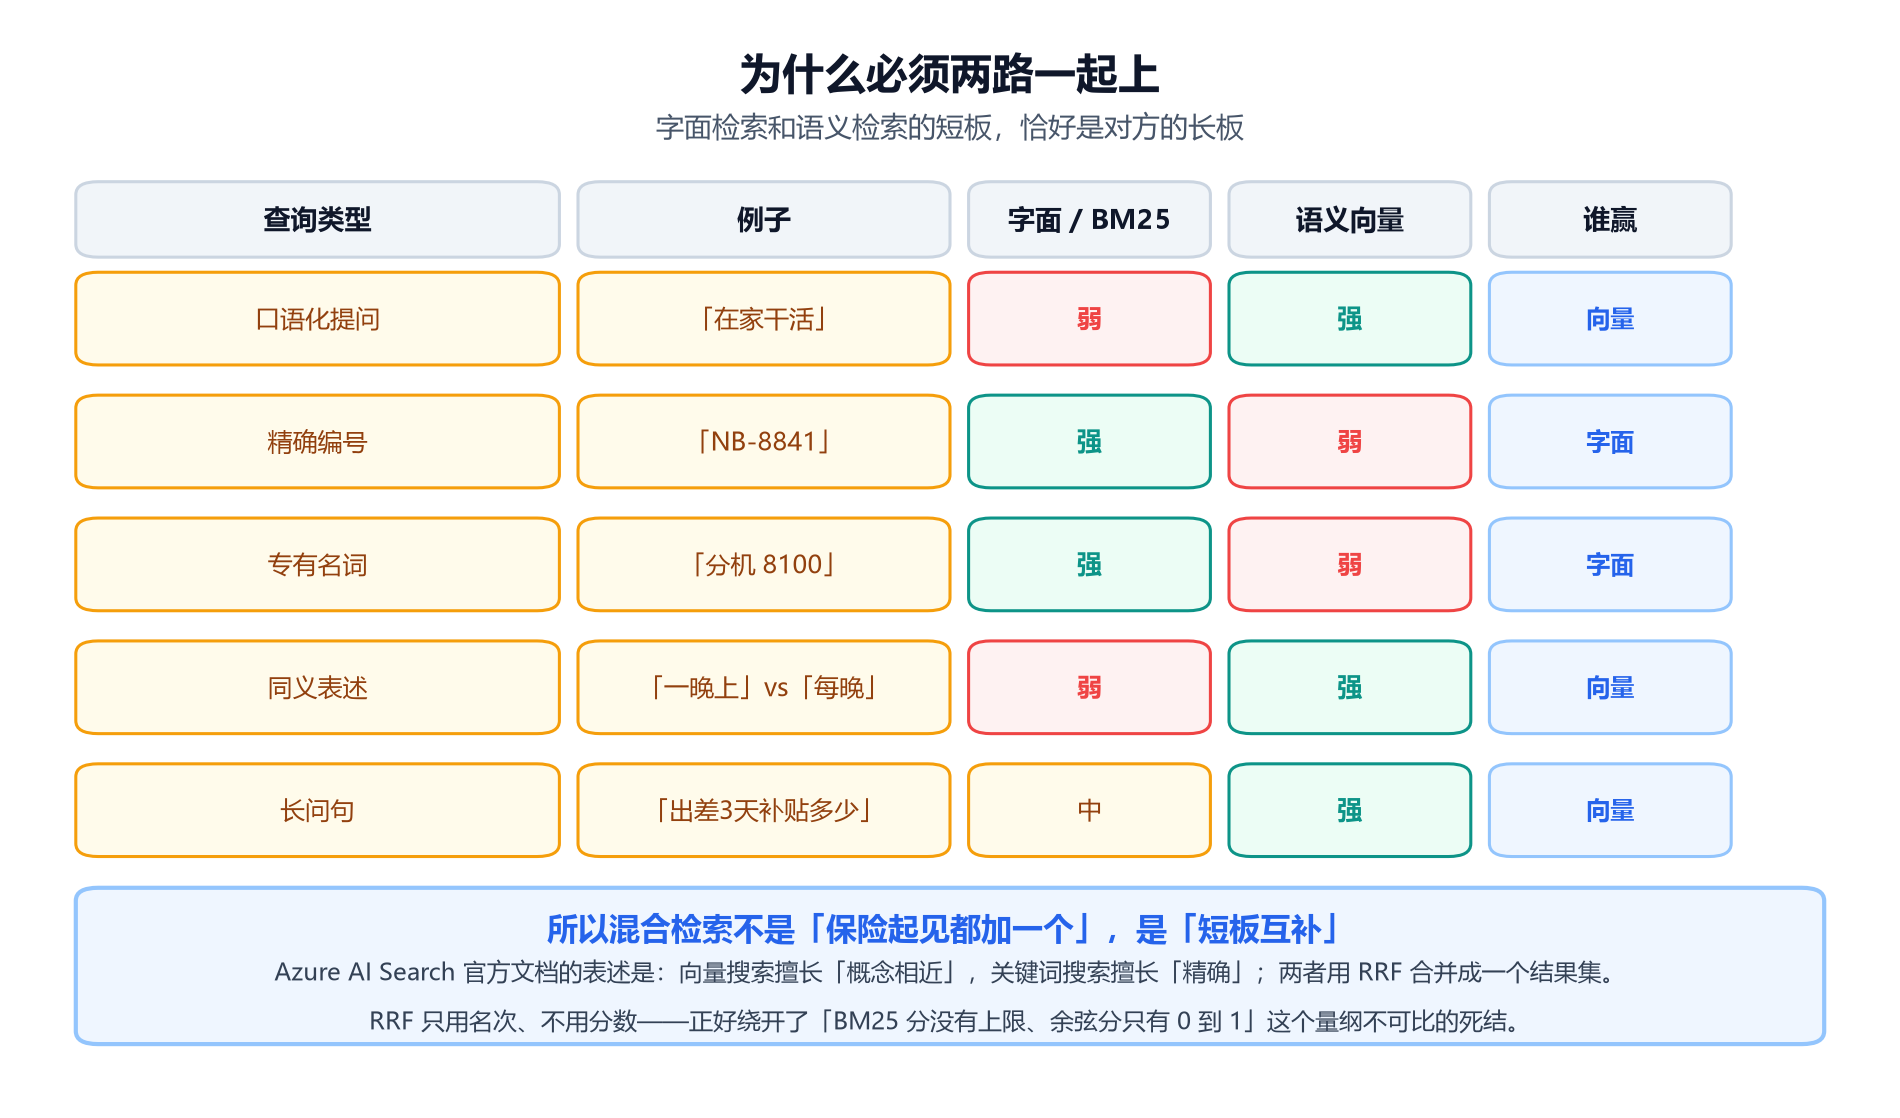 两路检索的互补矩阵
这张表来自我们的实验观察,和 Azure 官方文档的表述一致:向量搜索的优势在于找出「概念相近」的内容,即使倒排索引里没有任何关键词命中;关键词搜索的优势在于「精确」——商品编码、高度专业的术语、日期、人名这类查询,用关键词更准。
把这两条线接起来,就得到了生产级检索的标准形状——宽召回,窄注入: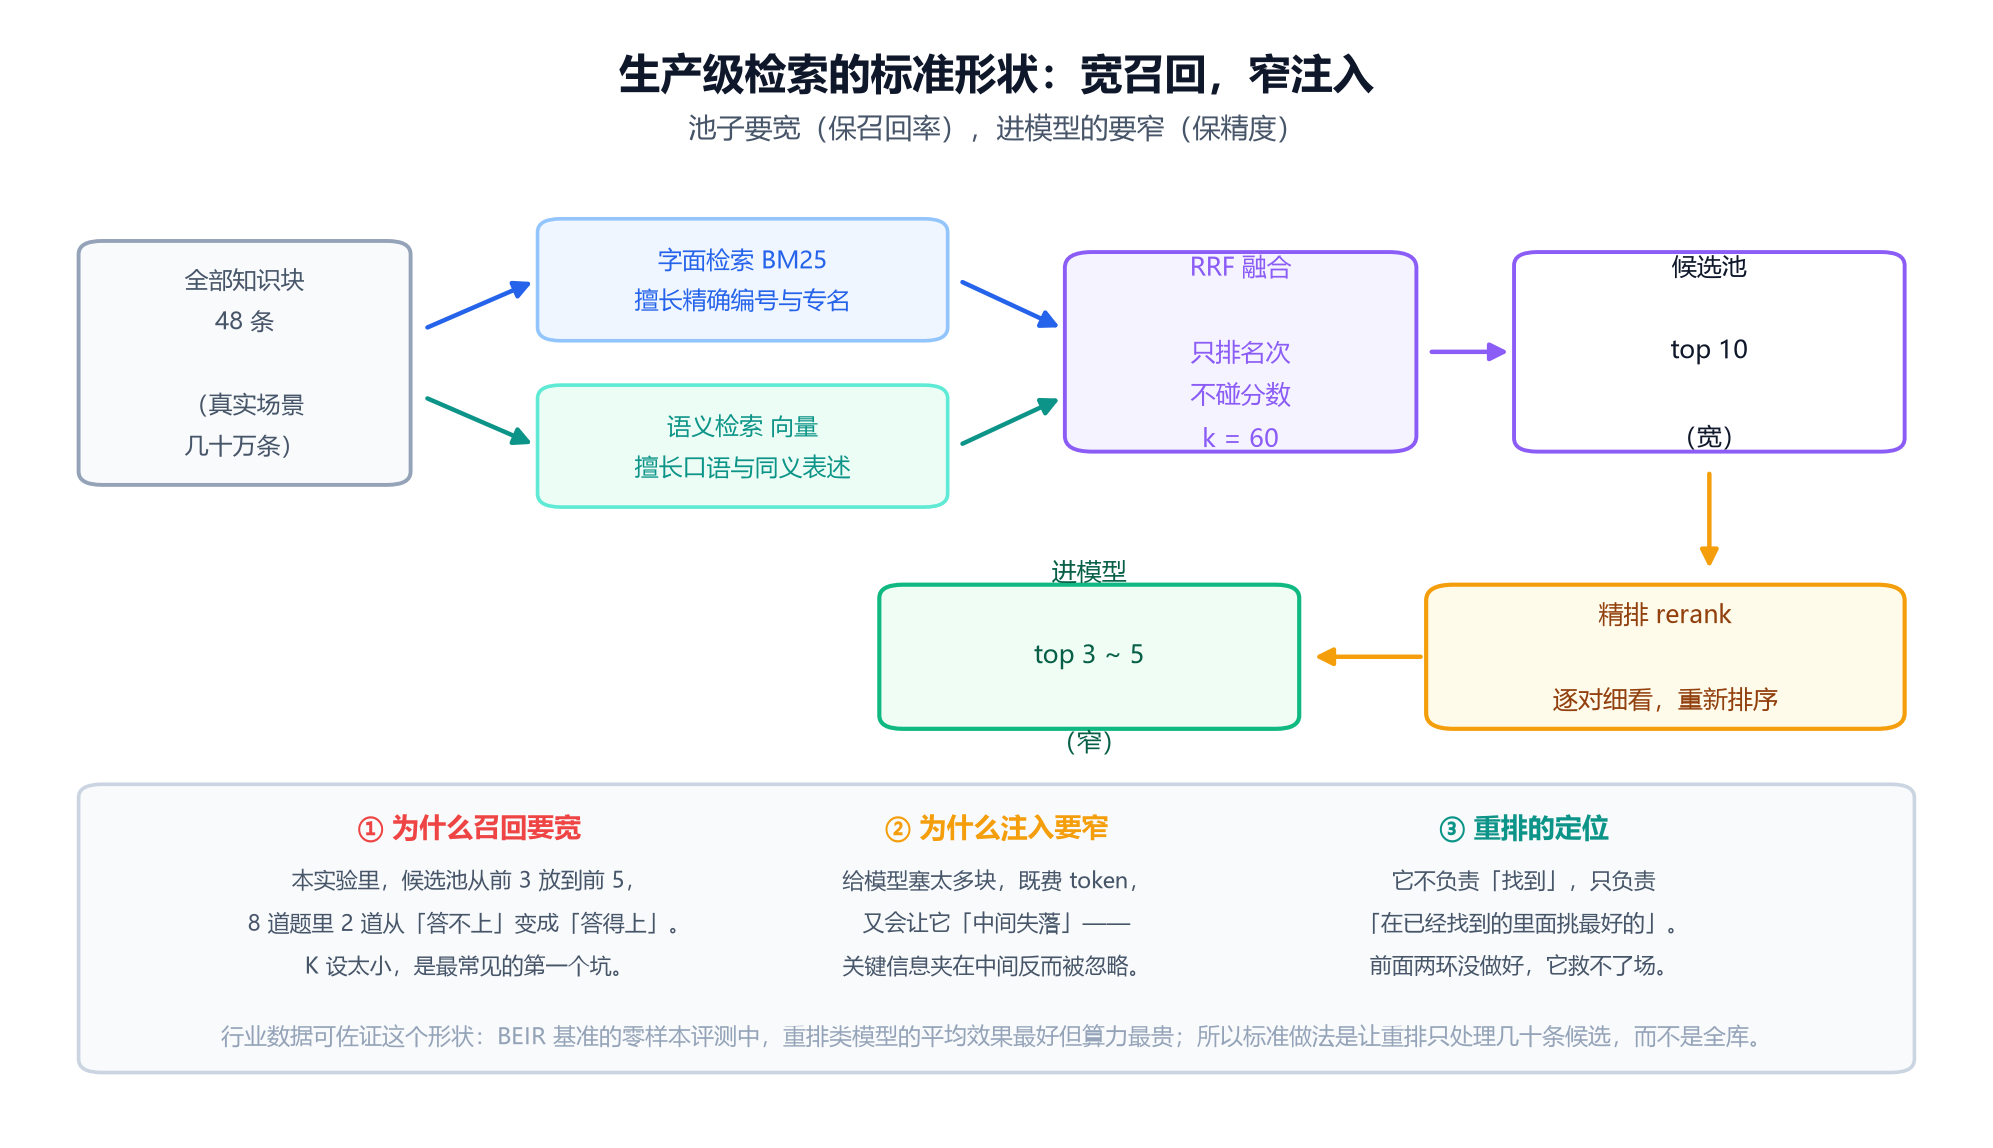 生产级检索的标准形状:宽召回,窄注入
这张图的三个关键位置,对应本文的三个结论:候选池要宽(第四节)、进模型的要窄(第四节)、重排只负责在已找到的里面挑最好的(第五节)。顺序错了,改动的收益就会被抵消。
八、完整实验:六种策略,八个提问
理论讲完了,现在看实测。这一节的所有数字都来自一个可以真跑的脚本,你可以在文末找到复现方法。
实验怎么设计的
知识库:48 条虚拟企业制度文档,覆盖差旅、假期、IT、保密、人事等主题。刻意埋了三类陷阱:
- 口语提问的用词,在正确文档里一次都不出现;
- 一个纯编号查询(NB-8841);
- 6 条「同主题近邻干扰」——比如「年假规则」旁边还躺着「年假结转与折现」「年假申请操作指引」,主题几乎一样,但答的不是同一个问题。真实知识库里这类重复文件最多,也最考验精排能力。
问题:8 个真实口吻的提问,覆盖口语化、同义表述、精确编号、多跳组合等类型。
策略:6 种,从最朴素到最完整。
|
代号 |
策略 |
说明 |
|
S1 |
字面匹配 |
实词共现计数,不做任何加权 |
|
S2 |
语义向量 |
概念空间余弦( embedding 的替身) |
|
S3 |
BM25 |
k1=1.2 , b=0.75 |
|
S4 |
混合 RRF |
BM25 + 向量, RRF 融合, k=60 |
|
S5 |
+查询改写 |
在 S4 之前先做术语改写 |
|
S6 |
+重排 |
在 S5 的候选池上做精排 |
结果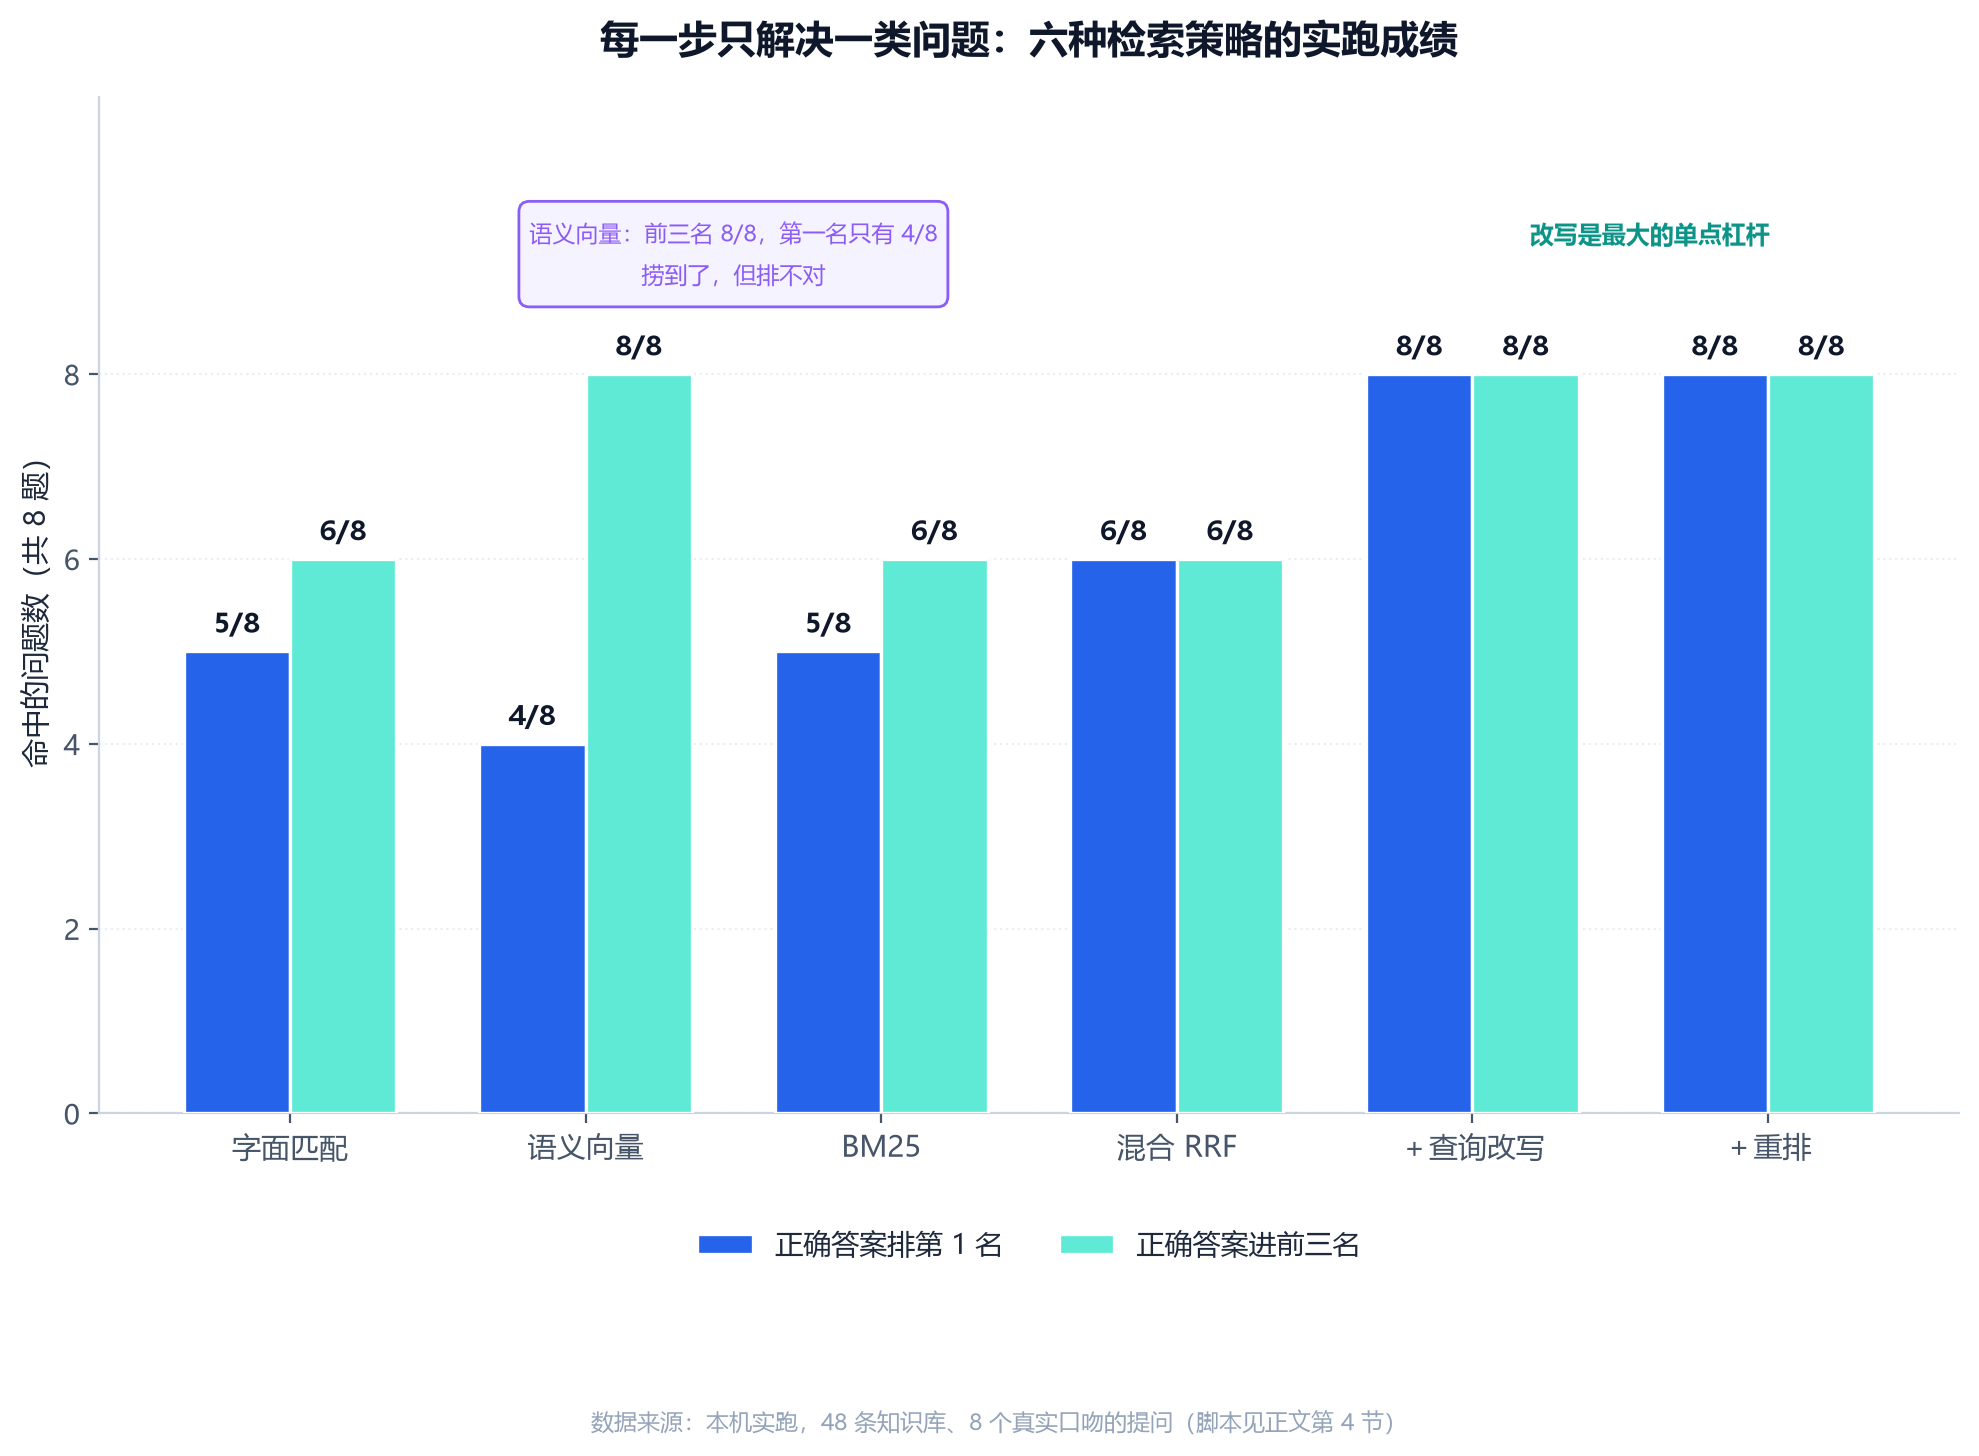 六种策略的效果阶梯
|
策略 |
第一名命中 |
进前三名 |
MRR |
平均名次 |
|
S1 字面匹配 |
5/8 |
6/8 |
0.716 |
2.38 |
|
S2 语义向量 |
4/8 |
8/8 |
0.750 |
1.50 |
|
S3 BM25 |
5/8 |
6/8 |
0.726 |
2.62 |
|
S4 混合 RRF |
6/8 |
6/8 |
0.812 |
1.75 |
|
S5 +查询改写 |
8/8 |
8/8 |
1.000 |
1.00 |
|
S6 +重排 |
8/8 |
8/8 |
1.000 |
1.00 |
几个值得停下来看的地方:
第一,语义向量的「前三名」是满分 8/8,但「第一名」只有 4/8。 这个组合非常说明问题:它捞得全,排不准。正确答案基本都在前三里,但经常不是第一个。如果你的系统只取 top 1,它会让你觉得「这个向量检索不太行」——其实它只是需要一次重排。
第二,混合检索(6/8)确实赢了任何单一策略(S1 的 5/8、S2 的 4/8、S3 的 5/8)。 这和业界共识一致:混合不是「保险起见多加一个」,而是「短板互补」。
第三,查询改写是最大的单点杠杆,8/8。 从 6/8 到 8/8,只加了一张几十行的对照表。
第四,也是最有意思的一点:在这个实验里,重排没有超过改写(8/8 对 8/8,各项指标持平)。
为什么重排没有赢
这个结果一开始让我有点意外,但想清楚之后,它恰恰印证了本文第二节的那句话——优化有顺序。
在本实验里,查询改写已经把最要命的「词汇鸿沟」填平了,一阶段就能把正确答案排到第一名。这时候重排没东西可改。 重排的价值只有在「候选池里有好几个长得很像的选项,需要精细分辨」时才体现出来——也就是在真实的、几十万条规模的知识库里。
|
多加一句:所以「业界说重排最有效」和「我测了没效果」可以同时为真。差别在于你的瓶颈在哪。判断方法很简单:先看你的正确答案在候选池里排第几。如果它已经常驻第 1 名,先别上重排;如果它稳定在第 4~8 名,重排就是你的解药。 |
逐题追溯:不同的问题要用不同的药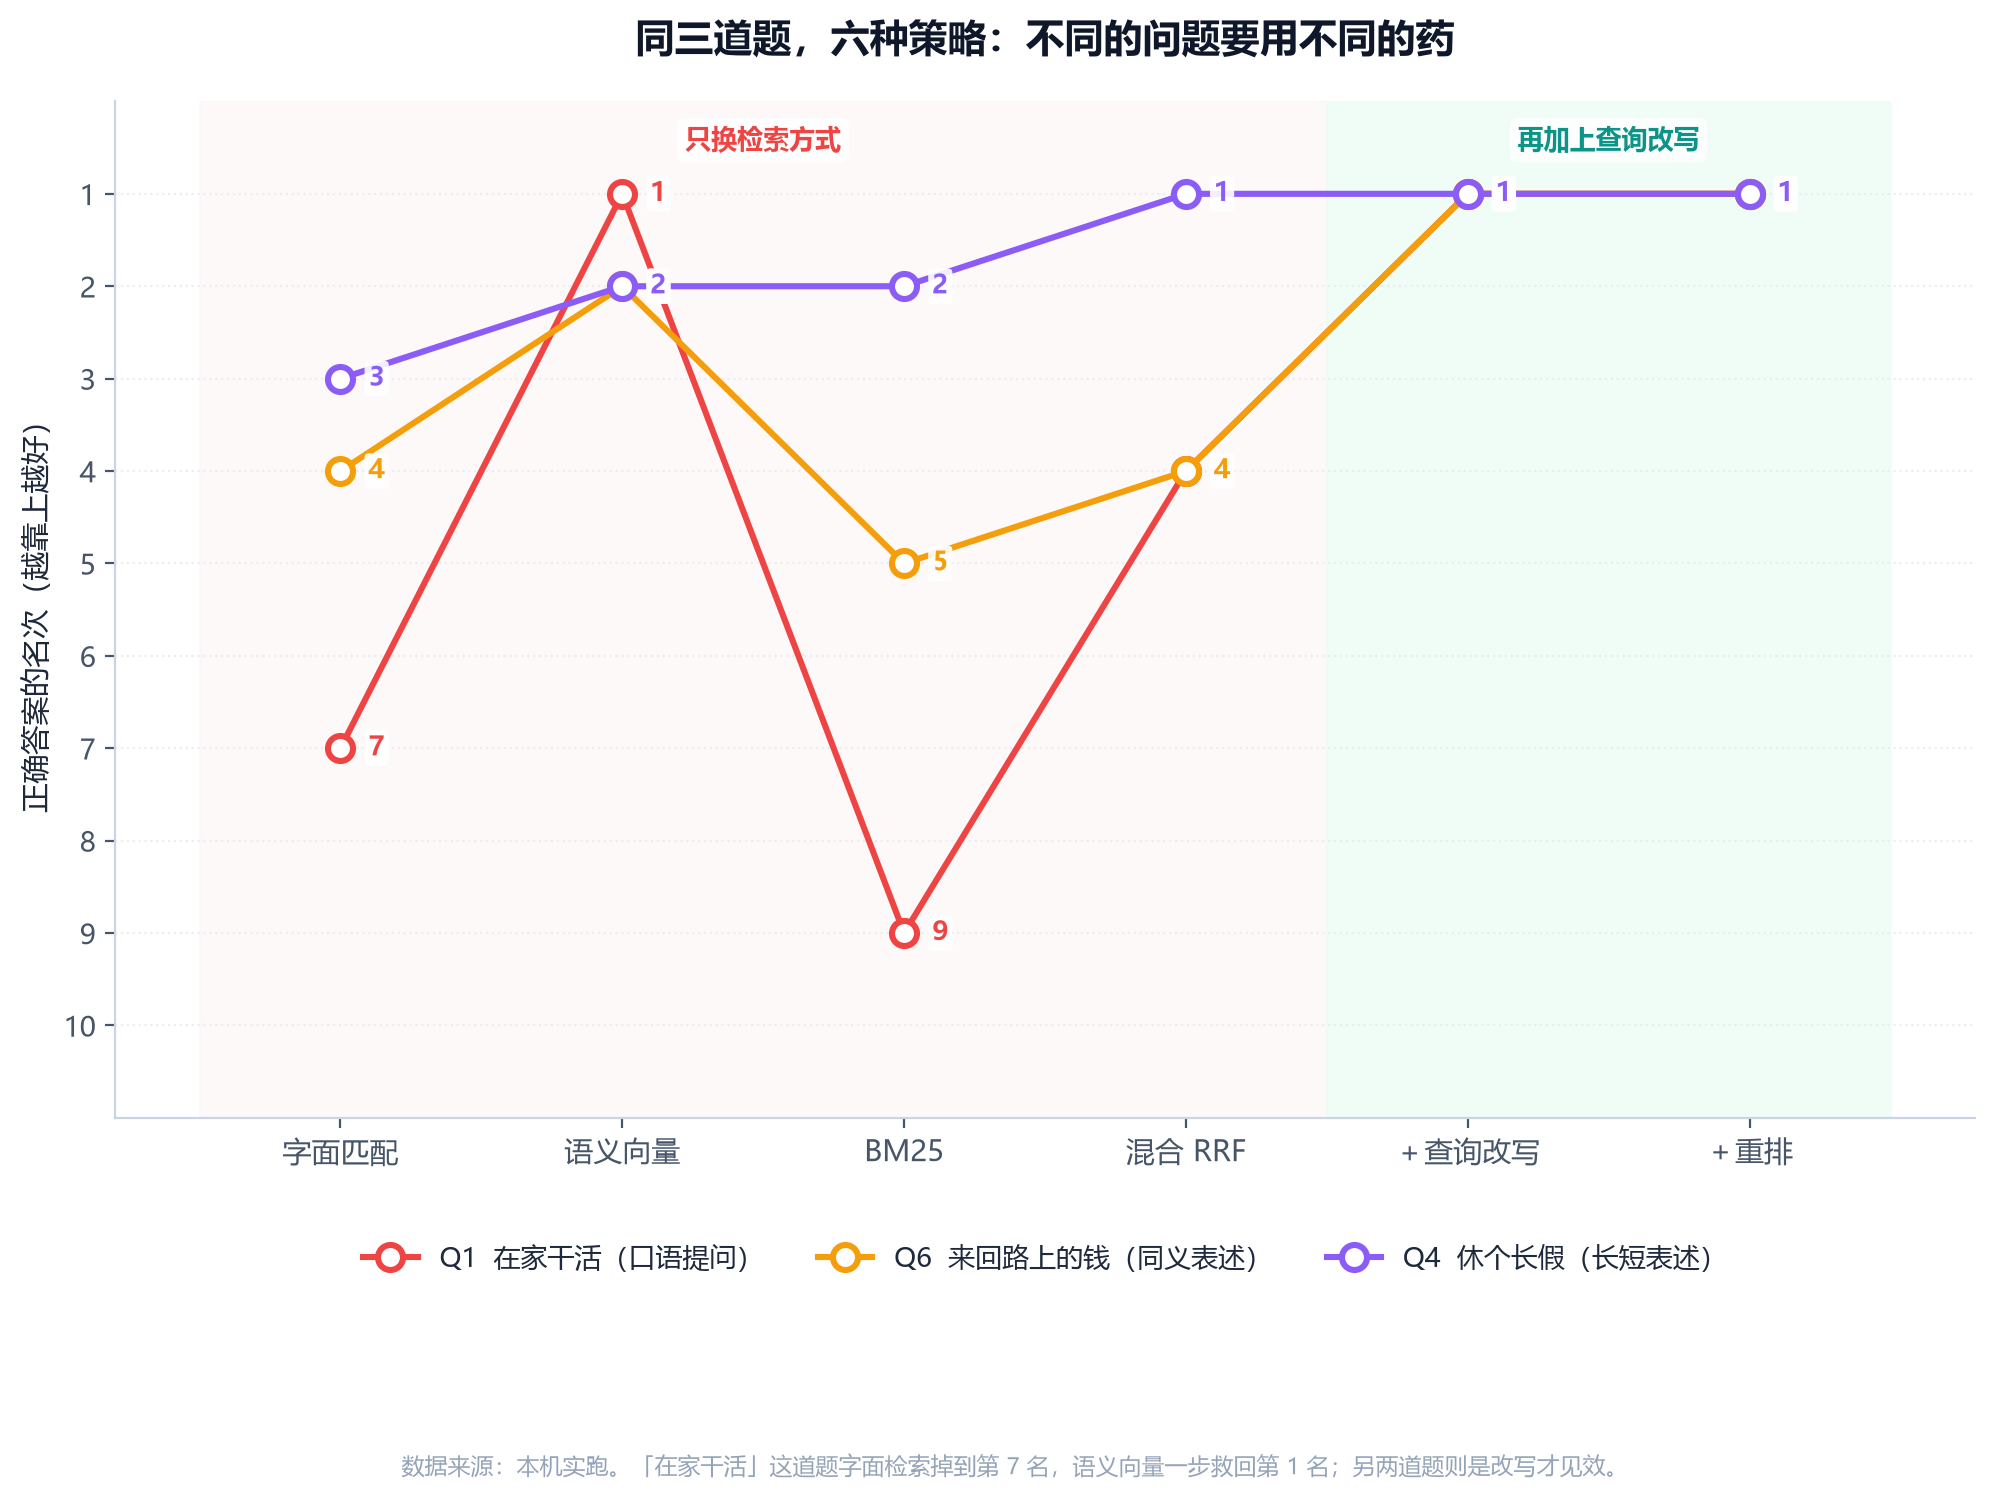 同三道题,六种策略的排名轨迹
这张图是整篇文章我最想让你记住的一页。三道题,三条线,各自在不同的地方被救回来:
- Q1「在家干活」(红线):字面检索第 7 名,BM25 第 9 名——掉到谷底。语义向量一步把它拉回第 1 名。这一类问题要靠「换个方式比对」。
- Q6「来回路上的钱」(黄线):字面第 4 名、BM25 第 5 名,语义向量只到第 2 名,混合检索也是第 4 名。直到加上查询改写,才一步到第 1 名。 这一类问题要靠「把词换对」。
- Q4「休个长假」(紫线):各个策略都在第 2~3 名徘徊,看着还行,但就是不夺冠。同样是查询改写把它送到第 1 名。
如果你只看总分,会以为「换个更好的检索算法」是答案。但看这三条线你会发现:没有一种算法能治所有病,因为它们得的不是同一种病。
九、真实案例:工业界是怎么做的
讲了这么多实验,你可能想看看真实系统。以下案例都标注了来源性质,请带着不同权重的信任度来看。
案例一:微软 Azure AI Search 的标准做法
这是官方文档级别的可靠来源。
微软的做法完整复刻了我们上面讲的架构:
官方文档还给了三条很实用的工程建议:
- 不要一上来就同时开最大向量召回、最大文本召回和语义重排——CPU 和内存压力会立刻上来,小规格实例上会直接出现延迟尖峰和 429 限流;
- 调参顺序:先降 efSearch(比如从 800 降到 128~192)、再收窄语义重排范围,最后才考虑加副本;
- 重排候选集大小从 20~50 起步——更大给重排更多素材,但延迟和成本同步上涨。
还有一个细节特别值得记住:向量检索永远会返回 k 个结果,即使最近的邻居其实并不相似。 文档的原话是「即使没有更接近的向量,它们仍然是最近的向量」。所以一个完全离谱的问题,向量检索也会一本正经地给你 k 个答案,只是分数都很低。关键词检索遇到没有的词会老老实实返回零结果,向量检索不会——这是两种技术一个非常重要的行为差异。
案例二:LinkedIn 用大模型重建检索层
这是官方工程博客(2026 年 3 月)级别的来源。
LinkedIn 重建了他们服务十几亿用户的 Feed 推荐系统。虽然这是推荐系统而不是文档问答,但检索层的原理完全相通,而且他们披露的细节特别有价值:
- 用一个 LLM 双编码器替换掉原来多路异构的检索源(时间线、热门内容、协同过滤、多个 embedding 系统)。理由是 LLM 带来的世界知识能建立语义连接:一个关注「电气工程」的人,会看到「小型模块化反应堆」的内容——这种联系传统关键词匹配完全抓不到;
- 一个工程技巧:把原始数值特征(浏览量、新鲜度)转成分位桶,再用特殊 token 表示。比如「浏览量 12345」变成 token「71」。官方报告这一步让 recall@10 提升 15%,embedding 相似度与内容热度的相关性提升 30 倍;
- 训练用了 InfoNCE 对比损失 + 难负样本(「展示过但没被互动」的帖子)。官方报告仅加 2 个难负样本就让召回率提升 3.6%;
- 最终指标:检索延迟低于 50 毫秒(要在数百万候选里搜),端到端服务延迟低于 1 秒。
这个案例说明的是:在工业级规模上,「检索」这两个字背后是一整套工程——不是换个向量库就能解决的。
案例三:重排带来的量化提升
这些是厂商自评数据,口径由厂商定义,参考价值在于量级:
|
来源 |
提升幅度 |
|
Cohere Rerank 3.5 (金融服务数据集) |
比混合检索 +23.4% ,比纯 BM25 +30.8% |
|
Voyage rerank-2 ( 93 个检索数据集) |
在 text-embedding-3-large 基础上平均 +13.89% |
延迟和成本的量级也可以参考:交叉编码器对 100 条候选重排,小的开源模型在单张 H100 上约 50 毫秒,大的模型(约 20 亿参数)在 A100 上约 0.9 秒;托管 API 按每千次查询(每次 100 篇文档)计费约 1~2 美元。
案例四:一个 SaaS 团队的改造账本
这是第三方博客转述的未具名案例,可信度低于前三个,仅作量级参考。
某 SaaS 团队维护着 5 万篇文档(Confluence + Zendesk),原本用纯语义检索,Precision@5 是 52%。他们做了三步:
结果 Precision@5 涨到 72%(相对提升 38%),实施周期两周,月度成本增加约 80 美元。转述中提到支持工单的自助解决率从 42% 提升到 61%。
这类案例的具体数字我无法一手核实,列在这里只是让你对「做这三件事值不值」有个量级感。真正的判断还是要看你自己的评测集。
十、天花板:有些问题一次检索结构上就解决不了
前面九节都在讲「怎么把检索调得更准」。但有一类问题,调得再准也没用。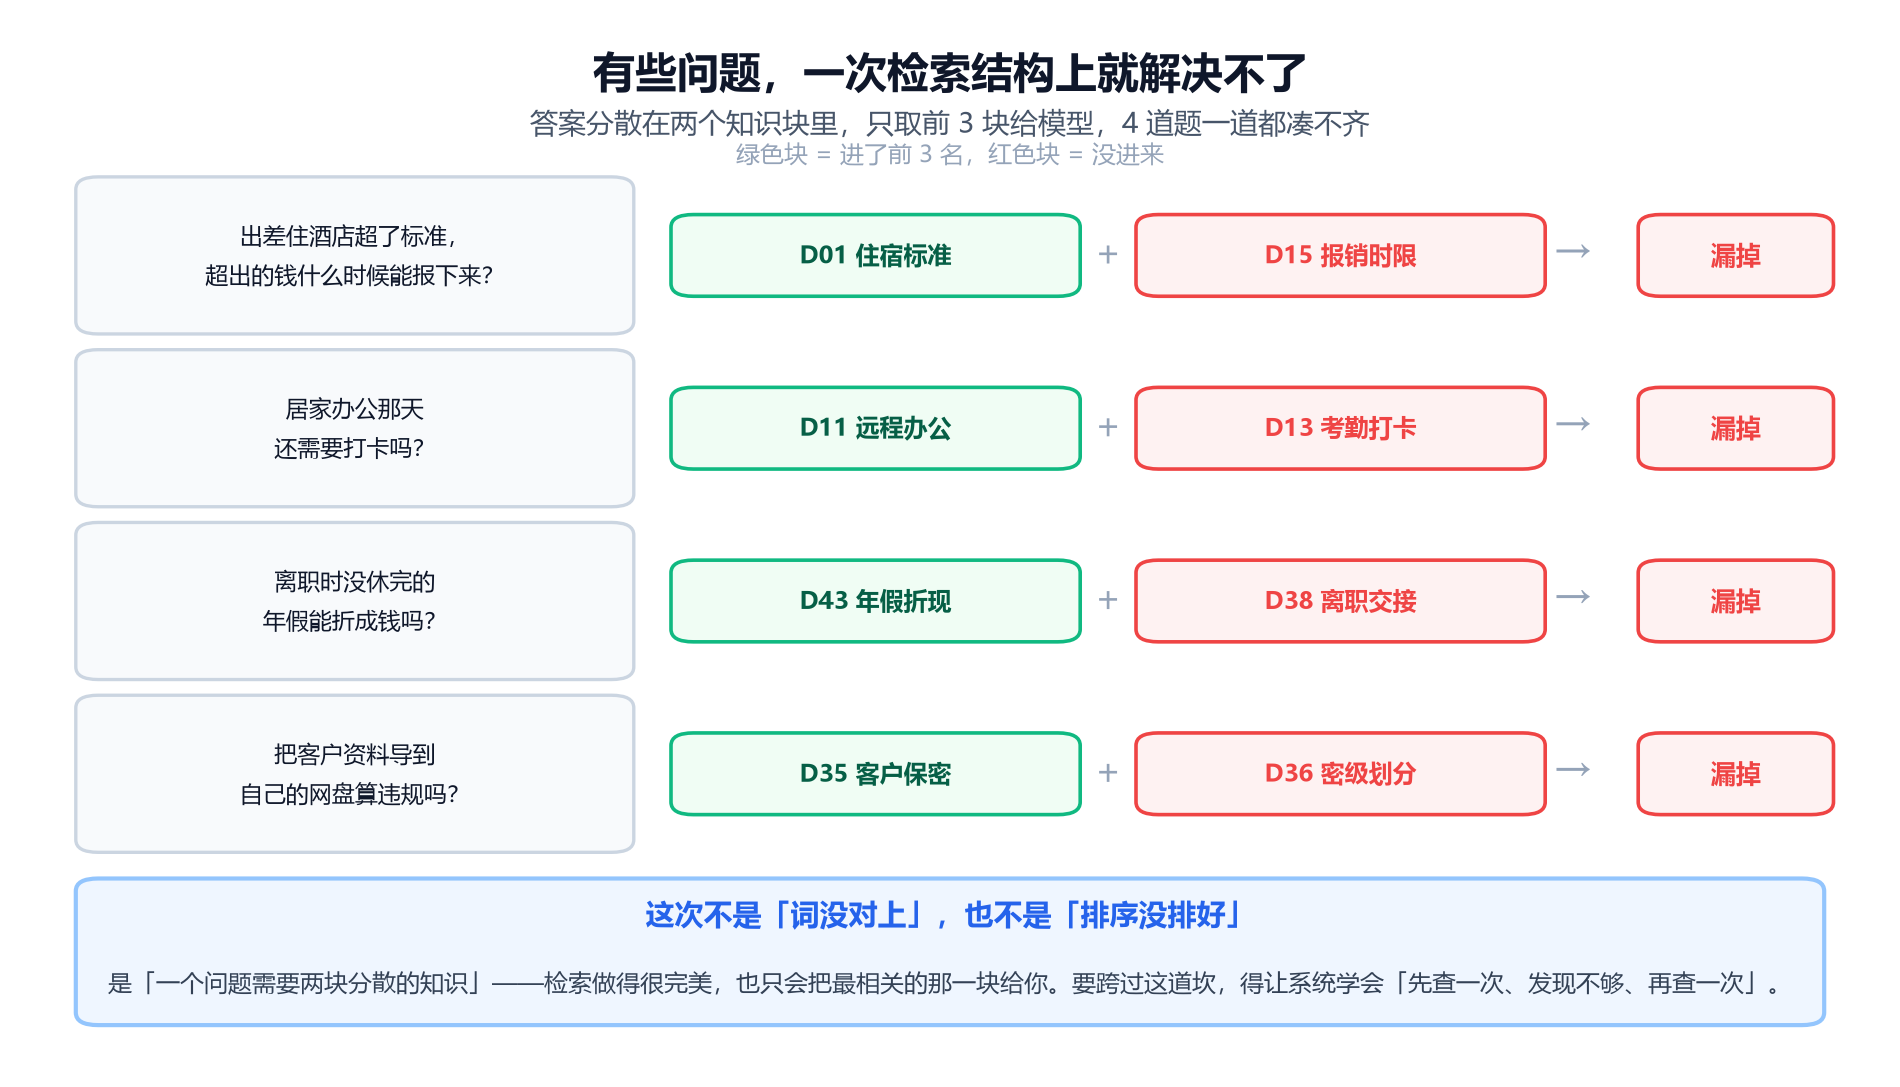 多跳问题:一次检索凑不齐材料
我们设计了 4 个需要两块不同知识才能回答的问题,然后看只取前 3 块给模型时,能不能凑齐材料:
|
问题 |
需要哪两块 |
结果 |
|
出差住酒店超了标准,超出的钱什么时候能报下来? |
住宿标准 + 报销时限 |
只捞到 1/2 |
|
居家办公那天还需要打卡吗? |
远程办公 + 考勤打卡 |
只捞到 1/2 |
|
离职时没休完的年假能折成钱吗? |
年假折现 + 离职交接 |
只捞到 1/2 |
|
把客户资料导到自己的网盘算违规吗? |
客户保密 + 密级划分 |
只捞到 1/2 |
4 道题,一道都没凑齐。
注意,这不是「词没对上」,也不是「排序没排好」——是检索这个动作本身,只会返回「最相关的那一块」。而这类问题的答案分布在两块不同的文档里,你取前 3 块,系统会给你 3 块「都在讲差旅」的内容,但缺了讲「报销时限」的那一块。
要跨过这道坎,系统得学会一件事:先查一次,发现不够,再查一次。
这就是所谓的多跳检索、迭代检索,也是 Agentic RAG 的起点。学界的做法包括:让模型把复杂问题分解成子问题分别检索(LevelRAG 这类方案会让一个高层 planner 把问题拆开,分派给关键词检索、语义检索和网页搜索三个专门的检索器),或者训练模型同时生成多个查询向量来覆盖一个问题的多种含义(AMER 的论文报告,在目标文档彼此不太相似的子集上,多向量比单向量有更明显的优势)。
这些内容足够单独写一篇。我们下一篇见。
十一、参数速查表
把这篇文章涉及的参数集中列一下,方便你对照自己的项目。
|
参数 |
常见默认值 |
作用 |
怎么调 |
|
块大小 chunk size |
256~1024 token |
每块知识的粒度 |
事实型问答用小块( 256~512 ),分析型问答用大块或整页 |
|
块重叠 overlap |
10%~20% |
防止答案被切断 |
上一篇已实测:切块按语义边界切,比按长度硬切强得多 |
|
召回深度 K |
20~100 |
候选池大小 |
别设太小。 本实验里从前 3 放到前 5 ,多救回 25% 的问题 |
|
注入块数 top_n |
3~5 |
最终给模型的块数 |
受「中间失落」效应约束,别贪多 |
|
RRF 的 k |
60 |
融合平滑常数 |
论文实测 20~100 之间结果几乎不变,基本不用调 |
|
BM25 的 k1 |
1.2 |
词频饱和速度 |
三十年评测淘出来的默认值,除非有充分理由否则别动 |
|
BM25 的 b |
0.75 |
长度归一强度 |
长文档为主的知识库可以略微上调 |
|
重排候选数 |
20~50 |
送去精排的条数 |
从 20~50 起步,看评测指标再调整 |
|
重排超时预算 |
100~200 ms |
增加的延迟 |
严格延迟要求的场景用更小的模型或跳过重排 |
十二、按顺序动手:一份可执行的优化清单
最后,把整篇文章压缩成一份可以照做的清单。顺序很重要,别跳步。
第 0 步:先建评测集。 这一步最容易被跳过,也最不能跳过。没有评测集,你无法区分「真的变好了」和「感觉好了一点」。做起来很简单:拿 100~500 个真实用户问题,检索出前 20 条,人工标注每条是「相关 / 部分相关 / 不相关」,存成「问题 → [(文档, 等级)]」并像代码一样版本管理。
第 1 步:定位瓶颈在哪一环。 对每个测试问题,记录正确答案在候选池里的排名。然后分三种情况处理:
- 经常不在候选池里 → 瓶颈在召回。跳到第 2 步。
- 在候选池里但常在第 4 名以后 → 瓶颈在排序。跳到第 4 步。
- 经常稳定在第 1 名 → 你的检索没问题,去查生成环节。
第 2 步:修词汇鸿沟。 先上查询改写(成本最低、见效最快)。从一张手工维护的口语–术语对照表开始,跑一遍评测,看提升多少。如果领域术语复杂,再考虑换成 LLM 改写。
第 3 步:把召回池放大,两路一起上。 K 从 3 提到 10 或 20,同时加上 BM25 和向量的混合检索,用 RRF 融合(不用调权重)。这一步之后再跑评测——你会发现召回率上去了,但精度可能反而下降了,因为噪声也进来了。 这是正常的,它为第 4 步创造了条件。
第 4 步:加一层精排。 用交叉编码器(开源的 BGE-Reranker 系列是稳妥的默认选择,或者用托管的 Cohere / Voyage API)把 top 50 精排成 top 5。这是单步收益最大的改动,也是唯一能解决「捞到了但排太后」的手段。
第 5 步:量化收益,再决定要不要继续。 在同一个评测集上报告改动前后的 NDCG@10、MRR@10、以及「召回到注入深度时的 Recall@k」。如果某一项改动没有让指标变好,把它退回去。 加更多环节不等于更好——我们第八节的实验就是活生生的例子。
|
一句话记住:优化检索的正确姿势是「先用数据找到瓶颈,再针对瓶颈下药」,而不是「把市面上听说过的技术都加一遍」。前者是工程,后者是碰运气。 |
数据时效声明
本文的实测数据来自本机运行的检索实验脚本(48 条知识库 / 8 个提问 / 6 种策略),运行环境为 Python 3.13 标准库,不含任何第三方依赖,结果可完整复现。
引用的外部数据均标注了来源与性质,请注意区分:
- 学术论文与基准(可信度最高):RRF 原始论文(SIGIR 2009)、HyDE(arXiv:2212.10496)、BEIR 基准(arXiv:2104.08663)、BM25 原始文献(Robertson & Zaragoza, 2009);
- 官方技术文档(可信度高):微软 Azure AI Search 混合检索与语义排序文档、LinkedIn 官方工程博客(2026 年 3 月);
- 厂商自评数据(口径由厂商定义,仅供参考量级):Cohere Rerank 3.5、Voyage AI rerank-2 的官方报告;
- 第三方博客转述(未具名,可信度最低):某 SaaS 团队与某电商平台的改造数据,本文仅用于提供量级感,不建议作为决策依据。
检索技术的迭代速度很快。向量索引算法、embedding 模型、重排模型的版本几乎每季度都有更新,阅读本文的技术选型建议时,请以你实际调研时的最新评测为准。
参考资料
下面按来源性质排列,方便你按需溯源。论文类给的是 arXiv 编号与 DOI,官方文档给的是可直达的页面地址。
- Cormack, G. V., Clarke, C. L. A., & Buettcher, S.(2009). Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods. SIGIR '09, 758–759. DOI: 10.1145/1571941.1572114(https://doi.org/10.1145/1571941.1572114)
- Gao, L., Ma, X., Lin, J., & Callan, J.(2022). Precise Zero-Shot Dense Retrieval without Relevance Labels. arXiv:2212.10496(https://arxiv.org/abs/2212.10496)
- Thakur, N., Reimers, N., Rücklé, A., Srivastava, A., & Gurevych, I.(2021). BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models. NeurIPS 2021. arXiv:2104.08663(https://arxiv.org/abs/2104.08663)
- Robertson, S., & Zaragoza, H.(2009). The Probabilistic Relevance Framework: BM25 and Beyond. Foundations and Trends in Information Retrieval.
- Microsoft Learn. Hybrid Search Overview — Azure AI Search(https://learn.microsoft.com/azure/search/hybrid-search-overview)
- Microsoft Learn. Information retrieval — Azure Architecture Center, RAG guidance(https://learn.microsoft.com/azure/architecture/ai-ml/guide/rag/rag-information-retrieval)
- LinkedIn Engineering. Engineering the next generation of LinkedIn's Feed(2026 年 3 月,https://www.linkedin.com/blog/engineering/feed/)
- Cohere. Rerank 3.5 发布说明与内部基准(https://cohere.com/rerank)
- Voyage AI. rerank-2 系列发布说明(https://www.voyageai.com/)
- Chen, H-T., Liu, X., Ravfogel, S., & Choi, E.(2025). Beyond Single Embeddings: Capturing Diverse Targets with Multi-Query Retrieval. arXiv:2511.02770(https://arxiv.org/abs/2511.02770)
配套实验脚本 retrieval_lab.py 包含完整的 48 条知识库、6 种检索策略实现与评测逻辑,纯标准库、无需任何依赖,直接运行即可复现文中全部数字。