📖标题:Video = World + Event Stream
🌐来源:arXiv, 2607.15038v1
🛎️文章简介
🔸研究问题:如何构建一个通用的预训练目标,使模型不仅能处理实时音视频交互,还能理解视频背后的持久上下文与动态变化,从而支持更广泛的下游任务?
🔸主要贡献:论文提出“视频=世界+事件流”的新范式,通过通用预训练赋予模型世界演化知识,并在保持低延迟的同时实现了开放词汇的自由行为生成。
📝重点思路
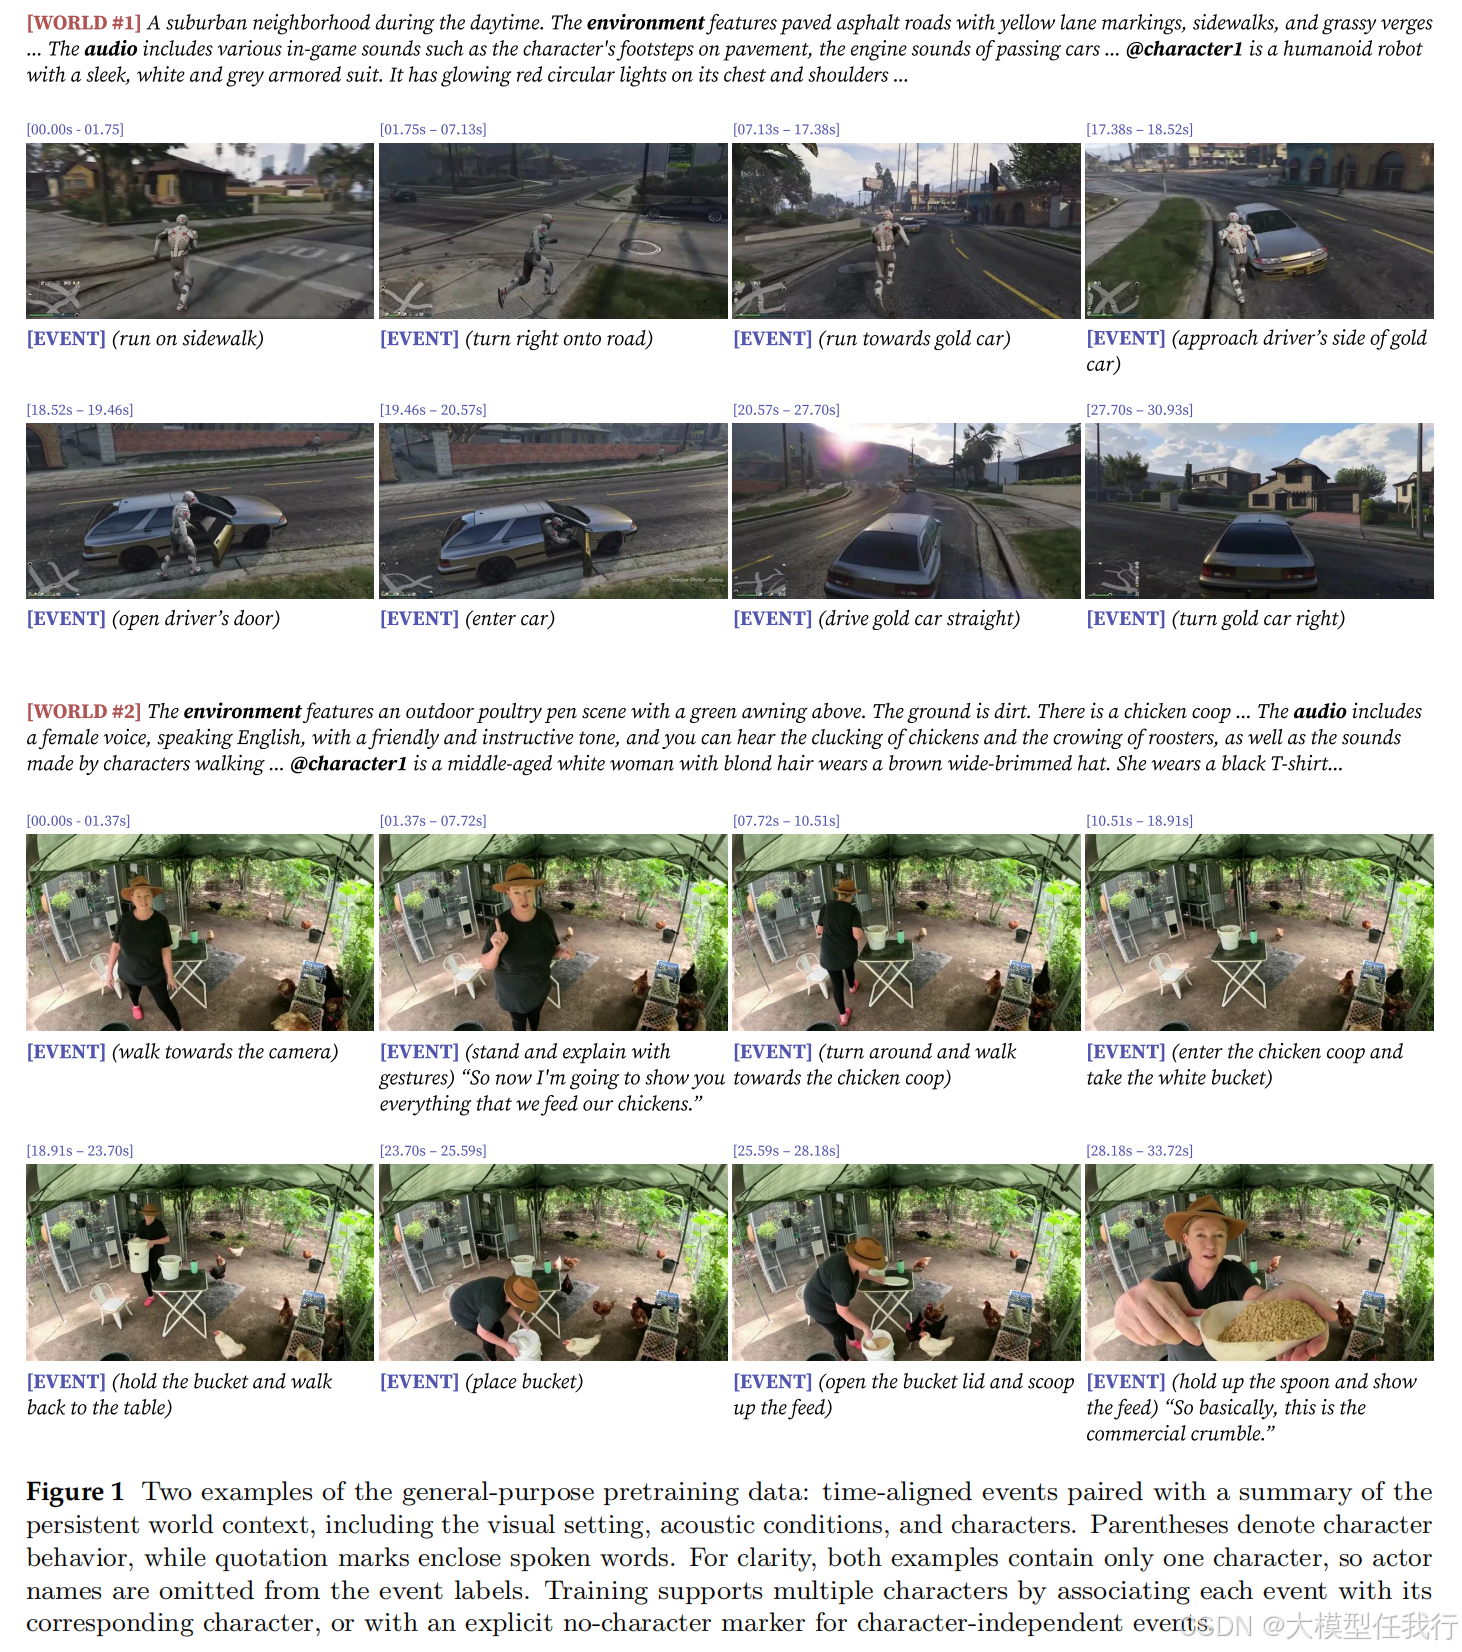
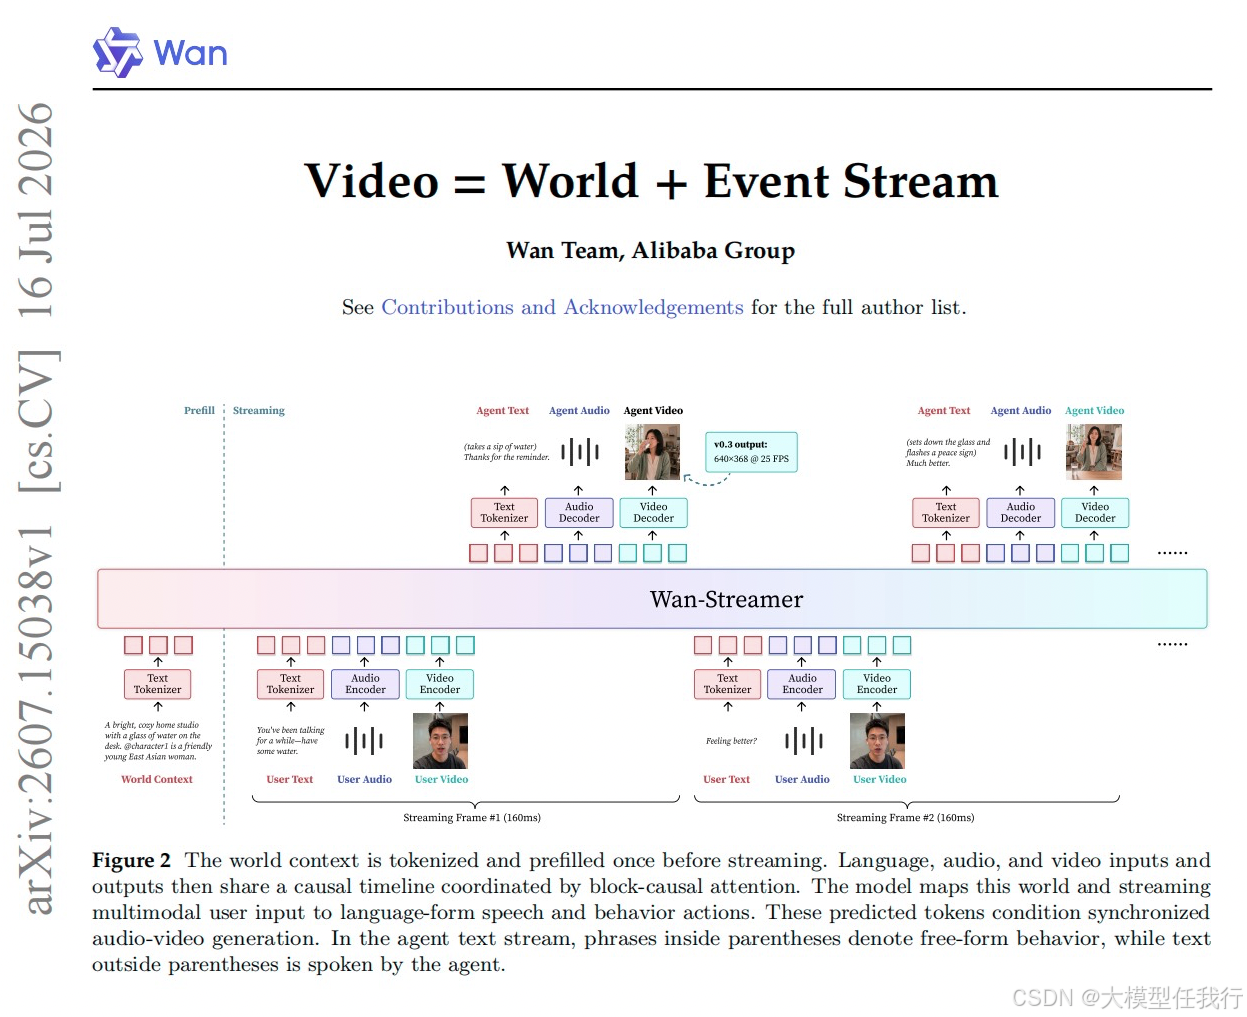
🔸提出核心分解理论:将视频解构为“世界”(World)和“事件流”(Event Stream)。世界指相对稳定的持久上下文,包括环境、场景、主体身份、外观及声学条件;事件流指随时间变化的内容,如主体行为、相机运动、语音及环境声音。
🔸定义通用预训练任务:基于大规模真实视频数据,训练模型根据给定的世界背景和输入,预测世界如何实时移动、变化和响应。这使得模型学习到场景合理演化的世界知识,而非仅针对单一交互任务优化。
🔸实例化实时全双工交互:在下游任务中,世界配置场景和角色,事件流由用户的流式文本、音频和视频驱动。模型采用类似视觉-语言-动作(VLA)的理解过程,将多模态输入映射为语言形式的语音和行为动作。
🔸引入自由形式行为表达:采用角色扮演聊天格式,代理的输出交织着口语和括号内的行为指令(如“(拿起杯子)谢谢”)。这种行为描述是开放词汇的,不局限于固定动作集,且与语音共享同一令牌流,确保时序同步。
🔸保持系统架构不变:继承v0.2的服务拓扑和建模契约,无需引入新的延迟关键路径。行为指令作为短语言令牌,对计算成本影响极小,通过因果解码器直接生成同步的音视频潜在变量。
🔎分析总结
🔸性能指标保持一致:Wan-Streamer v0.3在提升表达能力的同时,完全保留了v0.2的运行点,即640×368分辨率、25 FPS帧率、约200毫秒模型侧响应延迟以及在350毫秒双向网络预算下约550毫秒的总交互延迟。
🔸行为生成自然同步:实验表明,模型生成的开放词汇行为(如面部表情、姿势变化、物体交互)与语音高度同步,且扎根于配置的世界场景中,符合角色身份和外观设定。
🔸泛化能力得到验证:通过将预训练目标从特定交互数据扩展到通用视频数据,模型获得了可迁移的世界演化能力,证明了该分解方法在漫游、具身操作等其他实时任务中的潜力。
💡个人观点
论文从本体论角度重新定义了视频生成与理解的本质,将“持久上下文”与“动态事件”分离,并利用自然语言作为行为的中间表示。