很多做运维、SRE 的朋友最近挺焦虑的。手里攒着 Shell 脚本、Prometheus 告警规则、Ansible playbook,突然有一天发现,老板或者面试官开始问:“你会不会调大模型?能不能搞个 Agent?”
这种割裂感很真实。很多人简历上硬塞进去一个“基于 LLM 的智能运维平台”,结果面试官一问细节,全是“我调用了 API”、“用了 LangChain 框架”。这太虚了。对于运维背景的人来说,转做大模型应用,最大的优势不是写 Python 有多溜,而是**你对生产环境的痛点、边界条件和风险控制有着天然的敏感度**。
今天不谈怎么装环境,也不讲 Transformer 的数学原理,咱们直接复盘一个真实的转型路径:**如何把你过去做自动化脚本的逻辑,平滑迁移到 AIOps Agent 上。** 我会通过日志分析、告警归因、自动处置三个环节,聊聊这里面的坑和取舍,最后说说怎么写进简历里才像个真正的工程专家,而不是个调包侠。
摘要
本文探讨运维人员向大模型应用开发转型的实践路径。核心观点包括:将确定性运维逻辑转化为非确定性 Agent 推理;通过预处理降低 LLM 幻觉风险;建立“人机协同”的安全审批机制。文章提供了具体的代码示例和简历撰写策略,帮助读者将过往的工程经验转化为具备竞争力的 AI 项目描述。
目录
- 运维能力的迁移:从“如果-那么”到“思考-行动”
- 日志分析:让噪音回归信号
- 告警归因:连接孤立的监控指标
- 自动处置 Agent:安全与审批的底线
- 总结:简历里该怎么写?
运维能力的迁移:从“如果-那么”到“思考-行动”
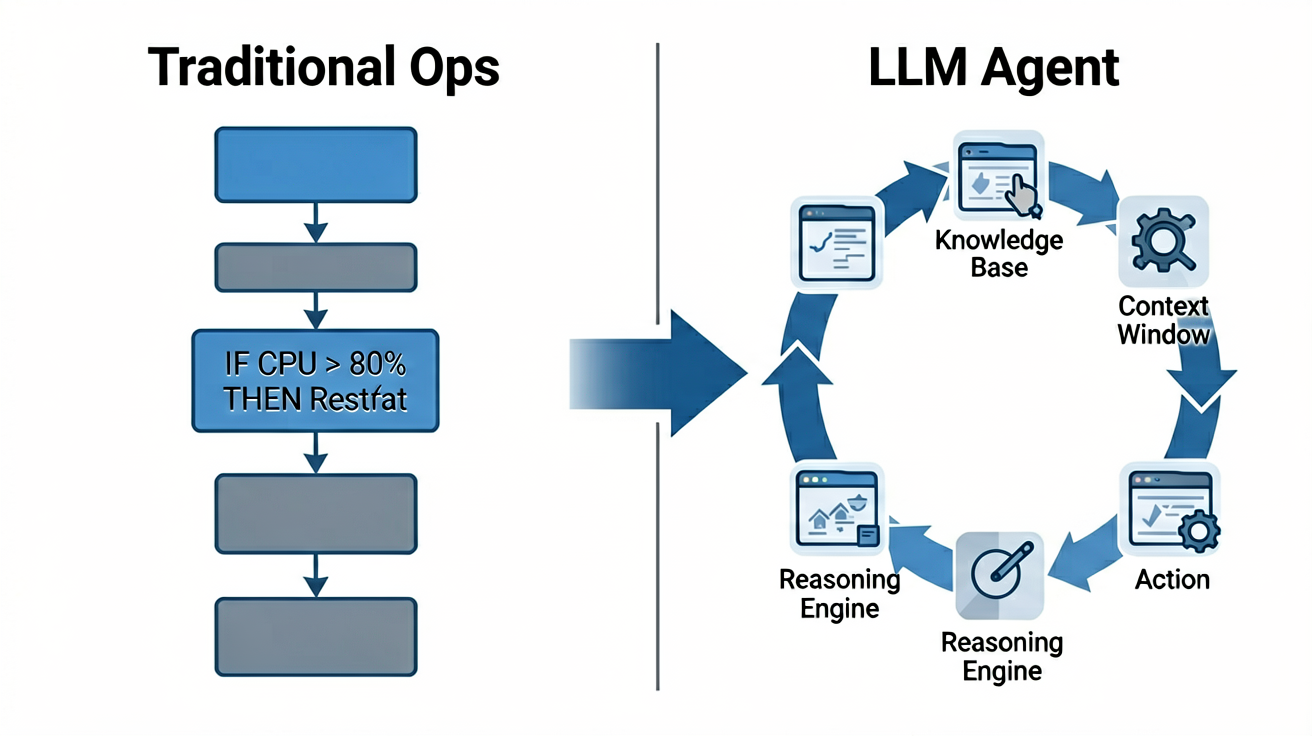
以前的自动化运维,本质上是确定性的逻辑树:`if CPU > 80% then restart service`。这种逻辑简单、可控,但面对复杂故障时往往力不从心。
引入大模型后,我们实际上是在构建一个非确定性的推理引擎。运维的核心能力——**监控、日志、网络拓扑、业务依赖关系**,并没有消失,它们变成了 Agent 的“长期记忆”和“上下文窗口”。
我在重构团队内部的故障处理流程时,做的第一个动作不是去学 PyTorch,而是重新梳理了现有的知识库。我们将过去三年的故障复盘报告(Post-mortem)、常见的 Runbook、以及微服务的依赖图谱,全部清洗成结构化数据。这才是 Agent 能“听懂”人话的基础。
**实战建议**:别一上来就搞复杂的 RAG 架构。先把你手头最头疼、重复性最高的那个排查步骤(比如查 Nginx 错误日志)拎出来,看看人工是怎么做的。把这个过程拆解成:输入什么(日志片段)、参照什么(历史工单)、输出什么(结论)。这就是你写 Prompt 的雏形。
日志分析:让噪音回归信号
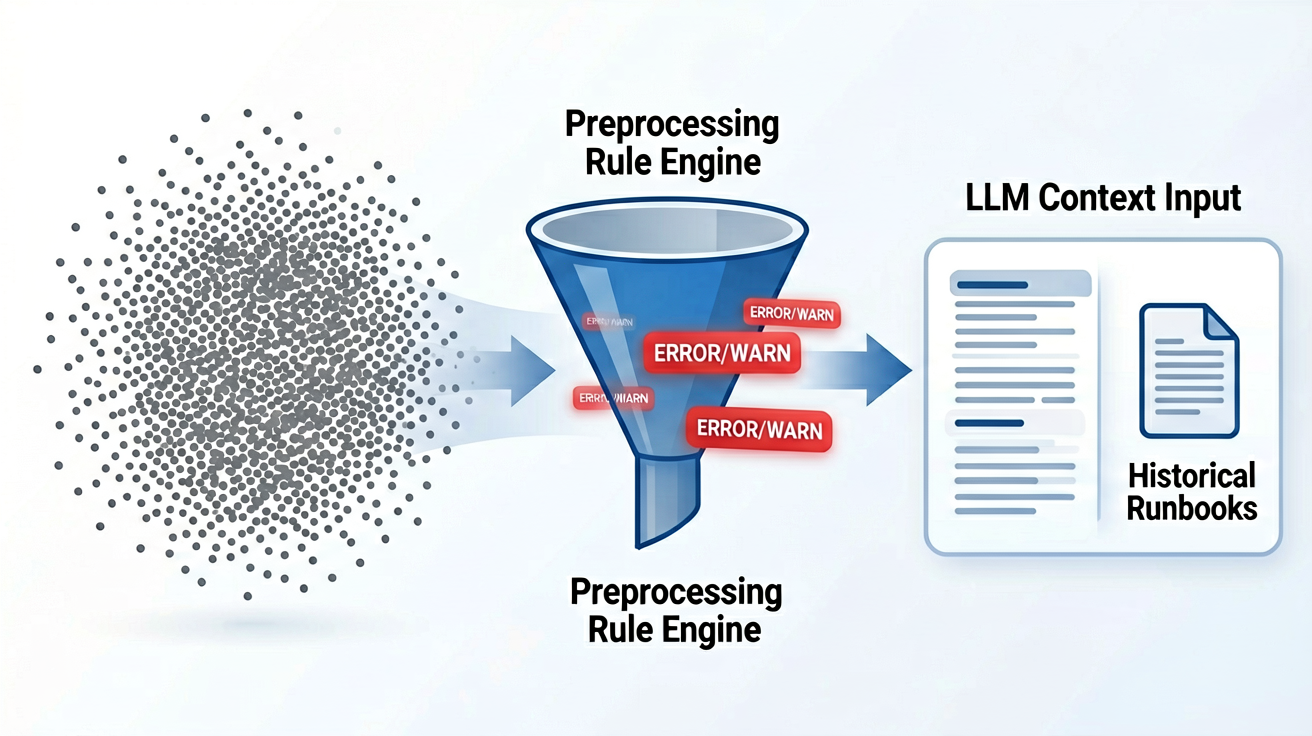
在运维日常中,最折磨人的就是海量日志。以前我们用正则表达式去过滤,现在有了 LLM,我们尝试让它理解语义。
但这有个巨大的陷阱:**幻觉**。如果你直接扔给模型一段几千行的 Nginx 访问日志,让它找异常,它大概率会编造一个根本不存在的问题。
我的做法是“预处理 + 关键切片”。
首先,必须在 LLM 介入前,用传统规则引擎(如 Promtail + Logstash)过滤掉 99% 的正常流量日志,只保留 ERROR、WARN 级别,或者特定时间窗口内的密集报错。其次,给模型提供足够的上下文,而不仅仅是日志文本。
import json
def construct_log_context(error_logs, service_name):
"""
构建供 LLM 分析的日志上下文
"""
# 截取最近的 20 条关键错误
recent_errors = error_logs[-20:]
context_payload = {
"service": service_name,
"time_window": "last_1h",
"severity_filter": ["ERROR", "CRITICAL"],
"logs": [
{
"timestamp": log['timestamp'],
"message": log['message'],
"stack_trace": log.get('stack_trace', '')
}
for log in recent_errors
]
}
return json.dumps(context_payload)
# 在实际调用时,配合 System Prompt 使用
system_prompt = """
你是一个资深 SRE 专家。请分析以下日志片段,识别根本原因(Root Cause)。
如果无法确定,请列出最可能的几个假设,并给出需要进一步收集的信息。
严禁臆造日志中不存在的错误码。
"""
在这个阶段,我学到的最重要一课是:**不要指望大模型去“读”所有日志,而是让它做“侦探”**。它需要线索,而不是满手泥土。
告警归因:连接孤立的监控指标
监控告警通常是碎片化的。CPU 高、内存低、数据库连接池满,这几个告警可能同时响,但根源只有一个。以前的关联分析靠的是硬编码的规则,比如“CPU 升高超过 5 分钟则检查 Load Average”。
现在,我们可以让 Agent 根据拓扑图来推理。
这里有一个关键的取舍:**准确性 vs 响应速度**。大模型推理是有延迟的。如果在核心交易链路中,我们不敢让 LLM 决定“关闭某个服务”。因此,我将 Agent 定位为“辅助归因”,而不是“最终决策者”。
Agent 的工作流是这样的:
1. 接收告警风暴。
2. 查询 CMDB,获取受影响服务的上下游依赖。
3. 提取相关 metrics 和 logs。
4. 生成一份“疑似根因报告”,附带置信度评分。
如果置信度高于 90%,且操作是可逆的(如重启 Pod),可以触发自动恢复流程;否则,直接推送给值班工程师,并附上建议操作命令。
自动处置 Agent:安全与审批的底线
这是运维转大模型最容易踩坑,也最能体现价值的地方。很多新手觉得,“既然叫 Agent,那就让它全自动干活呗”。**大错特错。**
在生产环境,**权限隔离**和**人工确认(Human-in-the-loop)**是不可逾越的红线。
我在设计自动处置 Agent 时,采用了“沙箱模拟 + 双因子确认”机制。当 Agent 决定执行 `kubectl delete pod 已完善内容` 或 `iptables -F` 时,流程如下:
1. **Dry Run 验证**:Agent 先在测试环境或干跑模式下验证命令语法和潜在影响范围。
2. **审批流触发**:将拟执行的命令、预期效果、风险等级发送给指定的负责人(可以是机器人或真人)。
3. **执行审计**:一旦获得授权,执行命令并将全过程日志上链或存入不可篡改的审计库。
代码层面,我封装了一个统一的 Action Executor,所有 LLM 生成的指令必须经过这个中间件。
class SafeActionExecutor:
def __init__(self, approval_required=True):
self.approval_required = approval_required
def execute(self, action_command, context_info):
if self.approval_required:
# 这里集成钉钉/飞书机器人审批接口
approved = request_approval(action_command, context_info)
if not approved:
raise PermissionError("Action denied by human approver")
# 执行前置检查:是否涉及生产数据库?是否批量删除?
risk_level = assess_risk(action_command)
if risk_level == 'HIGH':
# 强制二次确认或走更高级别审批
pass
result = run_command(action_command)
log_audit(action_command, result)
return result
总结:简历里该怎么写?
回到开头那个问题,简历项目怎么讲清楚?
不要写:“我搭建了一个基于 LangChain 的智能运维平台。”
要写:“针对线上告警风暴导致的响应滞后问题,设计并实现了一套**人机协同的 AIOps Agent 系统**。通过整合 Prometheus 指标与 ELK 日志,利用 LLM 进行多源数据关联分析,将平均故障定位时间(MTTR)缩短了 40%。特别设计了基于 RBAC 的执行审批网关,确保所有自动化操作符合安全合规要求,实现了从‘被动响应’到‘主动辅助’的工程化落地。”
你看,这里面有痛点、有技术方案、有数据支撑、还有对安全边界的考量。这才是运维工程师转型做 AI 应用时,最核心的竞争力。
别被那些花哨的术语吓住,回归工程本质。大模型只是你的新工具,而你过去十年积累的“排错直觉”和“系统思维”,才是让这个工具真正产生价值的关键。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。