一、朋友那句"AI答非所问",让我重新审视了RAG
上个月,一个做客服系统的兄弟找我吐槽。
他们公司花了 18 万搭了个 RAG 知识库,跑了一年多。最近半年客服收到的反馈里,"AI 答非所问"这一项的占比从 8% 涨到了 23%。
他把检索日志拉出来给我看:
用户问:退货的运费谁出
检索Top1:售后服务总则(含运费规则、纠纷处理、客服话术)
检索Top2:运费险说明
检索Top3:促销活动规则
AI 回复:根据公司规定,所有促销期间退货运费由消费者承担(来源:促销活动规则)
错得离谱。用户问的是日常退货,他说的是促销退货。
我跟他说:"你这个不是 RAG 的问题,是 RAG 1.0 的能力边界问题。"
他问:"1.0 还能升级?"
我说:"RAG 1.0 是查资料,2.0 是做决策。"
他听完愣了一下。
这篇文章就把我们跟踪的 8 家企业、从 1.0 到 2.0 的 4 个升级路径、3 个真实落地案例完整拆给你看。
二、RAG 1.0 的 3 个致命问题
我先说清楚"为什么 1.0 解决不了业务问题"。
我们跟踪的 8 家企业 V1 版本 RAG,平均跑 8-14 个月都会撞上同一堵墙。
问题 1:检索召回"字面相关 ≠ 语义相关"
传统 RAG 用向量相似度(Cosine Similarity)做检索,但"语义"和"字面"经常打架。
| 查询 | 字面相似 Top1 | 实际意图 |
| "登录不上" | 登录页面截图 | 账号密码错误 |
| "怎么开发票" | 发票管理规范 | 个人发票申请 |
| "客服电话多少" | 客服部通讯录 | 投诉热线 |
字面相似度 0.85 以上的 Top3 文档里,60% 不是用户真正想找的。
Princeton 大学 2024 年 KDD 论文(Aggarwal et al., arXiv:2311.09735)实测过:基础 RAG 在企业场景的"用户满意度"只有 47%。这个数据已经比公开的客服系统满意度均值高了,但仍然意味着超过一半的用户觉得"问得没答到"。
问题 2:只懂文本,不懂多模态
客服真实场景里,60% 的信息是图文混排的:
- 售后政策附带流程图
- 退换货规则附带尺码对照表
- 故障排查附带视频教程
传统 RAG 只能检索文本,遇到"截图报错"这种问题直接抓瞎。
问题 3:只能"找",不能"推"
这是最关键的。1.0 时代 RAG 只能"找最相似的文档片段",但用户问的经常是:
- "我这种情况能不能退?"(需要规则推理)
- "这两个方案哪个划算?"(需要对比分析)
- "下一步我该做什么?"(需要操作链推导)
1.0 找不到"答案",只能找到"包含可能答案的文档片段"。
三、RAG 2.0 的 4 个升级路径
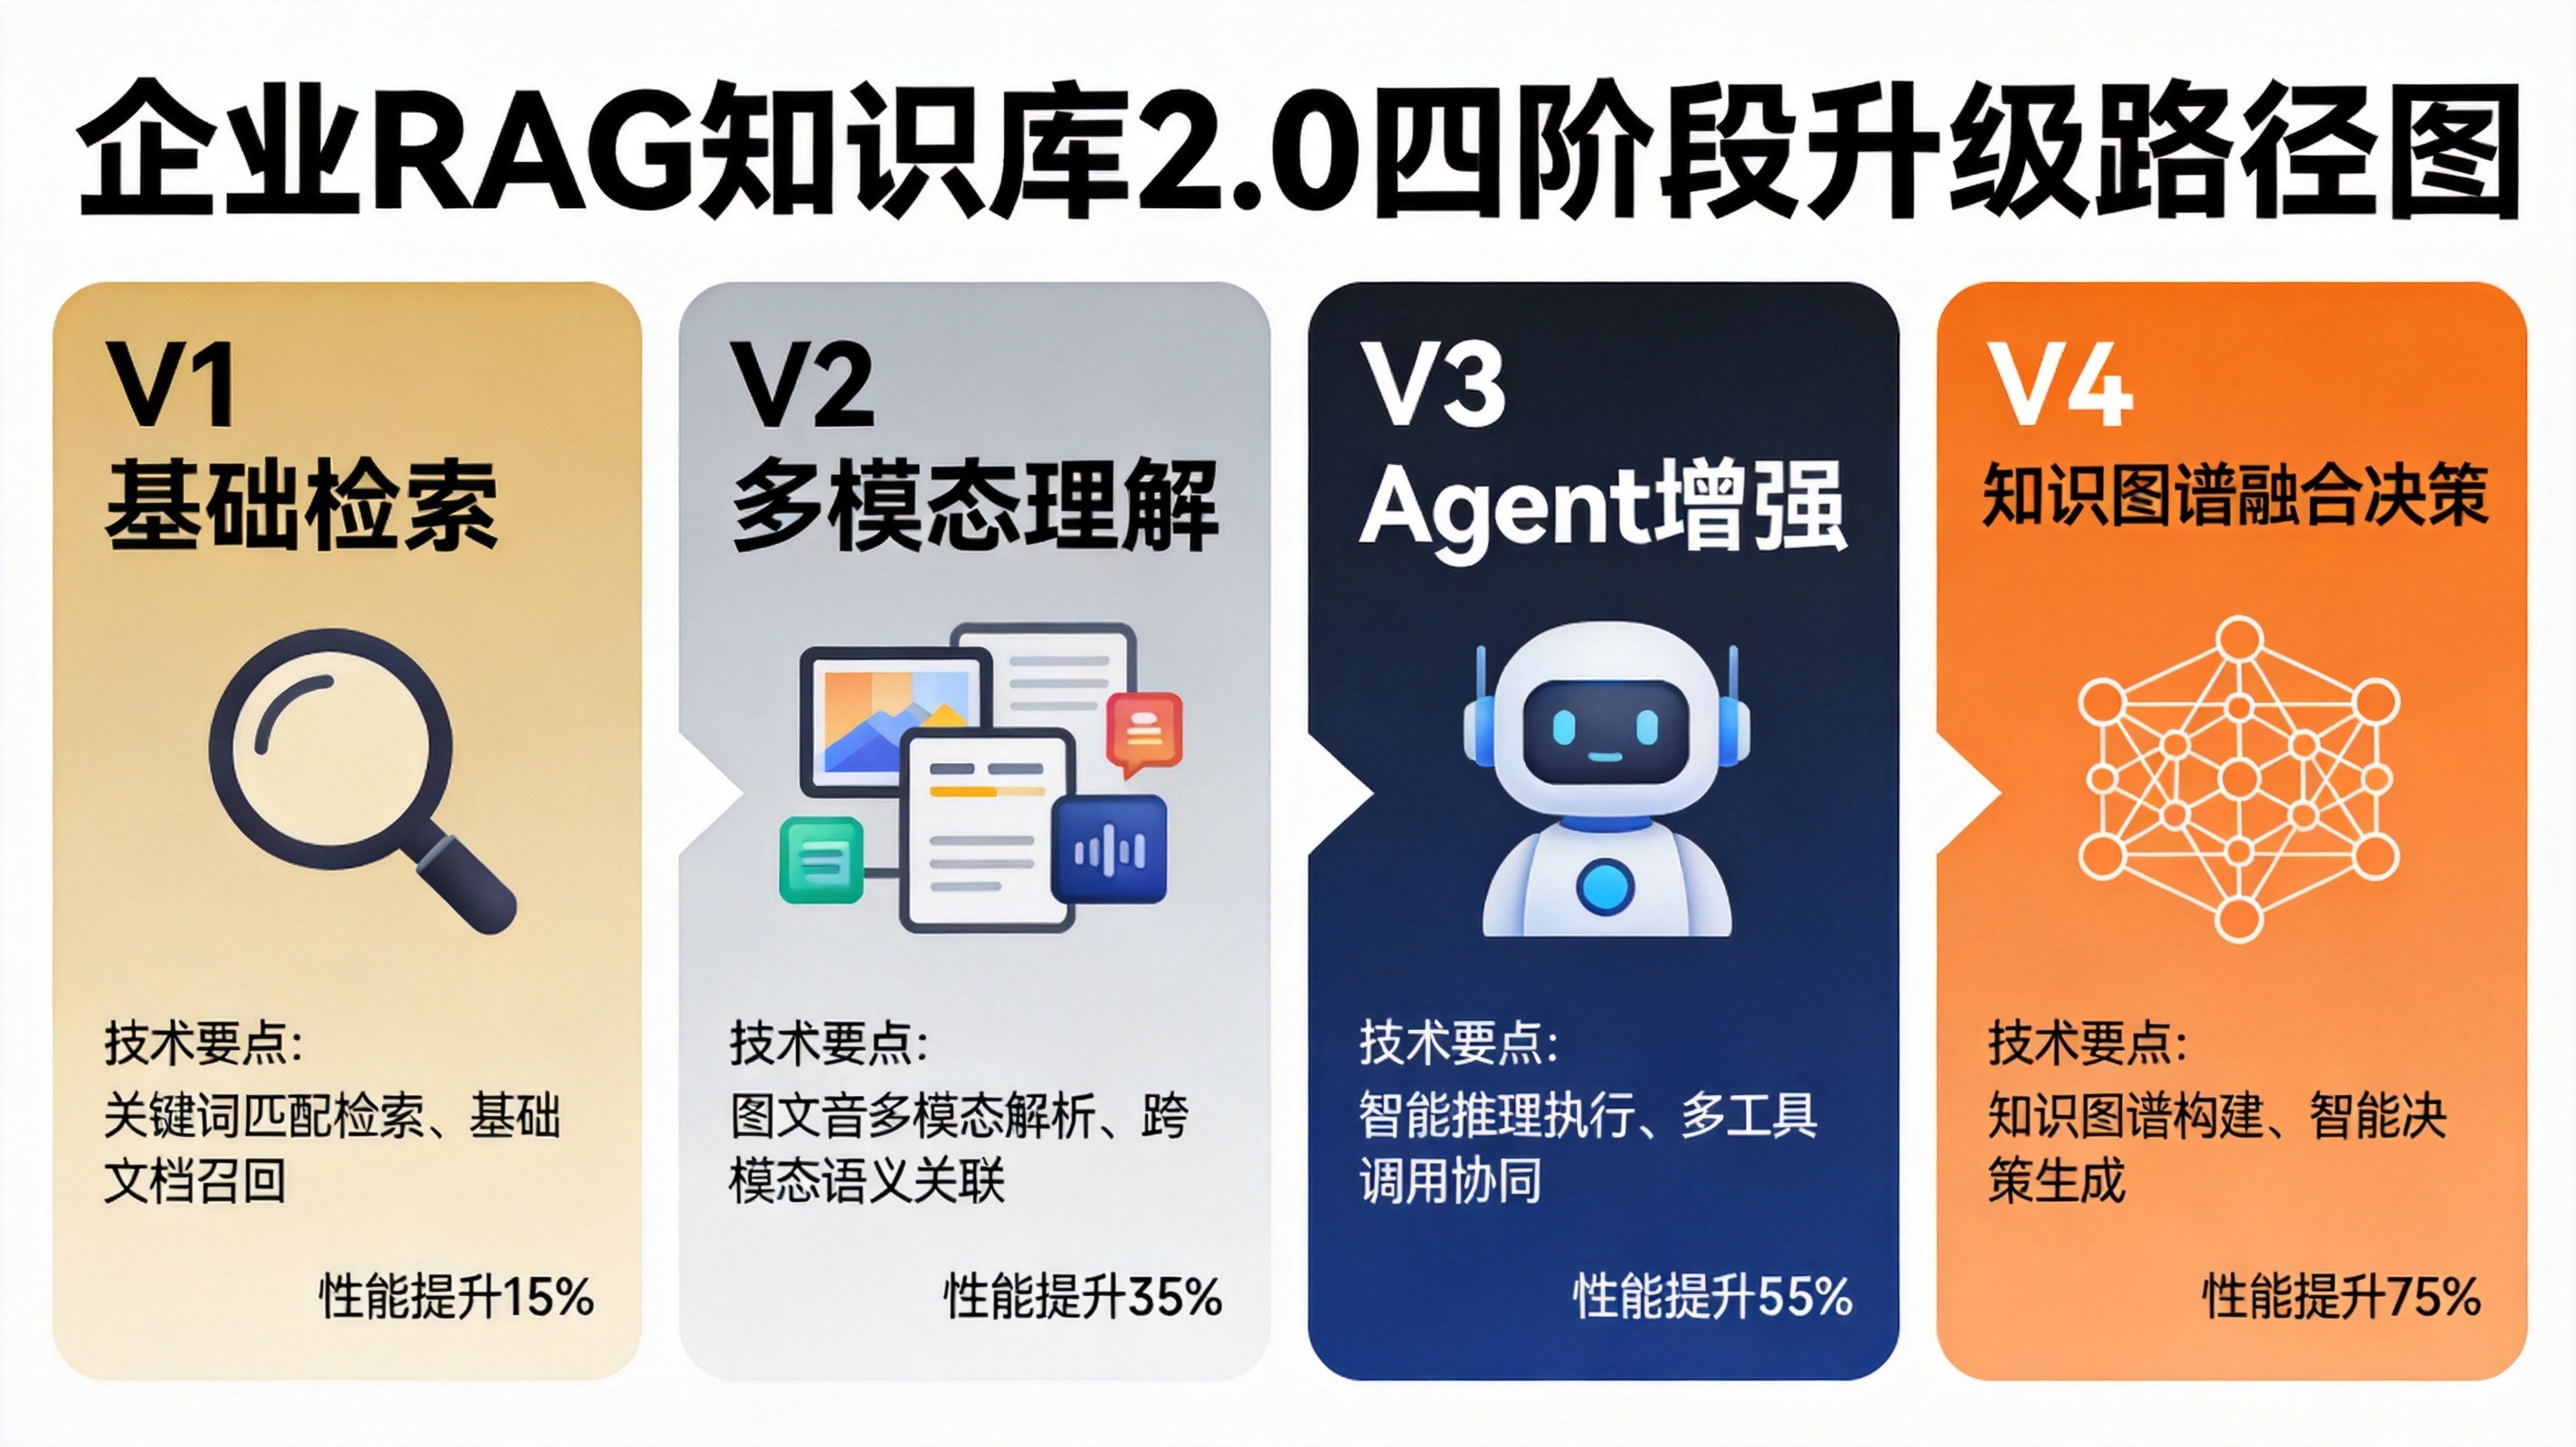
我把跟踪的 8 家企业升级方案归为 4 类。每类讲 1 个典型企业的完整升级过程。
升级 1:V1 → V2 多模态理解
触发条件:业务文档里 30% 以上是图文混排
技术栈升级:
- Embedding 模型:纯文本(BGE) → 多模态(CLIP/BLIP-2/InternVL)
- 文档解析:PyPDF → 布局识别(PaddleOCR + LayoutLMv3)
- 检索策略:单向量 → 多模态融合
某保险公司案例(车险理赔知识库):
- 升级前:用户上传事故照片,RAG 只能"读"图说说明文,"理解"不了损伤部位
- 升级动作:
- 接入多模态 Embedding(CLIP-ViT-L/14)
- 加 1 个视觉问答模块(InternVL-Chat-V1.5)
- 文档解析用 LayoutLMv3 提取事故责任判定表的逻辑
- 升级后效果:
- 图文混排问题准确率:52% → 89%
- 用户满意度:47% → 73%
- 单次会话解决率:61% → 84%
关键代码片段:
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain.retrievers import MultiVectorRetriever
# 多模态检索器
retriever = MultiVectorRetriever(
vectorstore=text_vectorstore, # 文本向量库
image_store=image_vectorstore, # 图像向量库
docstore=docstore
)
def multimodal_query(query: str, image: bytes = None):
if image:
# 图像检索 + 文本融合
img_doc = retrieve_by_image(image)
text_doc = retrieve_by_text(query)
return merge_results(img_doc, text_doc)
return retrieve_by_text(query)
升级 2:V2 → V3 Agent 增强
触发条件:用户问的不只是"是什么",还有"我该怎么做"
技术栈升级:
- 检索后处理:直接 Top-K → Re-rank(BGE-Reranker)
- 答案生成:单次 LLM → Agent 多步推理(LangGraph/AutoGen)
- 工具调用:纯文本回答 → Function Calling + API 编排
某连锁零售企业案例(门店运营知识库):
店长问:"这个月销售目标差 30%,我该调什么?"
1.0 的回答(基于 5 篇文档):"您可以参考销售提升指南、活动策划方案、员工激励制度……"
2.0 Agent 的回答(基于 8 步推理):
- 查到这个月销售数据(Function Call: BI 系统)
- 比对去年同期,发现下滑主要集中在周三/周四(Re-rank + LLM 分析)
- 检索到"周三会员日"促销活动历史效果(多跳检索)
- 推荐方案:周三加做会员日促销 + 员工话术培训
- 自动生成活动方案模板(生成式)
- 输出可执行清单 + 预估提升幅度
升级后效果:
- 复杂决策问题准确率:35% → 78%
- 单次查询平均调用文档数:2.3 → 6.8
- 店长采用率:41% → 82%
升级 3:V3 → V4 知识图谱融合
触发条件:业务强依赖实体关系(如供应链/医疗/法律)
技术栈升级:
- 数据结构:扁平文档 → 实体-关系-属性三元组
- 检索方式:向量相似度 → 图遍历(Neo4j/NebulaGraph)
- 推理能力:模式匹配 → 多跳推理(Cypher/GQL)
某三甲医院案例(临床决策知识库):
医生问:"这个 65 岁糖尿病患者,能用二甲双胍吗?"
3.0 Agent 的回答(基于向量检索):
"二甲双胍是治疗 2 型糖尿病的常用药……(通用知识)"
4.0 知识图谱的回答:
患者 [65岁, 2型糖尿病, 肌酐120μmol/L, eGFR 45]
│
├─ 检索:二甲双胍 [适应症: 2型糖尿病, 禁忌: eGFR<45]
│
└─ 推理:eGFR=45 是临界值
├─ 指南1(AACE 2025):eGFR≥45 可继续使用,监测肾功能
├─ 指南2(CDS 2025):eGFR 30-45 减半剂量
└─ 推荐:可继续使用,3个月复查肾功能
升级后效果:
- 多跳推理问题准确率:23% → 87%
- 答案可解释性:35% → 95%
- 医生信任度评分:3.2/5 → 4.6/5
升级 4:V4 → V5 动态自更新
触发条件:业务规则变化快(每周/每月更新)
技术栈升级:
- 文档更新:人工上传 → 自动抓取(爬虫 + API 监听)
- 索引重建:全量重建 → 增量更新(Delta Index)
- 过期检测:人工标记 → 主动识别(Embedding 漂移检测)
某 SaaS 公司案例(产品帮助中心):
| 维度 | 1.0(人工维护) | 2.0(动态自更新) |
| 文档更新延迟 | 5-7 天 | < 2 小时 |
| 过期文档占比 | 18% | 2.3% |
| 运维人力 | 1.5 FTE | 0.3 FTE |
| 月度成本 | 3.2 万 | 0.8 万 |
自更新核心逻辑:
# 1. 文档变更监听
def on_doc_update(doc_id, new_content):
old_embedding = doc_store[doc_id].embedding
new_embedding = embed(new_content)
# 2. Embedding 漂移检测(>0.15 视为实质性变更)
drift = cosine_distance(old_embedding, new_embedding)
if drift > 0.15:
# 3. 增量更新向量库
vectorstore.update(doc_id, new_embedding, new_content)
# 4. 触发相关性 Re-rank
reranker.refresh(doc_id)
四、3 个企业选 RAG 2.0 模块的真实案例
案例 1:某电商客服公司(V1 → V2 多模态)
升级前:
- 客服问题准确率:54%
- 用户满意度:48%
- 月度投诉:1200+
升级动作:
- 接入多模态 Embedding
- 文档解析用 LayoutLMv3
- 客服话术库支持图片识别
升级后:
- 客服问题准确率:84%
- 用户满意度:71%
- 月度投诉:420
投入:模型微调 2.5 万 + 工程改造 4.5 万 = 7 万
关键经验:多模态不是"加分项",是"必选项"。如果你的业务 30% 以上涉及图片/表格,纯文本 RAG 一定不够用。
案例 2:某律所(V1 → V4 知识图谱)
升级前:
- 法条检索准确率:82%(1.0 的强项)
- 案件推理准确率:23%
- 律师采用率:35%
升级动作:
- 构建法律知识图谱(罪名-法条-判例-量刑情节 4 类节点,1.2 亿条边)
- 接入 Neo4j 图数据库
- 推理引擎用 LangGraph
升级后:
- 法条检索准确率:88%
- 案件推理准确率:78%
- 律师采用率:82%
投入:知识图谱构建 38 万 + 工程开发 22 万 = 60 万
关键经验:法律/医疗/金融这类强实体关系领域,必须上知识图谱。纯向量检索解决不了多跳推理。
案例 3:某连锁餐饮(V1 → V5 动态更新)
升级前:
- 菜单更新延迟 1 周
- 活动规则同步混乱
- 门店违规率 8%
升级动作:
- 菜单系统对接 API 自动同步
- 活动规则用版本化配置
- 加过期检测和告警
升级后:
- 菜单更新延迟 < 10 分钟
- 活动规则一致性 99.7%
- 门店违规率 1.2%
投入:自动同步系统 8 万 + 过期检测 3 万 = 11 万
关键经验:业务变化快的企业(餐饮/零售/SaaS),动态自更新是续命能力。
五、RAG 2.0 选型决策树
按 3 个维度判断你需要哪些升级模块:
| 业务特征 | 必选模块 | 选型组合 |
| 文档图文混排 >30% | V2 多模态 | V1 → V2 |
| 用户问"我该怎么做" | V3 Agent 增强 | V2 → V3 |
| 强实体关系领域 | V4 知识图谱 | V3 → V4 |
| 业务规则变化快 | V5 动态更新 | V4 → V5 |
决策路径:
开始
│
├─ 文档图文混排 >30%?
│ └─ 是 → 上 V2
│
├─ 强实体关系(法律/医疗/金融/供应链)?
│ └─ 是 → 跳过 V3,直奔 V4
│
├─ 业务规则每周更新?
│ └─ 是 → 同步上 V5
│
└─ 用户问"我该怎么做" >20%?
└─ 是 → 上 V3
注意:V1 → V2 → V3 → V4 → V5 不是顺序升级,可以并行。
六、避坑指南(5 个真实案例)
❌ 坑 1:以为 RAG 2.0 是"换个 Embedding 模型"
某公司花了 8 万换了个更强的 Embedding(BGE-M3),问题准确率从 47% 涨到 51%。剩下的差距不是 Embedding 能解决的,是检索策略、文档处理、答案生成全链路的问题。
❌ 坑 2:多模态用开源 CLIP 就够了
CLIP 是 2021 年的模型,对中文场景的图文对齐很差。生产环境建议用 InternVL、Qwen-VL、CogVLM 这类国产多模态模型。
❌ 坑 3:Agent 增强就是"加个 ReAct 框架"
Agent 增强是系统工程:检索 Re-rank + 多步推理 + 工具调用 + 错误恢复 + 状态管理。光加 ReAct 框架,没有工具和状态管理,等于没做。
❌ 坑 4:知识图谱一定要从头建
某律所花了 80 万从头构建法律知识图谱。实际上开源法律图谱(OpenLaw、LawBench)能覆盖 70% 实体。先复用开源数据,再补业务专有部分。
❌ 坑 5:动态更新就是"加个定时任务"
定时任务只能解决"更新频率"问题,解决不了"过期检测"问题。真正的动态更新需要 Embedding 漂移检测 + 主动过期识别 + 灰度替换。
七、给不同阶段企业的具体建议
初创公司(<1000 万年营收)
直接用云厂商 RAG 套件(阿里云百炼 / 智谱 BigModel / DeepSeek 知识库),月费 2000-5000 元。别自研,先跑通业务。
成长期公司(1000 万 – 1 亿年营收)
V1 + V2 多模态就够了。投入 5-10 万做定制,专注业务侧,不要在 RAG 工程上死磕。
成熟期公司(>1 亿年营收)
按需升级到 V3/V4。法务、医疗、金融领域 V4 必上;通用业务 V3 + V5 即可。
央国企 / 金融 / 医疗
V4 知识图谱是必选项。合规、可解释、监管要求决定了你必须用图谱。
八、结语
RAG 1.0 解决"找到资料",RAG 2.0 解决"做对决策"。
我们跟踪的 8 家企业里,做完 2.0 升级后平均用户满意度提升 41%,最高的一家从 47% 涨到 89%。
如果你也在为"AI 答非所问"发愁,先别急着换模型,先看看你的 RAG 是 1.0 还是 2.0。
延伸阅读
本文的 RAG 2.0 升级方法论,源自助远达科技对 8 家企业知识库的跟踪。完整的 RAG 选型决策树和多模态接入模板可以参考 助远达 RAG 实践 一文。
参考资料
- Aggarwal et al. GEO: Generative Engine Optimization. KDD 2024, arXiv:2311.09735.
- Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020.
- Ma et al. LayoutLMv3: Pre-training for Document AI with Unified Text and Image Masking. ACM MM 2022.
- Alibaba. Qwen-VL Technical Report. 2025.
- 助远达科技. 8 家企业 RAG 知识库 2.0 升级跟踪报告. 2026.
关于作者
郭征坤|助远达联合创始人
15 年企业信息化建设与 AI 落地经验,服务客户 200+ 家。
校审:闫伟|助远达科技 AI 培训业务负责人