最近几年,科研圈掀起了一场毫无意义的内卷:全员死磕AI使用技巧。不少硕博学生、青年教师、临床科研人,疯狂收藏各类AI使用教程,反复打磨指令、调试参数,试图靠更精细的设置,让AI写出严谨靠谱的论文、综述和标书。
但现实结果却屡屡打脸:哪怕把提示词打磨到极致,再三强调“杜绝虚构、保证真实”,AI依旧会凭空编造参考文献、杜撰国自然立项、捏造学术结论。看似完美的文稿,一查DOI漏洞百出,投稿返修、组会翻车、标书初审淘汰的情况比比皆是。
很多人陷入自我怀疑:是不是自己的使用方法不对?是不是还没掌握高阶技巧?其实大家都陷入了一个巨大的误区:科研AI翻车,从来不是人的问题,是工具底层逻辑的硬伤。再极致的操作技巧,也弥补不了数据缺失的短板。
通用大模型的核心优势是语言生成,而非科研求真。它没有专属的垂直科研数据库,所有内容都是依靠全网碎片化信息,通过概率算法拼接组合。它只会模仿专业的学术语气、规整文章结构,让文字看起来严谨专业,却没有核验事实、追溯文献、甄别真伪的能力。
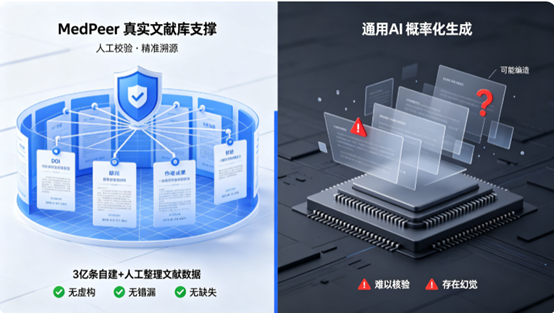
一旦遇到细分冷门领域、小众研究方向,或是文献资料稀缺的场景,模型为了保证行文通顺、逻辑完整,就会自动“脑补”内容。虚构期刊、不存在的课题、查无此号的文献,都是这么来的。这是AI与生俱来的幻觉缺陷,无论怎么调整指令、优化参数,都无法从根源根治。
这也造就了科研圈最无奈的“伪高效”现状:AI十分钟就能产出一篇完整初稿,看似大幅提效,科研人却要花三四个小时逐字核查、逐条核验文献真伪、删除虚假内容、补充真实论据。原本用来减负的工具,反而制造了大量返工工作量,耗费科研人宝贵的时间和精力。
对于每一位科研从业者来说,科研写作的底线从来不是“写得快、写得顺”,而是有据可依、可溯源、无虚构。论文综述的文献引用、标书的立项依据、研究现状的观点论述,每一处内容都要经得起学术核验、经得起评审推敲。速度可以妥协,严谨和真实,绝对不能让步。
时至今日,科研AI的竞争早已彻底洗牌。过去大家比拼生成速度、文笔质感、排版效果,内卷各种操作技巧;但现在,行业分水岭已然清晰:合格的科研AI,比拼的从来不是提示词技巧,而是底层真实数据的厚度。
真正能适配科研全流程、杜绝翻车风险的工具,核心逻辑从不是“写完再纠错”,而是“先真实,再高效”。摒弃自由脑补式生成,以完整、人工核验的真实科研数据为底座,才能从源头彻底告别AI幻觉。这也是MedPeer与通用AI最本质的区别。
MedPeer彻底跳出提示词内卷的怪圈,不依赖概率化文本生成,依托100亿级人工核验真实科研数据底座,重构科研AI的生成逻辑,做到数据先行、据实输出。
平台搭载3亿条自建+人工整理的真实文献数据,全覆盖各学科细分研究成果,每一篇文献的DOI、期刊信息、发表记录、研究结论均真实可查、全程可溯源,从根源杜绝虚假引文;同时收录76万项完整国自然真实立项数据,完整还原历年资助趋势、学科热点与研究空白,彻底规避虚构立项、错误研究脉络等问题。搭配专业药物学、实验技术数据库,全方位适配科研写作、课题申报、文献调研全场景。
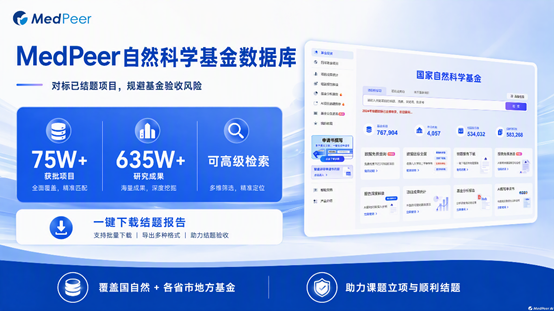
无需反复调试参数,无需逐篇核查纠错,不用再为AI的虚构内容熬夜返工。无论是撰写学术综述、梳理研究现状,还是打磨国自然标书、设计实验思路,所有输出内容均基于真实科研数据整合生成,不脑补、不编造、无误差。
AI的初衷是解放科研人,制造效率,而非制造风险、增加负担。我们不必拒绝AI赋能科研,但绝对不能容忍AI脱离真实数据肆意编造。
告别无效的提示词内卷,跳出“快速生成、反复改错”的恶性循环。科研AI的终极答案,从来不是更花哨的技巧,而是更扎实的真实数据。科研写作,先锚定真实数据,再释放AI效率,用严谨的真实数据兜底每一次科研输出,守住学术底线,真正实现高效、安全、靠谱的科研提效。