目录
1 核心要点
2 标准回答
2.1、瓶颈来源
2.2、核函数近似
2.3、结合律重排
2.4、代价与定位
3 疑问:线性注意力在自回归生成时还能保持 O(1) 每步吗?为什么
参考文献:
abstract:
用核函数近似softmax,结合律降低计算复杂度。 把大模型处理长文本的时间复杂度,从“平方级爆炸” (O(N^2)) 降低到“线性增长” (O(N))。
缓存历史state,decode 逐步累加。不缓存k v
1 核心要点
-
标准注意力先算 QKᵀ 得 n×n 矩阵,复杂度 O(n²d),长序列成本爆炸
-
用核函数 φ 近似 softmax,把相似度写成 φ(Q)·φ(K) 的内积
-
借结合律先算 φ(K)ᵀV(d×d),再乘 φ(Q),避免显式 n×n 矩阵,降到 O(n)
-
代价:丢失 softmax 的精确归一化,表达力/精度有损,长程精确检索变弱
2 标准回答
2.1、瓶颈来源
标准自注意力计算 softmax(QKᵀ)V。先算 QKᵀ 会得到一个 n×n 的注意力矩阵,复杂度和显存都是 O(n²),序列一长就成为瓶颈。
2.2、核函数近似
softmax 本质是衡量 query 与 key 的相似度。线性注意力用一个特征映射 φ(核函数,如 elu+1)把相似度近似为 φ(Q) 与 φ(K) 的内积,即去掉了 softmax 中不可分解的指数归一化。
2.3、结合律重排
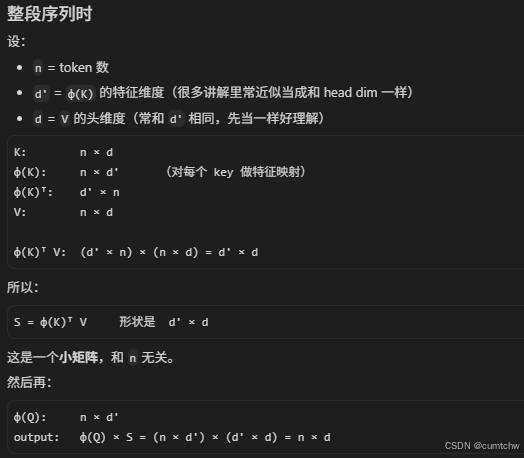
去掉 softmax 后,输出 ≈ φ(Q)·(φ(K)ᵀV)。利用矩阵乘法结合律,先计算 φ(K)ᵀV 得到一个 d×d 的小矩阵,再左乘 φ(Q),整体复杂度变为 O(n·d²),对序列长度 n 是线性的,也无需存储 n×n 矩阵。
面试里可以补一句:线性注意力如何把注意力复杂度降到 On 在大模型场景下通常要同时权衡效果、延迟、成本和安全边界。回答时最好带一个例子,比如上下文过长、幻觉、缓存命中或工具调用失败时,系统应该如何降级和观测。
2.4、代价与定位
牺牲了 softmax 的精确归一化和尖锐注意力分布,表达力与精度有损,在需要精确长程检索的任务上往往不及标准注意力;常与门控、衰减等机制结合(如 RetNet、GLA)改善。详见 线性注意力架构演进。
3 疑问:线性注意力在自回归生成时还能保持 O(1) 每步吗?为什么
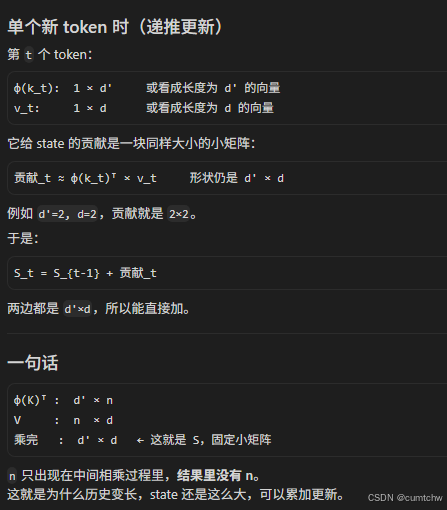
可以。把 φ(K)ᵀV 视作一个可累加的状态(类似 RNN 隐状态),每生成一个 token 只需用新 token 更新这个固定大小的状态,再与 φ(q) 相乘得到输出,每步 O(1)、无需缓存全部 KV。这也是它与 SSM/RNN 思路相通之处。
那么为什么,推导如下
看完了上面的解释没理解,然后我想了下,这其实跟矩阵乘法过程有关系,
其实就算是重新计算,比如把这个新的token重新计算成一个(n+1) xd的大矩阵,然后重新计算,那么效果跟求出前面n的矩阵,然后单独加上贡献_t ≈ φ(k_t)ᵀ × v_t 是一样的效果,因为如果是根据新增的token生成一个大的(n+1)矩阵,那么 d' × (n+1)里面,新token的也是在最后一列,然后新的V, (n+1) xd,新token对应的其实就是在最后一行,那么矩阵乘法其实就还是在过程中每个位置都加上了新token自身的乘积,因为就是最后一列正好跟最后一行相乘的,
S_{n+1} = φ(K_{1:n+1})ᵀ × V_{1:n+1} = 第1列×第1行 + 第2列×第2行 + … + 第n列×第n行 + 第(n+1)列×第(n+1)行 = S_n + φ(k_{n+1})ᵀ × v_{n+1}
参考文献:
线性注意力如何把注意力复杂度降到 O(n)? | AI 面试题 | AI Master
AI核心知识94——大语言模型之 Linear Attention Mechanism(简洁且通俗易懂版)_simplified linear attention mechanism.-CSDN博客