背景引入
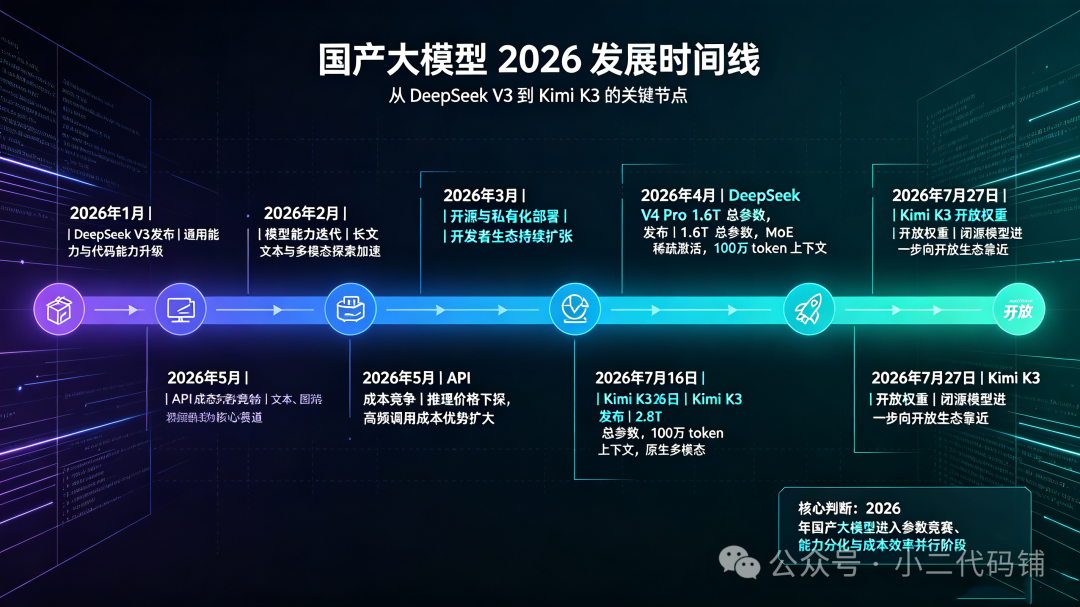
2026年7月,国产大模型迎来最密集的一次出牌。
7月16日,月之暗面正式发布 Kimi K3,一夜之间刷屏技术圈。几乎同一时间段,DeepSeek V4 Pro 持续发力,凭借极致性价比和开源策略继续攻城略地。两款模型在编程榜单上先后刷新记录,在 API 价格上形成鲜明对比,在开源策略上也走向了殊途同归。
这不是一场普通的模型发布,而是一次正面交锋——国产大模型第一次在全球开发者视野里,以"竞争威胁"的姿态出现。
为什么这场对决值得关注?
三个关键词:
- 编程能力:两款模型都在编程榜单上打出了历史级分数,直接威胁 GPT-5 家族的地位;
- API 成本:两者价差约 10 倍,背后是截然不同的商业策略;
- 开源策略:DeepSeek 从一开始就走开源路线,Kimi K3 在 7 月 27 日开放权重,双双选择开源,意味着开发者可以本地部署、自由定制。
对于每天和代码打交道的开发者来说,选对模型直接关系到开发效率和产品成本。这篇文章,我们把参数、价格、架构、实测数据全部摊开,帮你做出理性决策。
一、基础参数速览
先把硬数据摆出来,直观感受两款模型的定位差异:
|
发布时间 |
2026年4月 |
2026年7月16日 |
|
总参数量 |
1.6T(万亿) |
2.8T(万亿) |
|
激活参数 |
49B(MoE稀疏激活) |
未公开 |
|
上下文窗口 |
100万 token |
100万 token |
|
最大输出 |
384K token |
128K token |
|
多模态 |
宣称支持(实际不稳定) |
原生支持(文本+视觉+视频) |
|
开源策略 |
MIT 协议,已开源 |
7月27日开放权重 |
|
API 输入价格 |
~2元/百万 token |
~20元/百万 token |
|
API 输出价格 |
~8元/百万 token |
~100元/百万 token |
几个关键解读:
参数不等于体验。 Kimi K3 总参数量 2.8T,比 DeepSeek V4 Pro 的 1.6T 多出近一倍,但 DeepSeek V4 Pro 采用 MoE(混合专家)架构,激活参数仅 49B,用更少的激活参数实现高效推理。打个比方:K3 像一台大排量越野车,DS V4 Pro 像一台调校精良的小钢炮——排量小不代表跑得慢。
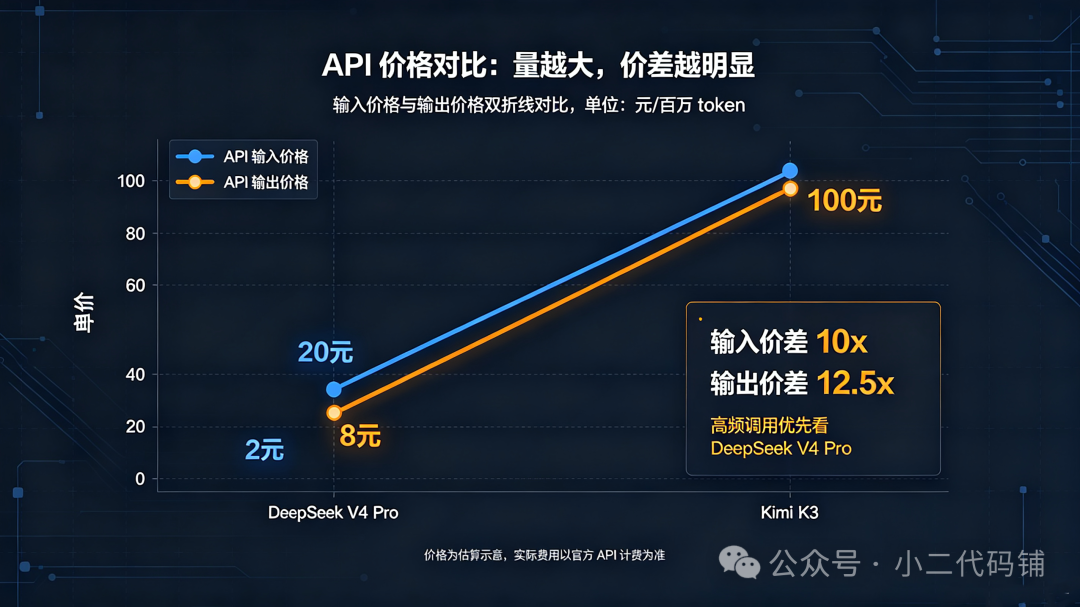
价格差距触目惊心。 输入价格差 10 倍,输出价格差超过 12 倍。如果你的场景每天调用量达到百万 token 级别,这个差距会直接体现在月度账单上。
最大输出差异值得注意。 DeepSeek V4 Pro 最大输出 384K token,几乎是 Kimi K3(128K)的三倍。如果你需要一次生成超长上下文内容,这个差异会直接影响使用体验。
多模态能力是分水岭。 Kimi K3 原生支持文本+视觉+视频统一处理,DeepSeek V4 Pro 虽然宣称支持多模态,但实测稳定性不足。这一维度两者差距明显。
二、编程能力实测对比
这是两款模型最核心的战场,也是开发者最关心的维度。先看榜单成绩,再看真实场景。
主流 Benchmark 成绩
Kimi K3 编程成绩:
|
Program Bench |
77.8分 |
超过 GPT-5.6 Sol 的 77.6 |
|
FrontierSWE |
81.2分 |
大幅领先 GPT-5.6 Sol 的 71.3(+10分) |
|
Terminal Bench |
88.3分 |
与 GPT-5.6 Sol 差距仅 0.5分 |
中信建投在评测报告中直接用词:K3 是"另一个 DeepSeek 时刻"——上一次国产模型让全球技术圈震动,是 DeepSeek V3 发布的时候。这一次,K3 第一次以"竞争威胁"的身份进入全球大模型叙事。
DeepSeek V4 Pro 编程成绩:
|
LiveCodeBench |
93.5% |
超越 Claude Opus 4.6 |
|
SWE-bench Verified |
58.2% |
V3 从 42.0% 提升至此(+16分) |
|
HumanEval |
93.5% |
持平主流顶级模型 |
|
价格 |
— |
仅为 GPT-5.5 的 1/70 |
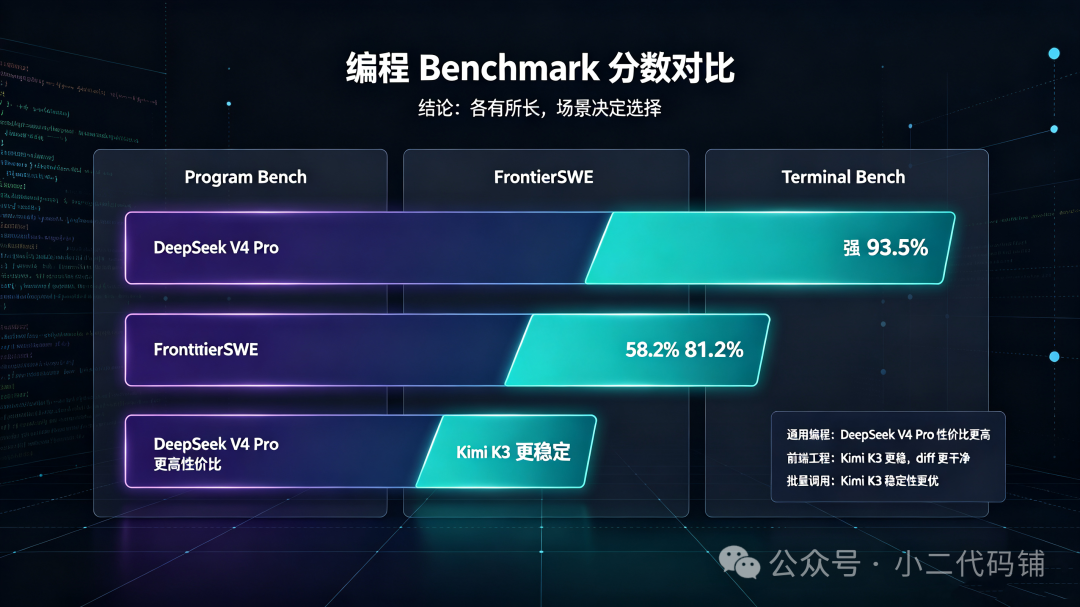
数据放在一起,有个细节值得玩味:两个模型的强项榜单不同。K3 在 Fronti erSWE(软件工程真实任务)和 Terminal Bench(命令行场景)上更强,DeepSeek V4 Pro 在 LiveCodeBench 和 HumanEval(算法/代码补全场景)上更强。这不是巧合,而是架构设计取向的体现。
小二实测:真实任务才是试金石
榜单分数是参考,真实任务才是考验。这里引用腾讯云文章中披露的实测案例,一个很有代表性的场景:
任务:给流程设计器的条件规则加上"周/月"日期类型支持,涉及 3000 行前端页面组件 + 后端日期字段解析逻辑联动。
这是典型的前端+后端联动任务,需要模型理解现有代码结构、找到正确的修改位置、同时保证前后端一致性。
Kimi K3 的表现:
自己理清代码结构(没有要求额外说明)
精准定位关键映射逻辑
前后端一起改
顺手修了两个隐藏的边界 bug
第五点尤其重要。多数模型在处理这类任务时,容易"过度发挥"——改一堆不相关的内容,或者在 diff 里塞入格式修改、注释变更等噪音。K3 的 diff 干净度说明它在理解任务边界上下了功夫。
DeepSeek V4 Pro 的表现:
同一个任务,DeepSeek V4 Pro 不是做不到,而是稳定性不够。同一条任务多次调用,结果有一定波动——有时完美,有时需要微调。这种不稳定性在高强度 Agent 调用场景下会被放大:自动化流程中,一次意外的错误输出可能导致整个链路失败。
结论:各有所长,场景决定选择
|
代码补全/算法题 |
更强(LiveCodeBench 93.5%) |
强 |
|
前端页面级联修改 |
稳定性不足 |
稳定,diff 干净 |
|
软件工程真实任务 |
SWE-bench 58.2% |
FrontierSWE 81.2%(更优) |
|
批量调用稳定性 |
有波动 |
更稳定 |
|
性价比 |
极高 |
较高 |
一句话总结: 前端编程任务选 Kimi K3 更稳,通用编程任务选 DeepSeek V4 Pro 性价比更高。
三、价格与成本对比
开发者选模型,价格不是唯一维度,但永远是现实约束。这里把账算清楚。
绝对价格对比
|
API 输入 |
~2元/百万 token |
~20元/百万 token |
|
API 输出 |
~8元/百万 token |
~100元/百万 token |
|
成本比(输入) |
1x |
10x |
|
成本比(输出) |
1x |
12.5x |
价格差距是客观存在的,但需要结合使用场景理性看待。
峰谷计费:DeepSeek V4 Pro 的创新
DeepSeek V4 Pro API 首次引入峰谷计费机制:
- 平时(低谷期)
:0.87 美元/百万输出 token
- 高峰期
:1.74 美元/百万输出 token
这意味着如果你的调用量集中在非高峰时段,实际成本可以再降一半。对于有固定调度任务的 Agent 系统(比如每天凌晨的批量数据处理),峰谷计费是实打实的省钱机会。
选型建议:按场景对号入座
|
高频 Agent 调用(日均千万 token+) |
DeepSeek V4 Pro |
10 倍价格差,量越大省得越多 |
|
对质量要求高的单次任务 |
Kimi K3 |
编程稳定性优势明显,多花的钱买的是省心 |
|
长文本处理(接近 100 万 token) |
两者均支持 |
但 DeepSeek V4 Pro 输出上限更高(384K vs 128K) |
|
多模态任务(图片+视频理解) |
Kimi K3 |
DeepSeek 多模态稳定性不足 |
|
预算有限/个人开发者 |
DeepSeek V4 Pro |
开源免费部署,零 API 成本 |
|
需要本地部署/数据不出域 |
DeepSeek V4 Pro |
MIT 协议,本地部署无忧 |
|
需要稳定批量输出(自动化流水线) |
Kimi K3 |
稳定性更好,降低人工 review 成本 |
四、技术架构差异
两款模型的架构选择,代表了两种不同的技术路线。理解架构,能帮你判断未来能力边界。
DeepSeek V4 Pro:效率优先的 MoE 路线
核心架构:MoE(混合专家)+ MLA
DeepSeek V4 Pro 采用 1.6T 总参数、49B 激活参数的 MoE 架构。MoE 的核心思想是"专业分工"——模型包含大量"专家"网络,每次推理只激活与任务最相关的少数专家,从而用更少计算量实现更强能力。
49B 的激活参数在 MoE 模型中属于相对克制的选择,带来的好处是推理成本可控。相比 Kimi K3 2.8T 的总参数量(激活参数未公开,但预计远高于 49B),DeepSeek V4 Pro 在推理效率上有结构性优势。
MLA(多头潜在注意力):这是 DeepSeek 系列模型的标志性技术创新。MLA 将 KV Cache 压缩至 V3.2 版本的 10%,这意味着在长上下文场景下,显存占用大幅降低,推理速度更快。对于需要处理长文档、长代码库的开发者,这个优化是实打实的体验提升。
FP8 混合精度训练:通过降低训练精度换取训练效率,DeepSeek V4 Pro 在国产算力平台上完成训练验证,不依赖单一 NVIDIA 生态。对于有国产化诉求的企业,这是一张重要底牌。
Engram 技术:DeepSeek 提出的记忆架构理念,75% 资源用于推理、25% 用于记忆。这意味着模型在长期对话和上下文累积场景下,有更好的记忆保持能力。
Kimi K3:性能上限优先的 Dense 路线
核心架构:Kimi Linear
Kimi K3 采用了自研的 Kimi Linear 架构,直面 Transformer 的计算瓶颈问题。Linear 架构的核心思路是打破标准 Transformer 中注意力机制的 O(n²) 计算复杂度限制,用线性注意力变体换取长序列处理效率。
从结果看,Kimi K3 在 FrontierSWE(软件工程任务)上的 81.2 分证明了这条路线的有效性——真实软件工程任务需要深度理解代码上下文和依赖关系,对长程依赖建模能力要求极高,K3 做到了。
分段注意力 + 语义压缩:Kimi K3 的长上下文处理策略采用分段注意力配合语义压缩,在保持理解深度的同时控制内存占用。100 万 token 的上下文窗口足够覆盖绝大多数实际场景。
原生多模态:这是 Kimi K3 相对于 DeepSeek V4 Pro 的明显优势。K3 从设计之初就将文本、视觉(图片)、视频统一纳入处理框架,没有后期打补丁的割裂感。对于需要同时处理产品截图、UI 设计稿、演示视频的开发者,K3 的多模态能力是刚需。
垂直领域知识深度:Kimi K3 在法律(500 万+ 判例)和医学(临床指南)领域做了深度知识增强。如果你的应用场景涉及专业文档处理,这个垂直深度可能比通用能力更重要。
架构对比小结
|
架构类型 |
MoE(稀疏激活) |
Dense/Liner(密集) |
|
注意力机制 |
MLA(KV Cache 压缩) |
分段注意力+语义压缩 |
|
训练精度 |
FP8 混合精度 |
未公开 |
|
多模态 |
宣称支持,稳定性不足 |
原生统一多模态 |
|
垂直领域 |
通用为主 |
法律+医学深度定制 |
|
算力依赖 |
国产平台验证 |
未公开 |
五、实测案例:给流程设计器加日期类型支持
这一节用一个具体任务,把两款模型的差异具象化。
任务描述:
给流程设计器的条件规则模块新增"周/月"日期类型支持。涉及约 3000 行前端 Vue 组件 + 后端 Java 日期解析逻辑,前端需要新增日期选择器组件,后端需要修改字段类型和校验逻辑,前后端通过接口字段联动。
这个任务的特点:
-
需要理解现有代码结构和命名规范
-
涉及多个文件的协同修改(前端组件 + 后端服务)
-
边界条件多(跨月、跨年、闰年、周起始日等)
-
改动必须精确,不能破坏现有功能
Kimi K3 的执行轨迹:
第1步:理解代码结构
→ 自动识别出条件规则的配置 Schema
→ 找到日期类型字段的定义位置
第2步:定位关键逻辑
→ 找到前端日期渲染和后端解析的映射关系
→ 发现现有逻辑只支持"日"粒度,需要扩展
第3步:前端修改
→ 新增 WeekMonthPicker 组件(约 200 行)
→ 修改规则配置面板,添加类型选项
→ 保持现有"日"类型完全兼容
第4步:后端修改
→ 修改字段类型,增加 dateGranularity 枚举
→ 更新校验逻辑,处理周/月边界的特殊情况
第5步:顺手修了两个隐藏 bug
→ 发现跨月时周数计算的 off-by-one 错误
→ 修复月末日期的时区偏移问题
结果:diff 干净,仅包含与任务相关的改动
DeepSeek V4 Pro 的表现:
同一条任务,DeepSeek V4 Pro 有能力完成,但多次调用结果有波动。具体表现:
-
有时能一次给出完整正确的方案
-
有时会在 diff 里夹带格式修改(空格、换行、import 顺序变更)
-
有时对边界条件的处理不够周全,需要二次 review
这种波动在单次调用场景下可以接受(反正还有人工 review),但在自动化流水线中会成为瓶颈:每个环节都需要加校验、重试机制,整体效率反而下降。
这个案例教会我们什么?
编程任务的"最后一公里"往往不是能力问题,而是稳定性问题。模型能不能稳定地输出高质量结果,比它能不能偶尔超常发挥更重要。对于需要集成到开发流水线的场景,Kimi K3 的稳定性优势值得多付那 10 倍价格。
六、选型决策树
理论说了一堆,来点实用的。直接对号入座:
你的首要需求是什么?
│
├─ 需要本地部署 / 数据不出域
│ └─ → DeepSeek V4 Pro(MIT 协议,直接用)
│
├─ 需要多模态(图片 / 视频理解)
│ └─ → Kimi K3(原生统一多模态,DeepSeek 暂不推荐)
│
├─ 每天调用量很大(百万 token 以上 / Agent 自动化)
│ └─ → DeepSeek V4 Pro(10 倍价格差,省下的都是利润)
│
├─ 对输出质量要求高,不能容忍波动
│ ├─ 前端级联修改 / 软件工程任务
│ │ └─ → Kimi K3(稳定性更好,diff 干净)
│ └─ 算法 / 代码补全
│ └─ → DeepSeek V4 Pro(LiveCodeBench 93.5%,性价比更高)
│
└─ 预算有限 / 个人开发者 / POC 阶段
└─ → DeepSeek V4 Pro(开源免费,POC 成本为零)
补充一条经验法则:
-
如果你的工作流是人机协作(人审查 AI 输出)→ 选 DeepSeek V4 Pro,省钱,偶有问题人工兜底
-
如果你的工作流是纯自动化(AI 输出直接进生产)→ 选 Kimi K3,多花的钱买的是稳定性保险
七、结论与展望
核心结论
|
能力差距 |
两者均在各自维度达到全球 Tier-1,编程能力不弱于 GPT-5 家族 |
|
价格差距 |
约 10 倍(API 成本),背后是商业策略而非能力差距 |
|
稳定性差距 |
Kimi K3 在前端/软件工程任务上更稳,DeepSeek V4 Pro 偶有波动 |
|
开源策略 |
两者均开源,开发者可以自由选择云端或本地 |
|
多模态 |
Kimi K3 明显领先,DeepSeek V4 Pro 仍有提升空间 |
2026 年下半年预测
多模态将成为标配:到 2026 年底,不支持原生多模态的大模型将失去主流竞争力。Kimi K3 的多模态优势窗口期大约还有 1-2 个季度。
价格战将持续:DeepSeek 证明了性价比路线的市场杀伤力,预计其他厂商会在未来几个季度跟进降价,API 成本将继续下探。
稳定性会成为新焦点:随着 Agent 化调用增多,模型输出的稳定性将从"nice to have"变成"must have"。这将是下一代模型竞争的核心维度之一。
开源生态进一步壮大:DeepSeek V4 Pro 和 Kimi K3 的开源策略,会催生大量基于两者做微调、精调的垂直领域模型。本地部署 + 微调,将成为企业级应用的主流形态。
写给开发者的话
这两款模型都值得认真对待。它们不是"二选一"的对立关系,而是"各有分工"的互补关系:
- DeepSeek V4 Pro
是你的性价比之选,适合高频调用、本地部署、预算敏感的场景;
- Kimi K3
是你的质量之选,适合对输出稳定性要求高的核心流程。
理解自己的场景,算清楚自己的账,比盲目追新更重要。
当别人在聊 AI 时,你在用 AI;当别人在学 AI 时,你在教 AI。我是小二,我们下期见。