7月27号,月之暗面把Kimi K3的模型权重全放出来了。2.8万亿参数,1040亿激活参数,100万token上下文窗口。全球首个开源3T级模型。
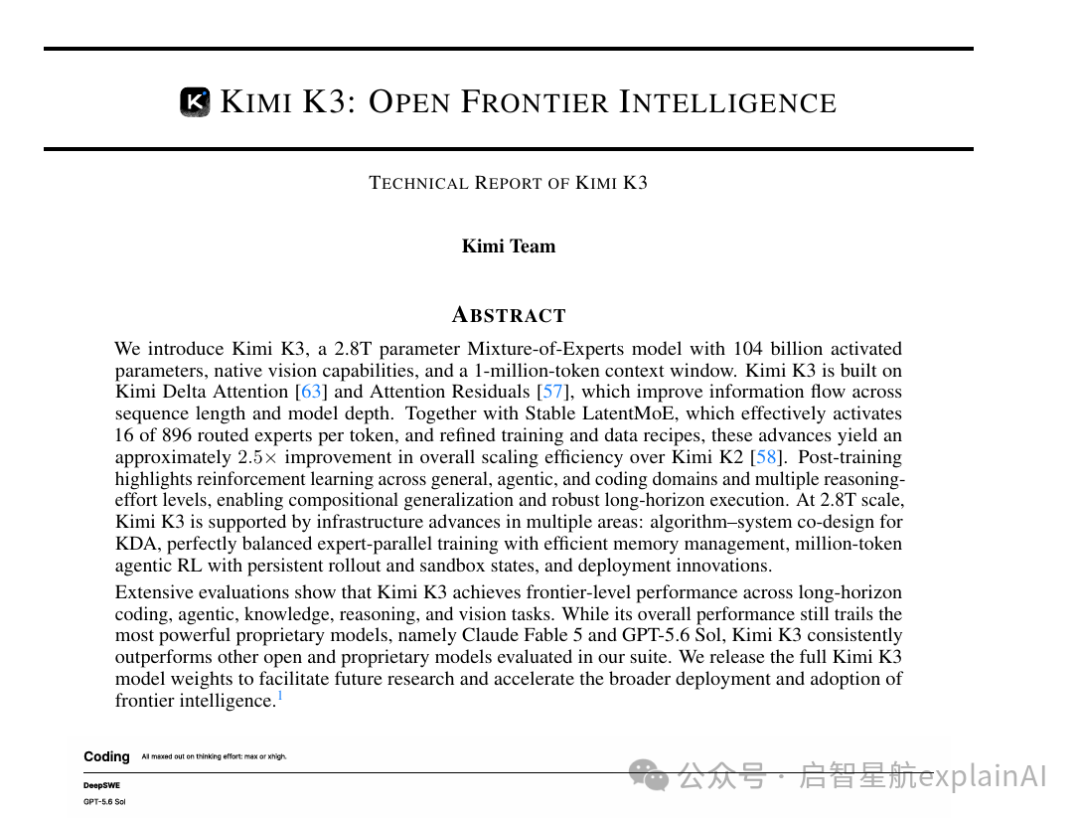 论文链接:https://arxiv.org/abs/2607.24653
刷到这个消息我愣了一下。不是因为数字本身,而是开源大模型之前好像集体卡在了一个看不见的天花板下面。推理能力、agent框架、强化学习这些方向跑得飞快,但参数规模基本卡在1T级别打转。闭源那边却在两条轴上同时加码,差距不是在缩小,是在拉大。
Kimi K3做的事情,就是同时推两条轴。预训练基础拉到2.8万亿参数是第一条轴,后训练RL覆盖通用、agent、编码三个域是第二条轴。开源不是追不上,是之前只追了一条路。
但2.8万亿参数的开源模型,第一个问题不是能不能打,是能不能跑。
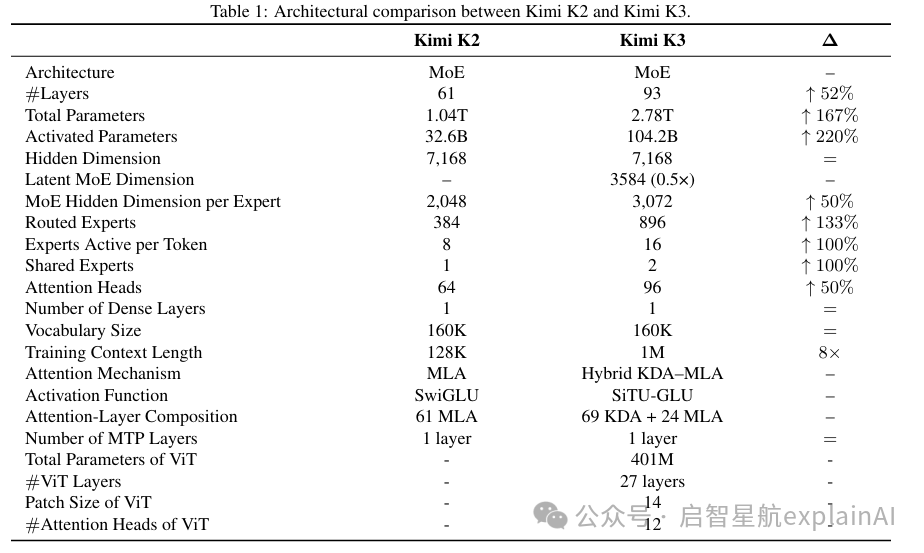
你想想看,2.8万亿参数的MoE模型,896个路由专家,每次激活16个,还要支持100万token的上下文。这个规模的开源模型,之前没人真正做过。训不训得起是一回事,训出来了能不能部署、能不能以合理成本提供服务,是另一回事。
所以我把整份技术报告拆了一遍,想搞清楚一个问题。Kimi K3凭什么让2.8万亿参数既训得起又跑得动。
答案的核心,是三个架构创新。报告里叫KDA、AttnRes、Stable LatentMoE,我管它们叫架构三件套。这三件套分别解决了序列、深度、宽度三个维度的信息流效率瓶颈,合在一起才换来了报告里那个2.5倍的scaling效率提升。
效率是贯穿全文的红线。我们顺着这条线往下拆。
架构三件套,各管一个维度
K3的架构设计,最巧妙的不是某个单独创新有多惊艳,而是它把信息流拆成三个维度对症下药。序列维度用Hybrid Attention,每block里3层KDA配1层Gated MLA。深度维度用Attention Residuals,让每层可以回头看前面任何一层的输出。宽度维度用Stable LatentMoE,896个专家激活16个,稀疏度56。
三个维度,三个瓶颈,三件套。2.5倍的scaling效率提升,是三件套合力的结果。
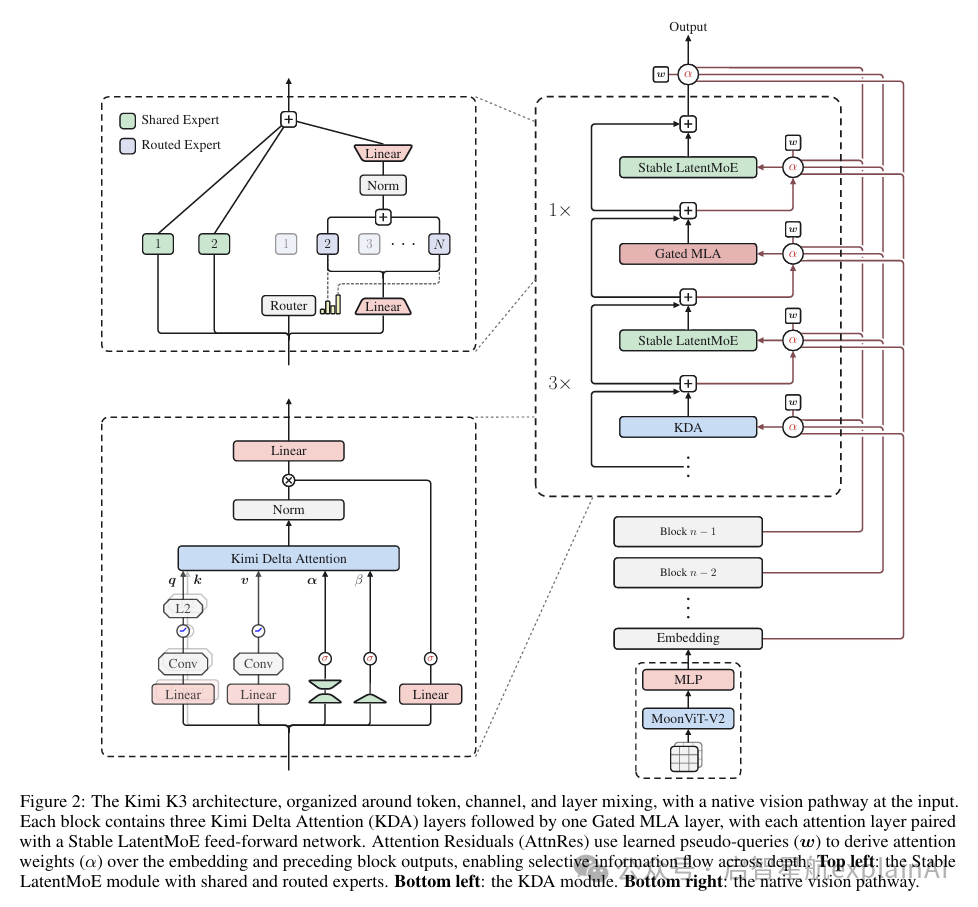
KDA,让序列处理不再背着越来越重的包袱
先说序列维度。标准Transformer的KV cache会随序列长度线性增长,序列越长开销越大。线性注意力用固定大小的递归状态替代不断增长的KV cache,不管序列多长状态大小不变。KDA是在Kimi Linear基础上的进化,做了两个关键改进。
第一个是下界衰减。之前Kimi Linear用负Softplus映射控制衰减率,但这个映射是无界的,累积衰减的倒数可能大到在有限精度计算中溢出。这导致分块计算时对角线tile没法用Tensor Core做密集矩阵乘法,只能逐位置对计算。K3把衰减映射改成有界的scaled sigmoid,设下界gmin等于负5,累积衰减的倒数被限制在e的80次方以内,落在BF16动态范围内。这一改,对角线tile也能用Tensor Core了,瓶颈直接消失。
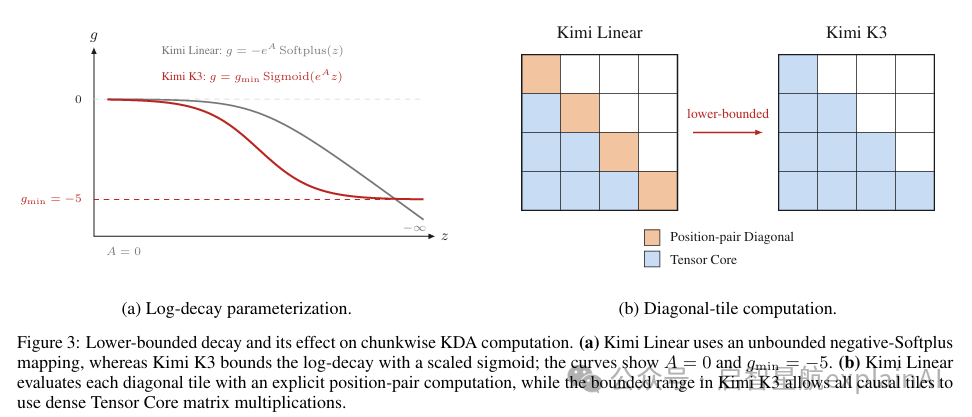
第二个是满秩门。之前KDA输出门用低秩参数化,K3改成输入相关的满秩投影,让每个token能更精细地控制从递归状态中读取哪些通道。
还有一个连锁效应。KDA的递归门控天然编码了位置信息,所以K3的MLA层不需要任何显式的位置编码,这直接为后面的100万token外推铺了路。
AttnRes,让深层网络不再只靠一个压缩包传递信息
再说深度维度。标准Transformer的残差连接把所有前面层的信息压缩到一个状态里往下传,这跟RNN在时间维度上的信息瓶颈是一回事。Transformer用注意力替代RNN解决了序列维度的问题,但在深度维度上还是用的RNN那套思路。
AttnRes做的事情,就是把注意力机制从序列维度搬到深度维度。每一层不再只能看到上一个压缩包,而是可以 selectively 回头看前面任何一层的输出。
但全量AttnRes要保留所有层的输出,内存开销是O(Ld),K3有93层,不可忽略。所以K3用的是Block AttnRes,把93层分成8个block,block内部求和压缩,block之间做完整注意力,内存降到O(Nd)。报告里说N大约等于8就能恢复大部分收益,意味着你只需要8个block级别的表示就够了。
我自己的感受是,AttnRes可能是三件套里最容易被低估的。深度维度的信息流瓶颈在之前的工作里很少被正面解决,AttnRes算是把Transformer自己造的深度瓶颈补上了。
Stable LatentMoE,896个专家怎么不炸
最后说宽度维度。K3的Stable LatentMoE把路由专家扩到896个,每次激活16个,稀疏度56,比K2的384选8高了不少。LatentMoE把全模型宽度和路由专家宽度分开,共享专家走全宽路径,路由专家在紧凑的潜在空间里操作,所以896个专家不会让参数量爆炸。
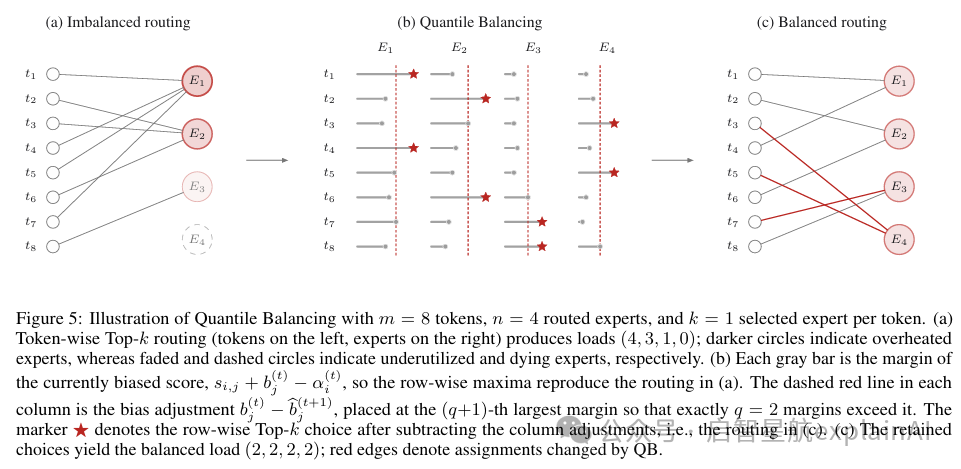
但极端稀疏带来两个新麻烦。一是激活爆炸,路由路径是将近四个连续矩阵乘法的链条,在2.8万亿规模下会产生内部激活爆炸。二是负载均衡,平衡近1000个专家超出了已有方法的工作范围。
K3给了三个解法。RMSNorm在up-projection前插归一化层,降低路由分支对尺度变化的敏感度。SiTU-GLU是K3新提出的激活函数,给SwiGLU的线性因子和上投影分支各加一个tanh的smooth cap,既保留原点附近的近似线性响应,又把大值增长控制住。
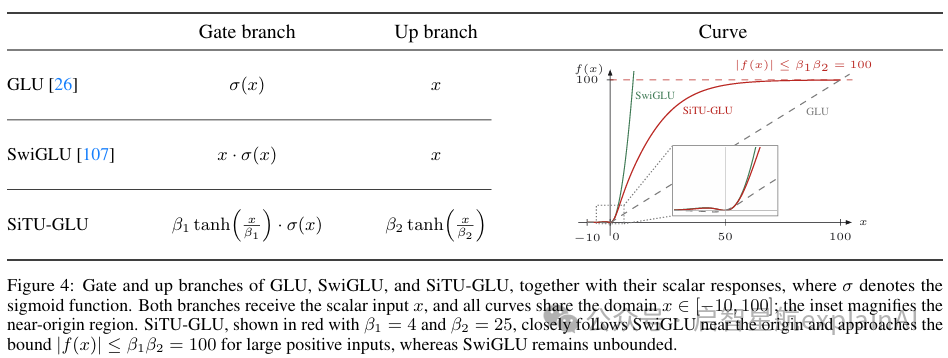
Quantile Balancing是负载均衡的解法,偏置项不是用固定步长更新,而是从路由分数的分位数推导,通过直方图估计计算,通信开销很小。
三件套到这就齐了。序列、深度、宽度,三个维度的信息流效率各自由一个创新来保障。那这些创新到底换来了什么,下一节看证据。
2.5倍效率和100万token,红线的两个硬证据
架构创新说得好听,最终要落在数字上。报告里最关键的Figure 7显示,在相同验证损失下,K3需要的FLOPs大约只有K2的40%,报告把这个提升量化为2.5倍的overall scaling efficiency。
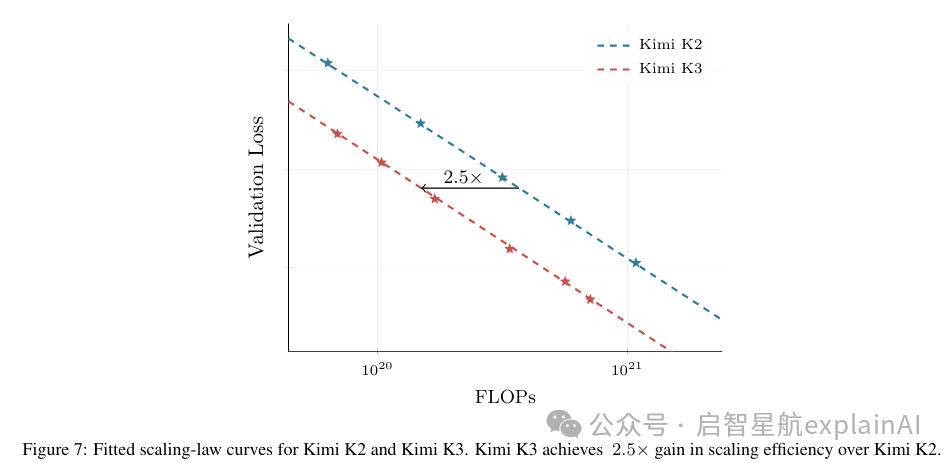
这个2.5倍不是单点优化。Table 1显示K2到K3的变化,层数从61增到93,总参数从1.04万亿增到2.78万亿,路由专家从384增到896,训练上下文从128K增到1M,注意力从纯MLA变成KDA和MLA混合。层数涨了52%,参数涨了167%,如果效率没提升,训练成本会指数级增长。2.5倍的效率提升意味着K3用架构创新抵消了规模增长的成本膨胀。
另一个硬证据是100万token的上下文窗口。K3用NoPE,不设显式位置编码,位置信息通过KDA的递归门控隐式编码,模型可以直接外推到100万token。训练时用四阶段课程,从8K到64K到256K到1M,长序列计算集中在训练预算的一小部分里。
这里有个连锁反应我觉得很妙。KDA的递归状态固定大小不随序列增长,NoPE又不需要修改位置编码参数,两个设计合在一起才让100万token在工程上可行。
后训练RL,把效率转化为100万token的agent能力
K3的后训练,我觉得是整份报告里信息密度最高的部分。
三阶段流程。第一阶段SFT建立基线agent能力,第二阶段RL训练领域专家,第三阶段MOPD把多个专家合并成一个统一模型。
RL的训练设计很有意思。三个域,通用任务、通用agent、编码agent,每个域三个推理努力度,low、high、max。3乘3等于9,一共9个专家模型。
为什么要分这么多专家?因为不同任务、不同努力度的最优策略是不一样的。一个要快速回答的简单问题和一个需要几百步工具调用的复杂agent任务,用一个策略很难同时兼顾。分开训练再合并,是更高效的路径。
合并的方法是MOPD,多教师在线策略蒸馏。训练时,对于给定的域和努力度,对应的专家模型充当教师,引导统一模型学习。这样最终得到一个模型,同时具备9个专家的能力。
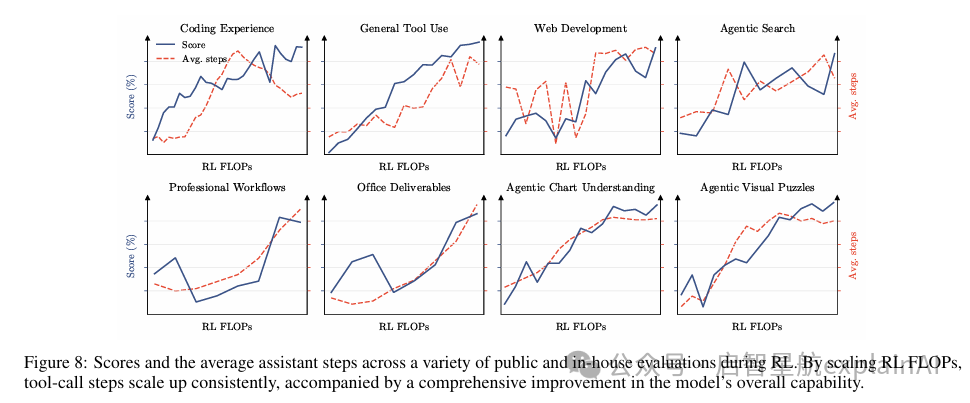
RL的环境设计也值得说。K3没有用固定的agent harness,而是开发了一个统一的白盒RL环境,工具接口、系统提示、上下文管理策略、技能、记忆这些模块像搭积木一样组合,训练时动态切换配置,避免模型过拟合到某一种harness。任务来源覆盖了知识图谱引导的任务合成、GPU内核优化、模拟Gmail和Notion的个人助理任务、以及agent只看目标和约束的自主执行任务。
这个设计思路我觉得很对。模型最终要在各种环境里工作,训练时就得多见几种环境。
还有一个工程细节值得提。K3从SFT阶段就开始做量化感知训练,MXFP4权重配MXFP8激活。整个后训练阶段,rollout和训练都用量化方案,消除了训练和推理的精度不匹配。
回到效率红线。RL把架构效率转化成了实际的agent能力。9个专家的分工训练和MOPD合并,让一个模型同时具备多域多努力度的能力。丰富的可验证环境,确保了这些能力是真实的、可泛化的,不是在单一harness上过拟合出来的。
那这些能力在实际任务中表现如何,下一节看案例和评测。
从造编译器到造芯片,案例和评测里的能力边界
案例部分是整份报告里最直观的能力证明,我挑两个最有代表性的说。
第一个是MiniTriton。K3从零写了一个类似Triton的紧凑型编译器,从tile级Python前端到warp级MLIR标注层,再到PTX代码生成,外面还套了一个双模式张量库,支持类似PyTorch的接口,还有反向自动微分和NCCL分布式训练原语。
在NVIDIA L20上,MiniTriton的几何平均值超过了PyTorch eager和torch.compile。从零写的tensor-core矩阵乘法路径在最大尺寸下接近cuBLAS,达到约90%的机器roofline。
这个案例真的让我坐直了。K3不是在写一堆孤立的内核,而是构建了一个从DSL前端到IR passes到PTX codegen再到CUDA运行时的完整编译器。这是一个有架构理解力的系统级工程。
第二个是芯片设计。K3用48小时自主运行设计了一个推理芯片原型,架构跟K3自己一样,混合KDA和NoPE-MLA注意力,Block AttnRes块大小为2,INT4权重量化。在4平方毫米的面积预算内,时序在100MHz收敛,RTL仿真解码吞吐量超过每秒8700 token,集成了146万个标准单元和带融合反量化的INT4 MAC阵列。RTL代码已经开源到GitHub。
报告里还有I-Love-Q天体物理关系计算,K3两小时完成了研究者通常需要一到两周的工作。42年AI ASIC行业研究网站,120多轮迭代,消化了超过11000页PDF。引力波事件分析,391个事件用20多个并发子agent。3Blue1Brown风格的架构动画和视频剪辑,从56个原始片段里做帧级节拍同步。
这些不是挑挑拣拣的展示,是系统级能力的自然外显。
评测部分,报告的实验设计其实很扎实。它把能力拆成四个轴,推理与知识、编码、agent、视觉,每个轴用一组公开benchmark测,对标Claude Fable 5、GPT-5.6 Sol、Claude Opus 4.8、GPT-5.5和GLM-5.2,所有模型都在最大推理努力度下跑。除了公开benchmark,还有一套内部评测覆盖公开benchmark测不到的能力维度,比如多日持续助手工作、多角色协作、agent视觉感知。
Table 2是公开benchmark的完整对比,先看这张表。
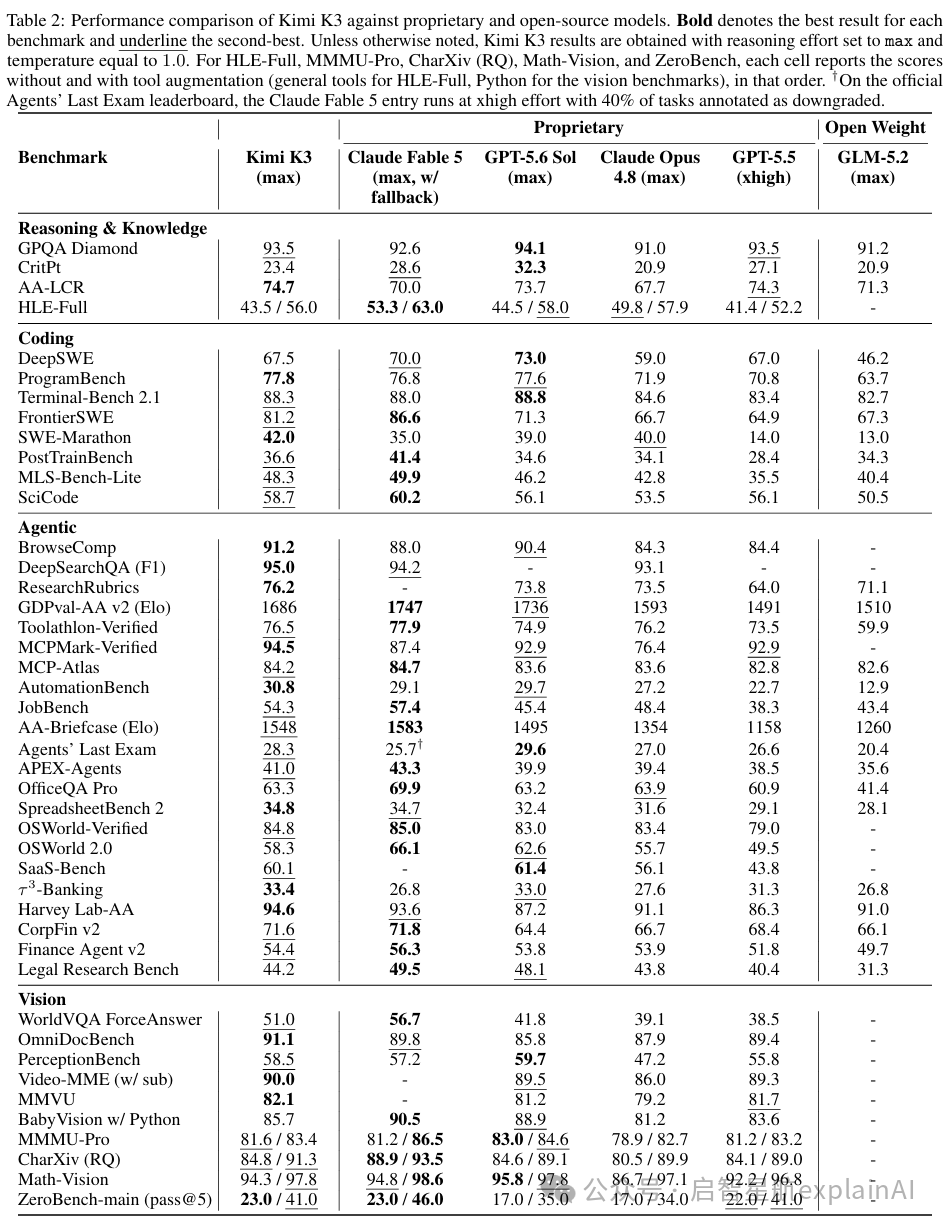
推理与知识这块,K3在GPQA Diamond上拿了93.5%,跟Fable 5的92.6%和GPT-5.6 Sol的94.1%咬得很紧。但在研究生级推理上拉开了差距,HLE-Full,K3在无工具和有工具条件下分别是43.5%和56.0%,Fable 5是53.3%和63.0%,GPT-5.6 Sol是44.5%和58.0%。CritPt,K3是23.4%,Fable 5是28.6%,GPT-5.6 Sol是32.3%。报告原文写得很清楚,研究级推理仍然是改进的关键方向。
编码是K3的强项。ProgramBench上K3拿77.8%排第一,SWE-Marathon这种GPU内核导向的测试上K3拿42.0%,比Fable 5高7分。Terminal-Bench 2.1上K3是88.3%,跟GPT-5.6 Sol的88.8%几乎打平。FrontierSWE这种长程编码任务上K3拿81.2%排第二,仅次于Fable 5的86.6%。DeepSWE上K3是67.5%,落后于Fable 5的70.0%和GPT-5.6 Sol的73.0%,但领先于Opus 4.8和GPT-5.5。
agent能力是K3另一个亮点。BrowseComp上K3拿91.2%排第一,DeepSearchQA拿95.0% F1排第一,MCPMark-Verified拿94.5%排第一,Harvey Lab-AA拿94.6%排第一。但在Elo评分的知识工作套件上,GDPval-AA v2 K3是1686 Elo排第三,落后于Fable 5的1747和GPT-5.6 Sol的1736。AA-Briefcase上K3是1548排第二,落后于Fable 5的1583。
视觉能力上,K3在OmniDocBench拿91.1%排第一,Math-Vision无工具94.3%有工具97.8%,ZeroBench-main跟Fable 5打平在23.0%,加Python工具后到41.0%。
除了公开benchmark,报告还有一套内部评测(Table 3),测的是公开benchmark覆盖不到的能力维度,比如多日持续助手工作、多角色企业协作、agent视觉感知、群体编排。
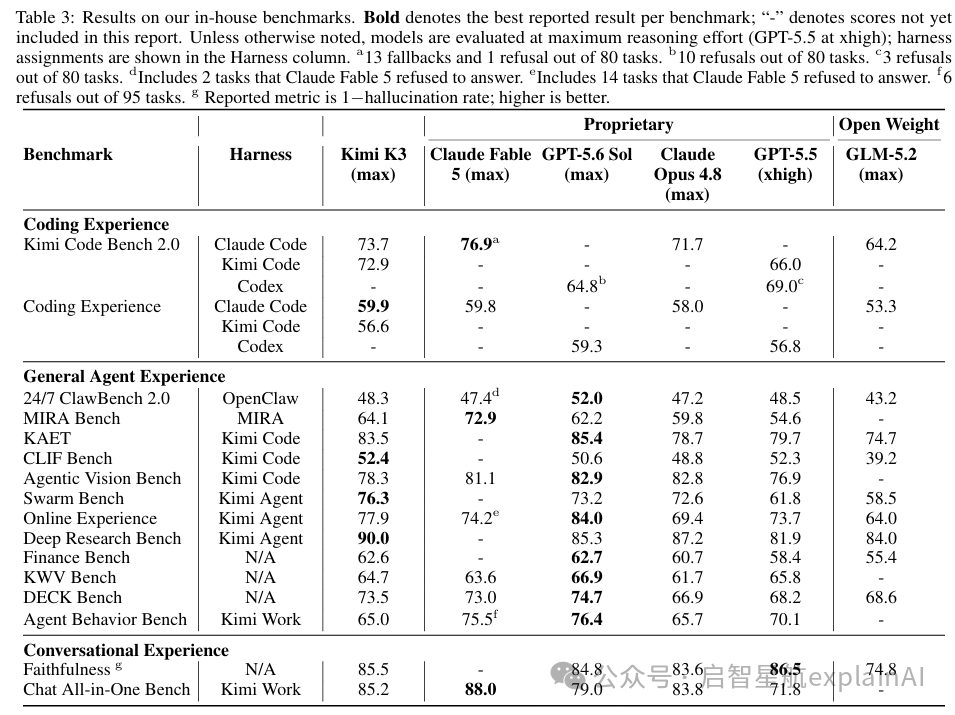
24/7 ClawBench 2.0模拟多日持续助手工作,K3拿48.3%略高于Fable 5的47.4%,但落后于GPT-5.6 Sol的52.0%。MIRA Bench测多角色企业协作,K3是64.1%,落后于Fable 5的72.9%。Agentic Vision Bench测agent在执行任务时能否注意到关键视觉信息,K3是78.3%,落后于Fable 5的81.1%和GPT-5.6 Sol的82.9%。Swarm Bench测agent群体编排能力,K3拿76.3%排第一。Deep Research Bench上K3拿90.0%排第一。
WebDev Arena上K3以1678 Elo排第一,这是第一个在这个众包人类偏好榜单上登顶的开源模型。BrowseComp成本每任务2.03美元,GPT-5.6 Sol是90.4%但成本是K3两倍,Claude在最大努力下成本比K3高一个数量级。在Kimi Code Bench 2.0上比Fable 5低4分但成本只有其38%,在GDPval-AA v2上跟GPT-5.6 Sol差50 Elo以内但成本低13%。
拆完整份报告,我对K3的判断是这样的。它最核心的价值不是2.8万亿这个数字,而是用三件套的架构创新证明了开源模型可以在3T级别既训得起又跑得动,同时用覆盖三个域九个专家的RL训练把架构效率转化成了实际的agent能力。
效率是贯穿全文的红线。三件套合力换来2.5倍的scaling效率,再加上NoPE外推到100万token,这就是2.8万亿参数能跑起来的底层逻辑。
感谢阅读。点个关注,不迷路,我们后续会持续跟进大语言模型的前沿技术动态,第一时间为你解读。