笔记总览
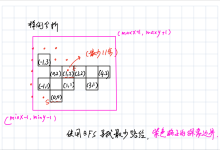
- BFS(广度优先):按层扩散,一层一层向外遍历,对应队列的「先进先出」特性;核心优势是无权图最短路径。
- DFS(深度优先):一路走到黑,走不通就回溯换分支,对应栈的「后进先出」特性;核心优势是连通性检测、全路径枚举、回溯搜索。
- 通用必备组件:visited 标记数组 / 集合,防止有环图重复访问、死循环。
- 约定:顶点编号 0 ~ n-1,基于邻接表存储(工业界默认标准)。
广度优先搜索 BFS
核心定义
从起点出发,先访问所有距离起点为 1 的邻接点,再访问距离为 2 的节点,像水波一样逐层向外扩散。无权图中,第一次到达目标节点的路径,一定是起点到该点的最短路径。
一、基础概念类
提问:BFS 为什么用队列实现?为什么能找无权图最短路径?
回答:
- 用队列是因为 BFS 要严格按「先入队先访问」的顺序处理节点:先入队的是距离近的层,后入队的是距离远的层,队列的先进先出刚好匹配逐层扩散的顺序。
- 能找最短路径,本质是因为 BFS 按距离分层遍历:所有距离为 k 的节点都处理完,才会处理距离为 k+1 的节点。因此第一次遇到目标节点时,走过的步数一定是最小的,不可能存在更短的路径。
提问:BFS 的时间和空间复杂度是多少?
回答:
- 邻接表存储:每个顶点入队一次,每条边访问一次,时间复杂度 O(n + e);空间复杂度 O (n),队列最多存一层节点,最坏情况接近 n。
- 邻接矩阵存储:每个顶点都要遍历 n 个位置判断邻接,时间复杂度 O(n²)。
二、核心代码
1. 图的 BFS 遍历
从指定起点出发,输出 BFS 遍历序列,visited 数组全局去重。
#include <vector>
#include <queue>
using namespace std;
// adj: 邻接表;start: 起点;visited: 全局访问标记数组
vector<int> bfs(vector<vector<int>>& adj, int start, vector<bool>& visited) {
queue<int> q;
vector<int> res;
q.push(start);
visited[start] = true;
while(!q.empty()) {
int curr = q.front();
res.push_back(curr);
q.pop();
for(auto node : adj[curr]) {
if(!visited[node]) {
q.push(node);
visited[node] = true;
}
}
}
return res;
}
// 遍历整个图(处理不连通图)
vector<vector<int>> bfsAll(vector<vector<int>>& adj) {
int n = adj.size();
vector<vector<int>> res;
vector<bool> vis(n, false);
for(int i = 0; i < n; i ++ ) {
if(!visited[i])
res.push_back(bfs(adj, i, vis));
}
return res;
}
提醒:标记访问的时机一定是「入队时」,不是「出队时」,否则同一个节点可能被多次入队,导致超时或重复。
2. 无权图最短路径长度
求起点到终点的最短路径边数,BFS 是最优解。
int shortestPath(vector<vector<int>>& adj, int start, int end) {
int n = adj.size();
vector<bool> visited(n, false);
queue<int> q;
q.push(start);
visited[start] = true;
int step = 0;
while(!q.empty()) {
int size = q.size();
for (int i = 0; i < size; i ++ ) {
int curr = q.front();
q.pop();
if (curr == end) return step;
for (int neighbor : adj[curr]) {
if (!visited[neighbor]) {
visited[neighbor] = true;
q.push(neighbor);
}
}
}
step ++ ;
}
return -1;
}
三、进阶理解类
提问:双向 BFS 是什么?优化原理是什么?
回答:
双向 BFS 是 BFS 的优化版:起点和终点同时开始做 BFS,两个方向的搜索相遇时,就得到了最短路径。
优化原理:BFS 的节点数随层数指数级增长,单向搜索扩散范围会越来越大;双向搜索从两端同时扩散,相遇时各自只走了一半的深度,搜索的节点总数远小于单向,时间空间都能大幅优化。
适用场景:已知起点和终点的最短路径问题,比如单词接龙、迷宫最短路径。
提问:BFS 适合解决哪类问题?
回答:
四类核心场景:
四、项目实战知识
深度优先搜索 DFS
核心定义
从起点出发,沿着一条路径一直走到最深的节点,走不通了就回溯到上一个分叉点,换另一条分支继续深入,直到所有节点都被访问。
类比走迷宫,遇到岔路随便选一条一直走,走到死胡同就退回到上一个岔路口,换一条路继续。
一、基础概念类
提问:DFS 为什么用栈实现?递归和 DFS 是什么关系?
回答:
- DFS 要「先深入、后回溯」,栈的后进先出刚好匹配:最后压入的最深节点,最先弹出处理回溯。
- 递归的底层就是操作系统的函数调用栈,递归写 DFS 本质就是让系统帮我们维护栈;迭代版 DFS 就是手动用栈模拟递归过程,效果完全一致。
提问:DFS 的时间和空间复杂度是多少?
回答:
- 邻接表存储:每个顶点访问一次,每条边访问一次,时间复杂度 O(n + e)。
- 空间复杂度:递归版取决于递归深度,也就是树 / 图的最大深度,最坏 O (n)(斜树 / 一条链);迭代版取决于栈的大小,同样最坏 O (n)。
二、核心代码
1. 图的 DFS 遍历(递归)
代码最简洁,逻辑最清晰,面试优先写递归版。
#include <vector>
using namespace std;
void dfs(vector<vector<int>>& adj, int curr, vector<bool>& visited, vector<int>& res) {
// 1. 标记当前节点已访问
visited[curr] = true;
res.push_back(curr);
// 2. 遍历所有邻接点,未访问则递归深入
for (int neighbor : adj[curr]) {
if(!visited[neighbor]) {
dfs(adj, neighbor, visited, res);
}
}
}
// 遍历整个图(处理不连通图)
vector<vector<int>> dfsAll(vector<vector<int>>& adj) {
int n = adj.size();
vector<bool> visited(n, false);
vector<vector<int>> res;
for (int i = 0; i < n; i ++ ) {
if (!visited[i]) {
vector<int> re;
dfs(adj, i, visited, re);
res.push_back(re);
}
}
return res;
}
2. 图的 DFS 遍历(迭代)
适合深度极大、怕栈溢出的场景,逻辑和前序遍历迭代版完全一致。
vector<int> dfsIter(vector<vector<int>>& adj, int start) {
vector<int> res;
int n = adj.size();
vector<bool> visited(n, false);
vector<int> stk;
stk.push_back(start);
visited[start] = true;
while(!stk.empty()) {
int curr = stk.back();
stk.pop_back();
res.push_back(curr);
// 倒序压入邻接点,保证访问顺序和递归版一致
for (auto it = adj[curr].rbegin(); it != adj[curr].rend(); it ++ ) {
int neighbor = *it;
if (!visited[neighbor]) {
visited[neighbor] = true;
stk.push_back(neighbor);
}
}
}
return res;
}
3. 经典应用:统计连通分量数量
int countComponents(vector<vector<int>>& adj) {
int n = adj.size();
vector<bool> visited(n, false);
int count = 0;
for (int i = 0; i < n; i ++ ) {
if (!visited[i]) {
count ++ ;
dfs(adj, i, visited, vector<int>())
}
}
return count;
}
三、进阶理解类
提问:DFS 和回溯算法是什么关系?剪枝是什么?
回答:
回溯是 DFS 的延伸,核心是「试探 – 撤销」:DFS 只管遍历所有节点,回溯会在深入时做选择,递归返回时撤销选择,从而枚举所有合法的解。
剪枝是回溯的优化:在搜索过程中,如果判断当前分支不可能得到合法解,就直接跳过不继续深入,相当于剪掉了搜索树的一根枝条,能大幅减少搜索量。
典型场景:全排列、组合总和、N 皇后,都是 DFS + 回溯 + 剪枝的经典题。
提问:递归 DFS 有什么风险?怎么解决?
回答:
最大风险是栈溢出:递归深度过大时,系统调用栈会被占满,导致程序崩溃。
解决方法有三个:
提问:DFS 适合解决哪类问题?
回答:
五类核心场景: