1. 什么是模型幻觉
在自然语言处理领域,幻觉(Hallucination) 指大语言模型(LLM)生成的内容虽然语法流畅、措辞自信,但与事实、输入上下文或外部世界不一致。
这个词最早借用自医学和心理学中的"幻觉"概念——患者感知到并不存在的刺激——恰好贴切地描述了模型"编造"不存在事实的行为。
核心定义:模型幻觉是 LLM 在生成过程中,产生与可验证事实、给定上下文、或逻辑一致性相矛盾的内容的现象。
幻觉并非简单的"出错"——它有三层递进含义:
- 事实性错误:生成的陈述与客观事实不符(如声称"爱因斯坦发明了电话")
- 上下文偏离:生成内容与给定的提示、指令或上文矛盾(如用户要求中文摘要,模型却输出英文)
- 逻辑不一致:同一回答内部自相矛盾(如先说 X=5,后又说 X=8)
2023年 ChatGPT 爆火后,幻觉问题迅速成为学术界和工业界最关注的安全议题之一。因为它直接影响模型在医疗、法律、金融等高风险场景的可用性。
2. 幻觉的分类
学术界通常将幻觉分为两大类,每类下有更细的子类型:
2.1 内在幻觉(Intrinsic Hallucination)
又称 事实性幻觉。模型生成的内容与可验证的外部世界知识直接矛盾。
| 事实捏造 | 编造不存在的事件、数据、人物 | "2022年诺贝尔和平奖得主是张三"(实际并非此人) |
| 属性错配 | 将 A 的属性错误赋予 B | "巴黎是英国的首都" |
| 时间错乱 | 事件时间线错误 | "iPhone 于 2005 年发布"(实际是 2007) |
| 数值错误 | 具体数字、统计量出错 | "中国人口约 20 亿" |
2.2 外在幻觉(Extrinsic Hallucination)
又称 忠实性幻觉。模型生成的内容偏离了给定的输入上下文或指令约束。
| 指令违背 | 未遵循用户明确指令 | 要求只用 3 句话总结,实际输出了 5 句 |
| 上下文矛盾 | 与上文提供的信息相悖 | 上文给了一段原文要求翻译,翻译却加了原文没有的内容 |
| 信息冗余 | 添加上下文中不存在的信息 | 摘要任务中添加了原文未提及的细节 |
2.3 更细粒度的分类(根据 Ji et al., 2023)
factual 事实性幻觉
- 实体错误(人名、地名、日期)
- 关系错误(实体间关系虚构)
- 数值错误
faithfulness 忠实性幻觉
- 指令不一致
- 上下文不一致
- 逻辑不一致
3. 幻觉的根本原因
幻觉不是单一原因造成的,而是模型训练、推理、数据等多个环节的综合结果。
3.1 训练数据层面
- 数据噪声与错误:互联网规模的数据集必然包含错误信息。模型无法区分训练语料中的事实与虚构,学习到了虚假关联。
- 知识截止日期:预训练数据存在时间截断,模型对训练截止日期之后的事件天然"无知",但仍会尝试回答。
- 长尾知识稀疏:低频实体、冷门领域在训练数据中出现次数极少,模型缺乏足够信号学习正确事实。
- 数据偏差:来源偏向(维基百科 vs 社交媒体)、地域偏向、观点偏向都会导致模型系统性地产生某些类型的幻觉。
3.2 模型架构层面
- 自回归生成的暴露偏差:训练时使用 teacher forcing(给定正确前缀),推理时却依赖自己的输出作为下一步输入,错误一旦产生就会累积放大。
- 注意力机制的局限:Transformer 的注意力在长上下文中会稀释对关键信息的关注,导致忽略重要指令或上下文细节。
- Softmax 瓶颈:输出概率分布过于平滑,低概率 token 仍有被采样的可能,为幻觉提供了随机入口。
3.3 解码策略层面
- Top-k / Top-p 采样:为提高多样性而引入的随机性,会以一定概率选中事实性错误的 token。
- 温度参数:高温增加输出的随机性,低温虽然更确定但也可能重复低质量模式。
- 贪婪解码的局部最优:每步贪心地选概率最高的 token,忽略了全局语义一致性。
3.4 对齐训练层面
- 讨好性偏差(Sycophancy):RLHF 训练后模型倾向于迎合用户,当用户前提本身错误时,模型可能附和而非纠正。
- 过度自信:对齐训练鼓励模型给出确定性的回答,抑制了"我不知道"的诚实表达。
4. 检测与诊断方法
在解决问题之前,需要先能够可靠地检测幻觉。以下是主流方法:
自然语言推理(NLI)
将模型输出与参考文本送入 NLI 模型判断蕴含/矛盾/中立关系。矛盾即标志潜在幻觉。
问答验证
将生成内容中的原子事实逐一转化为问题,用检索或模型回答来验证每个命题的真伪。
自一致性检查
对同一提示多次采样,检查不同回答之间的一致性。高方差往往暗示存在幻觉。
不确定性估计
利用输出 token 的概率(logit)、熵值、或模型内部表征的方差来量化不确定性。
5. 解决方案全景
解决幻觉没有"银弹"——实践中需要多层次的组合策略。下图展示了从数据到推理的完整防御纵深:
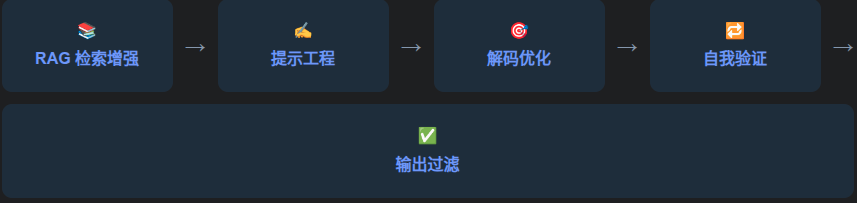
从数据注入 → 推理控制 → 后验证的完整链路
6. 方案一:检索增强生成(RAG)
核心理念:不让模型仅依赖参数化记忆,而是在生成前从外部知识库检索相关文档,将其作为上下文注入提示。这相当于给模型一个"开卷考试"的环境。
6.1 标准 RAG 架构
用户查询
│
▼
┌──────────────┐ ┌──────────────────┐
│ 查询编码器 │────▶│ 向量数据库检索 │
└──────────────┘ └────────┬─────────┘
│ Top-K 相关文档
▼
┌──────────────────┐
│ 拼接文档 + 提示 │
└────────┬─────────┘
│
▼
┌──────────────────┐
│ LLM 生成回答 │
└──────────────────┘
6.2 RAG 的关键设计决策
| 检索粒度 | 段落级 / 句子级 / 文档级 | 越细越精准但上下文碎片化 |
| 嵌入模型 | 稀疏检索(BM25)/ 密集检索(DPR)/ 混合 | 混合检索通常效果最佳 |
| Top-K 数量 | 3~20 | 太少遗漏信息,太多稀释注意力 |
| 重排序 | Cross-encoder 二阶段排序 | 显著提升检索精度但增加延迟 |
| 知识库 | 通用百科 / 领域专用 / 企业私有 | 领域专用效果远好于通用 |
6.3 高级 RAG 变体
Self-RAG
模型自主决定何时需要检索、检索什么、以及检索结果是否相关。通过特殊的反思 token(<RETRIEVE>、<ISREL>)控制检索流程,减少无关检索的噪音。
Corrective RAG(CRAG)
引入检索评估器判断检索质量。当检索结果相关性低时,自动触发 Web 搜索作为补充,或退回纯模型回答。
Graph RAG
将知识组织为图结构(实体为节点,关系为边),检索时不仅获取相关文档,还能沿图遍历获取关联知识,增强推理链条。
Agentic RAG
将检索过程 agent 化:模型可以多轮搜索、调整查询、整合多个来源,像人类研究员一样逐步收集信息。
7. 方案二:提示工程与推理增强
这是成本最低、见效最快的方法——通过精心设计的提示来约束和引导模型行为。
7.1 核心提示技术
① 明确引用要求
要求模型在回答中标注信息来源或引用原文,迫使模型区分记忆与上下文。
请基于提供的文档回答问题。每一条陈述后标注出处(如 [文档A, 第3段])。
如果文档中没有相关信息,请明确回答:"文档中未提供此信息"。
② Chain-of-Thought(思维链)
要求模型逐步推理而非直接给出答案。分步思考使推理过程透明化,更容易发现逻辑漏洞。
请一步步思考,在得出最终答案前展示推理过程。
③ 不确定性校准
明确要求模型对不确定的信息标注置信度或直接拒答。
如果你对某个事实不确定,请在回答中标注 [不确定] 并说明原因。
对于你无法确认的信息,直接回答"我无法确定"。
④ Few-shot 对比示例
在提示中同时给出正确回答和幻觉回答的示例,让模型学会区分。
7.2 高级推理框架
| Tree of Thoughts | 同时探索多条推理路径,评估后选择最优 | 复杂规划、数学证明 |
| Graph of Thoughts | 推理步骤构成 DAG,允许分支、合并、回溯 | 多约束优化问题 |
| Self-Consistency | 多次采样取多数投票结果 | 有确定性答案的任务 |
| ReAct | 交替执行推理(Thought)和行动(Action) | 需要工具使用的任务 |
| Decomposition | 将复杂问题拆解为子问题逐一回答 | 多跳推理 |
8. 方案三:解码策略优化
在推理阶段,通过调整采样和生成策略,可以在 token 级别抑制幻觉。
8.1 核心解码技术
| 上下文感知解码(CAD) | 放大源上下文对输出的影响权重,削弱模型先验 | 增强对输入的忠实度 |
| DoLa(对比层解码) | 用模型不同层的 logit 差异来放大事实性知识信号 | 在 TriviaQA 等任务上显著降低幻觉 |
| 推理时干预(ITI) | 在推理过程中识别并增强与真实性相关的注意力头 | 无需额外训练,即插即用 |
| 事实性核采样 | 将核采样限制在"已知事实"的 token 子集中 | 减少长尾 token 被采样的概率 |
| CD(对比解码) | 用小模型与主模型的 logit 差异来惩罚常见但无信息的 token | 提升回答的信息密度 |
8.2 温度与 Top-p 调优指南
| 事实型问答 | 0.0 ~ 0.3 | 0.9 | 低温减少随机性 |
| 翻译 / 摘要 | 0.2 ~ 0.5 | 0.9 | 平衡准确性与流畅性 |
| 创意写作 | 0.7 ~ 1.0 | 0.95 | 允许多样性,但幻觉风险升高 |
9. 方案四:监督微调与对齐
9.1 事实性 SFT
在高质量的事实性数据集上进行监督微调,强化模型对事实信息的记忆和准确表达能力。
- 使用经过人工验证的高质量 QA 对
- 从高可靠性来源(学术论文、教科书、百科)构建训练数据
- 混合正例(正确回答)和负例(标注为错误的回答),让模型学会区分
9.2 RLHF / DPO 对齐
RLHF(人类反馈强化学习)
收集人类对真实性和忠实度的偏好标注,训练奖励模型,再用 PPO 优化策略。可以让模型学会"不确定时坦诚"。Anthropic 的 Constitutional AI 更进一步将价值观写入宪章。
DPO(直接偏好优化)
无需训练单独的奖励模型,直接从偏好对中优化。更简单、更稳定。可在 truthfulness vs. helpfulness 的数据对上训练,让模型在真实性和有用性之间取得平衡。
9.3 幻觉对抗训练
专门构建幻觉检测数据集(包含正确回答和对应的幻觉版本),训练模型在生成后自我检测和纠正。代表性工作如 HaluEval 提供了大规模幻觉样本用于训练。
10. 方案五:自我反思与验证机制
10.1 核心范式
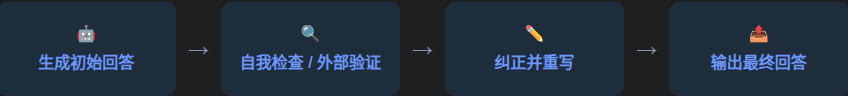
10.2 具体方法
| Self-Refine | 模型对自己的回答进行多轮迭代改进 | Self-Refine (Madaan et al.) |
| SelfCheckGPT | 多次独立采样,检查回答之间的一致性 | SelfCheckGPT (Manakul et al.) |
| FacTool | 将回答分解为原子事实,用外部工具逐一验证 | FacTool (Chern et al.) |
| LLM-as-Judge | 用更强模型(如 GPT-4)评判输出的事实准确性 | MT-Bench, AlpacaEval |
| Verification Chain | 级联多个验证步骤:事实提取 → 逐一验证 → 综合判断 | VERISCORE |
⚠️ 关键局限:自我反思的可靠性受限于模型自身能力。一个弱的模型可能既无法生成正确的内容,也无法识别自己的错误("盲人摸象"困境)。因此在高风险场景中,不应仅依赖自我反思。
11. 方案六:知识编辑与模型更新
当发现模型存在系统性的知识错误时,可以直接"编辑"模型的参数化知识,而无需重新训练。
11.1 知识编辑方法
| ROME | 定位并修改 MLP 层中存储事实的特定神经元 | 精确、副作用小 | 每次只能编辑一个事实 |
| MEMIT | ROME 的批量版本,可同时编辑大量事实 | 批量高效 | 需精心选择编辑层 |
| In-Context Editing | 在上下文中加入纠正信息,模型即时调整输出 | 不需修改参数 | 只在当前对话有效 |
11.2 模型编辑 vs. 检索增强
模型编辑是"修改教科书"——永久改变模型的知识;RAG是"开卷考试"——不改模型,只提供参考材料。两者互补:对于静态事实错误(如过时信息),用模型编辑;对于动态信息(如新闻),用 RAG。实践中混合使用。
12. 实践中的组合策略
单一技术难以全面解决幻觉问题,业界最佳实践是多层防御:
推荐组合方案
🥇 标准生产级方案
不同场景的策略侧重
| 客服问答 | RAG + 知识库 | 拒答模板、输出校验 |
| 医疗诊断 | 引用溯源 + 人工审核 | 不确定性标记、多模型交叉验证 |
| 新闻摘要 | 事实验证(FacTool) | 低温度解码、自一致性 |
| 代码生成 | 执行验证(sandbox) | 思维链、test-case 驱动 |
| 学术写作 | 文献检索 + RAG | 引用标注、专家审查 |
13. 幻觉的评估基准
衡量幻觉解决方案的效果需要标准化的评估基准:
| TruthfulQA | 真实性 | 817 个问题 | 涵盖健康、法律、金融等高风险领域 |
| HaluEval | 幻觉检测 | 35,000 样本 | 包含 QA、对话、摘要三种任务 |
| FActScore | 原子事实准确性 | 人物传记 | 将回答分解为原子事实逐一验证 |
| SelfCheckGPT | 自一致性 | Wikipedia 段落 | 无参考评估,通过采样一致性判断 |
| FEVER | 事实验证 | 185,445 声明 | 判断陈述是支持、反驳还是信息不足 |
| RealTimeQA | 实时知识 | 每周更新 | 测试模型对最新事实的掌握 |
参考文献
以下论文按主题分类列出,涵盖了模型幻觉的检测、缓解与评估的核心工作:
综述类
Zhang et al., 2023. arXiv:2309.01219
Huang et al., 2023. arXiv:2311.05232
Ji et al., ACM Computing Surveys, 2023
检测与评估
Lin, Hilton & Evans, ACL 2022. arXiv:2109.07958
Li et al., EMNLP 2023. arXiv:2305.11747
Min et al., EMNLP 2023. arXiv:2305.14251
Manakul, Liusie & Gales, EMNLP 2023. arXiv:2303.08896
检索增强生成(RAG)
Lewis et al. (Facebook AI), NeurIPS 2020. arXiv:2005.11401
Asai et al., ICLR 2024. arXiv:2310.11511
Yan et al., 2024. arXiv:2401.15884
Edge et al. (Microsoft), 2024. arXiv:2404.16130
解码策略与推理
Wei et al. (Google), NeurIPS 2022. arXiv:2201.11903
Chuang et al., ICLR 2024. arXiv:2309.03883
Li et al., NeurIPS 2023. arXiv:2306.03341
Wang et al., ICLR 2023. arXiv:2203.11171
Yao et al., NeurIPS 2023. arXiv:2305.10601
自我反思与验证
Madaan et al., NeurIPS 2023. arXiv:2303.17651
Chern et al., 2023. arXiv:2307.13528
Yao et al., ICLR 2023. arXiv:2210.03629
对齐与训练
Ouyang et al. (OpenAI), NeurIPS 2022. arXiv:2203.02155
Rafailov et al. (Stanford), NeurIPS 2023. arXiv:2305.18290
Bai et al. (Anthropic), 2022. arXiv:2212.08073
知识编辑
Meng et al. (MIT / ROME), NeurIPS 2022. arXiv:2202.05262
Meng et al., ICLR 2023. arXiv:2210.07229
训练数据治理
Lee et al. (Google), ACL 2022. arXiv:2107.06499
Gao et al. (EleutherAI), 2020. arXiv:2101.00027