Embedding:类别很多时,为什么还要稠密向量
文章目录
- Embedding:类别很多时,为什么还要稠密向量
-
- 1. 问题从哪来
- 2. One-Hot 在词表很大时会怎样
-
- 2.1 第一层权重太多
- 2.2 对数据量、算力、内存都不友好
- 2.3 几何上几乎没有「相似性」
- 3. Embedding 是什么
- 4. 为什么能减轻负担
-
- 4.1 后续全连接的规模
- 4.2 有机会学到「谁更像谁」
- 4.3 和「手工降维」的差别
- 5. 接到汽车预测流程里
- 6. 维数、词表与训练时的注意点
- 7. 常见误区
- 8. 术语表
- 9. 延伸阅读
- 10. 小结
摘要:第 17 篇用 One-Hot 处理类别特征,词表不大时很合适。品牌、车型、用户 ID 这类水平动辄上千上万时,稀疏向量会把第一层权重撑得很肥,也几乎表达不了「谁和谁更像」。本文说明稀疏表示的问题,引入 Embedding(嵌入):用可学习的短稠密向量代替超长 One-Hot,并说明它怎样接到后续网络里。适合读完神经网络单元、准备处理高基数类别的读者。
1. 问题从哪来
专栏里汽车例子常用重量、马力等数值特征。真实表格里还会出现品牌、车系、配置代码这类类别字段。第 17 篇的做法是:先建词表,再 One-Hot。
词表只有十几个水平时,One-Hot 完全够用。一旦「品牌 / 车型编码」涨到几千、上万,输入向量会变得又长又稀。后面若再接神经网络,第一层权重数量会跟着词表一起涨。
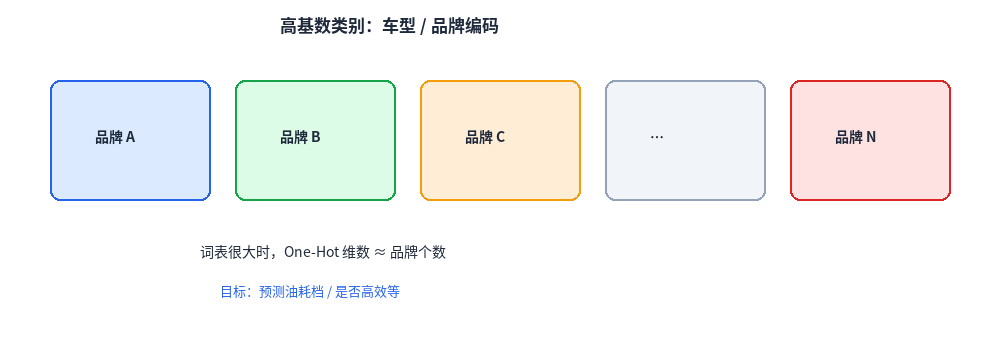
可以把场景想成:根据品牌、重量、马力等,预测油耗是否高效,或预测油耗数值。品牌是离散 ID;重量、马力仍是数值。本文关心的是:品牌这类高基数字段,一开始要不要继续做成超长 One-Hot。
推荐系统、搜索、广告里的物品 ID、用户 ID 是同一类问题。本文用汽车品牌把概念讲清楚,写法与推荐场景通用。
2. One-Hot 在词表很大时会怎样
设词表大小为
V
V
V(例如
V
=
5000
V=5000
V=5000)。品牌 A、B、N 的 One-Hot 大致是:
每个样本在品牌这一维上只有一个
1
1
1,其余全是
0
0
0。编码本身清晰,也和第 17 篇一致。麻烦出在「接到模型之后」。
2.1 第一层权重太多
若 One-Hot 向量长度为
V
V
V,后面第一层有
N
N
N 个节点,仅这一层就大约有
V
×
N
V\\times N
V×N 个权重(偏置另计)。
V
=
5000
V=5000
V=5000、
N
=
128
N=128
N=128 时,已经是六十多万个参数,而且还只服务「品牌」这一个字段。
2.2 对数据量、算力、内存都不友好
参数越多,通常越需要更多样本才能训稳;前向、反向的计算量和显存 / 内存占用也会上去。若还要在端侧跑,模型体积会很难压下去。
2.3 几何上几乎没有「相似性」
任意两个不同类别的 One-Hot 向量内积都是
0
0
0,欧氏距离也相同(都是
2
\\sqrt{2}
2
)。也就是说,在这种表示里,「品牌 A 和品牌 B」与「品牌 A 和品牌 Z」在几何上一样远。模型无法从输入向量本身读出「这两个品牌更接近」。
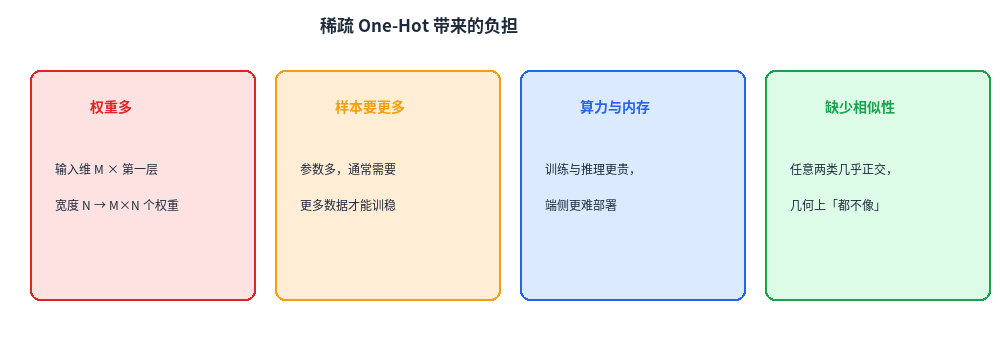
| 权重规模 | 输入维
V V V 大 → 第一层 V × N V\\times N V×N 很大 |
| 样本需求 | 参数多,往往需要更多数据 |
| 计算与存储 | 训练、推理更贵,端侧更难 |
| 语义关系 | 各类几乎正交,输入里看不出相似性 |
这些问题在词表很小(例如十几个车身类型)时通常可以忽略;词表大了才会成为主矛盾。
3. Embedding 是什么
**Embedding(嵌入)**把每个离散类别映成一段长度为
d
d
d 的稠密向量,且通常
d
≪
V
d \\ll V
d≪V。例如
V
=
5000
V=5000
V=5000 时,
d
d
d 可以取
16
16
16、
32
32
32、
64
64
64 这类量级(具体用验证集选)。
实现上可以看成一张可学习的查找表:
- 行数约为词表大小
V
V
V(常留出「未知」行) - 列数是嵌入维
d
d
d - 输入是类别的整数下标,输出是对应那一行的
d
d
d 维向量
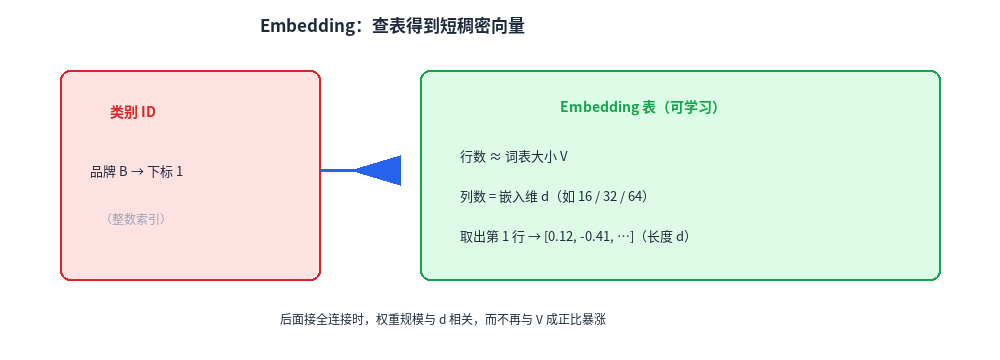
若品牌 B 的下标是
1
1
1,取出的向量记作
e
1
∈
R
d
\\mathbf{e}_1\\in\\mathbb{R}^{d}
e1∈Rd。表中的数值不是手写规则定的,而是和后面网络一起,用任务损失(油耗回归、是否高效等)训练出来。
和 One-Hot 对比:
| 向量长度 |
V V V |
d d d( d ≪ V d\\ll V d≪V) |
| 是否稀疏 | 是(一个 1) | 否(稠密实数) |
| 参数来源 | 编码固定;负担在后续大矩阵 | 表本身可学习 |
| 相似性 | 输入里几乎看不出 | 训练后相近类可在空间中靠近 |
符号上可以写:
e
=
E
m
b
e
d
d
i
n
g
(
i
)
,
i
∈
{
0
,
1
,
…
,
V
−
1
}
\\mathbf{e} = \\mathrm{Embedding}(i),\\quad i\\in\\{0,1,\\ldots,V-1\\}
e=Embedding(i),i∈{0,1,…,V−1}
其中
i
i
i 是类别下标,
e
\\mathbf{e}
e 是
d
d
d 维向量。后面把它与标准化后的重量、马力等拼接,再送进 MLP 或线性层。
4. 为什么能减轻负担
4.1 后续全连接的规模
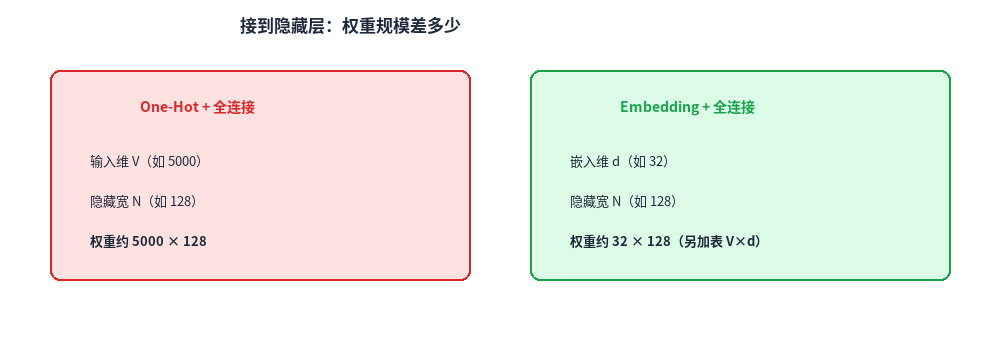
One-Hot 直接进宽度为
N
N
N 的全连接,权重约
V
×
N
V\\times N
V×N。若先经 Embedding 得到
d
d
d 维,再进同样宽度的全连接,这一层权重约
d
×
N
d\\times N
d×N。
d
≪
V
d\\ll V
d≪V 时,这部分会小很多。
Embedding 表本身还有
V
×
d
V\\times d
V×d 个参数。总参数通常仍远小于「超长 One-Hot + 很宽第一层」的组合,尤其当
N
N
N 不小的时候。
4.2 有机会学到「谁更像谁」
训练目标若与品牌行为有关(例如某些品牌整体更省油),优化过程会推动相关品牌的向量在空间中靠近。于是距离、内积可以间接反映相似性——这是 One-Hot 输入本身不具备的。
需要说明:维上的每个分量一般没有现成的人类语义名字(不像「甜度」「液体程度」那样可解释)。嵌入空间由任务和数据决定,换一个任务,同一品牌的向量也可能不同。
4.3 和「手工降维」的差别
也可以先把品牌合并成粗类别,或做哈希到固定桶数,再 One-Hot。那是另一类压缩。Embedding 的特点是:维数
d
d
d 由人定,向量内容由梯度下降学;不事先规定「哪些品牌必须合并」。
5. 接到汽车预测流程里
一条常见接法:
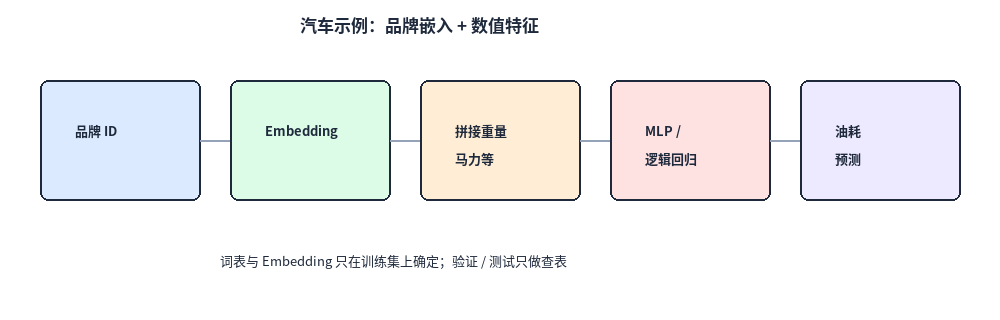
品牌 → 整数下标 → Embedding(d 维)
重量、马力等 → 标准化
拼接 → MLP / 逻辑回归 → 油耗相关目标
概念代码(框架里通常有现成 Embedding 层):
# brand_id: 形状 (batch,),取值 0 .. V-1
# emb: 形状 (batch, d)
emb = embedding_table[brand_id]
x = concat([emb, weight_scaled, horsepower_scaled], axis=–1)
y_hat = mlp(x) # 回归或分类头见第 27、28 篇
训练时,embedding_table 与 MLP 权重一起更新。验证、测试阶段只做查表与前向,不再根据验证 / 测试里的新统计去改词表规则——与第 18、19 篇防泄漏同一原则。
词表仍应在训练集上确定。验证 / 测试出现未见品牌时,常见做法是映射到专用的 <UNK> 下标,而不是临时扩大词表再拿测试信息改表。
6. 维数、词表与训练时的注意点
| 嵌入维
d d d |
先试 8~64 | 过小可能欠表达;过大参数变多、易过拟合 |
| 词表 | 训练集拟合;低频可并入 UNK | 与第 17 篇词表思路一致 |
| 未见类别 | UNK 行 | 避免测试时随意扩表 |
| 多个类别字段 | 各用一张表,再拼接 | 例如品牌一张、车身类型一张 |
| 正则 | 早停、权重衰减、必要时减小
d d d |
嵌入参数多时同样会过拟合 |
d
d
d 不是越大越好。汽车数据若只有几千行,品牌嵌入维开到 256,很容易变成「每个品牌一套近乎背答案的坐标」。验证损失仍是选
d
d
d 的依据。
Embedding 层与 One-Hot 后接线性层,在数学上有时可以看成相关结构;实践中仍推荐直接使用 Embedding 查表,既省内存(不必物化超长稀疏向量),也更符合常见框架用法。
7. 常见误区
| 词表只有十几个水平仍强行上 Embedding | 往往收益有限;One-Hot 更简单、也可行 |
| 把 Embedding 当成与任务无关的通用「品牌坐标」 | 向量通常依赖训练目标与数据,换任务可能要重学 |
| 全表先建词表 / 统计再切分 | 泄漏;词表与罕见词处理应基于训练集 |
| 测试里出现新品牌就临时加一行并继续调参 | 评估会被污染;应用 UNK 或单独的新 ID 策略并事先定好 |
| 只把嵌入维开很大,不看验证集 | 过拟合风险上升 |
| 以为嵌入每一维都有明确业务含义 | 多数维度不可直接命名;可解释性有限 |
第 26~28 篇的网络训练习惯仍然适用:先浅后深,盯验证集,输出头与任务匹配。Embedding 只是输入侧的表示方式,不是另一套可以省略评估纪律的方法。
8. 术语表
| 高基数类别 | 水平很多的离散特征(如大量品牌、ID) |
| One-Hot | 词表位置为 1、其余为 0 的稀疏编码 |
| Embedding / 嵌入 | 将离散 ID 映为
d d d 维稠密向量,通常可学习 |
| 嵌入维
d d d |
每个 ID 对应向量的长度 |
| 嵌入表 | 形状约
V × d V\\times d V×d 的查找表 |
| UNK | 未见或低频类别的占位下标 |
| 稠密向量 | 多数分量为非零实数的向量 |
| 稀疏向量 | 多数分量为 0 的向量(One-Hot 典型如此) |
9. 延伸阅读
| 专栏第 17 篇 | 词表与 One-Hot 基础 |
| 专栏第 28 篇 | 神经网络单元回顾 |
| PyTorch Embedding | 查表层接口 |
| sklearn OneHotEncoder | 小词表时的对照基线 |
| NumPy | 手工模拟「下标取行」 |
10. 小结
词表很大时,One-Hot 会带来超长稀疏输入、第一层权重膨胀,以及输入空间中缺乏相似性结构。Embedding 用长度为
d
d
d 的稠密向量表示每个类别,通过查表接入后续模型,通常能降低后续层规模,并在任务驱动下让相关类别在空间中靠近。
汽车场景里,品牌走 Embedding,重量与马力走标准化数值,拼接后再做回归或分类,是一条常见基线。词表与未见词策略仍须遵守训练集拟合、验证测试只变换的原则。
下一篇会继续看 嵌入空间:向量距离如何表示相似性、维数意味着什么,以及静态词嵌入这类例子在说明什么。
系列导航:
- 上一篇:【机器学习】(28)—— 神经网络小结
- 下一篇(预告):嵌入空间与静态 Embedding
如果本篇对你有帮助,欢迎点赞、收藏、关注博主,机器学习专栏持续更新中,下次更新不迷路。