摘要:本文通过 node:vm 基准测试,拆解了单文件工具冷启动中编译与顶层执行的成本占比。实验表明,决定冷启动速度的是"顶层执行图"而非文件字节数——将 IIFE 注册改为未调用的函数表达式,编译段省 47%、执行段省 96%,总耗时快 4.9 倍。
把 100 个小工具塞进一个 HTML 文件之后,我做了一件很反直觉的事:给源码多加了 5% 的字节,冷启动却快了 4.9 倍。
这不是压缩技巧,也不是删功能。变的只有一件事——模块是"在顶层立即跑"还是"先登记、用到才跑"。而真正让我意外的是编译那一段:惰性版本的源码明明更大,V8 编译它反而快了将近一倍。
顺着这个异常查下去,才发现单文件工具的冷启动预算,长期被算错了对象。
背景:单文件工具的"体积焦虑"可能找错了对象
单文件、零依赖、双击即用的本地工具这两年重新流行起来。原因不难理解:没有安装器、没有 node_modules、没有构建步骤,换台机器把文件拷过去就能跑;对 AI 生成代码来说,单文件还消除了跨文件引用这个最大的幻觉来源。
但这个范式有个天然的增长压力——工具会越加越多。一个文件从 3 个工具长到 100 个工具,很自然会开始担心:"文件是不是太大了?加载会不会变慢?"
于是优化动作几乎都指向体积:压缩、精简、去空白、把大表外置。
问题是,体积和冷启动耗时并不是同一件事。浏览器拿到一段内联脚本要做两件事:先编译(parse / compile),再执行顶层代码(top-level execution)。前者大致跟字节数相关,后者跟"你在顶层真正跑了多少活"相关。这两者可以完全脱钩——而绝大多数单文件工具的慢,慢在第二段。
我想把这两段拆开,各自称一下重量。
实验设计:把冷启动拆成编译与顶层执行
要干净地测这件事,得先把浏览器里的噪音去掉:网络、HTML 解析、CSS、布局、绘制都会污染读数。所以我用 node:vm 直接驱动 V8——它和 Chrome 是同一个引擎,new vm.Script() 对应编译,script.runInContext() 对应执行,两段可以分别打点。
生成的"工具模块"贴近真实单文件工具里一个编码/换算类工具的体量:一张 256 项查找表、一个渲染函数、一段事件装配。对照的两种范式是:
- 急切(eager):每个模块用 IIFE 包裹,在顶层立即建表、建模板、装事件。
- 惰性(lazy):每个模块只往注册表里 push 一个未调用的 init 闭包,只有当前激活的那一个真正初始化。
// 急切:顶层立刻执行模块体
(function () {
var table_7 = [];
for (var k = 0; k < 256; k++) table_7.push(((k * 14) ^ 0x5f).toString(16).padStart(2, '0'));
/* …建模板、装事件… */
__SINK.push(state_7);
})();
// 惰性:只登记闭包,模块体不在顶层跑
__REG.push({ id: 7, init: function () {
var table_7 = [];
for (var k = 0; k < 256; k++) table_7.push(((k * 14) ^ 0x5f).toString(16).padStart(2, '0'));
/* …同样的模块体… */
__SINK.push(state_7);
return state_7;
}});
这里有个很容易踩的坑,第一版实验我就掉进去了:V8 有 isolate 级的 compilation cache,重复编译同一份源码字符串会直接命中缓存。我第一次跑出来 87KB 脚本编译只要 0.003ms,比物理上限还离谱。修正办法是每轮迭代往源码里注入唯一 salt,保证 V8 每次见到的都是新字符串:
function buildScriptSource(count, eager, salt) {
const parts = [`var __SALT = ${salt}; var __SINK = []; var __WIRED = []; var __REG = [];`];
for (let i = 0; i < count; i++) parts.push(makeModuleSource(i, eager, salt));
if (!eager) parts.push('__REG[0] && __REG[0].init();'); // 只初始化激活的那一个
return parts.join('\\n');
}
每个配置预热 3 轮、正式跑 15 轮取中位数。测试环境:AMD Ryzen 7 9700X(8 核 16 线程)、31.1GB 内存、Windows 10.0.26200、Node v22.22.2、V8 12.4.254.21。
实测:执行成本主导,且随模块数近似线性
四种模块规模、两种范式的结果如下(中位数,单位 ms):
| 10 | 急切 | 8.6 | 0.168 | 0.325 | 0.493 |
| 10 | 惰性 | 9.1 | 0.101 | 0.071 | 0.172 |
| 30 | 急切 | 25.9 | 0.399 | 0.864 | 1.263 |
| 30 | 惰性 | 27.3 | 0.232 | 0.087 | 0.319 |
| 60 | 急切 | 51.9 | 0.843 | 1.626 | 2.469 |
| 60 | 惰性 | 54.7 | 0.434 | 0.101 | 0.535 |
| 100 | 急切 | 86.6 | 1.380 | 2.719 | 4.099 |
| 100 | 惰性 | 91.3 | 0.719 | 0.122 | 0.841 |
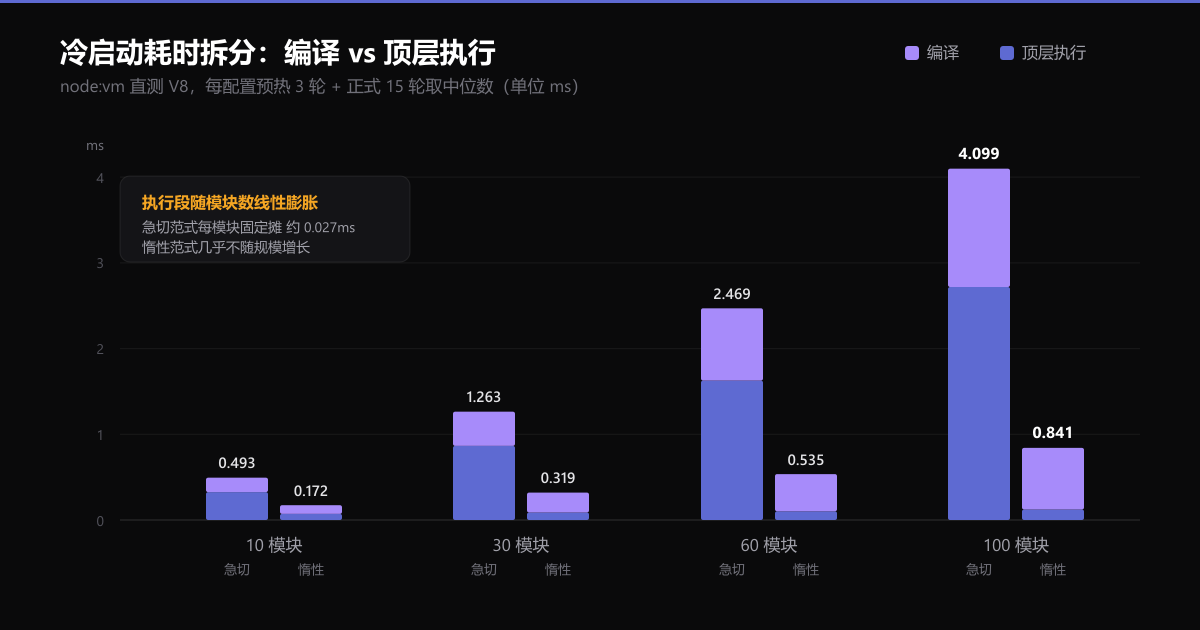
图1:编译(浅色)与顶层执行(深色)的耗时拆分。急切范式下执行段随模块数线性膨胀,惰性范式下几乎是一条平线。
三个读数值得注意。
第一,执行是主导项,不是编译。 100 模块急切范式里,执行 2.719ms 占了总耗时 4.099ms 的 66%。
第二,急切范式的执行成本严格线性。 换算成每模块摊销:10 模块 0.0325ms、30 模块 0.0288ms、60 模块 0.0271ms、100 模块 0.0272ms。基本是一个常数——你每往单文件里加一个急切初始化的工具,就固定买入约 0.027ms 的冷启动债务,跟这个工具用不用得上无关。
第三,惰性范式几乎不随规模增长。 执行段从 10 模块的 0.071ms 到 100 模块的 0.122ms,模块数涨了 10 倍,耗时只涨 1.7 倍——多出来的那点是注册闭包本身的开销,而真正的模块体只跑了被激活的那一个。
100 模块时两者执行段相差 22.3 倍(2.719ms vs 0.122ms),总耗时相差 4.9 倍。
反直觉:源码多 5%,编译却快 1.9 倍
上面那张表里藏着一个说不通的地方:惰性版本源码是 91.3KB,比急切版本的 86.6KB 大 5.4%,编译耗时却是 0.719ms vs 1.380ms——快了 1.92 倍。
字节更多、编译更快,这违反"编译成本正比于体积"的直觉。所以我做了第二个对照实验来定位原因:同一段模块体,三种包裹形式,只编译、不执行。
// A) IIFE:立即调用
(function () { /* BODY */ })();
// B) 函数表达式:登记但不调用
__REG.push({ init: function () { /* BODY */ } });
// C) 函数声明:定义但不调用
function mod_7() { /* BODY */ }
100 个模块,结果如下:
| IIFE(立即调用) | 50.3 | 0.943 ms |
| 函数表达式(未调用) | 52.1 | 0.499 ms |
| 函数声明(未调用) | 50.4 | 0.390 ms |
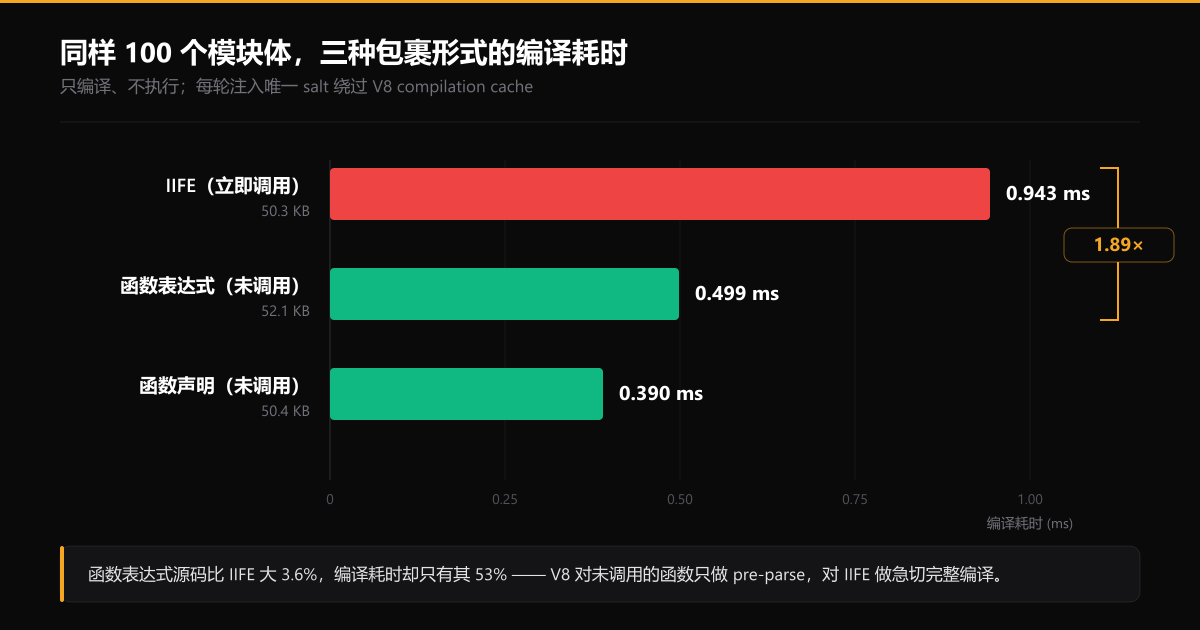
图2:函数表达式比 IIFE 源码大 3.6%,编译耗时却只有其 53%。差异来自 V8 是否对函数体做完整编译。
IIFE 的编译耗时是等价函数表达式的 1.89 倍,尽管它的源码还小 3.6%。 这就解释了主实验里的异常。
原因在于 V8 的惰性编译策略:默认情况下,V8 首次扫描脚本时对函数体只做 pre-parse——检查语法、记录作用域和变量引用,但不生成字节码。字节码要等函数第一次被调用时才生成。可 IIFE 是个例外:V8 有一条启发式规则,识别出 (function 这种立即调用的模式后,会直接对它做急切的完整编译,因为引擎知道这个函数马上就要跑,推迟没有意义。
于是"用 IIFE 包裹每个模块"这个在单文件工具里极其常见的写法,等于主动放弃了 V8 送给你的惰性编译优化。
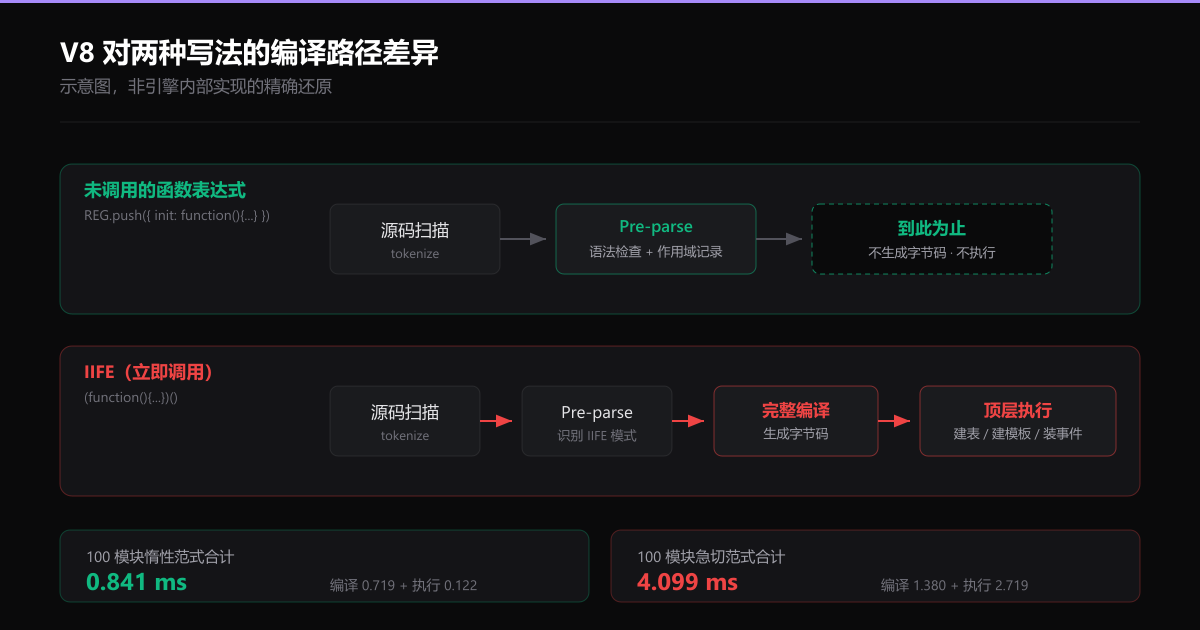
图3:未调用的函数表达式停在 pre-parse,IIFE 则一路走到字节码生成与顶层执行。示意图,非引擎内部实现的精确还原。
落到设计:单文件工具的三条冷启动约束
把上面的数据翻译成可执行的设计约束,就三条。
一、优化目标是"顶层执行图",不是文件字节数。 判断标准很简单:打开文件到可交互之前,有多少代码是必须跑的?一个 500KB 但顶层只跑路由和一个工具的单文件,冷启动会明显快过一个 200KB 但把 60 个工具全初始化了的单文件。字节数是个糟糕的代理指标。
二、模块注册用未调用的函数,不要用 IIFE。 这是本文成本最低的一条改动——把 (function(){…})() 改成 { init: function(){…} } 并延后调用,编译段直接省掉近一半,执行段省掉全部。改动是机械的,不涉及业务逻辑。
三、把"建表/建模板/装事件"从加载期挪到激活期。 查找表、DOM 模板、事件绑定这类工作,是每模块 0.027ms 的主要来源。它们该发生在用户点开某个工具的那一刻,而不是打开文件的那一刻。
一个可直接套用的骨架:
const REG = [];
const define = (id, init) => REG.push({ id, init, inst: null });
define('base64', function () {
const table = buildTable(); // 建表推迟到这里
const root = renderTemplate(); // 模板推迟到这里
bindEvents(root); // 装配推迟到这里
return { root, table };
});
function activate(id) {
const m = REG.find(x => x.id === id);
if (!m.inst) m.inst = m.init(); // 只初始化一次,之后复用
return m.inst;
}
关键在于 define 的第二个参数是未被调用的函数表达式——V8 会让它停在 pre-parse,直到 activate 真正需要它。
局限:这个实验没有证明什么
有几件事必须说清楚,否则这些数字会被过度解读。
这是 V8 层的测量,不是端到端的页面性能。 node:vm 隔离掉了 HTML 解析、CSS 解析、样式计算、布局和绘制。真实单文件工具的可交互时间里,DOM 与样式往往占更大比重。本文测的是"脚本这一段花了多少",不是"页面多久能用"。
绝对值很小,桌面端用户基本无感。 100 模块急切范式合计 4.099ms——在 Ryzen 7 9700X 上这个量级不构成体验问题。真正的意义在于那个线性系数:0.027ms/模块是结构性成本,它会随工具数量无上限增长,而且在慢设备上按比例放大。中低端移动 CPU 单线程性能通常比这台机器慢数倍,同样的脚本开销会相应变大——但这是推断,本文没有在移动设备上实测,不应当作已验证的数字引用。
没有测内存与 GC。 急切范式把 100 张 256 项查找表全建出来常驻堆上,惰性范式只建 1 张。这个差异对长时间运行的工具可能比启动耗时更重要,但不在本次测量范围内。
结论依赖 V8 的当前启发式。 IIFE 急切编译是 V8 的实现选择,不是语言规范。不同引擎(JavaScriptCore、SpiderMonkey)的策略不同,未来 V8 版本也可能调整。本文结论限定在 V8 12.4。
合成模块不等于真实工具。 生成的模块体是同构的;真实工具的初始化成本差异极大,有的只绑一个事件,有的要预编译正则或解析大常量表。线性系数在真实项目里会是一个分布,不是常数。
结论与下一步
单文件工具的性能讨论,长期停在"文件多大"上。但这次测量给出的结论是:决定冷启动的是顶层执行图的大小,而不是文件字节数——两者可以反向变动,惰性版本大了 5.4% 却快了 4.9 倍就是证据。
如果只带走一条,那就是这条机械改动:别用 IIFE 注册模块。改成未调用的函数表达式,编译段省 47%,执行段省 96%,代价是几行结构调整。V8 本来就准备好帮你惰性编译,IIFE 是主动把这个优化关掉。
下一步我打算把同一组对照搬进真实浏览器,用 Performance API 量端到端的可交互时间,看看在 HTML 解析和布局的噪音里,这 3.3ms 的脚本差异还剩多少可观测性;同时补上堆内存和 GC 的对照。
复现方式:本文两段基准的完整脚本、原始 results.json 与环境信息都在下面的仓库里,node bench.js 即可复跑。
开源地址:
- 矩阵门户:https://github.com/wangzifan396-wzf/WB
- 单文件工具聚合器:https://github.com/wangzifan396-wzf/nano-workbench
- GitHub 组织主页:https://github.com/wangzifan396-wzf