半小时上手蓝耘元生代 MaaS:用 OpenAI SDK 调用 DeepSeek,把大模型接进自己的项目
最近想给一个小工具接大模型能力:代码解释、接口报错分析、简单问答。自己部署满血模型成本太高,本地小模型又不够用。最后选了 蓝耘元生代 MaaS 平台,原因很直接——接口兼容 OpenAI,模型多,注册后就有免费 Token 可以试。
这篇文章按「能跑起来」来写:注册、拿 Key、Python 调用、流式输出、换模型、一个最小可用 Demo,以及我实际踩过的几个坑。适合第一次接触蓝耘 MaaS 的同学。
一、蓝耘元生代 MaaS 是什么,为什么适合先试它
MaaS(Model as a Service) 可以理解成「模型当云服务用」:不用自己买卡、装推理框架、调并发,通过 API 直接调用平台托管好的大模型。
蓝耘元生代 MaaS 的定位比较清晰(来自官网与文档):
| 模型覆盖 | 支持 DeepSeek、Qwen、Kimi 等 50+ 主流模型,统一接口一次接入 | 蓝耘 MaaS 官网 |
| 接口形态 | OpenAI 兼容,改 base_url + api_key 就能切模型 | 官方文档 |
| 稳定性 | 官网标注 99.9% 可用率,平均延迟 <100ms(网关侧指标,实际端到端受模型与网络影响) | 蓝耘 MaaS 官网 |
| 成本结构 | 自有 GPU 池 + 智能路由 + Prompt 缓存等降本能力;按 Token 计费 | 官网「三重降本」说明 |
| 新手友好 | 注册后可领取免费 Token(文档示例:DeepSeek 系列常见为 500 万 免费额度) | 官方文档「资源包管理」 |
对我这种「先验证业务、再谈规模」的开发者,最有用的是三点:
二、注册与获取 API Key(操作细节)
1. 注册账号
新用户通常会看到算力/Token 相关的体验权益,以控制台实际展示为准。注册后建议先去「资源包管理」看一眼剩余额度,后面测延迟、测代码时心里有数。
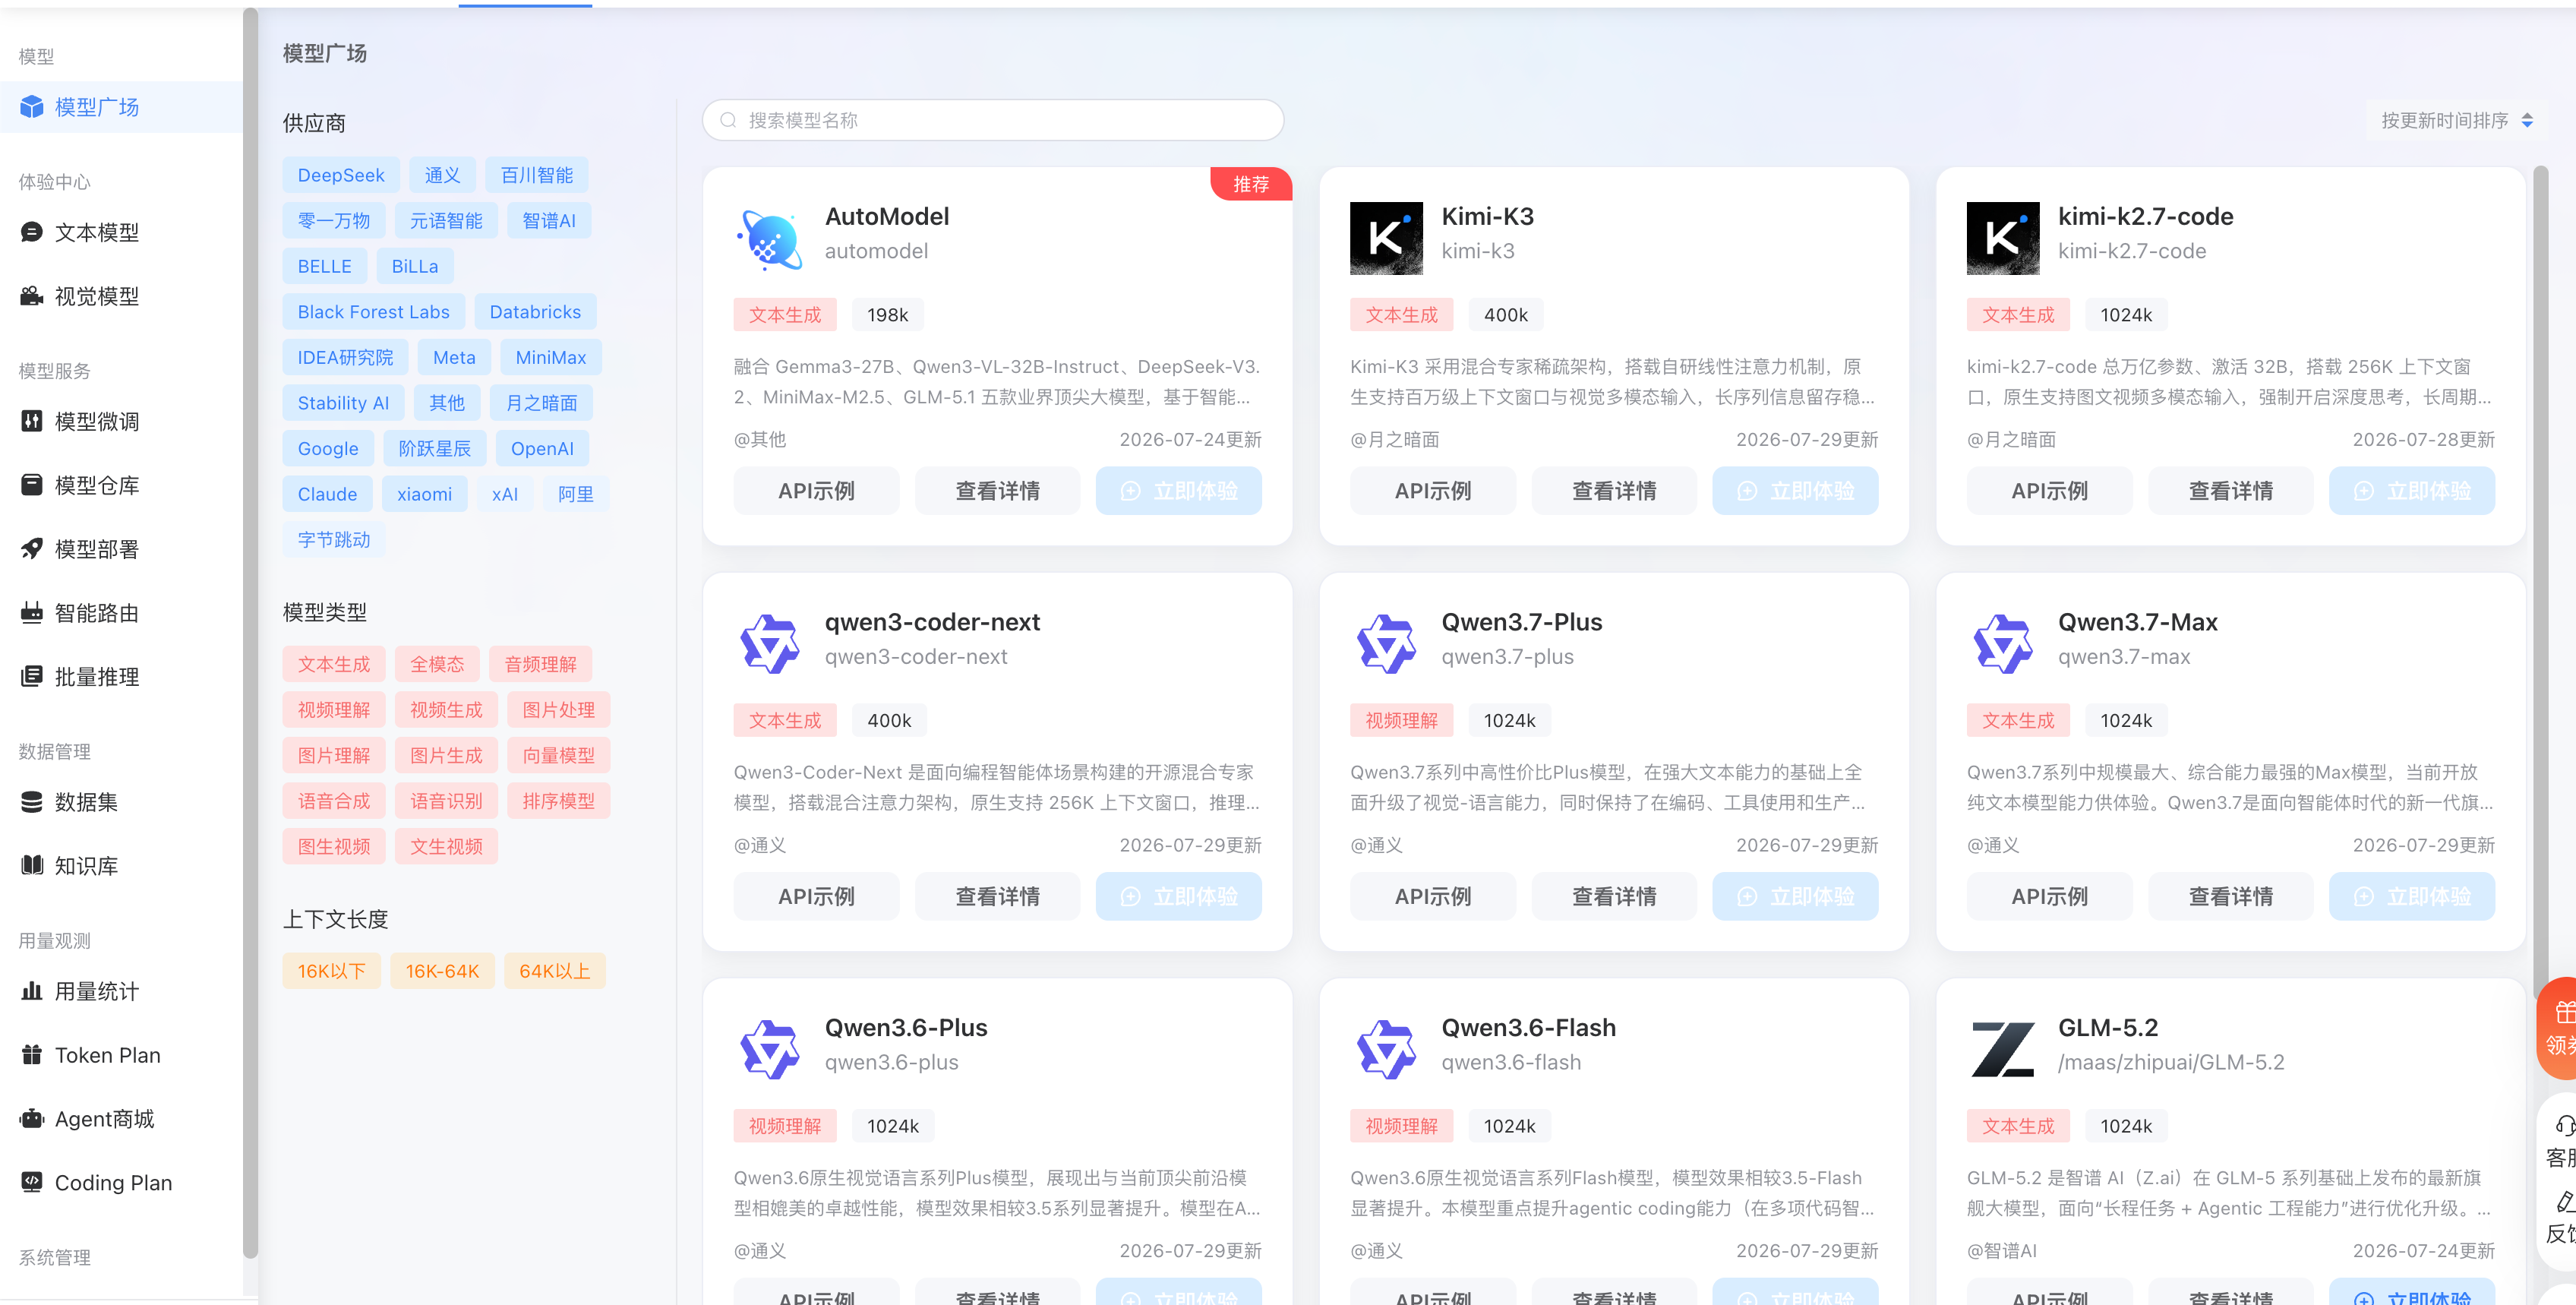
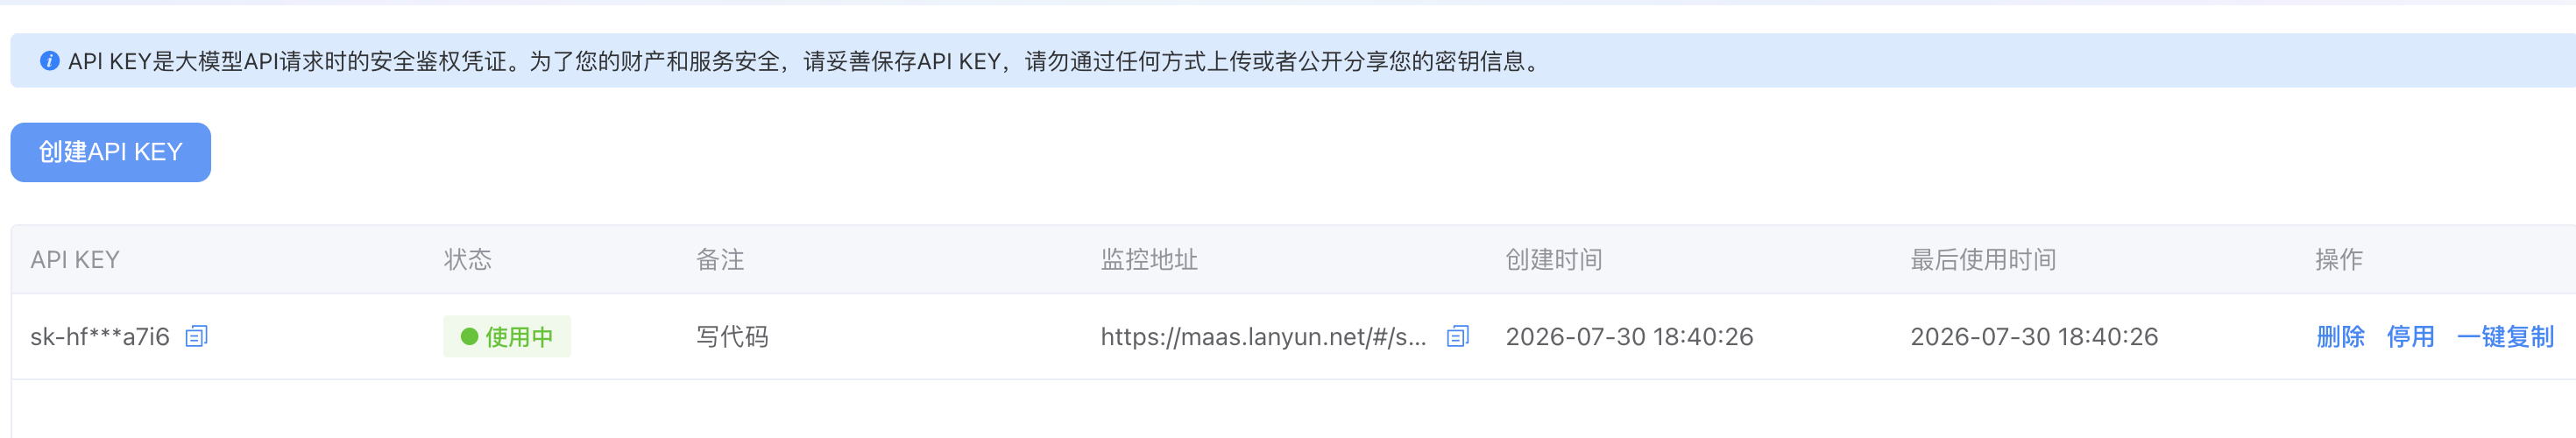
2. 创建 API Key
按官方文档路径:
安全建议(别嫌啰嗦,真的容易踩):
- 不要把 Key 写死在代码仓库里
- 用环境变量:export LANYUN_API_KEY=sk-xxxx
- 泄露了就去控制台删掉重建
3. 记下两个关键参数
后面所有调用都围着这两项转:
base_url : https://maas-api.lanyun.net/v1
完整接口 : https://maas-api.lanyun.net/v1/chat/completions
常见模型名(以文档示例为准,控制台模型市场可能更新):
| DeepSeek-R1 | /maas/deepseek-ai/DeepSeek-R1 | 8 元/百万 Token | 60K |
| DeepSeek-V3 | /maas/deepseek-ai/DeepSeek-V3 | 4 元/百万 Token | 60K |
| QwQ-32B | /maas/qwen/QwQ-32B | 4 元/百万 Token | 40K |
单价与免费额度以你账号控制台 / 模型详情页最新标价为准。上文表格摘自蓝耘 MaaS 官方文档「产品简介」页。
三、环境准备:三分钟装好依赖
本机需要 Python 3.8+。
pip install openai
(可选)用环境变量存 Key:
# macOS / Linux
export LANYUN_API_KEY="sk-你的密钥"
# Windows PowerShell
$env:LANYUN_API_KEY="sk-你的密钥"
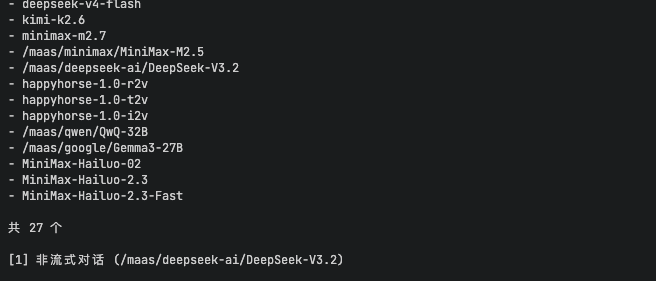
四、第一次调用:非流式对话
把下面代码存成 lanyun_hello.py:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.getenv("LANYUN_API_KEY", "sk-xxxxxxxxxxx"), # 建议用环境变量
base_url="https://maas-api.lanyun.net/v1",
)
resp = client.chat.completions.create(
model="/maas/deepseek-ai/DeepSeek-V3", # 通用对话可先用 V3,更省
messages=[
{"role": "system", "content": "你是一个简洁的中文技术助手。"},
{"role": "user", "content": "用三句话介绍什么是 MaaS。"},
],
temperature=0.3,
max_tokens=512,
stream=False,
)
print(resp.choices[0].message.content)
print("—")
print("usage:", resp.usage) # 方便对照 Token 消耗
运行:
python lanyun_hello.py
如果返回正常文本,说明 鉴权 + 路由 + 模型推理 整条链路已经通了。
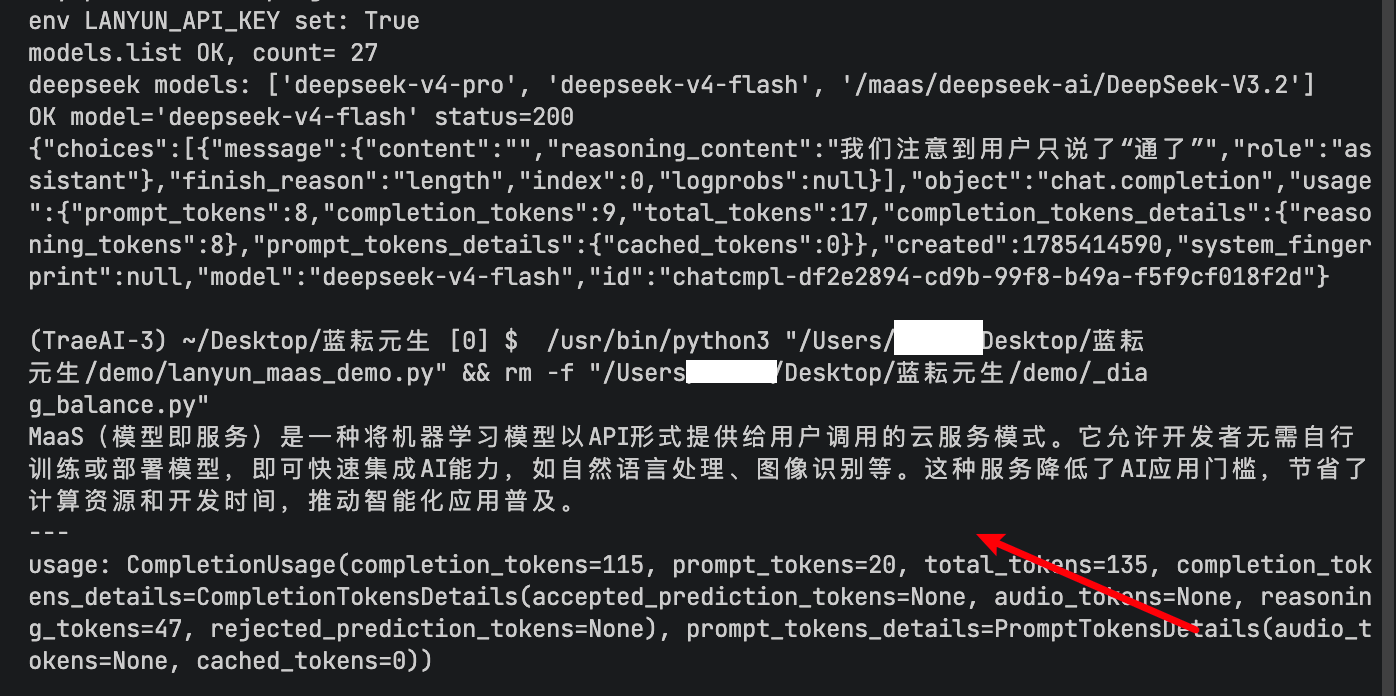
常见报错对照
| 401 / 鉴权失败 | Key 错、Bearer 格式问题、Key 被删 | 重新复制 Key;确认 Authorization: Bearer sk-… |
| 404 / model not found | model 名写错 | 对照控制台「API 调用模型名」,注意前缀 /maas/… |
| 超时 / 连接失败 | 网络、代理、公司防火墙 | 换网络;检查是否需要 HTTP 代理 |
| 余额不足 | 免费额度用完 | 去资源包管理确认;再决定充值 |
五、流式输出:做聊天框必备
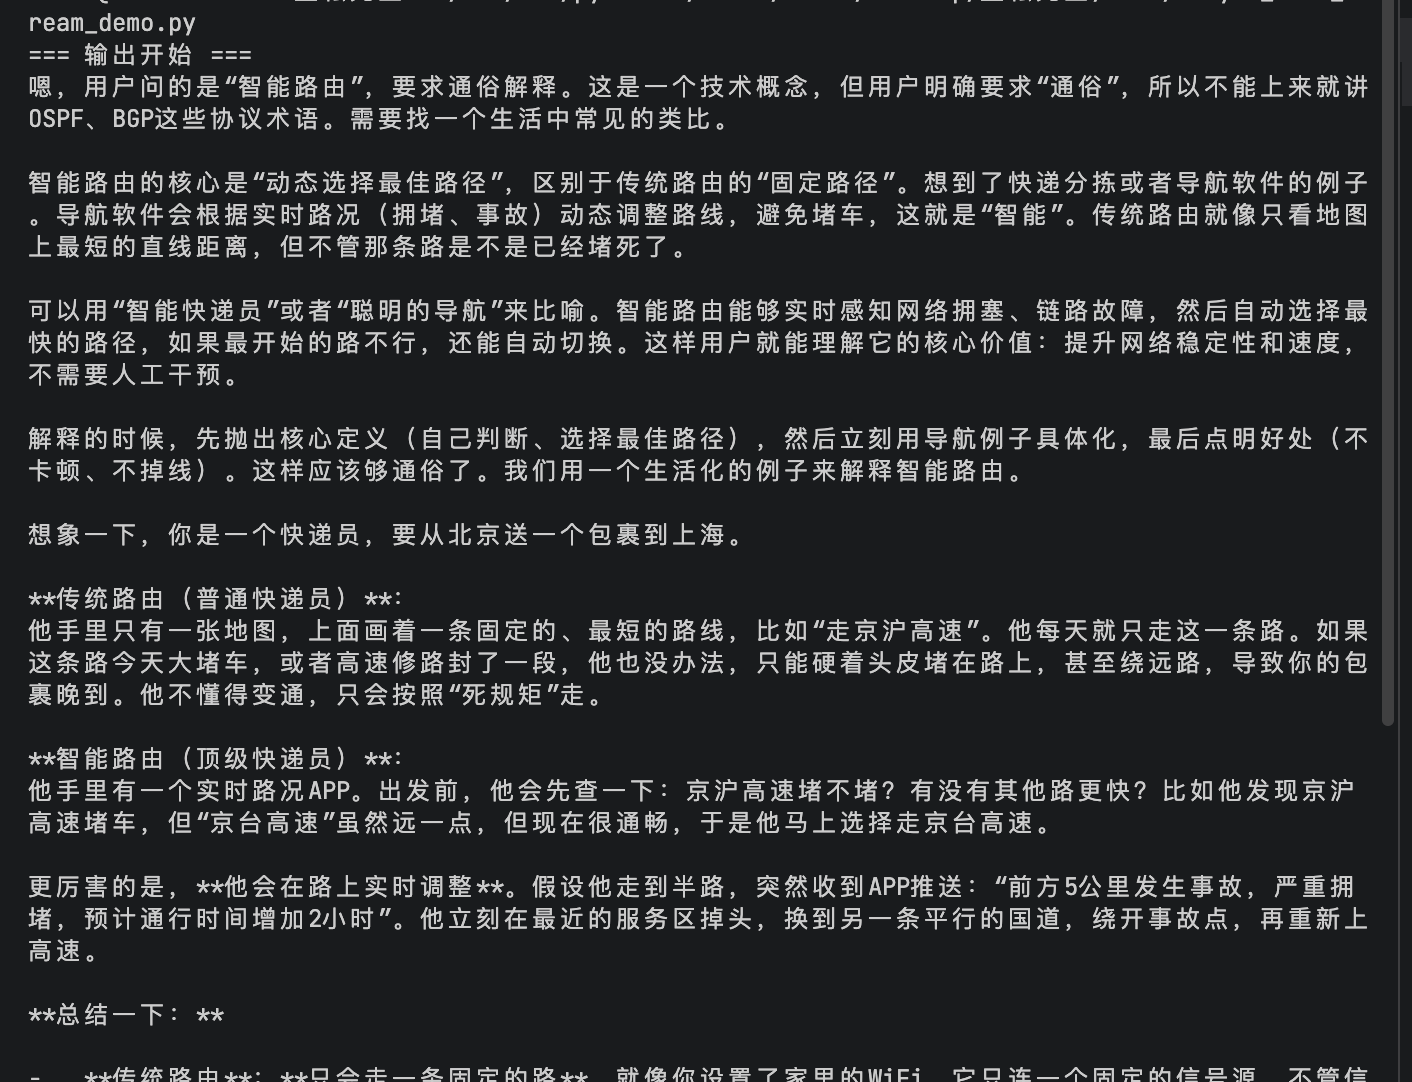
交互式产品几乎都要 SSE/流式。蓝耘文档明确支持 stream=true,DeepSeek-R1 还会带思维链字段 reasoning_content。
import os
from openai import OpenAI
client = OpenAI(
api_key=os.getenv("LANYUN_API_KEY", "sk-xxxxxxxxxxx"),
base_url="https://maas-api.lanyun.net/v1",
)
stream = client.chat.completions.create(
model="/maas/deepseek-ai/DeepSeek-R1",
messages=[{"role": "user", "content": "解释一下什么是智能路由,尽量通俗。"}],
stream=True,
)
print("=== 输出开始 ===")
for chunk in stream:
delta = chunk.choices[0].delta
# R1 等推理模型可能返回思维链
reasoning = getattr(delta, "reasoning_content", None)
if reasoning:
print(reasoning, end="", flush=True)
content = getattr(delta, "content", None)
if content:
print(content, end="", flush=True)
print("\\n=== 输出结束 ===")
体感上:流式一开,等待焦虑会少很多——哪怕总耗时差不多,用户也会觉得「在动」。
六、cURL 速测(不写代码也能验证)
适合排查「到底是代码问题还是 Key/模型问题」:
curl https://maas-api.lanyun.net/v1/chat/completions \\
-H "Content-Type: application/json" \\
-H "Authorization: Bearer sk-xxxxxxxxxxx" \\
-d '{
"model": "/maas/deepseek-ai/DeepSeek-V3",
"messages": [{"role": "user", "content": "你好,请回复:蓝耘MaaS调用成功"}],
"stream": false
}'
能返回 JSON,就说明平台侧没问题,再回头查 SDK 版本或参数。
七、小实测:同一提示词下,R1 和 V3 怎么选
我用同一条提示词做了简单对比(本机到蓝耘 API 的单次请求,非正式压测;正式数据请用平台日志 / AI Ping 复核):
提示词:
写一个 Python 函数:判断字符串是否为合法 IPv4,要求有注释和 3 个单测用例说明。
| DeepSeek-V3 | 速度、性价比 | 回答直接,适合日常编码助手、客服草稿 | 约 4 元/百万 Token |
| DeepSeek-R1 | 推理过程、复杂题 | 会先「想」再答,适合排错、方案对比、算法题 | 约 8 元/百万 Token |
选型建议(实战向):
- 日常对话 / 文案 / 简单代码 → 优先 V3,省钱也够用
- 疑难排查 / 架构权衡 / 数学推理 → 上 R1,把 reasoning_content 展示出来对用户也有帮助
- 长上下文阅读 → 先看控制台该模型的上下文上限,再决定是否切 Qwen 系或其他长窗口模型
蓝耘这边还有一个很实用的点:统一网关。业务侧只维护一套 base_url,模型在后台换,前端和中间件不用跟着拆多套 SDK。官网也强调智能路由可按「任务-成本-时延」做匹配——对以后做多模型编排很友好。
八、最小可用 Demo:本地「报错解释器」
很多同学第一次接大模型,不是做 ChatGPT 克隆,而是:把终端报错贴进去,让模型给修复建议。下面是一个可直接跑的小脚本。
# error_explainer.py
import os
import sys
from openai import OpenAI
client = OpenAI(
api_key=os.getenv("LANYUN_API_KEY"),
base_url="https://maas-api.lanyun.net/v1",
)
SYSTEM = """你是资深后端工程师。
用户会粘贴报错日志或堆栈。请按下面结构回答:
1) 问题一句话总结
2) 最可能原因(按概率排序,最多3条)
3) 可执行的修复步骤
4) 如何验证已修好
不要空话,尽量给出命令或代码片段。"""
def explain(error_text: str) –> str:
resp = client.chat.completions.create(
model="/maas/deepseek-ai/DeepSeek-V3",
messages=[
{"role": "system", "content": SYSTEM},
{"role": "user", "content": error_text},
],
temperature=0.2,
max_tokens=1200,
)
return resp.choices[0].message.content
if __name__ == "__main__":
if not os.getenv("LANYUN_API_KEY"):
print("请先设置环境变量 LANYUN_API_KEY")
sys.exit(1)
print("粘贴报错,结束后按 Ctrl+D(Windows 用 Ctrl+Z 回车):\\n")
text = sys.stdin.read().strip()
if not text:
print("没有输入内容")
sys.exit(1)
print("\\n===== 蓝耘 MaaS 分析结果 =====\\n")
print(explain(text))
用法示例:
export LANYUN_API_KEY=sk-xxxx
python error_explainer.py
# 粘贴一段 ModuleNotFoundError / 数据库连接超时日志
这个 Demo 的意义不在炫技,而在验证三件事:
如果要再进一步,可以把 model 做成参数:简单错误走 V3,复杂错误自动切 R1。
#!/usr/bin/env python3
"""
蓝耘元生代 MaaS 演示 Demo
依赖: pip install openai
用法:
export LANYUN_API_KEY=sk-你的密钥
python lanyun_maas_demo.py # 交互菜单
python lanyun_maas_demo.py hello # 非流式对话
python lanyun_maas_demo.py stream # 流式输出(含 R1 思维链)
python lanyun_maas_demo.py explain # 报错解释器
python lanyun_maas_demo.py chat # 多轮对话
"""
from __future__ import annotations
import os
import sys
from typing import Optional
from openai import OpenAI
BASE_URL = "https://maas-api.lanyun.net/v1"
MODEL_V3 = "/maas/deepseek-ai/DeepSeek-V3"
MODEL_R1 = "/maas/deepseek-ai/DeepSeek-R1"
EXPLAIN_SYSTEM = """你是资深后端工程师。
用户会粘贴报错日志或堆栈。请按下面结构回答:
1) 问题一句话总结
2) 最可能原因(按概率排序,最多3条)
3) 可执行的修复步骤
4) 如何验证已修好
不要空话,尽量给出命令或代码片段。"""
def get_client() –> OpenAI:
api_key = os.getenv("LANYUN_API_KEY")
if not api_key:
print("请先设置环境变量 LANYUN_API_KEY")
print(' macOS/Linux: export LANYUN_API_KEY="sk-xxxx"')
print(' Windows PS: $env:LANYUN_API_KEY="sk-xxxx"')
sys.exit(1)
return OpenAI(api_key=api_key, base_url=BASE_URL)
def demo_hello(client: OpenAI) –> None:
"""非流式:验证鉴权 + 模型调用"""
print("\\n[1] 非流式对话 (DeepSeek-V3)\\n")
resp = client.chat.completions.create(
model=MODEL_V3,
messages=[
{"role": "system", "content": "你是一个简洁的中文技术助手。"},
{"role": "user", "content": "用三句话介绍什么是 MaaS。"},
],
temperature=0.3,
max_tokens=512,
stream=False,
)
print(resp.choices[0].message.content)
print("—")
print("usage:", resp.usage)
def demo_stream(client: OpenAI) –> None:
"""流式输出:适合聊天框;R1 可能带 reasoning_content"""
print("\\n[2] 流式输出 (DeepSeek-R1,含思维链)\\n")
stream = client.chat.completions.create(
model=MODEL_R1,
messages=[
{
"role": "user",
"content": "解释一下什么是智能路由,尽量通俗,控制在 150 字内。",
}
],
stream=True,
)
print("=== 输出开始 ===")
saw_reasoning = False
for chunk in stream:
if not chunk.choices:
continue
delta = chunk.choices[0].delta
reasoning = getattr(delta, "reasoning_content", None)
if reasoning:
if not saw_reasoning:
print("[思维链]", end="", flush=True)
saw_reasoning = True
print(reasoning, end="", flush=True)
content = getattr(delta, "content", None)
if content:
if saw_reasoning:
print("\\n[回答]", end="", flush=True)
saw_reasoning = False
print(content, end="", flush=True)
print("\\n=== 输出结束 ===")
def demo_explain(client: OpenAI, error_text: Optional[str] = None) –> None:
"""最小业务 Demo:终端报错解释器"""
print("\\n[3] 报错解释器 (DeepSeek-V3)\\n")
if not error_text:
print("粘贴报错,结束后按 Ctrl+D(Windows 用 Ctrl+Z 回车):\\n")
error_text = sys.stdin.read().strip()
if not error_text:
# 无输入时用内置样例,方便一键演示
error_text = (
"ModuleNotFoundError: No module named 'openai'\\n"
" File \\"app.py\\", line 3, in <module>\\n"
" from openai import OpenAI"
)
print("(未粘贴内容,使用内置样例报错)\\n")
print(error_text)
print()
resp = client.chat.completions.create(
model=MODEL_V3,
messages=[
{"role": "system", "content": EXPLAIN_SYSTEM},
{"role": "user", "content": error_text},
],
temperature=0.2,
max_tokens=1200,
)
print("===== 蓝耘 MaaS 分析结果 =====\\n")
print(resp.choices[0].message.content)
print("\\n—")
print("usage:", resp.usage)
def demo_chat(client: OpenAI) –> None:
"""多轮对话:本地维护 messages 历史"""
print("\\n[4] 多轮对话 (DeepSeek-V3,输入 /exit 退出,/clear 清空上下文)\\n")
messages = [
{
"role": "system",
"content": "你是蓝耘 MaaS 接入助手,回答简洁、可执行。",
}
]
while True:
try:
user = input("你: ").strip()
except (EOFError, KeyboardInterrupt):
print("\\n已退出")
break
if not user:
continue
if user in ("/exit", "exit", "quit", "q"):
print("已退出")
break
if user in ("/clear", "clear"):
messages = messages[:1]
print("(上下文已清空)")
continue
messages.append({"role": "user", "content": user})
stream = client.chat.completions.create(
model=MODEL_V3,
messages=messages,
temperature=0.4,
max_tokens=1024,
stream=True,
)
print("助手: ", end="", flush=True)
parts: list[str] = []
for chunk in stream:
if not chunk.choices:
continue
content = getattr(chunk.choices[0].delta, "content", None)
if content:
parts.append(content)
print(content, end="", flush=True)
print()
messages.append({"role": "assistant", "content": "".join(parts)})
def print_menu() –> None:
print(
"""
========================================
蓝耘元生代 MaaS 演示 Demo
base_url: https://maas-api.lanyun.net/v1
========================================
1) hello – 非流式对话
2) stream – 流式输出(R1 思维链)
3) explain – 报错解释器
4) chat – 多轮对话
0) 退出
"""
)
def main() –> None:
client = get_client()
args = sys.argv[1:]
if args:
cmd = args[0].lower()
if cmd == "hello":
demo_hello(client)
elif cmd == "stream":
demo_stream(client)
elif cmd == "explain":
demo_explain(client, " ".join(args[1:]) or None)
elif cmd == "chat":
demo_chat(client)
else:
print(f"未知命令: {cmd}")
print(__doc__)
sys.exit(1)
return
while True:
print_menu()
try:
choice = input("请选择 [0-4]: ").strip()
except (EOFError, KeyboardInterrupt):
print("\\n已退出")
break
if choice in ("0", "q", "quit", "exit"):
print("已退出")
break
if choice == "1" or choice == "hello":
demo_hello(client)
elif choice == "2" or choice == "stream":
demo_stream(client)
elif choice == "3" or choice == "explain":
demo_explain(client)
elif choice == "4" or choice == "chat":
demo_chat(client)
else:
print("无效选项,请重试")
if __name__ == "__main__":
main()
完整代码如上
九、成本与用量:怎么避免「测着测着没额度了」
结合官方文档的计费逻辑,个人实践建议:
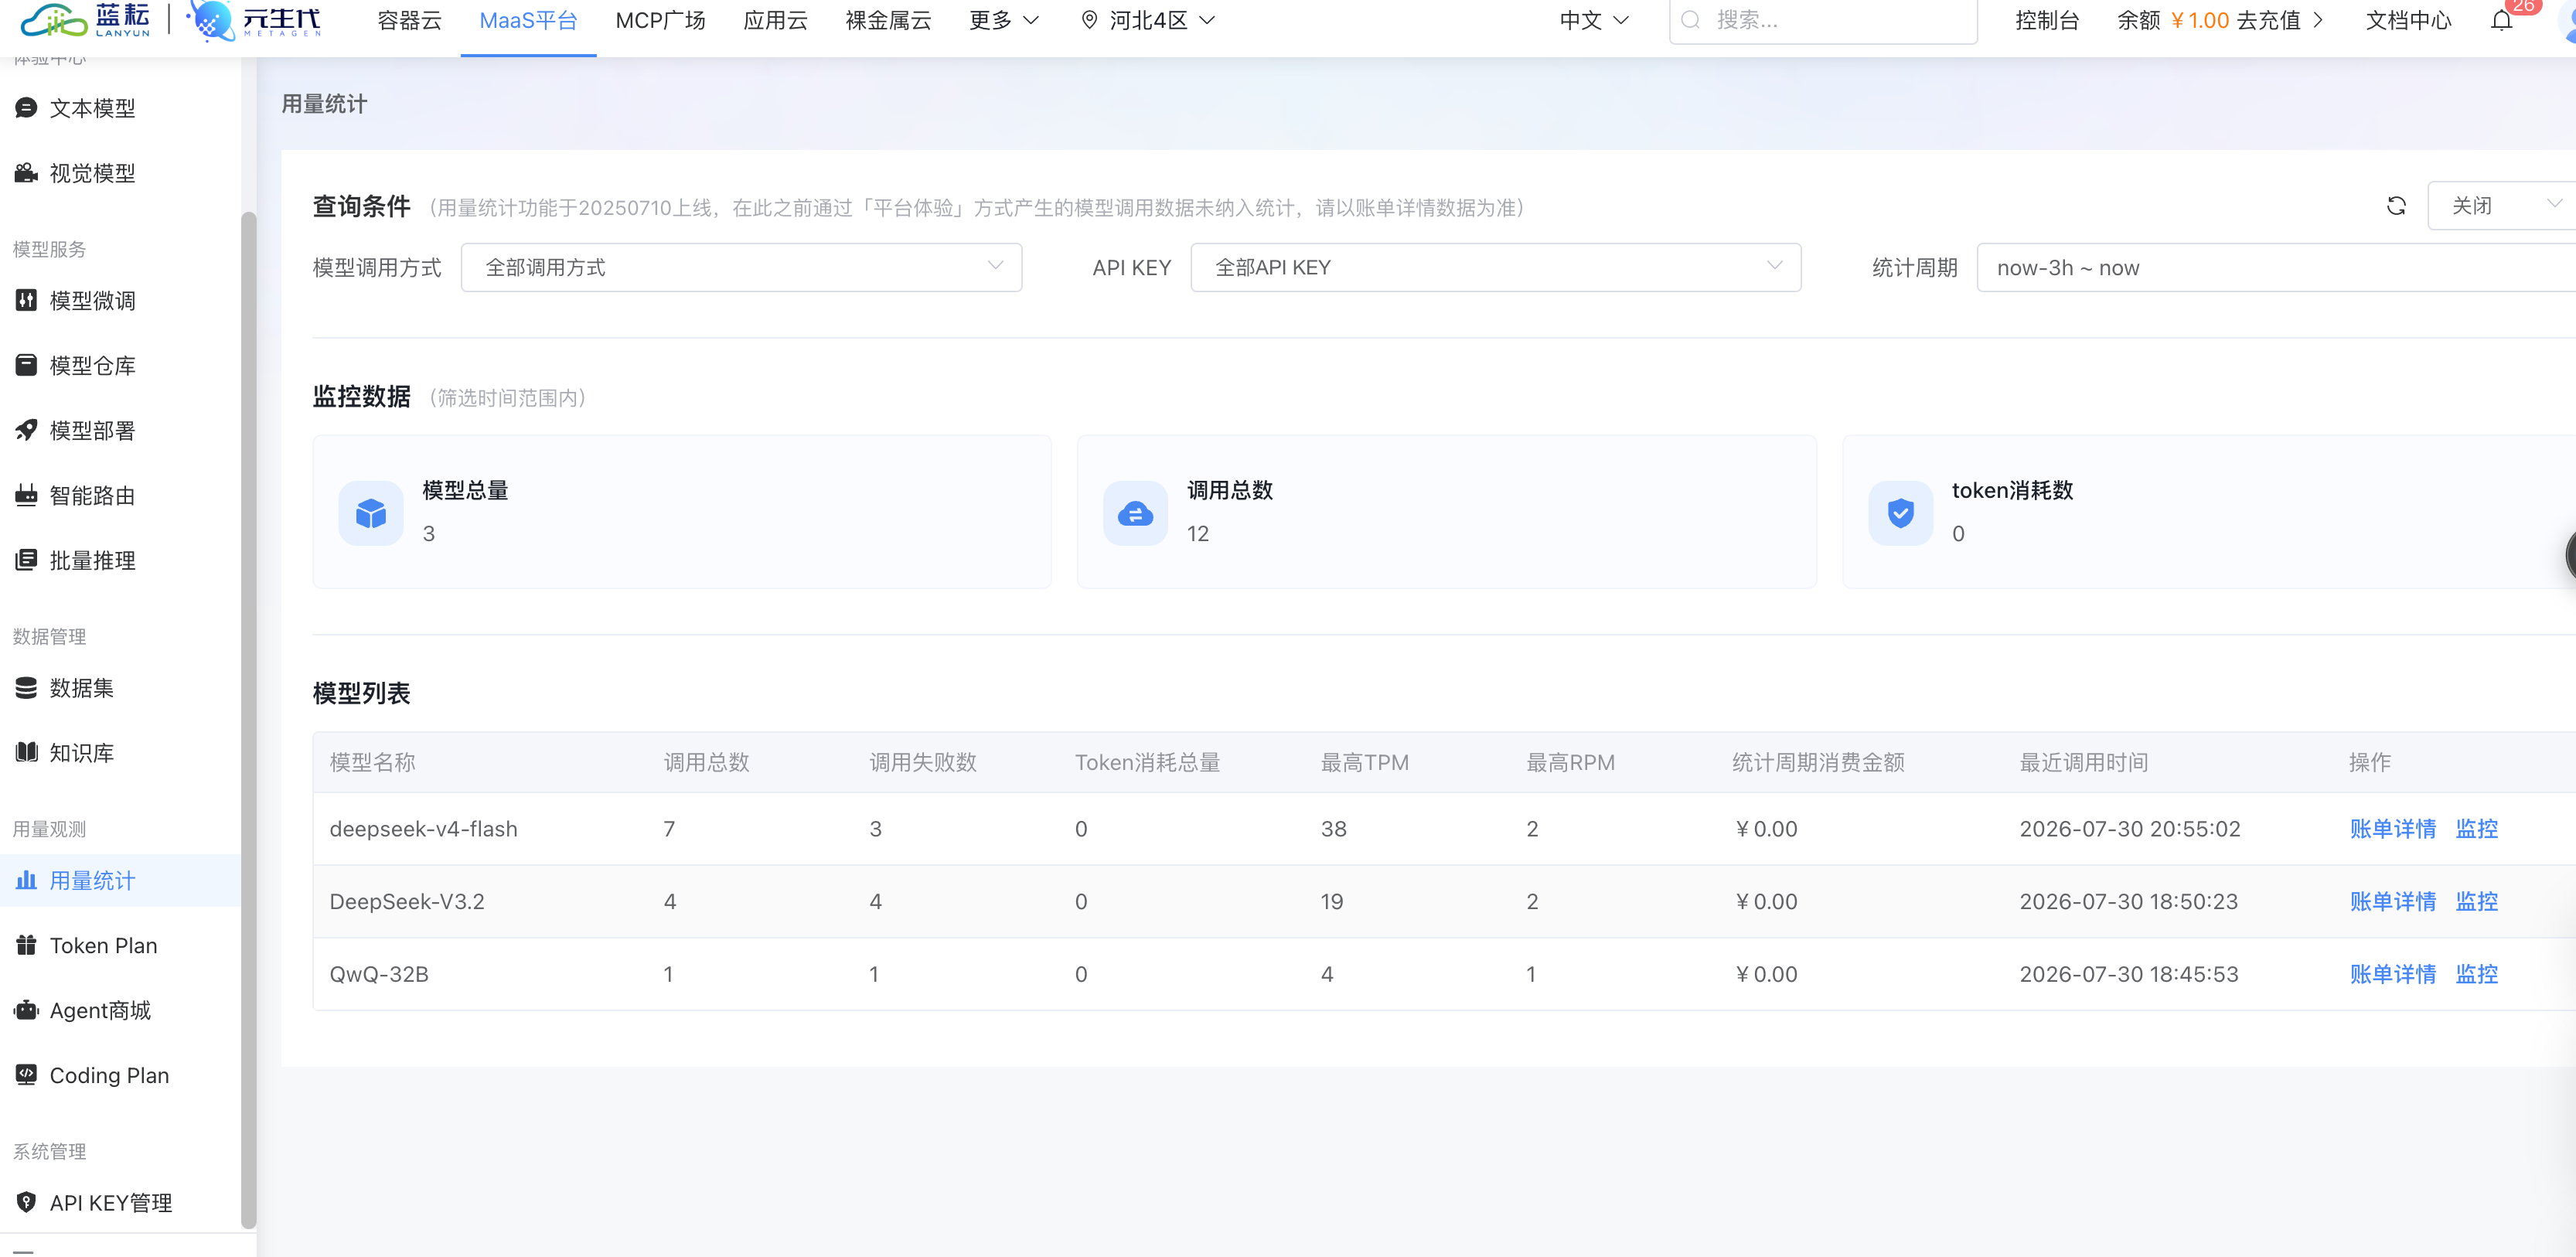
文档示例价(再次强调以控制台为准):
- DeepSeek-V3 ≈ 4 元 / 百万 Token
- DeepSeek-R1 ≈ 8 元 / 百万 Token
换算直觉:一百万 Token 大约相当于不少中文技术文章的体量;个人 Demo 阶段,免费额度通常够完成「接入 + 验证 + 写文章截图」。
十、我认可的蓝耘优势(结合真实接入体验)
写攻略不能只贴官方 slogan,结合这次接入,我觉得可感知的点是:
OpenAI 兼容做得扎实
换 base_url 就能跑,学习成本接近为零,旧项目迁移压力小。
模型名规范清晰
/maas/厂商/模型 这种命名,在多模型项目里很好管理,不容易和别的云厂商模型字符串混掉。
从「能聊天」到「能进业务」路径短
控制台体验、API、Chatbox、自建脚本四条路都通,适合个人开发者和小团队快速试错。
有统一网关思维
以后若要上智能路由、批量推理、多模型兜底,业务层仍可保持单一接入点——这比一上来对接五六套厂商 SDK 现实得多。
当然也有需要注意的地方:模型列表和价格会更新,写生产代码时务必以控制台实时信息为准;涉及敏感数据时,要按公司合规要求评估公有云 API 的数据出境与留存策略。
十一、总结:30 分钟 checklist
如果你也想今天就把蓝耘元生代接进项目,按这个清单走即可:
- 注册并登录蓝耘智算云 / MaaS
- 创建 API Key,写入环境变量
- 用官方 base_url=https://maas-api.lanyun.net/v1 跑通第一条请求
- 分别试一次 V3(快省)和 R1(深推理)
- 做一个最小业务脚本(报错解释 / 文档摘要 / 代码注释)
- 到资源包管理核对 Token 消耗
- 需要时再接到 Chatbox / Dify 等工具
一句话:蓝耘元生代 MaaS 把「选模型、调网关、管计费」收成了统一入口,开发者把精力放回业务本身。
