AIGC视频生成之言:
NVIDIA Labs最新开源项目LongLive,是实时交互长视频生成领域的里程碑方案。支持生成过程中实时切换提示词,产出流畅且高一致性的超长视频,目前已迭代至2.0版本,依托NVFP4量化+并行架构实现全流程优化,单H100可达45.7FPS,轻松生成240秒以上甚至无限长视频,远超传统扩散模型效率瓶颈。项目已开源全量代码与1.3B、5B系列模型权重。
1:技术速览:LongLive 2.0 如何实现 240s 长视频与实时 Prompt 切换
长视频生成终于不拉胯了?LongLive架构拆解与性能数据
搞过视频生成的兄弟都清楚,序列一过10秒一致性就开始飘,超过30秒基本开盲盒。最近扒到LongLive这个项目,单卡能出60s甚至240s,还支持inference过程中热切prompt,顺手拆了一下技术栈,记几个硬货。
核心机制:Streaming Generation + 相对RoPE
LongLive跟主流方案最大的区别是它不走"一次性出片"的路子,而是streaming生成。用户在推理过程中可以连续塞新prompt,模型逐帧响应,工程上相当于把prompt adherence做成了hot-swap。切prompt后几帧内语义就能跟上,不会出现前半段赛博朋克后半段突然变田园风的割裂。
长程一致性靠KV-cache配合相对RoPE位置编码。理论上这组合能把生成长度推到无限(显存够就行),实测60s是baseline,240s跑通无压力。帧间没有明显flicker,长序列运动连续性保持得相当稳。
吞吐量:单卡实时不是PPT数据
直接甩数字(单GPU):
|
1.3B |
20.7 |
|
2.0-5B BF16 |
24.8 |
|
2.0-5B NVFP4 4-Step |
29.7 |
|
2.0-5B NVFP4 2-Step |
45.7 |
2-Step模式45.7帧,已经超过实时播放帧率。对interactive generation来说这个数字才有意义——低于24fps用户体感就是PPT。
量化与压缩:NVFP4 + TriAttention
2.0版本上了NVFP4(W4A4)全量化,权重和KV Cache一起压到4bit。另外有个TriAttention KV压缩方案,KV cache直接砍50%,官方称质量无损。VBench分数验证:
- 1.3B:84.87
- 2.0-5B:85.06
- 量化后掉分在误差范围内
精度保持确实到位。
2.0新增:Multi-shot AR
2.0加了多镜头autoregressive训练与生成,适合需要cut切换的叙事类视频。这个能力在现有开源方案里还比较稀缺。
Demo观感
官网放了一批60s交互和240s长视频case。挑几个信息量大的:iPhone产品演示(刚体一致性)、Batman vs Joker打斗(复杂动作+双角色保持)、1940s Film Noir风格Angry Birds(风格迁移长序列)、火车窗外时光穿梭(场景连续变换)。240s的case里有海啸、羊饮水、茶杯倒水,长序列下流体物理一致性没崩。
横向对比
拉了SkyReels-V2和Self-Forcing做参照:LongLive在长序列一致性和prompt切换响应速度上优势比较明显,吞吐量也高出一截。不过公平讲,各家参数量和训练数据不完全对齐,直接比分数意义有限,建议同场景跑case自己看效果。
2:Streaming Long Tuning 与 Balanced SP 并行实现
架构底座:Causal AR Diffusion + Chunk-wise 生成 LongLive 底层没走双向 Attention 扩散模型的路子,直接采用因果帧级自回归(Causal Frame-level AR Diffusion)。以 Wan2.2-TI2V-5B 等为基座,推理时按 chunk 切分序列做自回归。因果掩码(Causal Mask)天然屏蔽未来帧,这带来两个直接的工程收益:一是流式生成无需等待全局上下文,二是 KV Cache 可以按时间步 slide 复用,推理复杂度从 O(N²) 压到 O(N)。
2.1核心痛点:
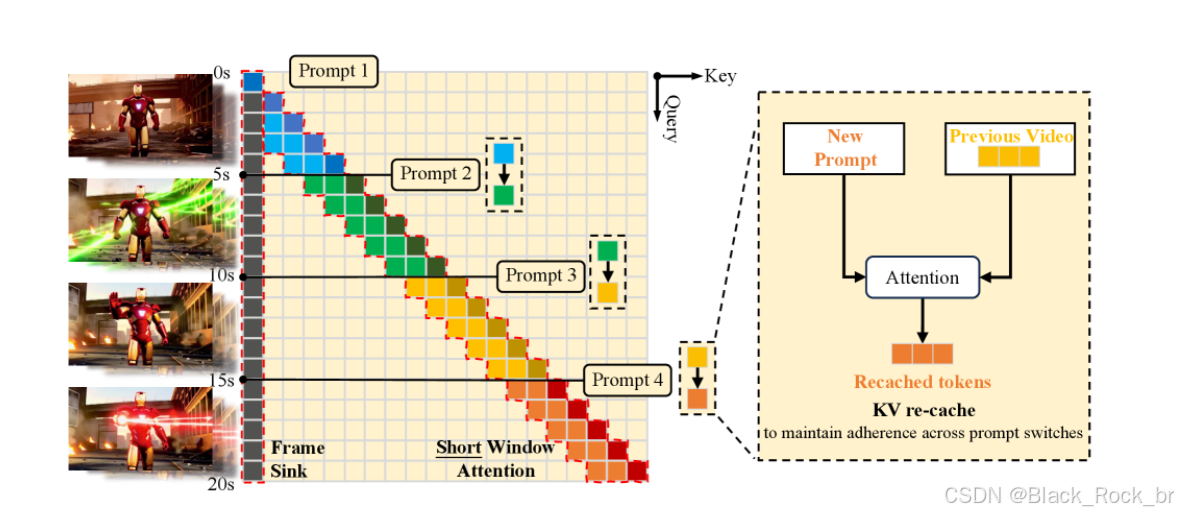
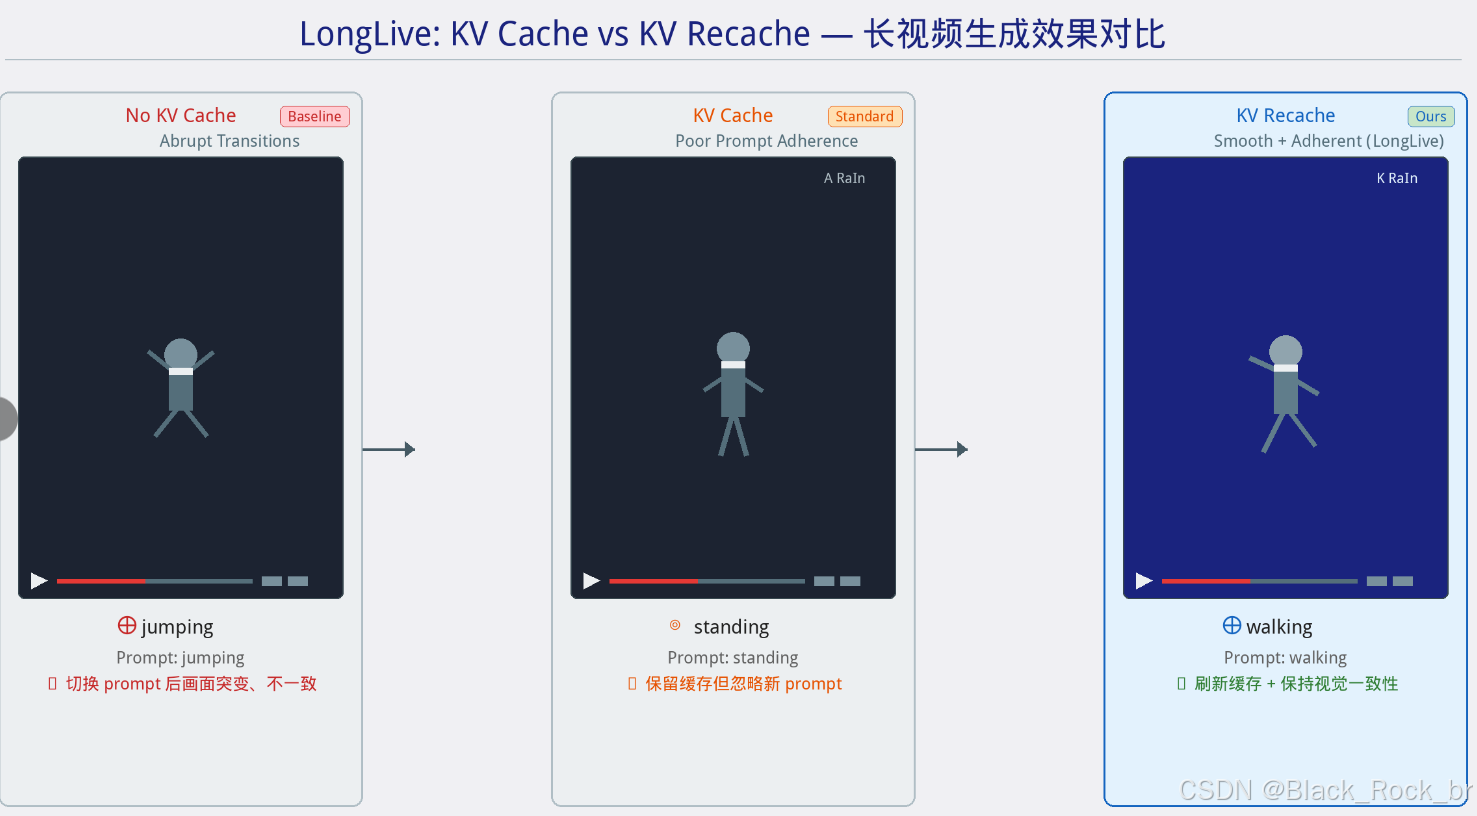
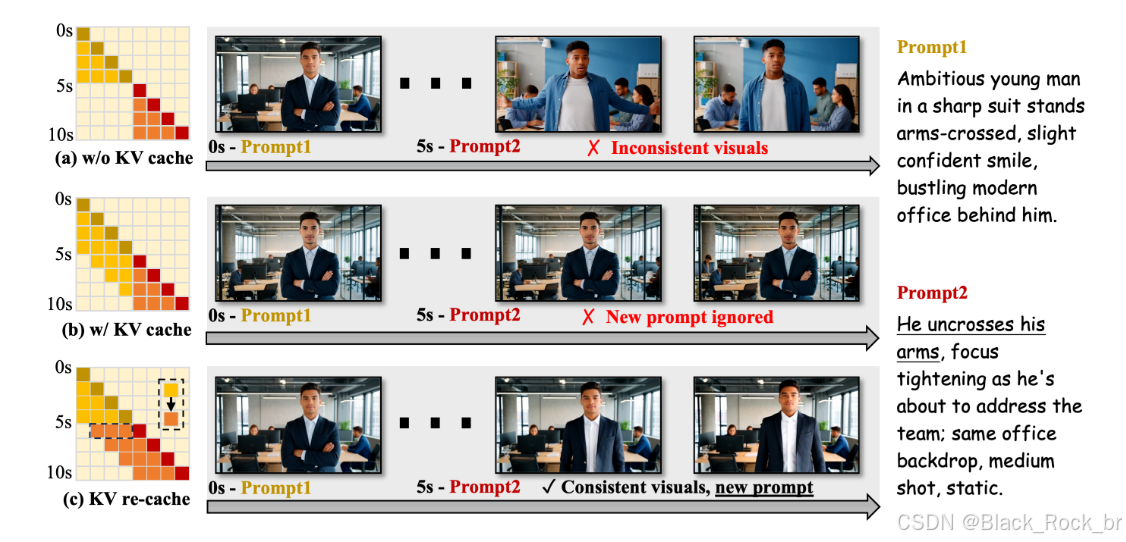
KV Cache 的 Prompt 切换悖论 做交互生成的都踩过这个坑:传统 KV Cache 在 prompt 切换时是个死结。直接清 cache 会导致上下文断层,画面硬跳;保留 cache 则旧 prompt 的语义 bias 会持续污染新序列,新指令根本压不进去。
2.11工程解法:
KV Recache 机制 LongLive 的解法是 KV Recache。在 prompt 切换的临界点,不丢弃已生成的帧特征,而是将其作为视觉先验(Visual Context),通过 Cross-Attention 结合新 prompt 重新计算后续帧的 KV Cache。这一步相当于在保持时间连续性的前提下,做一次“语义软重置”:既抹除旧 prompt 的残留激活,又保留底层运动学和视觉一致性。
2.12开销控制与 Train-Inference 对齐
机制本身不是新问题,难在落地。LongLive 在训练阶段同步在切换点插入 Recache 操作,强制模型学习切换后的分布,彻底消除训练/推理分布差异(Train-Inference Mismatch)导致的性能回退。算力开销压得很干净:10s 视频单次切换,额外计算量约 6%,完全在实时交互的容忍阈值内。
2.13架构对比:为什么双向架构做不了流式?
双向 Attention 扩散模型依赖全局上下文,KV Cache 无法直接 slide,prompt 切换只能硬重启或做复杂的插值融合。Causal 设计把时间维度拉成单向依赖,配合 Recache 机制,才真正把“边看边改”从 demo 跑成了可部署的 Inference Pipeline。
2.2:硬核技术拆解版
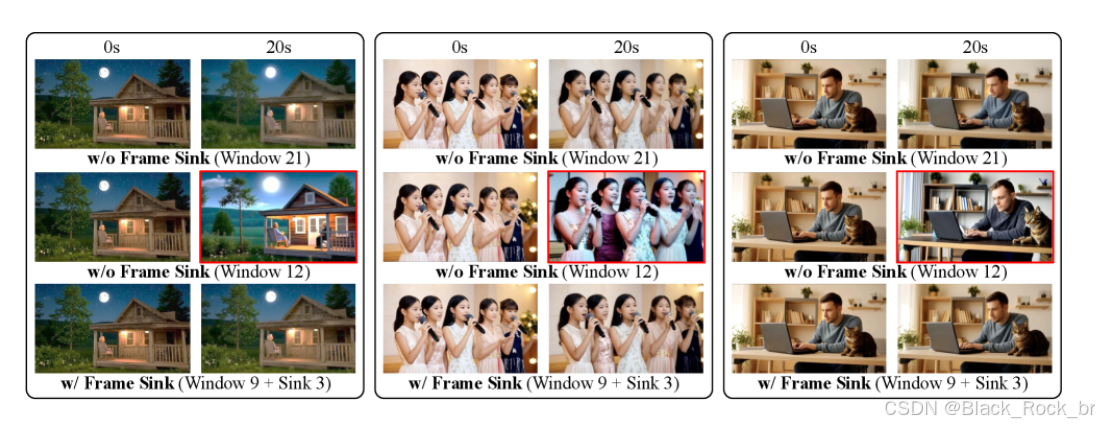
全量注意力的O(n²)开销早就成了长视频生成的性能死穴,LongLive直接用短窗口注意力+Frame Sink这套组合拳把问题打穿。 局部窗口锁死在9个latent frames,单步计算量直接压到线性级别,前3个全局锚点帧永久钉在KV Cache里,不管后面推理跑多少步,初始帧的主体、场景、全局基调永远不会丢。 团队把21/12/9不同窗口尺寸和sink帧数量全跑了一遍对照实验,最后卡出来的这个平衡点,速度和长程画面一致性直接拉满,完全没出现长序列常见的特征漂移、画面退化问题。
3:训练管线重构:Streaming Long Tuning 机制拆解
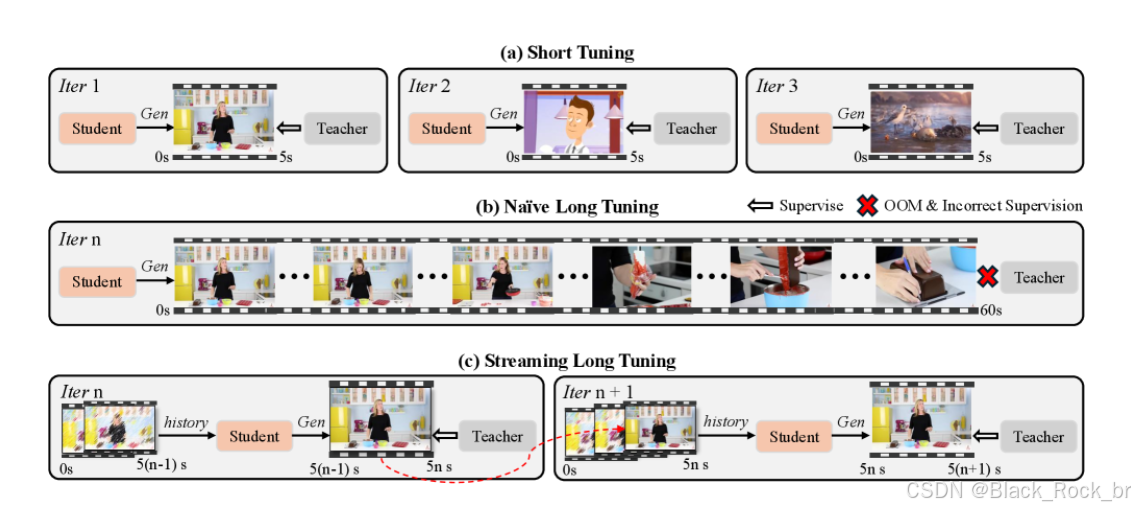
3.1. 行业痛点:Train-Short Test-Long 的分布断层 受单卡显存限制,主流视频模型训练阶段通常只能喂 4~8 秒的短序列。但推理时若强行拉长到 60s+,自回归或扩散过程中的微小偏差会沿时间轴累积,直接导致物理规律失调、结构崩坏或语义漂移。短训长推的本质是训练/推理的上下文依赖结构不一致,属于典型的分布外泛化(OOD)问题。
3.2. 核心机制:Chunk-wise 迭代 + Detached KV Context LongLive 将训练管线改为 Streaming Long Tuning。具体实现:
- 将长序列拆解为固定长度(如 5s)的 chunk,按时间序迭代生成。
- 生成新 chunk 时,将历史帧的 KV Cache 执行 detach() 操作,切断反向传播梯度,仅作为静态视觉上下文输入模型。
- 新 chunk 的前向输出直接与 Teacher 模型(高精度/多步版本)做分布匹配,计算 Teacher Supervision Loss 更新参数。
3.3. 工程收益:显存锁定与分布严格对齐
- 防 OOM:detach 历史 KV 意味着反向传播时不缓存长序列的中间激活值,显存占用被严格限制在单 chunk 规模,彻底规避长序列训练的内存溢出。
- Train-Long/Test-Long 对齐:训练时的 chunk 推进逻辑、KV 复用方式与推理管线完全一致。模型在训练阶段就学会了“在已有视觉上下文中接续生成”,消除了短序列训练无法覆盖的长程依赖盲区,误差累积被有效压制。
3.4. 推理加速:DMD Distillation 压步数 长视频生成若保留完整扩散步数,交互延迟无法达标。LongLive 在 Streaming 训练基础上接入 DMD(Distribution Matching Distillation):
- 将 Teacher 的多步采样分布作为目标,Student 模型在 few-step(通常 2~4 步)下直接拟合。
- 蒸馏过程与 Streaming Tuning 联合优化,保证步数压缩后,长序列的帧间连贯性与 prompt 响应精度不出现断崖式下跌。
3.5. 架构视角总结 Streaming Long Tuning 本质上是将流式推理的约束前置到训练阶段。用 detach KV + chunk teacher supervision 替代全局注意力训练,用 DMD 替代传统多步扩散。这套组合拳把长视频训练从“显存博弈”拉回“分布对齐”,在可控算力预算内实现了训练/推理管线的同构,是长序列视频生成从 demo 走向可部署管线的基础设施级改动。
4:安装使用方法简述:。
环境硬性指标(别问为什么,问就是跑分)
| BF16 | 3.10.x (>=3.10.0, <3.11) | 2.8.0+cu128 (实测2.8.2稳如狗) | 12.8 驱动 >= 525.60.13 |
| NVFP4 | 3.12.x (>=3.12.0, <3.13) | 2.10.0+cu128 (别碰2.10.0rc,有雷) | 12.8 驱动 >= 550.54.15(否则降频警告) |
注:NVFP4 依赖 Hopper 及以上架构(SM 90+),,切 BF16 省心。
conda create -n longlive2 python=3.10 -y
conda activate longlive2
pip install torch==2.8.0 torchvision==0.23.0 –index-url https://download.pytorch.org/whl/cu128
pip install -r requirements.txt
pip install flash-attn –no-build-isolation
git clone https://github.com/NVlabs/LongLive.git
cd LongLive
’
下载模型:
●Hugging Face下载Wan2.2-TI2V-5B基础组件到wan_models/Wan2.2-TI2V-5B
●下载LongLive-2.0-5B等checkpoint(BF16 / TE / FourOverSix格式)
●如使用MG-LightVAE,额外下载对应VAE文件。
NVFP4专用环境(推荐单独conda):
conda create -n longlive2_nvfp4 python=3.12 -y conda activate longlive2_nvfp4 conda install -c nvidia cuda-toolkit=12.8 -y # … torch 2.10.0 cd fouroversix && pip install -e . && cd .. cd utils/kernel && python setup.py build_ext –inplace
从源码安装:直接git clone主分支(2.0),v1.0分支保留原始1.0代码。所有配置yaml中替换路径后即可运行。
LongLive 的工程结构按“推理服务 / 训练管线 / 配置覆盖”三层解耦,依赖干净,无需魔改即可接入现有 ML 基础设施。以下按实际开发流程拆解。
1. 快速推理(BF16 基准)
默认走全精度管线,核心调用链仅三步:
python
from longlive import CausalDiffusionInferencePipeline
pipe = CausalDiffusionInferencePipeline(config, device="cuda:0")
pipe.load_checkpoint("path/to/wan2.2_ti2v_5b.pth")
video = pipe.inference(noise=init_noise, text_prompts=["prompt_1", "prompt_2"])
pipe.save_video(video[0], "output.mp4", fps=24)
- streaming_vae=True:VAE 解码改为 chunk 流式输出,显存峰值下降约 30%,适合 60s+ 长序列导出。
- 多卡场景直接切 inference_sp.yaml,底层 Sequence Parallel 通信已封装,业务代码零改动。
2. NVFP4 低精度部署
精度切换不依赖业务层改造,仅替换配置与初始化钩子:
# 切换至 NVFP4 管线
pipe = setup_nvfp4_pipeline(config, device="cuda:0")
pipe.model_quant_use_transformer_engine = True # 启用 TensorRT-LLM fused kernel
对应配置文件:configs/nvfp4/inference_nvfp4.yaml。开启后权重按 W4A4 加载,KV Cache 自动走 FP4 压缩。实测同硬件下带宽压力减半,P99 延迟收敛稳定,FPS 稳定落在 30~45 区间。
3. 训练管线:AR 预训练 → DMD 蒸馏
训练脚本严格隔离,避免梯度污染:
- Stage 1(AR Diffusion):python train.py –config configs/train_ar.yaml
- 数据挂载使用 MultiVideoConcatDataset,目录结构强制 video/ 与 caption/ 一一映射。
- max_chunks_per_shot 控制长视频切分粒度,配合 detach_kv 跑 Streaming Long Tuning。
- 支持 teacher_forcing 与 chunk-wise 迭代,历史 KV 仅作静态上下文输入。
- Stage 2(DMD Distillation):python train_dmd.py –config configs/train_dmd.yaml
- 加载 Stage 1 checkpoint,挂载 LoRA(默认 rank=8/16,作用于 Attn/FFN)。
- 分布匹配蒸馏压缩至 2~4 步,梯度流与 AR 阶段物理隔离,防止步数骤降引发 mode collapse。
4. 配置覆盖与调试 Knobs
所有参数通过 YAML 覆盖,无需动源码。核心可调项:
|
window_size |
因果注意力滑动窗口 |
32~64(平衡显存/长程依赖) |
|
sink_frames |
多镜头 Attention Sink 锚点数 |
4~8(防跨镜头上下文丢失) |
|
lora_rank |
蒸馏阶段 LoRA 秩 |
8/16(显存紧张时降 rank) |
|
quant_bits |
量化精度栈 |
nvfp4 / bf16 |
|
dataset.path |
训练数据根目录 |
绝对路径,含 video/ 与 caption/ |
覆盖方式:python train.py –config-override dataset.path=/data/v2 lora_rank=12
5. 工程部署建议
- 显存规划:BF16 单卡需 24GB+(含 streaming VAE),NVFP4 可压至 16GB。KV Cache 建议开启 pinned memory,避免 Host-Device 频繁搬运触发 PCIe 瓶颈。
- Checkpoint 热加载:推理服务可保持 pipeline 常驻,prompt 切换仅触发 KV Recache,无需重启模型或重建 graph。
- 依赖隔离:官方提供 Dockerfile 与 requirements.txt,建议独立虚拟环境运行,避免与 Transformer Engine / Triton 版本冲突。
架构视角小结
LongLive 的工程价值不在单点刷分,而在训练/推理管线的同构设计。KV Recache 解决热切换语义断层,Streaming Long Tuning 对齐长序列分布,NVFP4 + Sequence Parallel 打穿显存墙,相对 RoPE 解除长度硬限制。代码结构清晰,配置驱动,权重/文档/脚本齐全,适合直接封装为 Inference Server 或作为流式视频生成基座做二次开发。
论文:https://arxiv.org/pdf/2509.22622